
用于扩增突变的无创产前检测的方法与流程
本公开涉及产前遗传分析的领域。参考文献:dashnow h, lek m, phipson b, halman a, sadedin s, lonsdale a, et al.stretch: detecting and discovering pathogenic short tandem repeat expansions.genome biology. 2018;19:121.dolzhenko et al., expansionhunter: a sequence-graph-based tool toanalyze variation in short tandem repeat regions. bioinformatics 2019; 35(22): 4754-4756.liautard-haag c, durif g, vangoethem c, baux d, louis a, cayrefourcql, et al. noninvasive prenatal diagnosis of genetic diseases induced bytriplet repeat expansion by linked read haplotyping and bayesian approach.sci rep. 2022;12:11423.rabinowitz t, polsky a, golan d, danilevsky a, shapira g, raff c, etal. bayesian-based noninvasive prenatal diagnosis of single-gene disorders.genome res. 2019. https://doi.org/10.1101/gr.235796.118.rabinowitz t, deri-rozov s, shomron n. improved noninvasive fetalvariant calling using standardized benchmarking approaches. computational andstructural biotechnology journal. 2021;19:509–17.us2021/0340601.yu scy, jiang p, peng w, cheng sh, cheung ytt, tse oyo, et al.single-molecule sequencing reveals a large population of long cell-free dnamolecules in maternal plasma. proceedings of the national academy ofsciences. 2021;118:e2114937118.
背景技术:
1、近年来,越来越多的基因突变经由无创产前检测(nipt)进行临床检测,使孕妇能够在没有侵入性手术风险的情况下鉴定遗传畸形。
2、rabinowitz等人(2019)描述了一种全基因组nipt方法,称为无创产前变异检出。使用
hoobari(第一个无创胎儿变异检出器),他们能够对所有胎儿位置(包括双亲基因座和插入缺失(indel))进行基因分型(us2021/0340601)。
hoobari是一种采用贝叶斯算法来预测单基因疾病遗传的工具,无论其遗传模式或亲本起源如何(rabinowitz等人2019;us2021/0340601;rabinowitz等人2021)。此工具能够通过考虑每个cfdna片段的长度来估计其是胎儿起源的可能性。
hoobari可以检测由单核苷酸多态性(snp)或小插入缺失(基因组中碱基的插入和缺失)引起的突变。
3、当dna复制过程中发生错误,导致常见三核苷酸序列(如cag、gcg等)的重复次数增加时,会出现短串联重复序列(str)突变。在涉及此机制的每种疾病中,存在两个阈值:将正常等位基因与前突变分开的一个阈值,以及将前突变与全突变分开的第二个阈值。这第二个阈值涉及重复次数,超过该重复次数时,表型被视为疾病。这些阈值因疾病而异。尽管存在用于分析str的侵入性临床检测(基于绒毛膜绒毛取样或羊水),但尚无被证明成功的用于分析str的无创临床检测。str可引起扩增突变。检测扩增突变是一个至关重要的目标,因为主要影响神经系统的超过40种疾病源于散布在人类基因组中的简单重复序列的扩增,例如脆性x综合征。
4、liaotard-hagg等人描述了一种间接方法,该方法使用连锁读段对亲本的基因组序列数据进行测序和定相(即,获得单倍型信息),使用存在于扩增突变周围的标记。作为下一步,作者使用
hoobari来预测遗传的单倍型。
5、yu等人描述了使用pacbio长读段测序对长游离dna分子进行测序,并推断胎儿单倍型(遗传的等位基因)。
6、liaotard-hagg等人和yu等人都推断出了遗传的等位基因,但他们没有预测是否发生了扩增,以及是否导致了全突变。
技术实现思路
1、在其第一方面,本发明提供了一种用于对胎儿进行基因分型的方法,所述方法包括:
2、a.接收来自养育所述胎儿的一对亲本的(i)母体血浆游离dna (cfdna)以及(ii)母体和任选地父体基因组dna (gdna)的测序数据读段;
3、b.鉴定所述胎儿可能具有短串联重复序列(str)变异的潜在基因组位点;
4、c.对于所述潜在基因组位点中的每个潜在基因组位点,确定所述胎儿具有所述str变异的概率;
5、d.推断母体和任选地父体str等位基因;
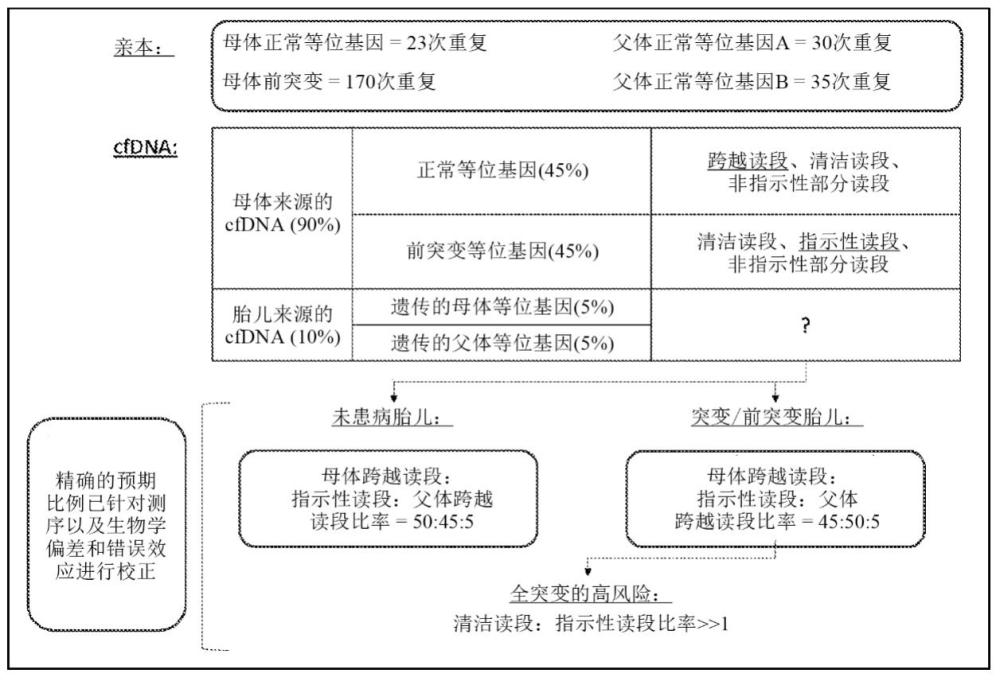
6、e.处理基因的潜在地包含str的区域中的cfdna读段,以鉴定读段类别,其中所述读段类别包括跨越读段、部分读段(包括指示性和非指示性读段)和清洁读段;
7、f.计算所述读段类别之间的预期比率,从而获得计算比率;
8、g.通过以下方式确定所述胎儿最可能遗传的等位基因:
9、i.测量所述读段类别之间的观察比率;以及
10、ii.使用所述计算比率和所述观察比率来区分正常等位基因与具有前突变或全突变的等位基因,并区分具有前突变的等位基因与具有全突变的等位基因;
11、或者
12、iii.应用贝叶斯算法;
13、从而对所述胎儿进行基因分型。
14、在一个实施例中,所述测序数据读段是短读段。
15、在一个实施例中,所述测序数据读段是长读段。
16、在一个实施例中,所述测序数据读段包含短读段和长读段。
17、在一些实施例中,gdna测序数据和cfdna测序数据中的一者或两者是通过选自由以下项组成的组的方法来获得的:全基因组测序(wgs)、全外显子组测序(wes)、下一代测序(ngs)、靶向测序、组套测序、基因测序、长读段基因组测序、双端测序、单端测序和扩增子测序。
18、在一个实施例中,wgs或wes数据是通过深度测序来获得的。
19、在一个实施例中,确定所述概率基于至少一个序列比对图(sam)参数。
20、在一个实施例中,确定所述概率至少基于观察到的模板长度。
21、在一个实施例中,确定所述概率包括计算总胎儿分数。
22、在一个实施例中,所述方法进一步包括构建胎儿大小分布和母体大小分布,其中步骤c的所述确定所述概率包括:对所述胎儿大小分布进行分箱并计算每个片段大小箱(bin)的胎儿分数,以及对于所述至少一个位点处的至少一个大小和至少一个片段,基于所述片段所属的相应片段大小箱的胎儿分数,计算所述片段是胎儿的概率。
23、在一个实施例中,确定所述概率包括应用贝叶斯程序。
24、在一个实施例中,所述贝叶斯程序包括使用所述亲本中的至少一者的测序数据计算出的先验概率。
25、在一个实施例中,所述方法进一步包括使用机器学习重新校准所述贝叶斯程序的输出。
26、在一个实施例中,所述确定所述概率是使用胎儿变异检出进行的。
27、在一个实施例中,所述确定所述概率是使用
hoobari算法进行的。
28、在一个实施例中,所述确定所述概率包括序列读段是胎儿起源的基于片段组学的概率。
29、在一个实施例中,所述方法包括对于被鉴定为与胎儿可能具有str变异的潜在基因组位点重叠的每个cfdna读段,提取片段组学特征。
30、在一些实施例中,所述片段组学特征包括以下项中的一者或多者:读段质量映射、读段碱基质量、片段长度、短/长读段比、末端基序、甲基化位点周围的切割模式、读段端点优选末端、dna/可及性/核小体、到最近核小体的距离、转录因子结合位点、区域胎儿分数、区域序列组成、读段序列组成、以及所述读段中的序列错误的数量。
31、在一个实施例中,确定所述概率包括将基于变异检出的概率与所述基于片段组学的概率相乘,以获得计算出的联合概率。
32、在一些实施例中,所述推断母体和任选地父体str等位基因的步骤包括应用选自由以下项组成的组的生物信息学工具:stretch、gangstr、expansionhunter、hipstr、expansion hunter de novo (ehdn)、strling、repeatseq、lobstr、advntr和tredparse。
33、在一些实施例中,所述str变异指示选自由以下项组成的组的遗传疾病:脆性x综合征、脆性x相关震颤/共济失调综合征(fxtas)、x连锁智力障碍、亨廷顿病、强直性肌营养不良、脊髓小脑性共济失调(sca)、弗里德赖希共济失调、马查多-约瑟夫病、脊髓小脑性共济失调10型(sca10)、脊髓小脑性共济失调12型(sca12)、脊髓小脑性共济失调17型(sca17)、齿状核红核苍白球路易体萎缩症(drpla)、脊髓小脑性共济失调8型(sca8)、脊髓小脑性共济失调31型(sca31)和脆性xe综合征。
34、在另一方面,本发明提供了一种用于诊断胎儿中与短串联重复序列(str)相关或由其引起的遗传疾病的方法,所述方法包括:
35、a.接收来自养育所述胎儿的一对亲本的(i)母体血浆游离dna (cfdna)以及(ii)母体和任选地父体基因组dna (gdna)的测序数据读段;
36、b.鉴定所述胎儿可能具有短串联重复序列(str)变异的潜在基因组位点;
37、c.对于所述潜在基因组位点中的每个潜在基因组位点,确定所述胎儿具有所述str变异的概率;
38、d.推断母体和任选地父体str等位基因;
39、e.处理基因的潜在地包含str的区域中的cfdna读段,以鉴定读段类别,其中所述读段类别包括跨越读段、部分读段(包括指示性和非指示性读段)和清洁读段;
40、f.计算所述读段类别之间的预期比率,从而获得计算比率;
41、g.通过以下方式确定所述胎儿最可能遗传的等位基因:
42、i)测量所述读段类别之间的观察比率;以及
43、ii)使用所述计算比率和所述观察比率来区分正常等位基因与具有前突变或全突变的等位基因,并区分具有前突变的等位基因与具有全突变的等位基因;
44、或者
45、iii)应用贝叶斯算法;
46、从而诊断所述胎儿。
47、在一些实施例中,所述与短串联重复序列(str)相关或由其引起的遗传疾病选自由以下项组成的组:脆性x综合征、脆性x相关震颤/共济失调综合征(fxtas)、x连锁智力障碍、亨廷顿病、强直性肌营养不良、脊髓小脑性共济失调(sca)、弗里德赖希共济失调、马查多-约瑟夫病、脊髓小脑性共济失调10型(sca10)、脊髓小脑性共济失调12型(sca12)、脊髓小脑性共济失调17型(sca17)、齿状核红核苍白球路易体萎缩症(drpla)、脊髓小脑性共济失调8型(sca8)、脊髓小脑性共济失调31型(sca31)和脆性xe综合征。
48、在另一方面,本发明提供了一种用于诊断胎儿中脆性x综合征的方法,所述方法包括:
49、a.接收(i)母体血浆游离dna (cfdna)以及(ii)母体基因组dna (gdna)的测序数据读段;
50、b.推断母体fmr1基因等位基因;
51、c.计算所述cfdna内的胎儿分数;
52、d.处理fmr1基因的区域中的cfdna读段,以鉴定读段类别,其中所述读段类别包括跨越读段、部分读段(包括指示性和非指示性读段)和清洁读段;
53、e.计算所述读段类别之间的预期比率,从而获得计算比率;
54、f.通过以下方式确定所述胎儿最可能遗传的等位基因:
55、i.测量所述读段类别之间的观察比率;以及
56、ii.使用所述计算比率和所述观察比率来区分正常等位基因与具有前突变或全突变的等位基因,并区分具有前突变的等位基因与具有全突变的等位基因;
57、或者
58、iii.应用贝叶斯算法;
59、其中
60、朝向跨越读段的失衡指示所述胎儿具有未患脆性x综合征的高可能性,
61、朝向指示性读段的失衡指示所述胎儿具有在所述fmr1基因中具有前突变或全突变的高可能性,并且
62、朝向指示性读段的失衡以及清洁读段与指示性读段之间的比率高于所述计算比率指示所述胎儿具有在所述fmr1基因中具有导致脆性x综合征的全突变的高可能性。
63、在一个实施例中,所述计算所述读段类别之间的所述预期比率的步骤包括对读段计数进行归一化。
64、在一些实施例中,所述归一化通过以下项中的一者或多者进行:
65、a.样品内归一化,
66、b.样品间归一化,
67、c.胎儿富集和母体富集读段的比较,
68、d.单倍型比较,以及
69、e.双端ngs技术的校正。
70、在一个实施例中,所述样品间归一化包括创建正常样本集(pon)。
71、在另一方面,本发明提供一种计算机软件产品,所述计算机软件产品包括其中存储了程序指令的计算机可读介质,当由数据处理器读取时,所述指令将所述数据处理器配置为:(1)接收来自养育胎儿的一对亲本的(i)母体游离dna (cfdna)以及(ii)母体和任选地父体基因组dna (gdna)的测序数据读段,以及(2)执行本发明的方法。
72、在另一方面,本发明提供了一种用于对胎儿进行基因分型的系统,所述系统包括:输入实用程序,其用于接收来自养育胎儿的一对亲本的(i)母体游离dna (cfdna)以及(ii)母体和任选地父体基因组dna (gdna)的测序数据读段;以及数据处理器,其被配置用于分析所述数据,以执行本发明的方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com