
一种直接空间晶体流生成模型的强化学习方法与流程
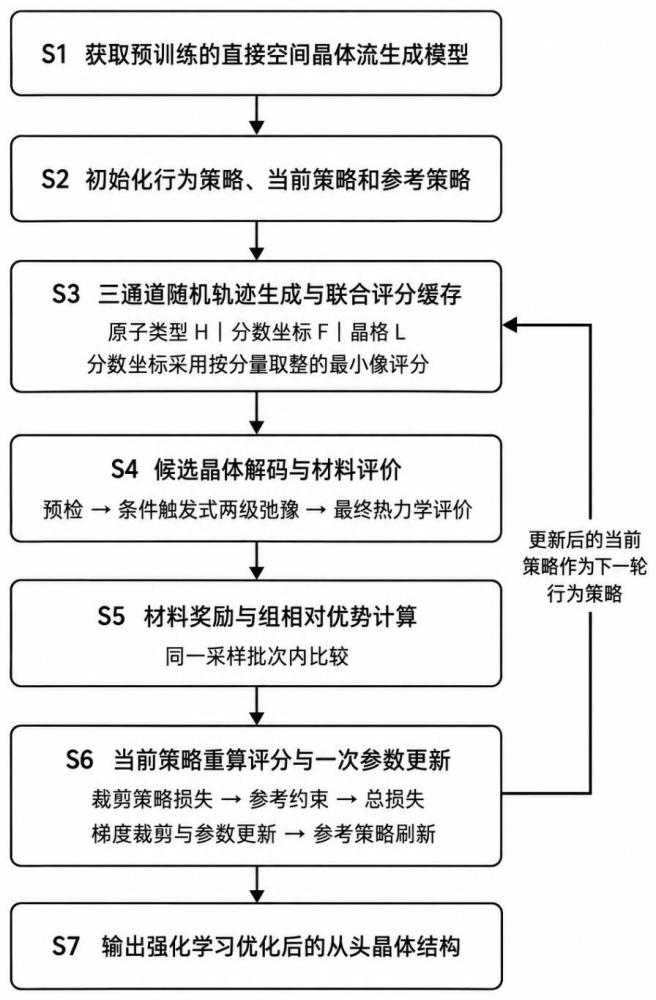
本发明涉及人工智能辅助材料设计,更具体的说是涉及一种直接空间晶体流生成模型的强化学习方法。
背景技术:
1、流匹配、整流或其他连续流生成模型通过学习随时间变化的速度场,将易于采样的先验分布逐步映射至晶体数据分布。在直接空间晶体生成中,可令联合状态为:,其中,为原子类型连续状态,为分数坐标状态,为晶格状态。常规确定性离散积分可写为,该确定性积分本身不提供适用于策略梯度的显式随机动作概率。若希望根据最终生成晶体的稳定性、有效性、新颖性、多样性或目标功能性质进行强化学习后训练,需要将多步生成过程构造成具有随机动作和可计算转移评分的策略过程,并使行为策略采样、行为评分缓存和当前策略重算针对同一物理动作和同一转移语义。
2、现有代表性方法chemeleon2将强化学习引入晶体潜空间去噪扩散模型,其技术路径为:利用变分自编码器将晶体结构编码为连续潜变量z,以潜空间反向扩散核作为策略,通过组相对策略优化(grpo)及多目标材料奖励(创造性、稳定性、多样性)引导生成,并采用机器学习力场降低评价成本。然而,上述现有方案及一般性直接空间生成技术仍存在以下显著缺陷:
3、第一,缺乏直接空间多通道随机策略构造方案。chemeleon2的策略完全依赖vae潜变量及潜空间扩散核,现有技术未给出在不引入潜空间编码器的条件下,将该确定性流积分转化为具有显式随机动作及可计算转移评分的联合策略的方法,也未解决行为轨迹采样、评分缓存与当前策略重算之间直接空间转移语义的一致性问题。
4、第二,分数坐标周期边界的转移评分语义不一致。直接空间中,若仅对分数坐标状态执行回绕(将动作放回基本域),而在计算策略转移评分时仍对动作与转移中心之差采用普通欧氏残差,则周期边界附近的物理小位移会被误判为接近一个晶格周期的大残差,导致高斯评分和策略梯度异常放大。chemeleon2的概率定义于潜变量空间,未涉及直接空间周期等价残差的选择。更为关键的是,现有技术未意识到行为策略缓存评分与当前策略重算评分必须严格复用相同的按分量取整最小像规则;否则,即使状态回绕正确,新旧策略概率比率仍会因坐标表示差异而失真,无法真实反映策略变化。
5、第三,未考虑多通道尺度差异与无效原子干扰。原子类型、分数坐标和晶格三个通道具有不同的状态维度、物理量纲及有效自由度。潜空间单一扩散核无法分别适配各通道的随机扰动尺度,也无法解决离散时间步长变化导致累计扩散强度改变的难题。同时,晶胞填充原子(无效槽位)若不从转移评分和活动维数统计中排除,将主导联合评分并干扰策略梯度方向,现有技术对此未提供有效处理机制。
6、第四,材料评价中的弛豫预算分配不合理。现有方案对候选晶体统一执行固定步数的结构弛豫,未根据初步热力学评价结果动态分配计算预算。对全部候选采用高成本深层弛豫会显著降低强化学习训练吞吐量;而统一采用浅层弛豫又可能导致接近稳定或亚稳定阈值的候选因结构尚未充分收敛而发生奖励误判,影响策略更新的可靠性。
7、因此,如何实现周期一致性转移评分构造、多通道随机策略适配及可控成本下的可靠材料评价,提高模型生成晶体结构的准确性是本领域技术人员亟需解决的问题。
技术实现思路
1、鉴于上述问题,提出了本发明以便提供一种克服上述问题或者至少部分地解决上述问题的一种直接空间晶体流生成模型的强化学习方法,将晶体流模型的多步生成过程构造为具有可计算转移评分的随机生成轨迹,并依据生成晶体的材料评价结果对模型参数进行策略梯度更新。本发明应用于从头晶体结构生成,包括原子类型、分数坐标和晶格参数的联合生成,以及随机流转移构造、周期分数坐标处理、行为轨迹缓存、当前策略重算、多目标奖励计算、组相对优势估计、参考策略约束和结构弛豫评价等技术环节。
2、为了实现上述目的,本发明采用如下技术方案:
3、第一方面,本发明实施例提供一种直接空间晶体流生成模型的强化学习方法,包括以下步骤:
4、步骤1:获取预训练的直接空间晶体流生成模型;
5、步骤2:根据直接空间晶体流生成模型初始化策略参数;将直接空间晶体流生成模型的参数复制到策略参数;
6、步骤3:利用直接空间晶体流生成模型和策略参数生成多通道随机生成轨迹,并解算每条轨迹对应的联合对数评分;
7、步骤4:将每条轨迹的终止状态解码为一个候选晶体结构,并对候选晶体结构进行材料评价获得最终热力学评价;
8、步骤5:根据最终热力学评价对候选晶体结构计算轨迹级优势;
9、步骤6:使用策略参数中的当前策略对缓存轨迹重新计算联合对数评分,并结合轨迹级优势构建裁剪策略损失,更新优化直接空间晶体流生成模型;
10、步骤7:利用优化后的直接空间晶体流生成模型预测输出从头晶体结构。
11、优选的,在晶体结构数据集上完成预训练的直接空间晶体流生成模型表示为:
12、;
13、;
14、其中,表示第k步联合状态;为第k步的原子类型连续状态,为第k步的周期分数坐标,为第k步的晶格状态;表示根据k步联合状态和第k步生成时间输出的速度场;表示第k步的原子类型连续状态通道对应的速度场;表示第k步的周期分数坐标通道对应的速度场;表示第k步的晶格状态通道对应的速度场。
15、优选的,策略参数包括行为策略、当前策略和参考策略;行为策略用于生成并缓存轨迹;当前策略为待更新的策略,初始与行为策略相同;参考策略用于约束策略漂移,初始与行为策略相同。
16、优选的,步骤3中生成每条轨迹的每个生成步k的具体过程为:
17、步骤311:读取当前的第k步联合状态和生成时间,采用行为策略获得三种通道对应的速度场,三种通道包括原子类型、分数坐标和晶格;
18、步骤312:根据第k步联合状态、速度场和预设的离散时间步长计算条件转移中心,表示为:
19、;
20、其中,表示行为策略在通道c上加入随机扰动前的一步条件转移中心;当c=f时,表示分数坐标通道上加入随机扰动前的一步条件转移中心;表示状态通道,h、f和l分别表示原子类型通道、分数坐标通道和晶格通道;表示第k步联合状态在通道c上的状态分量;表示行为策略根据第k步联合状态和生成时间输出的通道c的速度场。
21、步骤313:对各通道设置独立的随机扰动标准差,表示为:
22、;
23、其中,表示通道c的随机扰动标准差;表示通道扩散系数;s()表示时间调度函数;
24、步骤314:对各通道采样相互独立的标准高斯噪声,并根据一步条件转移中心和随机扰动标准差计算第k+1步的随机联合状态,获得每个通道未经周期折叠的第k+1步的随机状态分量,表示为:
25、;
26、其中,表示通道c在第k步的标准高斯噪声;表示第k+1步随机联合状态在通道c上的随机状态分量;
27、步骤315:根据第k+1步随机联合状态对原子类型状态和晶格状态执行状态更新,对分数坐标执行周期折叠和状态更新,获得更新后的第k+1步的联合状态,第k+1步联合状态包括第k+1步的原子类型状态分量、晶格状态分量和分数坐标状态分量;表达式为:
28、;
29、;
30、;
31、其中,表示第k+1步的原子类型状态分量;表示第k+1步原子类型随机状态分量;第k+1步的晶格状态分量;第k+1步的晶格随机状态分量;表示第k+1步的分数坐标状态分量;表示第k+1步的分数坐标随机状态分量;wrap表示折叠操作。
32、优选的,步骤3还包括计算行为策略对每条轨迹的每个生成步k实际执行动作的联合对数评分,并关联缓存所有必要信息;具体过程为:
33、步骤321:根据各通道对应的第k+1步的状态和条件转移中心计算各通道残差,表达式为:
34、;
35、;
36、;
37、;
38、;
39、其中,表示原子类型残差,采用欧氏残差;表示晶格残差,采用欧氏残差;表示第k+1步分数坐标状态分量与未经周期等价处理的一步条件转移中心之间的原始分数坐标残差,用于确定周期等价代表元;表示对原始分数坐标残差按分量取整得到的最小像整数平移矩阵,表示整数集合,表示填充后的全部原子槽位;表示经周期等价处理后的分数坐标有效残差;
40、步骤322:根据各通道残差、随机扰动标准差和有效原子掩码对各通道有效原子维度求和,计算各通道对数评分,表示为:
41、;
42、其中,表示第i条轨迹中第k步的通道c的对数评分;表示第i条轨迹中第k步的通道c的实际评分残差,分别取原子类型残差、晶格残差或分数坐标有效残差,表示为:,,;表示通道c的随机扰动标准差;表示由有效原子掩码确定的有效标量维度索引集合,用于选取第条轨迹在通道c中参与求和的标量维度,填充原子对应的维度不纳入该索引集合;根据确定掩码长度,并结合第i条轨迹的实际有效原子数构造有效原子掩码,其中,有效原子槽位的掩码值为1,填充原子槽位的掩码值为0;
43、步骤323:将各通道的对数评分按照联合对数概率形式相加,计算联合对数评分,表达式为:
44、;
45、其中,表示第i条轨迹中第k步的联合对数评分;表示第i条轨迹中第k步的原子类型对数评分;表示第i条轨迹中第k步的分数坐标对数评分;表示第i条轨迹中第k步的晶格对数评分;
46、步骤324:针对第i条轨迹的第k步,将行为策略对应的联合对数评分与第k步联合状态、步骤315获得的下一步的联合状态、生成时间、离散时间步长、各通道的随机扰动标准差、有效原子掩码以及步骤321采用的按分量取整的最小像规则进行关联缓存,获得缓存数据。缓存数据供步骤53和步骤54在固定已采样相邻状态转移的条件下重算当前策略评分使用;表示第i条轨迹的第k步状态;表示对应的下一步状态。
47、优选的,根据原始分数坐标残差采用按分量取整的最小像规则计算最小像整数平移矩阵,利用最小像整数平移矩阵计算经周期等价处理后的分数坐标有效残差,分数坐标有效残差即为分数坐标的周期等价残差,表示为:
48、;
49、;
50、其中,round表示取整操作。
51、优选的,步骤4中进行材料评价的过程为:
52、步骤41:判断每个候选晶体结构是否满足预检规则;满足时将候选晶体结构标记为预检通过并进入步骤42;不满足时将其标记为评价失败,保留对应轨迹并进入步骤5;
53、步骤42:采用条件触发式两级弛豫对每一个候选晶体结构执行机器学习原子间势弛豫,获得凸包能差;具体过程为:
54、步骤421:利用结构弛豫算子对候选晶体结构执行第一深度弛豫,获得第一深度凸包能差,若计算过程未发生异常,则将该候选晶体结构标记为评价成功,进入步骤422;否则标记为评价失败,进入步骤5;表达式为:
55、;
56、;
57、其中,表示第一深度弛豫结构;表示第一深度弛豫预算;表示第一深度弛豫后的第一深度凸包能差;表示根据第一深度弛豫结构的能量、组成和参考相数据计算第一深度凸包能差的评价算子;
58、步骤422:如果第一深度凸包能差,为预设第二深度触发阈值,则对候选晶体结构执行第二深度弛豫获得第二深度凸包能差,若计算过程未发生异常,则将该候选晶体结构标记为评价成功,并将第二深度凸包能差传输至步骤43,若计算过程发生异常,则标记为评价失败,进入步骤5;
59、如果第一深度凸包能差,则将第一深度凸包能差传输至步骤43;
60、第二深度弛豫表达式为:
61、
62、其中,表示第二深度弛豫预算;表示第二深度弛豫后的第二深度凸包能差;评价成功是指结构弛豫和凸包能差计算未发生异常,且弛豫后结构与凸包能差均为有效有限值;
63、步骤43:根据每一个候选晶体结构的凸包能差确定对应的最终热力学评价,表示为:
64、或;
65、其中,表示最终热力学评价;第一深度凸包能差大于第二深度触发阈值时,保留第一深度凸包能差作为最终热力学评价;小于或等于该阈值时,对同一候选晶体结构执行第二深度弛豫,并在第二深度弛豫评价成功时,采用第二深度凸包能差作为最终热力学评价;第一深度弛豫或触发后的第二深度弛豫、结构解析或凸包能差计算发生异常,或者输出为非有限值时,将候选晶体结构标记为评价失败,并在步骤5赋予预设有限失败奖励。
66、优选的,预检规则包括多项判别约束:具有结构可解析性;有效原子数大于0;晶体体积为正且有限;周期性最小原子间距大于预设阈值。
67、优选的,步骤5的具体过程为:
68、步骤51:对评价成功的候选晶体结构,根据最终热力学评价、稳定或亚稳定阈值、成分有效性、创造性、成分多样性及结构多样性中的一种或多种得到奖励分量,并构造轨迹级总奖励;表达式为:
69、;
70、其中,表示奖励分量索引;表示第i个候选晶体结构经同一采样批次内标准化后的第j项奖励分量;表示第项奖励分量的预设权重;表示第i个候选晶体结构的轨迹级总奖励;奖励分量包括连续凸包能奖励、稳定阈值奖励、亚稳定阈值奖励、成分有效性奖励、创造性奖励、成分多样性奖励和结构多样性奖励中的一种或多种;连续凸包能奖励通过对最终的凸包能差在预设上下限内截断后取负值得到;根据最终热力学评价确定稳定阈值奖励和亚稳定阈值奖励,稳定阈值奖励在最终热力学评价不大于0 ev/atom时取1,否则取0;亚稳定阈值奖励在最终热力学评价不大于0.1 ev/atom时取1,否则取0;成分有效性奖励通过基于元素氧化态组合、电荷中性和电负性约束的成分有效性判定得到;创造性奖励先根据候选组成相对于训练集的约化组成新颖性及其在同一采样批次内的唯一性确定二值端点;处于边界情形时,在相同约化组成下,根据候选结构的平均最小距离描述符与批内其他候选结构及参考结构的描述符距离连续赋分;成分多样性奖励根据同一采样批次内候选组成的元素分数向量相对于参考组成集合的留一最大均值差异贡献得到;结构多样性奖励根据同一采样批次内候选结构平均最小距离描述符相对于参考结构集合的留一最大均值差异贡献得到;各奖励分量在同一采样批次内分别进行标准化后,按预设权重加权求和得到轨迹级总奖励;
71、对于评价失败的候选晶体结构,将其轨迹级总奖励设定为同一采样批次内评价成功的候选晶体结构对应轨迹级总奖励的最小值减去预设有限间隔,从而避免无效数值进入梯度,同时使失败轨迹相对于同组有效轨迹通常获得负优势;
72、步骤52:在一次强化学习迭代开始时固定步骤2中的行为策略参数,并利用行为策略生成一个采样批次的多条轨迹;将该采样批次内各轨迹终止状态对应的候选晶体结构划分为同一比较组,第i个候选晶体结构所在比较组的标识为;根据同一比较组内各候选晶体结构的轨迹级总奖励计算轨迹级优势,表示为:
73、;
74、其中,表示第i个候选晶体结构的轨迹级优势;和分别表示同一比较组内轨迹级总奖励的均值和标准差;表示用于数值稳定的预设正数,;表示轨迹级总奖励与比较组的对应关系,其中表示第m个候选晶体结构的轨迹级总奖励,表示第m个候选晶体结构所在比较组的标识;在优势计算式中,选取满足=gi的轨迹级总奖励组成同组轨迹级总奖励集合,该集合用于计算同一比较组内轨迹级总奖励的均值和标准差;同一轨迹的随后用于该轨迹所选生成步的策略梯度计算。
75、优选的,一次强化学习迭代包括轨迹采样阶段和参数优化阶段;在轨迹采样阶段,固定行为策略生成并缓存一批随机生成轨迹;在参数优化阶段,缓存轨迹本身保持不变,仅更新当前策略参数;每批轨迹仅用于一次参数更新;步骤6为参数优化阶段,具体过程为:
76、步骤61:从多通道随机生成轨迹的缓存数据中提取相邻状态转移对、生成时间、离散时间步长以及缓存的行为策略对应的联合对数评分;使用缓存的联合对数评分作为基准,并使用当前策略对第k步联合状态和对应生成时间执行前向计算,获得各通道的当前速度场,再根据当前速度场和离散时间步长计算当前条件转移中心,表示为:
77、;
78、其中,表示通道c的当前条件转移中心;表示通道c的当前速度场;表示第i条轨迹中通道c的第k步联合状态;其中,各通道随机扰动标准差、有效原子掩码和按分量取整的最小像规则在步骤62重算评分时使用;
79、步骤62:在不重新采样状态转移结果的情况下,以已缓存的第k+1步联合状态作为评分对象,根据缓存数据中各通道随机扰动标准差、有效原子掩码和按分量取整的最小像规则,分别重算三个通道的当前对数评分,进行求和获得当前联合对数评分;表示为:
80、;
81、其中,表示原子类型的当前对数评分;表示分数坐标的当前对数评分;表示晶格的当前对数评分;
82、对分数坐标通道,根据当前条件转移中心重新计算原始残差,并按照相同的按分量取整最小像规则确定当前分数坐标有效残差,利用当前分数坐标有效残差和随机扰动标准差计算当前分数坐标对数评分;当前分数坐标有效残差表达式为:
83、;
84、其中,表示分数坐标的当前条件转移中心;表示第k+1步的分数坐标状态分量;保证行为策略评分与当前策略重算对同一物理动作采用相同的周期语义;
85、步骤63:根据联合对数评分和当前联合对数评分之间的差值构造逐步重要性比率,表达式为:
86、;
87、步骤64:根据逐步重要性比率构建裁剪策略损失,作为本批轨迹一次参数更新的策略优化损失,裁剪策略损失表达式为:
88、;
89、其中,表示限制单次策略变化的预设裁剪宽度;表示对参与本次参数优化的轨迹和生成步的索引对(i,k)取平均获得的期望算子;表示第i条轨迹对应候选晶体结构的轨迹级优势;
90、在本轮参数更新开始时,当前策略与行为策略相同,故;在该更新起点,裁剪目标的梯度等价于以下分数函数梯度:
91、;
92、其中,表示策略梯度损失对当前策略参数的梯度;表示对当前策略参数求梯度;
93、步骤65:根据缓存的联合状态、生成时间、离散时间步长及各通道随机扰动标准差,使用参考策略对相同缓存联合状态和生成时间进行前向计算,得到各通道参考速度场和参考条件转移中心;将参考条件转移中心与当前条件转移中心按同一轨迹、生成步和通道一一对应,计算当前策略相对于参考策略的逐步参考约束;当前策略与参考策略在同一通道使用相同随机扰动方差,逐步参考约束采用参考条件转移中心与当前条件转移中心的均值差表示为:
94、;
95、其中,表示第i条轨迹第k步的通道c的逐步参考约束;表示通道c的当前条件转移中心;表示通道c的参考条件转移中心;表示通道c的的随机扰动标准差;
96、步骤66:对各轨迹、生成步和通道的逐步参考约束取平均得到参考约束项,并将策略优化损失与参考约束项组合为总损失,表示为:
97、;
98、步骤67:将参考约束项与预设熔断阈值比较;超过预设熔断阈值时,跳过本次参数更新;不超过预设熔断阈值时,对总损失执行反向传播,对当前策略参数的梯度执行全局梯度裁剪,并利用优化器对当前策略参数执行一次更新;
99、步骤68:本次参数更新完成后,参考策略在预设训练间隔内保持固定;达到预设刷新间隔时,将更新后的当前策略参数复制至参考策略;然后将更新后的当前策略作为下一轮行为策略,返回步骤3重新生成一个采样批次的轨迹。
100、优选的,使用更新后的直接空间晶体流生成模型从原子类型、分数坐标和晶格先验状态出发进行多步积分,联合生成候选晶体的原子类型、分数坐标和晶格参数,得到强化学习优化后的从头晶体结构。
101、优选的,预检规则还可包括晶格参数范围、晶格密度范围或晶格组成约束。
102、优选的,多目标奖励、时间步选择方式、参考策略刷新周期、两级弛豫深度及触发阈值均可根据数据集、预训练流模型和评价预算进行设置。
103、经由上述的技术方案可知,与现有技术相比,本发明公开提供了一种直接空间晶体流生成模型的强化学习方法,在轨迹采样阶段,对加入漂移和噪声后的分数坐标下一状态执行周期折叠,用于将实际动作放回固定基本域;在行为策略评分阶段及当前策略重算阶段,对动作与各自策略转移中心之间的残差执行同一周期等价代表映射,用于定义新旧转移评分。本发明将预训练晶体流模型的确定性生成过程构造为具有可计算转移评分的多通道随机策略,以生成晶体的材料评价结果形成轨迹级奖励,并通过组相对策略梯度更新模型参数。在周期晶体的直接空间流生成模型强化学习过程中,构造与分数坐标周期等价关系一致的随机转移评分,使同一物理动作的不同整数周期像获得一致评价,并保证行为策略轨迹缓存和当前策略重算采用相同的动作及评分语义,从而避免周期边界伪大残差污染策略梯度。有益效果具体包括:
104、(1)为原本确定性的直接空间晶体流积分构造可微、可缓存和可重算的多通道随机策略;步骤3将跨周期边界的物理小位移按最小镜像残差进行局部高斯转移评分,避免其被误判为接近一个晶格周期的大位移;行为策略评分缓存和当前策略重算复用相同的按分量取整最小像规则,使新旧评分之差主要反映策略参数变化而不是周期坐标表示差异,进而使重算得到的概率比率和策略梯度与晶体分数坐标的周期几何相符;
105、(2)使随机扰动尺度与离散时间步长相匹配,并排除无效填充原子的影响;生成多通道随机生成轨迹的过程中采用的随机扰动尺度包含离散步长的平方根因子,使改变积分步数时累计扩散强度不因逐步固定加噪而任意变化;原子类型、分数坐标和晶格通道可分别设置扩散尺度,并通过有效原子掩码排除填充原子对转移评分和策略梯度的干扰;
106、(3)通过逐步重要性比率和裁剪策略损失对每批缓存轨迹执行一次参数更新,使策略更新直接对应本批已采样状态转移;
107、(4)通过多通道参考策略转移约束、参考约束熔断、参考策略周期刷新和全局梯度裁剪限制策略漂移;
108、(5)通过条件触发式两级结构弛豫,兼顾了阈值附近评价可靠性与训练计算成本;
109、(6)无需将直接空间晶体流模型迁移至潜空间,即可利用晶体弛豫、凸包能差、结构匹配和数据库新颖性等非可微材料反馈更新原子类型、分数坐标和晶格的联合生成策略。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com