
甲基化和衰老的制作方法
背景技术:
1、衰老通常是指生物体中的进行性生理变化,其可从该生物体出生起随着时间流逝(即,实际年龄)而发生。生理变化可导致衰老、生物功能衰退和/或生物体适应代谢应激的能力下降。代谢应激可以由代谢紊乱驱动,所述代谢紊乱受环境因素,例如病原体、温度、噪声、毒素、营养应激(过量或缺乏)、氧化应激和缺氧的影响。衰老是疾病和残疾的主要原因。实际年龄可能是人类群体中许多疾病的风险因素,所述疾病例如心血管疾病、糖尿病、癌症、阿尔茨海默氏病和痴呆(partridge et al., 2018)。然而,直接基于实际年龄的某种疾病(例如,阿尔茨海默氏病、癌症、心血管疾病等)的预测能力可能很低(lowsky et al.,2014)。因此,获取改进的技术将是有益的。
技术实现思路
1、实施方案提供了用于确定和使用与各种组织和样本相关的甲基化水平的系统、方法和装置。提供了示例。甲基化水平可以基于血浆游离dna分子(或具有游离dna的其他样本,例如尿液、唾液、生殖器冲洗液)的位点的甲基化状态来推断。甲基化水平可以对应于cpg位点或基因,并且可以指示对象或特定组织的生物学年龄。因此,可以训练一个或多个机器学习模型以基于一个或多个cpg位点或一种或多种基因的一个或多个甲基化水平来预测生物学年龄。机器学习模型可以使用各种年龄的健康对象的甲基化水平数据来训练。
2、另外,对象的生物学年龄与实际年龄的比较可用于检测对象中病症的存在。例如,可以基于比较来检测对象或特定组织的年龄加速。年龄加速的水平可用于对病症的存在进行分类。当检测到病症存在时,可以基于表现出年龄加速的特定组织或基于具有指示年龄加速的甲基化水平的一个或多个cpg位点或一种或多种基因来确定该特定病症。
3、在一个实施方案中,提供了用于测量对象的生物学年龄的方法。所述方法可以由计算机系统执行,所述计算机系统接收包括在多个游离dna分子的位点处的甲基化状态的序列读数,并将序列读数与参考基因组进行比对,其中序列读数被比对到一个或多个cpg位点的n个集合。然后,对于一个或多个cpg位点的n个集合中的每个集合,计算机系统可以鉴定比对到参考基因组中一个或多个cpg位点的集合的一组序列读数,并使用该组序列读数的甲基化状态确定甲基化水平。此外,计算机系统可以:根据n个甲基化水平生成特征向量;将机器学习模型加载到计算机系统的存储器中,机器学习模型是使用具有已知实际年龄和测量的甲基化水平的参考向量的训练样本来训练的;将特征向量输入到机器学习模型中;并利用机器学习模型预测对象的生物学年龄。
4、在另一实施方案中,提供了用于检测具有已知实际年龄的对象中的病变的方法。所述方法可以由计算机系统执行,所述计算机系统接收包括在多个游离dna分子的位点处的甲基化状态的序列读数,并将所述序列读数与参考基因组进行比对,其中所述序列读数被比对到一个或多个cpg位点的n个集合。然后,对于一个或多个cpg位点的n个集合中的每个集合,计算机系统可以鉴定比对到参考基因组中一个或多个cpg位点的集合的一组序列读数,并使用该组序列读数的甲基化状态确定甲基化水平。此外,计算机系统可以:根据n个甲基化水平生成特征向量;将年龄依赖性机器学习模型加载到计算机系统的存储器中,年龄依赖性机器学习模型是使用具有已知的实际年龄、已知的病变分类和测量的甲基化水平的参考向量的训练样本来训练的;将特征向量输入到年龄依赖性机器学习模型中;以及通过使用特征向量的年龄依赖性机器学习模型来确定对象中病变的存在的分类。
5、另外,在另一实施方案中,提供了用于检测具有已知实际年龄的对象中的病变的方法。所述方法可以通过计算机系统执行,所述计算机系统接收包括在多个游离dna分子的位点处的甲基化状态的序列读数,并将所述序列读数与参考基因组进行比对。另外,对于一组或多组cpg位点的集合中的每一组,计算机系统可以:鉴定比对到所述组的cpg位点的集合中的任何cpg位点的一组序列读数,所述组的cpg位点的集合包括cpg位点的至少3个集合,其中所述组中的cpg位点的每个集合具有相对于甲基化水平随年龄变化的相同形态分类;以及使用所述组的序列读数的甲基化状态来确定一个或多个甲基化水平。此外,计算机系统可以使用随年龄变化的模型来确定对象中病变存在的分类,其中所述确定使用对象的已知实际年龄和一个或多个甲基化水平,并且其中所述模型是使用具有所述病变的已知分类的对象的参考样本来产生的。
6、下文详细描述了本公开的这些和其他实施方案。例如,其他实施方案涉及与本文描述的方法相关联的系统、设备和计算机可读介质。
7、参考以下详细描述和附图,可以获得对本公开的实施方案的特性和优点的更好理解。
8、附图的简要说明
9、图1显示了根据本公开的一些实施方案的对象的年龄分布的柱状图。
10、图2显示了根据本公开的一些实施方案的基因特异性5hmc甲基化水平的归一化标准偏差的图。
11、图3显示了根据本公开的一些实施方案,基于基因特异性5hmc甲基化水平的预测年龄与真实实际年龄对比的图。
12、图4是示出根据本公开的一些实施方案的用于测量对象的生物学年龄的方法的流程图。
13、图5a显示了根据本公开的一些实施方案,基于基因特异性甲基化水平的年龄预测与真实实际年龄对比的图。
14、图5b显示了根据本公开的一些实施方案的年龄加速的箱形图。
15、图6是示出根据本公开的一些实施方案的用于检测具有已知实际年龄的对象中的病症的方法的流程图。
16、图7显示了根据本公开的一些实施方案,在衰老过程中各种基因的cfdna 5hmc轨迹的图。
17、图8a显示了根据本公开的实施方案的线性型基因特异性cfdna 5hmc轨迹的图。
18、图8b显示了根据本公开的实施方案的对数型基因特异性cfdna 5hmc轨迹的图。
19、图8c显示了根据本公开的实施方案的二次型基因特异性cfdna 5hmc轨迹的图。
20、图8d显示了根据本公开的实施方案的指数型基因特异性cfdna 5hmc轨迹的图。
21、图9a显示了根据本公开的实施方案的基因特异性cfdna 5hmc轨迹的图。
22、图9b显示了根据本公开的实施方案的基因特异性cfdna 5hmc轨迹的图。
23、图9c显示了根据本公开的实施方案的基因特异性cfdna 5hmc轨迹的图。
24、图9d显示了根据本公开的实施方案的基因特异性cfdna 5hmc轨迹的图。
25、图10a显示了根据本公开的实施方案的具有年龄指示的基因特异性cfdna 5hmc轨迹的图。
26、图10b显示了根据本公开的实施方案的具有年龄指示的基因特异性cfdna 5hmc轨迹的图。
27、图10c显示了根据本公开的实施方案的具有年龄指示的基因特异性cfdna 5hmc轨迹的图。
28、图10d显示了根据本公开的实施方案的具有年龄指示的基因特异性cfdna 5hmc轨迹的图。
29、图11显示了根据本公开的实施方案的衰老过程中cfdna 5hmc轨迹的图。
30、图12a显示了根据本公开的一些实施方案的器官特异性年龄预测与真实实际年龄对比的图。
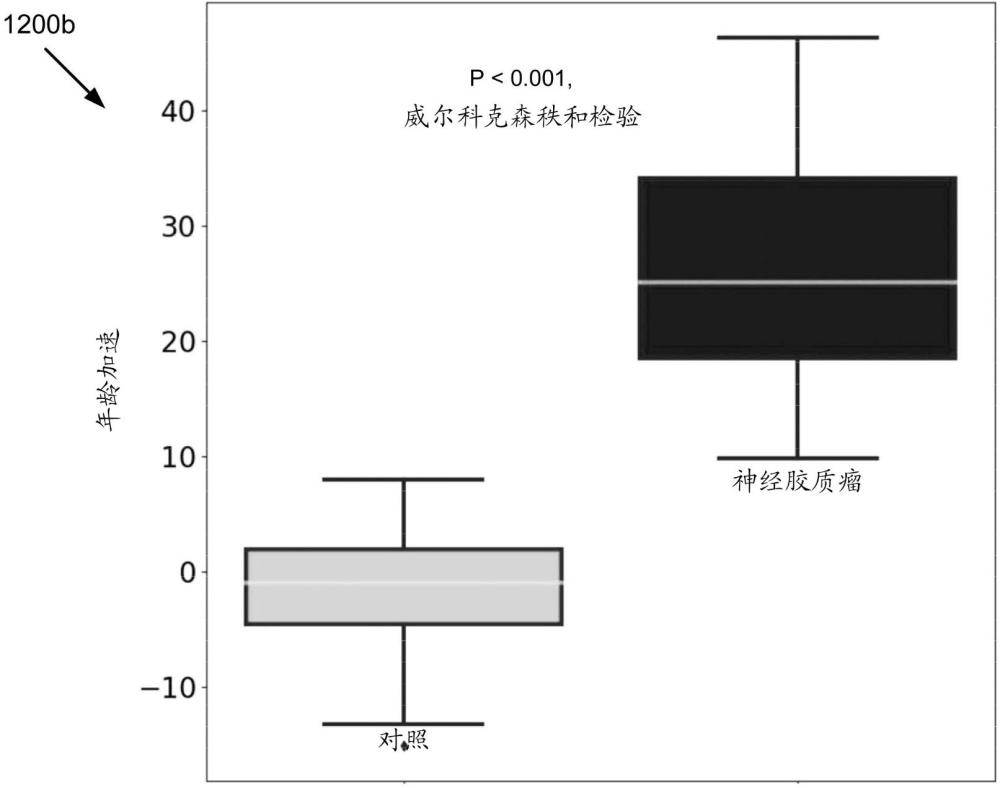
31、图12b显示了根据本公开的一些实施方案的器官特异性年龄加速的箱形图。
32、图13a显示了根据本公开的一些实施方案的器官特异性年龄预测与真实实际年龄对比的图。
33、图13b显示了根据本公开的一些实施方案的器官特异性年龄预测与真实实际年龄对比的图。
34、图13c显示了根据本公开的一些实施方案的器官特异性年龄预测与真实实际年龄对比的图。
35、图13d显示了根据本公开的一些实施方案的器官特异性年龄预测与真实实际年龄对比的图。
36、图14显示了根据本公开的一些实施方案的器官特异性年龄模型的皮尔森相关系数值的图。
37、图15是示出根据本公开的一些实施方案的用于检测具有已知实际年龄的对象中的病症的方法的流程图。
38、图16显示了根据本公开的一些实施方案的基于胞嘧啶甲基化水平的年龄预测与真实实际年龄对比的图。
39、图17a显示了根据本公开的一些实施方案,真实实际年龄和预测年龄之间的皮尔森相关系数与在相应年龄预测模型中使用的基因特征数目对比的图。
40、图17b显示了根据本公开的一些实施方案,真实实际年龄和预测年龄之间的皮尔森相关系数与在相应年龄预测模型中使用的基因特征数目对比的表。
41、图18a显示了根据本公开的一些实施方案的真实实际年龄和预测年龄之间的皮尔森相关系数与在相应的年龄预测模型中使用的cpg位点特征数目对比的另一幅图。
42、图18b显示了根据本公开的一些实施方案,真实实际年龄和预测年龄之间的皮尔森相关系数与在相应的年龄预测模型中使用的cpg位点数目对比的另一个表。
43、图19a显示了根据本公开的一些实施方案的对照和具有不同肿瘤阶段的hcc患者的基于胞嘧啶甲基化水平的年龄预测与真实实际年龄对比的图。
44、图19b显示了根据本公开的一些实施方案的对照和具有不同肿瘤阶段的hcc患者的年龄加速差异的箱形图。
45、图20示出了根据本发明实施方案的系统。
46、图21显示了可以与根据本发明的某些实施方案的系统和方法一起使用的示例计算机系统的框图。
47、术语
48、“
组织”对应于一组一起作为功能单元的细胞。在单一组织中可以发现多于一种类型的细胞。不同类型的组织可由不同类型的细胞(例如,肝细胞、肺泡细胞或血细胞)组成,但也可对应于来自不同生物体(母亲与胎儿)的组织或对应于健康细胞与肿瘤细胞的组织。
49、“
生物样本”是指获取自对象(例如人类,诸如怀孕的女性、患有癌症的个人、或疑似患有癌症的个人、器官移植接受者或疑似患有涉及器官(例如心肌梗塞中的心脏、或中风中的脑、或贫血中的造血系统)的疾病过程的对象)并包含一个或多个所关注的核酸分子的任何样本。生物样本可以是体液,例如血液、血浆、血清、尿液、阴道液、来自阴囊水肿(例如睾丸)的液体、阴道冲洗液、胸水、腹水、脑脊髓液、唾液、汗液、泪液、痰、支气管肺泡灌洗液、腹膜透析液、乳汁、来自身体不同部分(例如甲状腺、乳腺)的抽吸液等。也可使用粪便样本。在各种实施方案中,已富集游离dna的生物样本(例如经由离心方案获得的血浆样本)生物样本中的大部分dna可以是游离的,例如多于50%、60%、70%、80%、90%、95%或99%的dna可以是游离的。离心方案可以包括,例如3,000 g × 10分钟获得液体部分,随后以例如30,000 g再离心10分钟以移除剩余细胞。作为生物样本的分析的一部分,可以分析生物样本的统计学上显著数目的游离dna分子(例如以提供准确的测量结果)。在一些实施方案中,分析至少1,000个游离dna分子。在其他实施方案中,可以分析至少10,000个或50,000个或100,000个或500,000个或1,000,000个或5,000,000个或更多个游离dna分子。可以分析至少相同数目的序列读数。本文所描述的任何量可以是上文所列出的任何数字。样本的示例尺寸可以包括30、50、100、200、300、500、1,000、5,000或10,000或更多纳克,或1、2、3、4、5、6、7、8、9或10ml。
50、术语“
对照”、“
对照样本”、“
背景样本”、“
参考”、“
参考样本”、“
正常”和“
正常样本”可互换地用于一般性地描述不具有特定病况或在其他方面健康的样本。在一个示例中,具有污染性dna的无模板对照(ntc)样本可以被认为是参考样本。在另一示例中,参考样本是提取自没有感染的对象的样本。可以从对象或从数据库获得参考样本。参考一般是指参考基因组,其用于映射从来自对象的样本测序获得的序列读数。参考基因组一般是指单倍体或二倍体基因组,可以将其与来自生物样本的序列读数进行比对和比较。对于单倍体基因组,在每个基因座处仅有一个核苷酸。对于二倍体基因组,可以鉴定杂合基因座,此类基因座具有两个等位基因,其中任一等位基因可以允许与该基因座进行比对的匹配。参考基因组(例如,通过包括一个或多个微生物基因组)可以是对应于特定微生物物种的参考微生物基因组。
51、如本文所使用的术语“片段”(例如dna或rna片段),可指包含至少3个连续核苷酸的多核苷酸或多肽序列的一部分。核酸片段可以保留母体多肽的生物活性和/或一些特征。核酸片段可以是双链的或单链的、甲基化的或未甲基化的、完整的或缺刻的、与其他大分子(例如,脂质颗粒、蛋白质)复合的或不复合的。核酸片段可以是线性片段或环状片段。肿瘤来源的核酸可以指从肿瘤细胞释放的任何核酸,包括来自肿瘤细胞中病原体的病原体核酸。作为生物样本分析的一部分,可以分析统计学上显著数目的片段,例如,可以分析至少1,000个片段。作为其他示例,可以分析至少5,000个、10,000个或50,000个或100,000个或500,000个或1,000,000个或5,000,000个或更多片段,并且可以随机选择或根据一个或多个标准选择此类片段。
52、术语“测定”通常是指用于确定核酸或核酸样本(例如,统计学上显著数目的核酸)的特性以及从中获得样本的对象的特性的技术。测定(例如,第一测定或第二测定)通常是指用于确定样本中核酸的量、样本中核酸的基因组身份、样本中核酸的拷贝数变化、样本中核酸的甲基化状态、样本中核酸的片段尺寸分布、样本中核酸的突变状态或样本中核酸的片段化模式的技术。本领域技术人员已知的任何测定可用于检测本文提及的核酸的任何特性。核酸的特性包括序列、量、基因组身份、拷贝数、在一个或多个核苷酸位置处的甲基化状态、核酸的尺寸,在一个或多个核苷酸位置处的核酸中的突变,以及核酸的片段化模式(例如,核酸片段所处的核苷酸位置)。术语“测定”可以与术语“方法”互换使用。测定或方法可以(例如,基于一个或多个截止值的选择)具有特定的灵敏度和/或特异性,并且可以使用接收者操作特征(roc)曲线下面积(auc)测量它们作为诊断工具的相对有用性。
53、术语“基因”是指涉及产生多肽链或转录的rna产物的dna片段。其可以包括在编码区之前和之后的区域(前导和尾部)以及在各个编码段(外显子)之间的插入序列(内含子)。
54、“
序列读数”是指从核酸分子的任何部分或全部获得的一系列核苷酸序列。例如,序列读数可以是从核酸片段测序的短核苷酸系列(例如20个至150个核苷酸)、在核酸片段的一端或两端的短核苷酸系列,或存在于生物样本中的整个核酸片段的测序。序列读数可以通过各种方式获得,例如使用测序技术或使用探针(例如在杂交阵列或可用于微阵列的捕获探针中)或扩增技术(例如聚合酶链式反应(pcr)或使用单一引物进行的线性扩增或等温扩增)。示例测序技术包括高通量平行测序、靶向测序、桑格测序(sanger sequencing)、通过连接进行的测序、离子半导体测序和单分子测序(例如使用纳米孔测序,或单分子实时测序(例如来自pacific biosciences)。此类测序可以是随机测序或靶向测序(例如,通过使用与指定区域杂交的捕获探针或通过扩增某些区域,两种方法都富集此类区域)。示例基于探针的技术包括实时pcr和数字pcr(例如微滴式数字pcr)。作为生物样本分析的一部分,可以分析统计学上显著数目的序列读数,例如可以分析至少1,000个序列读数。作为其他示例,可以分析至少5000个、10,000个或50,000个或100,000个或500,000个或1,000,000个或5,000,000个或更多个序列读数。此外,对于本公开的实施方案确定的序列读数的量可以是至少1,000个、5,000个、10,000个、50,000个、100,000个、100,000个、500,000个、1,000,000个或5,000,000个。
55、术语“
映射(mapping)”或“
比对(aligning)”是指将序列与具有已知参考序列的参考(例如参考基因组)中的位置或坐标(例如基因组坐标)相关联的过程,其中所述序列与参考中位置处的已知参考序列相似。可以根据“
映射质量”来测量或报告相似程度。在本文所使用的映射质量的一个示例中,序列相对于参考中报告的位置或坐标的映射质量x表示该序列映射至不同位置的概率不大于10^(-x/10)。例如,映射质量30表示序列映射到另一个位置概率小于0.1%。
56、“
参考基因组”或“
参考序列”可以是参考生物体的整个基因组序列、可以连续或可以不连续的参考基因组的一个或多个部分、多个参考生物体的共有序列、基于不同生物体的不同组分的编译序列,或任何其他合适的参考序列。作为示例,参考基因组/序列可以是至少1,000、10,000、50,000、100,000、500,000、1,000,000、5,000,000、10,000,000、50,000,000、100,000,000、500,000,000、10亿或30亿个核苷酸长,例如完整的人类基因组或重复掩蔽的人类基因组。参考还可以包括关于已知在生物体群体中发现的参考的变化的信息。
57、“
位点”(也称为“
基因组位点”)对应于单个位点,其可以是单个碱基位置或一组相关的碱基位置,例如cpg位点、tss位点、dnase超敏反应位点或更大组的相关碱基位置。“基因座”可对应于包括多个位点的区域。基因座可以仅包括一个位点,这将使得该基因座等同于上下文中的位点。可以限定位点周围的区域,例如位点周围的对称或不对称的区域。作为示例,区域可以包括在位点之前和之后的至少+/-50个碱基(例如,101个碱基)、+/-60个碱基、+/-70个碱基、+/-80个碱基、+/-90个碱基、+/-100个碱基、+/-150个碱基、+/-200个碱基、+/-300个碱基、+/-400个碱基。+/-500个碱基、+/-600个碱基、+/-700个碱基、+/-800个碱基、+/-900个碱基和+/-1,000个碱基。作为其他示例,区域可以为至少100个碱基、140个碱基、147个碱基或167个碱基长。可以分析一个或多个区域,例如,以提供病变(例如,癌症)等级或特定组织的比例。可以分析各种数目的区域、位点或基因座,例如50、100、200、500、1,000、5,000、10,000、50,000、100,000、500,000、一百万或更多。各种技术,例如将序列读数与参考基因组进行比对或使用位置特异性探针,可以确定dna分子位于参考基因组中的一种或多种基因组位置。可对参考基因组的一些或全部进行位置确定,例如,如果仅分析基因组的一部分的情况下。作为示例,所分析的基因组的量可以大于0.01%、0.1%、1%、5%、10%或50%。“
切割位点”可以指dna被核酸酶切割从而产生dna片段的位置。
58、哺乳动物基因组中的“
dna甲基化”通常是指在cpg二核苷酸中的胞嘧啶残基的5’碳上添加甲基(即,5-甲基胞嘧啶)。dna甲基化可以发生在其他背景下的胞嘧啶中,例如chg和chh,其中h是腺嘌呤、胞嘧啶或胸腺嘧啶。胞嘧啶甲基化也可以是5-羟甲基胞嘧啶的形式。还报道了非胞嘧啶甲基化,例如n6-甲基腺嘌呤。
59、每个基因组位点(例如,cpg位点)的“
甲基化指标”可以指在该位点处显示甲基化的dna片段数(例如,如由序列读数或探针确定)相比于覆盖该位点的读数总数的比例。“
甲
基化状态”可以指特定位点是否在dna片段的特定位点处甲基化,或者基因组的特定位点是否具有特定的差异甲基化状态,例如高甲基化或低甲基化。“读数”可以包括从dna片段获得的信息(例如位点处的甲基化状态)。可以使用优先与特定甲基化状态的dna片段杂交的试剂(例如引物或探针)获得读数。通常,此类试剂在使用根据dna分子的甲基化状态,有差异地修饰或有差异地识别dna分子的方法处理之后施加,所述方法为例如亚硫酸氢盐转化,或甲基化敏感限制酶,或甲基化结合蛋白,或抗甲基胞嘧啶抗体,或识别甲基胞嘧啶及羟甲基胞嘧啶的单分子测序技术。
60、区域或一组位点的“
甲基化密度”可以指该区域(也称为箱(bin))或该位点的集合内显示甲基化的位点的读数数目除以覆盖该区域或该位点的集合中的位点的读数总数。区域可以包括所关注的一个或多个位点,包括至少1个、2个、3个、4个、5个、10个、20个、50个、100个、200个、500个和1,000个位点。位点可以具有指定特性,例如为cpg位点。因此,区域的“cpg甲基化密度”可以指显示cpg甲基化的读数数目除以覆盖区域中的cpg位点(例如特定cpg位点、cpg岛或较大区域内的cpg位点)的读数总数。例如,人类基因组中每100 kb箱的甲基化密度可以根据亚硫酸氢盐处理之后于cpg位点处未转化的胞嘧啶(其对应于甲基化胞嘧啶)的总数相对于映射到100 kb区域的序列读数所覆盖的所有cpg位点的比例来确定。也可以对其他箱尺寸进行此分析,例如500 bp、5 kb、10 kb、50-kb或1-mb等。区域可以是整个基因组或染色体或染色体的一部分(例如染色体臂)。当区域仅包括cpg位点时,cpg位点的甲基化指标与区域的甲基化密度相同。“甲基化胞嘧啶的比例”可以指展示为甲基化(例如在亚硫酸氢盐转化之后未转化)的胞嘧啶位点“c”的数目相对于分析的胞嘧啶碱基的总数,即包括区域中除cpg背景之外的胞嘧啶。甲基化指标、甲基化密度和甲基化胞嘧啶的比例是“甲基化水平”的示例。除亚硫酸氢盐转化之外,那些本领域技术人员已知的其他方法可用于检测dna分子的甲基化状态,包括(但不限于)对甲基化状态敏感的酶(例如,甲基化敏感限制酶)、甲基化结合蛋白、使用对甲基化状态敏感的平台的单分子测序(例如,纳米孔测序(schreiber et al. proc natl acad sci usa 2013; 110: 18910-18915)或通过pacificbiosciences单分子实时测序分析(tse et al. proc natl acad sci usa 2021; 118:e2019768118))。
61、“
甲基化水平”是相对丰度的示例,例如在(例如,在一个或多个特定位点)甲基化的dna分子和其他dna分子(例如,所有其他dna分子或只有在一个或多个特定位点处未甲基化的dna分子)之间的相对丰度。其他dna分子的量可以充当归一化因子。作为另一示例,可以确定在一个或多个位点处甲基化dna分子的强度(例如荧光或电强度)相对于所有dna分子或未甲基化的dna分子的强度。相对丰度还可以包括每体积的强度。甲基化水平可以使用甲基化感知分析,例如甲基化感知测序或pcr来确定。示例性甲基化感知测序可包括亚硫酸氢盐测序或例如使用纳米孔的单分子技术。
62、差异甲基化区域(dmr)是跨越两个或更多个生物样本的具有不同dna甲基化水平的基因组区域(例如,位点集合)。不同dna甲基化水平可以由甲基化指标或密度的特定差异定义,例如(但不限于)1%、5%、10%、20%、30%、40%、50%、60%、70%、80%、90%、95%、99%等。可以以类似的方式定义差异甲基化位点(dms)。
63、如本文所使用的术语“
分类”是指与样本的特定特性相关的任何数字或其他字符。例如,符号“+”(或词语“阳性”)可以表示样本归类为具有缺失的部分或扩增的部分。分类可以是二元(例如阳性或阴性)或具有更多的分类级别(例如从1至10或0至1的标度),包括概率。可以组合用于确定分类的不同技术,以例如通过多数投票或要求所有初始/中间分类都相同(例如,阳性),从用于不同技术中的每个技术的初始或中间分类获得最终分类。
64、用于甲基化的术语“
形态分类”可以指基因的甲基化如何随年龄变化而变化。不同的基因增加或减少的方式将不同,并且此类增加或减少也会变化。给定的分类可以对应于在每个年龄的一个或多个甲基化水平中的基因的特定变化模式。例如,对于给定的基因集合,基因的甲基化水平随衰老时间的变化模式(例如轨迹)可能是类似的。因此,基因的集合可以具有相同的形态分类。形态分类的示例包括线性型、对数型、二次型(例如,凸型或凹型)和指数型。
65、术语“生物学年龄”可以对应于与生物体的实际功能状态相关的特征,其中此类特征随时间变化。
66、术语“
截止值”和“
阈值”是指操作中所使用的预先确定的数值。例如,截止值尺寸可以指一种尺寸,超过该尺寸的片段将被排除。作为另一示例,阈值可以是一种值,高于或低于该值则适用特定的分类。这些术语中的任一个可用于这些情形中的任一种。截止值或阈值可以为表示特定分类或区别两个或更多个分类的“参考值”或衍生自该参考值。可以在参考或不参考样本或对象的特征的情况下预先确定截止值。例如,可以基于测试对象的年龄或性别来选择截止值。可以在测试数据的输出之后并基于测试数据的输出来选择截止值。例如,当样本的测序达到一定深度时,可以使用特定的截止值。作为另一个示例,具有一种或多种病症的已知分类和测量的特征值(例如,甲基化水平、统计尺寸值或计数)的参考对象可用于确定参考水平以区分不同的病症和/或病症的分类(例如,对象是否患有病症)。可以选择参考值作为一个分类的代表(例如平均值)或介于度量的两个集群之间的值(例如被选择以获得期望灵敏度和特异性)。作为另一示例,可以基于样本的统计模拟来确定参考值。可以在任一个这些背景下使用这些术语的任一个。可以以各种方式测定此类参考值,如技术人员将理解的。例如,可以针对具有不同已知分类的两个不同群组的对象确定度量,并且可以选择。作为另一示例,参考值可以基于样本的统计模拟来确定。特定的截止值、阈值、参考值等可以基于所需的准确度(例如,灵敏度和特异性)来确定。
67、术语“
灵敏度”或“
真阳性率”(tpr)可以指真阳性的数目除以真阳性和假阴性的数目之和。灵敏度可以表征测定或方法正确鉴定真正具有病状的群体的比例的能力。例如,灵敏度可以表征方法正确鉴定具有感染的群体中对象数目的能力。在另一示例中,灵敏度可以表征方法正确鉴定一个或多个指示感染的标记物的能力。
68、术语“
特异性”或“
真阴性率”(tnr)可以指真阴性的数目除以真阴性和假阳性的数目之和。特异性可以表征测定或方法正确鉴定真正不具有病症的群体的比例的能力。例如,特异性可以表征方法正确鉴定不具有感染的群体中对象数目的能力。在另一示例中,特异性可以表征方法正确鉴定一个或多个指示感染的标记物的能力。
69、术语“
癌症等级”可以指癌症是否存在(即,存在或不存在)、癌症的阶段、肿瘤的尺寸、是否存在转移、身体的总肿瘤负荷、癌症对治疗的反应和/或癌症严重度的其他量度(例如癌症复发)。癌症等级可以是数字或其他标志,例如符号、字母和颜色。等级可以是零。癌症等级也可以包括恶化前或癌变前的病况(状态)。癌症等级可以以多种方式使用。例如,筛查可以检查先前未知患有癌的某人体内是否存在癌症。评估可以调查已经被诊断患有癌症的某人以随时间推移监测癌症的进展、研究疗法的有效性或确定预后。在一个实施方案中,预后可以表示为患者死于癌症的概率,或指定期限或时间之后癌症进展的概率,或癌症转移的概率或程度。检测可以意指‘筛查’或可以意指检查具有癌症的特征(例如症状或其他阳性测试)的某人是否患有癌症。可以确定各种类型的癌症等级,例如,癌或肉瘤、黑色素瘤、淋巴瘤和白血病,以及各种来源的组织,包括例如:乳腺、肺、肝脏、结肠、胰腺、胃、骨、血液、头部和颈部(例如,头颈鳞状细胞癌)、咽喉、膀胱、肾脏、前列腺、子宫、直肠、胆管、脑、眼、食道、卵巢、口腔、鼻咽、甲状腺、尿道、睾丸、阴道和垂体的癌症等级。
70、
“病变等级”(也称为病状)可以指与生物体相关的病变的量、程度或严重度,其中等级可以是如上文针对癌症所描述的。病变的另一个示例为移植器官的排斥反应。其他示例病变可以包括自身免疫攻击(例如损伤肾脏的狼疮性肾炎或损伤中枢神经系统的多发性硬化症)、炎症疾病(例如肝炎)、纤维化过程(例如肝硬化)、脂肪浸润(例如脂肪肝疾病)、退化过程(例如阿兹海默氏症(alzheimer's disease))和缺血性组织损伤(例如心肌梗塞或中风)。对象的健康状态可以被视为无病变的分类。
71、“
机器学习模型”(ml模型)可以指被配置成在一个或多个处理器上运转以提供一个或多个样本的特性的分类或数值的软件模块。可以使用样本数据(例如,训练样本)来生成ml模型以对测试数据进行预测。可以使用各种数目的训练样本,例如,至少10个、100个、1,000个、5,000个、10,000个、50,000个或100,000个训练样本。一个示例是无监督学习模型,例如隐马尔可夫模型(hmm)、聚类(例如,分层聚类、k-均值、混合模型、基于模型的聚类、基于密度的噪声应用空间聚类(dbscan)和optics算法)、用于学习潜变量模型的方法,例如期望最大化算法(em)、矩估计法和盲信号分离技术(例如,主成分分析、独立成分分析、非负矩阵分解、奇异值分解)和异常检测(例如,局部离群因子和孤立森林)。另一示例类型的模型是可以与本公开的实施方案一起使用的监督式学习。示例监督式学习模型可以包括不同的方法和算法,包括分析学习、统计模型、人工神经网络、提升(boosting)(共通式算法)、反向传播、自举聚合(bagging)(例如随机森林、支持向量机(svm)、支持向量回归(svr))、贝叶斯统计(bayesian statistics)、病例式推理、判定树学习、归纳逻辑程序设计、高斯过程回归(gaussian process regression)、遗传规划、数据分组处理法、核估计法(kernelestimator)、学习自动机、学习分类系统、最小信息长度(判定树、决策图等)、多线性子空间学习、单纯贝氏分类器(naive bayes classifier)、最大熵分类器、条件随机场、最近相邻算法、概率近似正确学习(pac)学习、涟波下降规则(ripple down rule)、知识获取方法、符号机器学习算法、子符号机器学习算法、最小复杂度机器(mcm)、随机森林、分类器集成、有序分类、数据预处理、处理不平衡数据集、统计关系学习或proaftn(一种多准则分类算法)。模型可包括线性回归、逻辑回归、深度循环神经网络(例如长短期内存,lstm)、隐藏式马可夫模型(hidden markov model,hmm)、线性判别分析(lda)、k平均分群、基于密度的噪声应用空间聚类(dbscan)、随机森林算法、支持向量机(svm)或本文所描述的任何模型。可以以各种方式使用定义来自已知标签的误差(例如,最小平方以及与已知分类的绝对差异)的各种成本/损失函数和各种优化技术,例如,使用反向传播、最陡下降、共轭梯度和牛顿与准牛顿技术来训练监督式学习模型。
72、如本文所使用的术语,“
基于”是指“
至少部分基于”,并且是指一个值(或结果)用于确定另一个值,例如发生在方法的输入与该方法的输出之间的关系中的值。如本文所使用的术语“
推导(derive)”还指方法的输入与该方法的输出之间的关系。
73、术语“约(about)”或“大约(approximately)”可意指在如通过本领域的一般技术人员所确定的特定值的可接受误差范围内,所述误差范围将部分取决于测量或确定该值的方式,即测量系统的限制。例如,根据本领域中的实践,“约”可以意指在1个或大于1个标准偏差内。或者,“约”可以意指给定值的至多20%、至多10%、至多5%或至多1%的范围。可替代地,特别是关于生物系统或方法,术语“约”或“大约”可以意指在值的一定数量级内、在5倍内或更优选地在2倍内。如果本技术和权利要求书中描述特定值,除非另有说明,否则应假设术语“约”意指在特定值的可接受误差范围内。术语“约”可以具有如本领域一般技术人员通常理解的含义。术语“约”可以指±10%。术语“约”可以指±5%。
74、在提供了值的范围的情况下,应了解除非上下文另外明确规定,还具体公开了每个在该范围的上限与下限之间的精确至下限单位的十分位的每个中间值。本公开的实施方案内涵盖了陈述范围中的任何所陈述值或中间值之间的每个更小的范围和所陈述范围中的任何其他所陈述值或中间值。这些更小的范围的上限和下限可以独立地包括或排除在该范围内,并且包括在更小范围中的任一界限、无界限或两个界限的各范围也涵盖于本公开内,受制于所陈述范围中任何特别排除的界限。在所陈述范围包括界限中的一个或两个时,排除那些所包括的界限中的任一个或两个的范围也包括在本公开中。
75、可以使用标准缩写,例如bp,碱基对;kb,千碱基;pi,皮升;s或sec,秒;min,分钟;h或hr,小时;aa,氨基酸;nt,核苷酸;等。
76、除非另外定义,否则本文所使用的所有技术和科学术语均具有与本公开所属领域的一般技术人员通常所理解的相同含义。尽管在本公开的实施方案的实践和测试中可以使用与本文所描述的那些相似或等效的任何方法和材料,但现在可以描述一些潜在的与示例性的方法和材料。
77、详细描述
78、游离dna(cfdna)可以以短片段的形式天然存在于各种类型的生物样本中,例如血浆、尿液、唾液、脑脊液、胸腔积液、羊水、腹膜液和腹水中。与包含在特定组织中的dna相比,血浆或其他生物样本可以携带从各种组织的死亡细胞释放的cfdna分子。因此,对来自生物样本的cfdna的检测可以提供最小侵入方式来获取来自各种组织的dna分子。这能够检测和分析异常或病变组织(例如,器官)。例如,cfdna的分析可用于非侵入性产前测试(lo etal., 1997)、癌症检测(leon et al., 1977; mandel, 1948),和器官移植监测(lo etal., 1998)。
79、5-羟甲基胞嘧啶(5hmc)和5-甲基胞嘧啶(5mc)是可以影响基因表达的修饰形式的胞嘧啶。可以使用各种技术从cfdna检测5hmc水平,所述技术例如涉及亚硫酸氢盐测序、酶促消化、化学标记、基于抗体的富集、液相色谱-串联质谱等的那些技术。还可以使用各种技术从cfdna检测胞嘧啶甲基化水平(例如,5hmc水平、5mc水平或其组合),所述技术例如亚硫酸氢盐测序、简并代表性亚硫酸氢盐测序(reduced representation bisulfitesequencing)、微阵列、甲基化dna免疫沉淀、纳米孔测序和单分子实时(smrt)测序。5hmc水平或胞嘧啶甲基化水平随时间的变化可以基于来自不同已知实际年龄的对象的cfdna来估计。5hmc水平或胞嘧啶甲基化水平的此类变化可以与生物过程(例如衰老和疾病进展)相一致。因此,来自特定对象的cfdna中的5hmc水平或胞嘧啶甲基化水平可以指示对象的一个或多个生物过程的状态(例如,生物学年龄或疾病的进展水平)。
80、为了确定生物过程的状态,可以开发分析一个或多个cpg位点的5hmc水平或胞嘧啶甲基化水平的方法。另外地或者可选择地,可以开发分析一种或多种基因的5hmc水平或胞嘧啶甲基化水平的方法。例如,可以将序列读数与参考基因组进行比对,所述序列读数具有来自对象的一个或多个cfdna分子的一个或多个位点的甲基化状态。甲基化状态可以指示每个位点处5hmc修饰或5mc修饰的存在或不存在。作为将序列读数与参考基因组比对的结果,可以确定序列读数所对应的cpg位点,并且可以推导一个或多个cpg位点的集合的甲基化水平。在一些示例中,还可以鉴定cpg位点所对应的基因,并且可以推断基因特异性甲基化水平。例如,对于对应于给定基因的给定的cpg位点的集合,相应的基因特异性甲基化水平(例如,基因特异性5hmc或胞嘧啶甲基化水平)可以代表相对于与所述基因相关的位点总数,具有5hmc或5mc修饰的cpg位点的数目。
81、另外,可以开发用于预测生物过程状态的模型。例如,可以使用来自不同年龄、疾病状态的对象(例如,健康对象或诊断患有特定疾病的对象)的生物样本的甲基化水平(例如,5hmc水平或胞嘧啶甲基化水平)或其组合来开发一种或多种机器学习模型。可以使用来自不同年龄的健康对象的生物样本的甲基化水平来训练特定的机器学习模型。作为训练的结果,机器学习模型可以基于接收具有cpg位点的集合、基因集合、对应于一种或多种基因的cpg位点的集合或其组合的甲基化水平的输入来输出预测的生物学年龄。因此,机器学习模型可以利用针对cpg位点的集合、基因集合、对应于一种或多种基因的cpg位点的集合或其组合的时间依赖性甲基化模式来预测对象的生物学年龄。在一些示例中,可以将通过机器学习模型输出的对象的预测生物学年龄与对象的真实实际年龄进行比较以揭示年龄异常(例如,年龄加速或减速)。年龄异常可以指示对象的健康问题,例如病症的存在。
82、在一些示例中,可以进一步开发用于分类一种或多种疾病的存在或进展的模型。例如,可以训练一个或多个机器学习模型以基于甲基化水平和对象的已知实际年龄对病症的存在或进展进行分类。在一个示例中,可以训练机器学习模型以基于已知实际年龄和预测的生物学年龄之间的差异对病症的存在进行分类。在另一示例中,机器学习模型可以在特定年龄范围内并具有已知病变分类(例如,对于病症为阳性或对于病症为阴性)的对象的甲基化水平上进行训练。基于训练,机器学习模型然后可以基于来自所述年龄范围内的对象的生物样本的甲基化水平输出病症的存在或进展的分类。
83、另外,用于年龄预测、疾病分类或其组合的cpg位点、基因或具有相应基因的cpg位点可以与指定组织类型,例如指定器官相关。例如,指定组织类型可以包括骨髓、脑、卵巢、胰腺、肝脏、下丘脑、心脏、肾脏、膀胱、前列腺、淋巴结、乳腺、肺、皮肤和睾丸。与每个cpg位点和/或基因相关的组织类型可以基于富集在对应于所述组织的生物通路中的cpg位点和/或基因来确定,或基于在所述组织中高水平表达的cpg位点和/或基因来确定。然后,与特定组织类型相关的cpg位点和/或基因的甲基化模式可用于组织特异性或器官特异性年龄预测或疾病进展分析。例如,机器学习模型可以在与特定组织相关的cpg位点和/或基因的甲基化水平上训练,以预测对象的生物学年龄。作为结果,可以检测组织(例如,器官)的年龄加速或减速。在其他示例中,可以训练机器学习模型以基于与特定组织相关的cpg位点和/或基因的甲基化水平对疾病的存在或进展进行分类。
84、作为从cfdna获得甲基化水平(例如,5hmc水平或胞嘧啶甲基化水平)和开发基于甲基化水平预测年龄、疾病发生或疾病进展的方法的结果,可以实现对相关生物学过程的更深入的理解。例如,可以获得对疾病对特定器官的影响或衰老的影响的更深入的理解。这可以促进用于有效检测并治疗疾病的方法的开发。例如,基于cfdna中甲基化水平的器官衰老评估能够以最小侵入方式进行疾病检测,这可以导致新的预防性干预措施的发展。
85、i. 引言
86、生物学年龄可以反映生物体基于生理学或分子学证据的年龄。生物学年龄可以与年龄相关的生物过程和病变生理学状态有关。例如,如果对象特别健康,则对象的生物学年龄可能低于对象的实际年龄,这可以被称为“减速的生物学衰老”。否则,可能在具有免疫相关和/或器官相关功能障碍的对象中检测到“加速的生物学衰老”,并且其可以指示发展一种或多种疾病的高风险。因此,生物学年龄的确定对于预防性诊断和精确医疗是重要的。生物学年龄和生理学或分子学证据之间的标准曲线可以从定义的正常对象群体中构建,从而可以针对每个测试样本定量化生物学年龄。可以将正常对象定义为在研究期间没有检测到疾病或病症的那些对象。
87、分子生物学和组学技术的最新进展已经使在分子水平上表征生物学衰老称为可能,并且提出了许多基于组学的衰老时钟来估计人类生物学年龄(rutledge et al.,2022)。基于dna胞嘧啶-磷酸-鸟嘌呤(cpg)甲基化,hannum等人使用血液样本预测实际年龄(hannum et al., 2013),且horvath等人构建了适用于所有人类组织的泛组织甲基化衰老时钟(horvath, 2013)。此外,血液血浆携带在衰老过程中变化的循环蛋白,基于此lehallier等人开发了预测实际年龄的准确模型(lehallier et al., 2019),且oh等人最近在活体个体中证实了器官特异性蛋白质组学衰老时钟(oh et al., 2023)。转录组学时钟是另一种类型,并且可以使用来自不同组织,例如外周血(peters et al., 2015)和真皮成纤维细胞(fleischer et al., 2018)的转录组学数据推导衰老时钟。此外,分析尿液(hertel et al., 2016)和血液(robinson et al., 2020)中的代谢物,已经生成了代谢组学衰老时钟。
88、5-甲基胞嘧啶(5mc)是dna的主要甲基化形式,并且tet酶在主动去甲基化过程中逐渐将5mc氧化成一系列中间状态,例如5-羟甲基胞嘧啶(5hmc)(greenberg and bourc’his, 2019)。研究表明,5hmc不仅在去甲基化过程中作为中间体,还作为具有独立调节功能的稳定表观遗传标志物(lister et al., 2013; pastor et al., 2011)。神经发育可能与脑和神经元细胞中5hmc的富集有关(kriaucionis and heintz, 2009; szulwach et al.,2011),并且5hmc累积似乎对于保持胚胎干细胞的多能性是必需的(koh et al., 2011)。最近的鼠模型研究揭示,5hmc在包括肝脏、心脏和肺在内的多种衰老组织中累积,相比之下,5mc在年轻器官和衰老器官之间没有显示出任何可检测到的差异(occean et al., 2023)。此外,xiong等人证实了实际年龄与人类血细胞的5hmc水平呈负相关(r = -0.865),而血液5mc显示与年龄弱得多的相关性(r = -0.232)(xiong et al., 2015)。
89、然而,对血细胞的分析不能反映其他器官的衰老。血浆dna可以来源于不同的器官,理论上提供了评估器官特异性衰老的机会。然而,仍未建立基于对血浆dna的分析的用于此目的的方法。
90、ii. 跨年龄群组的基因中的甲基化变异性
91、可以获得不同年龄的对象的数据,并且针对每个对象基因集合中的每一个,其可以包括基因特异性甲基化水平。基因特异性甲基化水平可以是5hmc水平,其可以指示每个对象的每种基因中存在的5hmc修饰的浓度或量。通过比较不同年龄的对象的基因特异性甲基化水平,可以鉴定高变异基因。高变异基因可以是在跨越不同年龄对象的5hmc水平中表现出最大变异的基因。
92、
a. 群组
93、在本公开的一些实施方案中,来自785个对象的群组的数据可用于确定具有随时间变化的cfdna 5hmc信号的基因。该数据可以来源于两个公开的全基因组5hmc数据集。第一数据集可以包括未患癌症的对象的数据,包括522个健康对象和263个患有慢性乙型肝炎病毒感染(hbv)或肝硬化的对象。第一数据集中的对象的年龄范围可以为19岁到86岁。图1显示了第一数据集中对象的年龄分布的柱状图100。例如,柱状图100中的每个柱可以表示在第一数据集中19岁至86岁的每个年龄包括多少个对象。柱状图100中的年龄可以是对象的真实实际年龄(“真实年龄”)。第二数据集可以包括47名患有癌症的对象的数据。患有癌症的对象可以患有神经胶质瘤。第二数据集的年龄范围可以跨越23岁到66岁。
94、对于每个对象,可以有17,000种基因的数据。每种基因的数据可以包括基因特异性甲基化水平(例如,每个对象的每种基因中存在的5hmc修饰的浓度或量)。在一个示例中,可以对来自每个对象的一个或多个血浆cfdna样本执行5hmc-seal技术,以确定每种基因的5hmc水平。因此,对于每个对象,第一数据集和第二数据集可以包括所述基因和相应的5hmc水平。
95、
b. 高变异基因的鉴定
96、高变异基因可以是跨群组的在5hmc水平上表现出最大变异的基因。在一些示例中,可以通过计算跨群组的每种基因的5hmc水平的标准偏差来测量每种基因的cfdna 5hmc信号中的变异性。或者,可以通过计算跨群组的每种基因的5hmc水平的归一化标准偏差来测量每种基因的cfdna 5hmc信号中的变异性。归一化标准偏差可以通过将每种基因的5hmc水平的标准偏差与落入给定箱的基因的平均5hmc水平进行比例缩放来获得(satija etal., 2015)。例如,可以基于平均5hmc水平将基因分组成箱。对于每个箱,可以有相应的平均5hmc水平。因此,每种基因的标准偏差可以用其相应箱的平均5hmc水平进行归一化。
97、图2显示了根据本公开的一些实施方案的基因特异性甲基化水平的归一化标准偏差的图200。更具体地,图2显示了跨群组的每种基因的5hmc水平的归一化标准偏差。在图2中,可以将每种基因的归一化标准偏差相对于该基因的相应平均5hmc水平作图。具有5hmc水平最高变异性的基因可以是具有最高5hmc水平归一化标准偏差值的基因。例如,在图2中,用实心黑点显示了17,000种基因中具有最高归一化标准偏差值的前3,000种基因。
98、在一些示例中,在计算基因的5hmc水平的平均值和标准偏差之前,可以对每个5hmc水平进行对数变换。然后可以使用群组中每个对象的基因的log变换的5hmc值来计算基因的平均5hmc水平。另外,基因的5hmc水平的标准偏差可以使用基因的log变换的5hmc值来计算。标准偏差可以进一步使用对应于一个或多个箱的平均5hmc水平进行归一化。然后,基于每种基因的归一化标准偏差,可以鉴定在cfdna的5hmc水平方面的高变异基因。高变异基因可以是前10、前50、前100、前500、前1000、前2000、前3000、前4000、前5000个基因等,或前1%、前2%、前5%、前10%、前20%、前30%、前40%、前50%的基因等。
99、另外地或者可选择地,用于统计离散度的度量可以包括四分位距(iqr)、极差(range)、中位数绝对偏差、平均绝对差、均方根差(rmsd)、距离相关系数等。用于统计离散度的任何一个或多个度量可以用于鉴定具有高5hmc水平变异性的基因。
100、iii. 生物学年龄与甲基化水平的关系
101、可以基于一个或多个位点(例如,cpg位点)集合的甲基化水平来估计对象或特定组织的生物学年龄,所述一个或多个位点集合可以部分或完全位于相应基因内。作为示例,甲基化水平可以是5mc和/或5hmc的水平。因此,在一个示例中,5hmc水平可以是一种或多种基因的5hmc水平。为了关联年龄和位点的集合的此类甲基化水平(例如,基因的5hmc水平),可以推导甲基化水平(例如,5hmc水平)轨迹。基于来自未患癌症对象的cfdna样本,胞嘧啶甲基化水平轨迹可以显示一个或多个cpg随时间变化的典型胞嘧啶甲基化水平。
102、
a. 基于cfdna甲基化的衰老时钟
103、甲基化水平(例如,5hmc和/或5mc)轨迹可以使用各种算法推导,所述算法例如最小绝对收缩与选择算子(lasso)、岭回归、支持向量机(svm)、分析学习、人工神经网络、反向传播、提升算法(元算法)、贝叶斯统计、基于案例的推理、决策树学习、归纳逻辑编程、高斯过程回归、遗传编程、数据处理的群组方法、核估计器、学习自动机、学习分类器系统、最小信息长度(决策树)、决策图等)、多线性子空间学习、朴素贝叶斯分类器、最大熵分类器、条件随机场、最近邻算法、可能近似正确学习(pac)算法、涟漪向下规则、知识获取方法、符号机器学习算法、亚符号机器学习算法、最小复杂度机器(mcm)、随机森林、分类器集合、序数分类、数据预处理、不平衡数据集处理、统计关系学习、或proaftn(一种多准则分类算法)。
104、用于推导甲基化水平轨迹、用于基于甲基化水平轨迹预测年龄或其组合的模型可以利用线性回归、逻辑回归、深度循环神经网络(例如,长短期记忆,lstm)、隐马尔可夫模型(hmm)、线性判别分析(lda)、k-均值聚类、基于密度的噪声应用空间聚类(dbscan)、随机森林算法等。使用一个或多个位点(例如cpg位点)的cfdna甲基化水平训练以预测生物学年龄的模型在本文中可称为衰老时钟。
105、1. 5hmc-衰老时钟
106、在一个特定示例中,可以开发回归模型(例如,lasso回归模型)用于基于一种或多种基因的5hmc值预测生物学年龄。所述模型可以使用至少一部分具有如上文基于群组的数据集所鉴定的高变异5hmc水平的基因的数据。例如,回归模型可以使用对应于图2所示的块状点的前3,000种基因的5hmc水平来训练和测试。
107、为了训练和验证回归模型,可以将群组中未患癌症的每个对象的数据(例如3,000种基因和相应的5hmc水平)分成训练数据集和测试数据集。在一个特定的示例中,数据可以被分成比率为9: 1的训练数据集和测试数据集。训练可以包括将回归模型拟合到训练数据集中。也就是说,训练可以包括调整与回归模型相关的超参数,以通过基于高变异基因的5hmc水平的回归模型改进年龄预测。在一些示例中,在训练期间,回归模型可以选择可足以预测生物学年龄的最小基因集合。例如,回归模型可以选择3000种高变异基因中的200种作为可用于预测生物学年龄的最小基因集合。选择的200种基因列于下文表3中。
108、在训练后,可以通过将至少选择的200种基因的5hmc水平输入到训练的回归模型中来测试回归模型。输入回归模型的5hmc水平可以是测试数据集中未患癌症的对象的5hmc水平。经过训练的回归模型然后可以基于所选基因的5hmc水平来输出测试数据集中的对象的预测年龄。可以将预测的年龄与对象的真实年龄进行比较,以估计训练的回归模型的准确度。
109、图3显示了根据本公开的一些实施方案,基于基因特异性甲基化水平预测的年龄与真实实际年龄对比的曲线图300。更具体地,曲线图300描绘了通过训练数据集的训练回归模型输出的预测年龄和通过测试数据集的训练回归模型输出的预测年龄。因此,图3包括针对群组中未患癌症的每个对象的预测年龄。可以将预测年龄与包括在第一数据集中的群组中每个对象的真实年龄对比作图。如图3所示,由经过训练的回归模型预测的年龄可与第一数据集中的真实年龄相关。为了量化图3中描绘的预测年龄和真实年龄之间的相关性,可以计算皮尔森相关系数。图3中描绘的预测年龄和真实年龄的皮尔森相关系数为0.96。
110、2. 基于胞嘧啶甲基化水平的衰老时钟
111、可以基于5hmc和5mc水平进行年龄预测。胞嘧啶甲基化可以包括5-甲基胞嘧啶(5mc)和5-羟甲基胞嘧啶(5hmc)。亚硫酸氢盐测序可用于检测两种类型的甲基化胞嘧啶。在一个示例中,在亚硫酸氢盐处理期间,未甲基化的胞嘧啶被转化为尿嘧啶,然后其在测序过程中被读取为胸苷。相比之下,在亚硫酸氢盐处理期间,甲基化的胞嘧啶,包括5mc和5hmc保持不变,并被读取为胞嘧啶。因此,在亚硫酸氢盐测序中,胞嘧啶甲基化水平(例如,指示cpg位点的5mc水平和5hmc水平的信号)可以通过鉴定为胞嘧啶的读数的比率来确定。在其他示例中,胞嘧啶甲基化模式可以通过其他技术获得,例如简并代表性亚硫酸氢盐测序、微阵列、甲基化dna免疫沉淀、纳米孔测序和单分子实时(smrt)测序。
112、可以基于一个或多个cpg位点(cpg)和/或基因的胞嘧啶甲基化来估计对象或特定组织的生物学年龄。为了关联年龄和胞嘧啶甲基化水平,可以推导胞嘧啶甲基化水平轨迹。基于来自未患癌症对象的cfdna样本,胞嘧啶甲基化水平轨迹可以显示一个或多个cpg随时间变化的典型胞嘧啶甲基化水平。
113、另外,可以对患病的对象进行衰老分析。患病的对象在年龄分析期间可能表现出异常的结果。例如,加速或减速的衰老可以指示特定的病症。因此,通过基于胞嘧啶甲基化水平预测年龄并将对象的预测年龄与真实年龄进行比较,可以检测到病症或其他病变。
114、可以使用各种模型技术(如上文所述)推导胞嘧啶甲基化水平轨迹,例如最小绝对收缩与选择算子(lasso)、岭回归、支持向量机(svm)、分析学习、人工神经网络、反向传播、提升算法(元算法)、贝叶斯统计、基于案例的推理、决策树学习、归纳逻辑编程、高斯过程回归、遗传编程、数据处理的群组方法、核估计器、学习自动机、学习分类器系统、最小信息长度(决策树)、决策图等)、多线性子空间学习、朴素贝叶斯分类器、最大熵分类器、条件随机场、最近邻算法、可能近似正确学习(pac)算法、涟漪向下规则、知识获取方法、符号机器学习算法、亚符号机器学习算法、最小复杂度机器(mcm)、随机森林、分类器集合、序数分类、数据预处理、不平衡数据集处理、统计关系学习、或proaftn(一种多准则分类算法)。
115、用于推导胞嘧啶甲基化水平轨迹、用于基于胞嘧啶甲基化水平轨迹预测年龄,或其组合的模型的其他示例包括线性回归、逻辑回归、深度循环神经网络(例如,长期短期记忆,lstm)、隐马尔可夫模型(hmm)、线性判别分析(lda)、k-均值聚类、基于密度的噪声应用空间聚类(dbscan),随机森林算法等。使用一个或多个cpg和/或基因的胞嘧啶甲基化水平训练以预测生物学年龄的模型在本文中可称为衰老时钟(或衰老时钟模型)。
116、在一个特定示例中,可以开发回归模型(例如,lasso回归模型)以基于一个或多个cpg的胞嘧啶甲基化水平预测生物学年龄。l1-正则化项可以被并入回归模型中以防止过度拟合。为了训练和验证回归模型,可以获得指示未患癌症的对象的胞嘧啶甲基化水平的数据。
117、在特定示例中,可以对来自未患癌症的136个对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序(中位数:约1.93亿成对末端读数),以获得包括来自对象的cpg的胞嘧啶甲基化水平的数据。然后可以将数据分成训练数据集和测试数据集。在特定的示例中,136个未患癌症的对象被分成比率为4: 1的训练数据集和测试数据集。如此,训练数据集包括指示对象的训练子集的胞嘧啶甲基化水平的数据,并且测试数据集包括指示对象的测试子集的胞嘧啶甲基化水平的数据。
118、回归模型的训练可以包括将回归模型拟合到训练数据集中。也就是说,训练可以包括调整与回归模型相关的超参数,以通过基于对象的训练子集的胞嘧啶甲基化水平的回归模型改进年龄预测。在一些示例中,在训练期间,回归模型可以选择其甲基化水平预测年龄的基因和/或cpg。另外,在特定示例中,回归模型选择49个cpg,其列于下文表4中。
119、在训练后,可以通过将对象的测试子集的胞嘧啶甲基化水平输入到经过训练的回归模型中来测试回归模型。经过训练的回归模型然后可基于所选cpg的胞嘧啶甲基化水平输出对象的测试子集的预测年龄。可以将对象的预测年龄与真实实际年龄进行比较,以估计经过训练的回归模型的准确度。
120、图16显示了根据本公开的一些实施方案,基于胞嘧啶甲基化水平预测的年龄与真实实际年龄对比的曲线图1600。更具体地,曲线图1600描绘了通过训练数据集的训练回归模型输出的预测年龄与训练集的真实实际年龄的对比(例如,如曲线图1600上的点1602a至1602c所示)。曲线图1600还描绘了通过训练的回归模型输出的预测年龄与测试集的真实实际年龄的对比(例如,如曲线图1600上的点1604a至1604c所示)。因此,图16包括136个未患癌症的对象中的每一个的预测年龄。
121、如图16所示,通过训练的回归模型预测的年龄与真实实际年龄相关。为了量化图16所示的预测年龄和真实实际年龄之间的相关性,可以计算皮尔森相关系数。训练数据集的皮尔森相关系数为0.97,且测试数据集的皮尔森相关系数为0.94。因此,曲线图1600显示了通过使用cfdna胞嘧啶甲基化水平训练的回归模型预测的年龄与训练数据集和测试数据集中的真实实际年龄密切相关。
122、
b. 用于年龄预测的示例性方法
123、图4是示出根据本公开的一些实施方案的用于测量对象的生物学年龄的方法400的流程图。
124、在框402处,方法400可以包括接收包括在多个游离dna(cfdna)分子的位点处的甲基化状态的序列读数。cfdna分子可以从对象的血浆或其他合适的生物样本获得。序列读数可以使用测序或基于探针的技术来确定,如可以使用微阵列或在对来自对象的生物样本执行的扩增反应(例如pcr)中进行。测序可以是成对末端测序、单分子测序、靶向测序等。序列读数可以包括每个cfdna分子的一个或多个位点,其中位点可以是cfdna分子中的指定位置或基因座。在一些示例中,位点可以是所关注的特定类型的位点。例如,所关注的位点可以包括cpg位点或其他合适的位点,例如a。在此类示例中,可以接收不包括所关注的位点(例如cpg位点)的序列读数。不包括所关注的位点的序列读数可以被丢弃并且不在方法400中使用。
125、甲基化状态可以指示每个位点是否通过添加ch3基团化学修饰以形成5mc或5mhc基团,或其他类型的甲基化。在一些示例中,确定每个位点的甲基化状态可以包括(1)(例如,用亚硫酸氢盐或限制酶)处理多个游离dna分子或(2)分析在包括该位点的窗口内的位置处的多个游离dna分子的光学或电信号。进一步的细节可以在美国公开号2021/0047679和2022/0328135中找到。
126、在框404处,方法400可以包括将序列读数与参考基因组进行比对。参考基因组可以是对应于对象的物种的dna序列的代表性示例。通过在参考基因组中搜索与序列读数最匹配的位置,可以将序列读数与参考基因组比对。
127、序列读数可以与参考基因组中的一个或多个cpg位点的n个集合进行比对。作为示例,n是的整数,其可以是至少3、4、5、6、7、8、9、10、11、12、13、14、15、16、17、18、19、20、30、40、50、60、70、80、90或100。因此,可以有cpg位点的这些数目中的至少任何数目。在表4中提供了可与序列读数进行比对的cpg位点的示例。另外地或者可选择地,序列读数可以与参考基因组中的基因进行比对。基因可以包括3,000种基因中的任何数目,例如,对应于图2中所描绘和/或表1中所提供的点。在一些示例中,一个或多个cpg位点的集合中的至少一些可对应于基因。因此,至少一些序列读数可以与基因内的一个或多个cpg位点的集合进行比对。表4显示了与基因相对应的cpg位点的示例。本领域技术人员将理解,可以使用任何合适的比对工具,例如bowtie、bwa、blast和fasta。
128、在框406处,方法400可以包括,针对一个或多个cpg位点的n个集合中的每一个,鉴定比对到参考基因组中一个或多个cpg位点的集合的一组序列读数。例如,参考基因组可以包括cpg位点、基因或其组合的位置和边界的注释或其他合适的指示。因此,基于序列读数与参考基因组的比对,每个序列读数可与cpg位点、基因或其组合相关联。每个序列读数可对应于一个或多个cpg位点、基因或其组合。cpg位点、基因或其组合中的每一个可以与特定组织类型,例如特定器官相关联。在一个示例中,特定组织类型可以选自包括骨髓、脑、卵巢、胰腺、肝脏、下丘脑、心脏、肾脏、膀胱、前列腺、淋巴结、乳腺、肺、皮肤和睾丸的组。
129、cpg位点、基因、或其组合中的每一个与特定组织类型的关联可以基于(1)生物通路、(2)表观遗传模式,或(3)在特定组织类型中大于阈值的表达水平来确定。关于生物通路,特定组织类型可以基于参与与特定组织相关的生物通路的cpg位点、基因或其组合来确定。生物通路可以是生物环境(例如细胞)内的一系列分子事件,其可以由基因产物(例如蛋白质)携带输出。例如,编码胰岛素的
ins基因可以基于在葡萄糖稳态的生物通路中使用的胰岛素而与胰腺相关。关于表达水平,一些cpg位点或基因可以在特定组织中以高水平(例如,大于阈值)表达。因此,对于给定的基因,如果特定组织(例如心脏)中的相应表达水平大于阈值,则该基因可以与特定组织相关联。
130、在框408处,方法400可以包括,对于一个或多个cpg位点的n个集合中每一个,使用该组序列读数的甲基化状态确定甲基化水平。在一些示例中,甲基化水平可以包括在给定cpg位点或基因的序列读数上聚集的甲基化位点(或未甲基化位点)的计数(数目)。例如,为了确定在该一个或多个cpg位点的集合中的甲基化水平,可以确定在指示甲基化存在或指示甲基化不存在的一个或多个cpg位点处的甲基化状态的量(数目)。因此,在一些示例中,比对到一个或多个cpg位点的集合的一组序列读数的甲基化水平可以是该集合中每一个cpg位点的指示甲基化存在的甲基化状态的量。
131、或者,在序列读数与参考基因组中的基因进行比对的示例中,甲基化水平可以是在每种基因的序列读数上聚集的甲基化位点(或未甲基化位点)的计数(数目)。因此,甲基化水平可以是基因特异性甲基化水平。另外,在一个或多个cpg位点的集合中的至少一些对应于基因的示例中,甲基化水平可以是基因特异性甲基化水平。例如,甲基化水平可以是对应于基因的每个cpg位点的指示甲基化存在的甲基化状态的量。
132、可以对甲基化位点的数目进行归一化。例如,甲基化水平可以是一个或多个cpg位点的集合或基因集合的甲基化密度的比例、百分比或其他合适的定量。也就是说,甲基化水平可以是序列读数中与一个或多个cpg位点的集合或基因集合相关的甲基化位点的数目相对于序列读数中与一个或多个cpg位点的集合或基因集合相关的位点总数的量度。
133、在框410处,方法400可以包括根据n个甲基化水平生成特征向量。特征向量可以包括一个或多个cpg位点或基因的每个集合的甲基化水平。特征向量可以包括结构化形式的甲基化水平,其可以摄入(输入)机器学习模型并被机器学习模型理解。
134、在框412处,该过程可以包括将机器学习模型加载到计算机系统的存储器中。机器学习模型可以使用具有已知实际年龄的训练样本(即,取自具有已知实际年龄的训练对象)和从训练样本(即,来自训练对象的生物样本)测量的甲基化水平的测量参考向量来训练。机器学习模型可以是回归模型或其他合适类型的机器学习模型。在一个示例中,训练样本可以从训练群组(例如,如本文所述的群组)获得。训练样本可以是未患癌症的对象。训练群组可以包括每个未患癌症的对象的已知实际年龄。另外,甲基化水平的参考向量可以包括至少一部分高度变异基因的5hmc水平。
135、在框414处,该过程可以包括将特征向量输入到机器学习模型中。例如,可以将特征向量输入到回归模型中。特征向量(以及在本文描述的其他特征向量)可以具有各种格式,例如串行组织成单一阵列或者当除了甲基化水平之外的其他值也包括在特征向量中时,组织成多维的。
136、在框416处,该过程可以包括使用机器学习模型预测对象的生物学年龄。作为示例,预测的生物学年龄可以是年龄(例如,20岁、30岁、45岁、55岁等),或者生物学年龄可以是年龄范围(例如,20至25岁、30至39岁等),或者甚至比年龄更高的精度,例如月份范围的一个月。在基因与特定组织类型相关的示例中,生物学年龄可以是针对特定组织类型的年龄。另外,在一些示例中,可以将使用机器学习模型预测的生物学年龄与对象的真实实际年龄进行比较。如果预测的年龄偏离真实实际年龄,例如比真实的实际年龄大一个阈值量,则可以确定对象具有病变(例如病状、疾病或病症)。在此类情况下,可以产生并输出年龄加速的警报或其他合适的指示标记。在一个或多个cpg位点的集合或基因集合与特定组织类型相关的示例中,预测的年龄比实际年龄大至少阈值量可以指示影响特定组织类型的病变的存在。
137、iv. 病变检测
138、可以对患病的对象进行衰老分析。患病的对象在年龄分析期间可能表现出异常的结果。例如,特定组织的加速衰老可指示特定的病症。因此,通过基于cfdna甲基化水平(例如,5hmc水平和/或5mc水平)预测年龄并将预测年龄与对象的真实年龄相比较,可以检测病症或其他病变。另外地或者可选择地,通过分析具有随时间变化的高变异甲基化水平的cpg位点的集合和/或基因的甲基化水平,并将甲基化水平与已知年龄的参考甲基化水平进行比较,可以检测病变。比较可以通过使用参考甲基化水平(参考向量)训练的机器学习模型进行。
139、
a. 基于5hmc水平的示例模型
140、为了基于cfdna甲基化水平信号研究患病对象中的生物衰老,可以将第二数据集输入到回归模型中。如上文所述,基于群组中未患癌症的对象的数据,回归模型选择200种可用于预测生物学年龄的基因。在200种基因中,175种在第二数据集中可具有可检测的5hmc水平。因此,为了适应数据集中的差异,可以重新训练回归模型。例如,第一数据集中未患癌症的对象的数据可用于重新训练模型。用于重新训练模型的未患癌症的对象的数据可以包括175种基因和相应的5hmc水平。与先前的示例类似,数据可以以9:1的比率被分成训练数据集和测试数据集。
141、在训练之后,可以将来自测试数据集的5hmc水平输入到回归模型中。另外,可以将来自第二数据集的5hmc水平输入到回归模型中。
142、图5a显示了根据本公开的一些实施方案,基于基因特异性甲基化水平的年龄预测与真实实际年龄对比的曲线图500a。特别地,曲线图500a可以包括由测试数据集和第二数据集的模型输出的预测年龄。如图5a所描绘的,回归模型可以准确地预测测试数据集中未患癌症的对象的真实实际年龄。例如,针对测试数据集的预测年龄与真实年龄的皮尔森相关系数为0.94。此外,如图5a所示,针对第二数据集中的对象的预测年龄与对象的真实年龄可具有一定程度的相关性。例如,针对第二数据集的预测年龄与真实年龄的皮尔森系数是0.66。另外,如所描绘的,对应于第二数据集的预测年龄通常可以大于对象的真实年龄。
143、基于由第二数据集的回归模型输出的预测年龄通常大于真实年龄,可以预测患有神经胶质瘤的对象可能表现出年龄加速。该预测可以基于与对照对象(例如,第一数据集中未患癌症的对象)相比,第二数据集中的对象的基因特异性甲基化水平(例如,5hmc水平)。年龄加速可被定义为预测年龄和真实年龄之间的年龄差异。为了确定患有神经胶质瘤的对象是否表现出年龄加速,可以确定对照对象和患有神经胶质瘤的对象之间的年龄加速差异是否显著。为此,可以执行威尔科克森秩和检验。
144、图5b显示了根据本公开的一些实施方案的年龄加速的箱形图500b。特别地,箱形图500b可以描绘威尔科克森秩和检验的结果。例如,如箱形图500b所示,神经胶质瘤对象的中位数年龄加速可能是大约13岁,而对照对象的中位数年龄加速可能是大约1岁。威尔科克森秩和检验的p值可以低于0.001,表明对照对象和患有神经胶质瘤的对象的预测年龄之间存在显著差异。基于这些结果,可以确定神经胶质瘤患者可能确实表现出年龄加速。先前的研究(liao et al., 2018; lin and wagner, 2015)也可以显示,基于horvath甲基化的衰老时钟,神经胶质瘤肿瘤组织与健康组织相比表现出年龄加速。
145、因此,基于基因特异性甲基化水平预测年龄可用于鉴定异常加速或减速的生物学年龄。这能够有效地检测、预防和治疗疾病。
146、
b. 联合使用5hmc和5mc检测病变
147、为了基于胞嘧啶甲基化水平(例如,基于5hmc水平和5mc水平)研究患病对象的生物衰老,可以将包括通过对来自38名患有早期(n = 20)、中期(n = 11)和晚期(n = 7)癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的甲基化水平的数据输入到上文针对图16所述的回归模型中。然后,回归模型可以输出患有早期、中期和晚期癌症的对象的预测年龄。
148、图19a显示了根据本公开的一些实施方案,针对对照和肝细胞癌(hcc)的不同阶段,基于胞嘧啶甲基化水平的年龄预测与真实实际年龄对比的曲线图1900。曲线图1900描绘了对比对象的真实实际年龄(例如,如由点1902a至1902c所示)绘制未患癌症的对象(在曲线图1900中称为对照)的年龄预测。曲线图1900还描绘了患有早期癌症(例如,如点1904所示)、中期癌症(例如,如点1906所示)和晚期癌症(例如,如点1908所示)的对象的年龄预测。
149、因此,曲线图1900显示了针对未患癌症的对象和针对患有早期、中期和晚期癌症的对象的年龄预测和真实实际年龄之间的差异。与未患癌症的对象相比,患有早期、中期和晚期癌症的对象在其真实实际年龄和预测年龄之间具有较大的误差(例如,平均绝对误差(mae))。特别地,未患癌症的对象的mae为2.8,而患有早期癌症的对象的mae为10.1,患有中期癌症的对象的mae为11.7,以及患有晚期癌症的对象的mae为45.5。
150、图19b显示了根据本公开内容的一些实施方案,未患癌症的对象和患有hcc的对象的年龄加速的箱形图1902。特别地,箱形图1902描绘了威尔科克森秩和检验的结果。例如,如箱形图1902所描绘的,患有hcc的对象的中位数年龄加速可以是大约负10岁。威尔科克森秩和检验的p值可以低于0.001,表明在未患癌症的对象和患有hcc的对象的预测年龄之间存在显著差异。基于这些结果(例如,基于年龄加速为负并且存在显著差异),可以确定患有hcc的对象相对于未患癌症的对象可能表现出年龄减速。
151、因此,基于甲基化水平(例如,基于5mc和5hmc水平)预测年龄可用于鉴定异常加速或减速的生物学年龄。这能够有效地检测、预防和治疗疾病。
152、
c. 其他模型
153、在另一示例中,为了基于cfdna 5hmc信号研究患病对象中的生物衰老,机器学习模型可以基于来自对应于癌症子集的第二数据集的数据和来自对应于未患癌症对象的第一数据集的数据来训练。数据可以被分成训练数据集和测试数据集。数据以可包括病变分类(例如对神经胶质瘤呈阳性或神经胶质瘤呈阴性)和高变异基因的5hmc水平。机器学习模型可以使用逻辑回归、一个或多个决策树、神经网络等。在训练期间,机器学习模型可以学习以基于基因集合的5hmc水平来预测病症的存在的分类(例如,对象是否患有神经胶质瘤)。在训练之后,可以将来自测试数据集的5hmc水平输入到机器学习模型中。然后,机器学习模型可以输出针对测试数据集的每个对象的神经胶质瘤的存在的预测分类。
154、在又一个示例中,为了基于cfdna 5hmc信号研究患病对象中的生物衰老,一个或多个机器学习模型可以基于来自在特定年龄范围内的对象的第二数据集的数据和来自特定年龄范围内的对象的第一数据集的数据来训练。对于每个年龄范围,相应的数据可以被分成训练数据集和测试数据集。数据可以包括每个对象的年龄、病变分类(例如对神经胶质瘤呈阳性或神经胶质瘤呈阴性)和高变异基因5hmc的水平。机器学习模型可以包括逻辑回归、决策树、神经网络等。在训练期间,机器学习模型可以各自学习以基于基因集合的5hmc水平并基于对象的年龄来预测病症或其他病变的存在的分类(例如,对象是否患有神经胶质瘤)。在训练之后,和上文相似,机器学习模型可以输出针对测试数据集的每个对象的神经胶质瘤的存在的预测分类。
155、在另一示例中,为了基于cfdna甲基化水平研究患病对象的生物衰老,机器学习模型可以基于包括通过对来自38名患有早期(n = 20)、中期(n = 11)和晚期(n = 7)癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的甲基化水平的数据以及通过对来自136名未患癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的数据来训练。数据可以被分成训练数据集和测试数据集。数据可以包括病变分类(例如hcc阳性或hcc阴性)和cpg位点集合(例如表4中提供的cpg位点)的甲基化水平。机器学习模型可以使用逻辑回归、一个或多个决策树、神经网络等。在训练期间,机器学习模型可以学习以基于cpg位点的一个或多个集合的甲基化水平预测病症的存在的分类(例如对象是否患有hcc)。在训练之后,可以将来自测试数据集的甲基化水平输入到机器学习模型中。然后,机器学习模型可以输出针对测试数据集的每个对象的癌症(例如,hcc)的存在的预测分类。
156、在又一示例中,为了基于cfdna甲基化水平研究患病对象的生物衰老,一个或多个机器学习模型可以基于包括通过对来自38名患有早期(n = 20)、中期(n = 11)和晚期(n =7)癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的甲基化水平的数据以及通过对来自136名未患癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的数据来训练。对于对象的多个年龄范围中的每一个,可以将相应的数据分成训练数据集和测试数据集。数据可包括每个对象的年龄、病变分类(例如hcc阳性或hcc阴性)和cpg位点的集合的甲基化水平。机器学习模型可以包括逻辑回归、决策树、神经网络等。在训练期间,机器学习模型可以各自学习以基于cpg位点的一个或多个集合的甲基化水平和基于对象的年龄来预测病症或其他病变的存在的分类(例如对象是否患有神经胶质瘤)。在训练之后,和上文相似,机器学习模型可以输出针对测试数据集的每个对象的癌症(例如hcc)的存在的预测分类。
157、
d. 病变预测方法
158、图6显示了用于检测具有已知实际年龄的对象中的病症的方法600的示例的流程图。方法600的某些方面可以以与方法400类似的方式执行。
159、在框602处,方法600可以包括接收包括在多个游离dna(cfdna)分子的位点处的甲基化状态的序列读数。序列读数可以包括每个cfdna分子的一个或多个位点。框602可以以与方法400的框402类似的方式执行。
160、在框604处,方法600可以包括将序列读数与参考基因组进行比对。参考基因组可以是对应于对象的物种的dna序列的代表性示例。比对可以包括搜索在参考基因组中与序列读数最佳匹配的位置。
161、序列读数可以与参考基因组中的一个或多个cpg位点的n个集合进行比对。作为示例,n是整数,其可以是至少3、4、5、6、7、8、9、10、11、12、13、14、15、16、17、18、19、20、30、40、50、60、70、80、90或100。因此,可以有cpg位点的这些数目中的至少任何一个。在表4中提供了可与序列读数进行比对的cpg位点的示例。另外地或者可选择地,序列读数可以与参考基因组中的基因进行比对。基因可以包括对应于图2中所描绘的块状点和表1中所提供的3,000种基因中的任何数目。在一些示例中,一个或多个cpg位点的集合中的至少一些可对应于基因。因此,至少一些序列读数可以与基因内的一个或多个cpg位点的集合进行比对。表4显示了与基因相对应的cpg位点的示例。框604可以以与方法400的框404类似的方式执行。
162、在框606处,方法600可以包括,针对一个或多个cpg位点的n个集合中的每一个,鉴定比对到参考基因组中该一个或多个cpg位点的集合的一组序列读数。例如,参考基因组可以包括cpg位点、基因或其组合的位置和边界的注释或其他合适的指示。因此,基于序列读数与参考基因组的比对,每个序列读数可与cpg位点、基因或其组合相关联。例如,如果读数足够长,每个序列读数可对应于一个或多个cpg位点、基因或其组合。框606可以以与方法400的框406类似的方式执行。
163、cpg位点、基因或其组合中的每一个可以与特定组织类型,例如特定器官相关联。在一个示例中,特定组织类型可以选自包括骨髓、脑,卵巢、胰腺、肝脏、下丘脑、心脏、肾脏、膀胱、前列腺、淋巴结、乳腺、肺、皮肤和睾丸的组。每种基因与特定组织类型的关联可以基于(1)生物通路或(2)表观遗传模式或(3)在特定组织类型中大于阈值的表达水平来确定。
164、在框608处,方法600可以包括,对于一个或多个cpg位点的n个集合中的每一个,使用该组序列读数的甲基化状态确定甲基化水平。框608可以以与方法400的框408类似的方式执行。
165、例如,为了确定在一个或多个cpg位点的集合中的甲基化水平(例如5hmc水平和/或5mc水平),可以确定在指示甲基化存在或指示甲基化不存在的一个或多个cpg位点的集合处的甲基化状态的量(数目)。因此,在一些示例中,与一个或多个cpg位点的集合比对上的一组序列读数的甲基化水平可以是该集合中每一个cpg位点的指示甲基化存在的甲基化状态的量。或者,在序列读数与参考基因组中的基因进行比对的示例中,甲基化水平可以是在每种基因的序列读数上聚集的甲基化位点(或未甲基化位点)的计数(数目)。因此,甲基化水平可以是基因特异性甲基化水平。另外,在一个或多个cpg位点的集合中的至少一些对应于基因的示例中,甲基化水平可以是基因特异性甲基化水平。例如,甲基化水平可以是对应于基因的每个cpg位点的指示甲基化存在的甲基化状态的量。
166、在框610处,方法600可以包括根据n个甲基化水平生成特征向量。特征向量可以包括一个或多个cpg位点的每一个的甲基化水平或一种或多种基因的甲基化水平。特征向量可以包括结构化形式的甲基化水平,其可以被机器学习模型摄入并被机器学习模型理解。框610可以以与方法400的框410相似的方式执行。
167、在框612处,方法600可以包括将年龄依赖性机器学习模型加载到计算机系统的存储器中。可以使用各种类型和架构的年龄依赖性机器学习模型。年龄依赖性机器学习模型可以包括多个子模型,每个子模型可以对应于不同的生物学年龄或年龄范围。
168、在框614处,方法600可以包括将特征向量输入到年龄依赖性机器学习模型中。特征向量(以及本文描述的其他特征向量)可以具有各种格式,例如,串行组织成单一阵列或者当除了甲基化水平之外的其他值也包括在特征向量中时,组织成多维的。
169、在框616处,方法600可以包括使用年龄依赖性机器学习模型预测对象中病变等级(例如,病变(诸如病症)的存在)的分类。
170、在一些示例中,确定对象中病变存在的分类可包括将特征向量与代表性参考向量进行比较,所述代表性参考向量是使用具有相同已知病变分类(例如,病症分类)的一组测量参考向量确定的。可以确定两个向量之间的距离。如果特征向量与第一代表性参考向量足够相似(例如,在阈值内的距离或最接近的代表性参考向量),则可以确定对象具有对应于第一代表性参考向量的第一分类。
171、年龄依赖性机器学习模型可以基于具有病症(例如,神经胶质瘤)并与对象年龄相同或相似(例如,相同的年龄范围)的样本对象的参考向量来产生第一代表性参考向量。因此,第一代表性参考向量可以包括患有所述病变的样本对象的测量的(包括统计学确定的,例如平均的)cpg位点或基因的甲基化水平。
172、另外,年龄依赖性机器学习模型可以针对与所述对象相同或相似年龄的健康样本对象(例如,未患病变的对象)生成第二参考向量。因此,预测对象中病症的存在的分类可以包括将特征向量与每个代表性参考向量进行比较,并确定特征向量与哪个代表性参考向量最相似。在一些示例中,可以存在对应于任何数目的病变的任何数目的代表性参考向量。
173、每个实际年龄或年龄范围可以具有其自己的代表性特征向量的集合。因此,模型可以包括不同年龄的子模型,其中子模型具有针对不同分类的代表性特征向量的集合。在其他实施方式中,模型可以一次确定所有年龄的相对于所有其他代表性参考向量的距离,但是对于不同年龄的相对于此类参考向量的距离可以具有缩放其维度的权重,使得针对不同年龄的相对于参考向量的距离通常高于针对相同年龄的相对于参考向量的距离。
174、另外,在一些示例中,确定病症存在的分类可以包括使用年龄依赖性机器学习模型预测对象的生物学年龄、将生物学年龄与已知的实际年龄进行比较,并基于比较确定对象中病症存在的分类。例如,为了基于比较来确定分类,方法600可以包括确定生物学年龄和已知实际年龄之间的差异是否超过阈值。如果差异超过阈值,则分类可以指示对象患有病症。差异可以是正的(年龄加速)或负的(年龄减速),每一个对应于一种类型的年龄异常。
175、v. 具有相似形态特征的基因
176、如i-iii节所述,可以存在甲基化水平(例如,5mc水平和/或5hmc水平)随时间变化的cpg位点的集合和/或基因。cpg位点的集合和/或基因相对于年龄的典型甲基化水平变化模式(例如甲基化水平轨迹)可以基于未患癌症的对象的甲基化水平数据来估计。然后可以使用甲基化水平轨迹了解生物过程(例如疾病进展或衰老)。
177、
a. 衰老期间甲基化水平轨迹
178、为了估计衰老期间的甲基化水平轨迹(例如,5mc水平轨迹和/或5mc水平轨迹),可以对cfdna甲基化水平进行z评分。例如,可以对跨越第一数据集、第二数据集或其组合的每种基因的cfdna 5hmc水平进行z评分。或者,可以对cpg位点的集合(例如,表4中的cpg位点的集合)的甲基化水平进行z评分。例如,可以对通过对来自136个未患癌症的对象的血浆cfdna样本进行全基因组亚硫酸氢盐测序获得的cpg位点的集合的甲基化水平进行z评分。
179、图7显示了基于群组鉴定的每个高变异基因的5hmc水平z评分。将每个对象的每个高变异基因的5hmc水平z-评分与对象的年龄对比作图。作为结果,图7显示了根据本公开的一些实施方案,在衰老期间高变异基因的cfdna 5hmc轨迹的曲线图700。
180、另外,可以将局部加权散点图平滑(loess)回归拟合到每个cpg位点的集合和/或每种基因,以估计每个cpg位点的集合或每种基因的甲基化水平随年龄变化的轨迹。另外地或者可选择地,甲基化水平轨迹可以基于各种平滑算法来建立,例如但不限于loess、分箱平滑法、移动平均法、样条(spline)、罚样条、小波、savitsky-golay滤波器等。使用平滑算法建立的甲基化水平轨迹可以显示一些cpg位点的集合和/或基因随年龄变化的不同变化模式(例如轨迹)。在一些示例中,当甲基化水平轨迹建立时,具有相似甲基化水平轨迹的cpg位点的集合或基因可以被分组。可以通过用模糊c均值(fcm)进行无监督聚类,对具有相似5hmc轨迹的cpg位点集合或基因集合进行分组。在一个实施方案中,可使用各种聚类算法进行对甲基化水平轨迹的聚类,所述算法例如但不限于fcm、k-均值聚类、层次聚类、主成分分析(pca)、自动编码器、深度信念网络(dbn)、受限玻尔兹曼机器(rbm)、分层时间记忆(htm)、卷积神经网络(cnn)、支持向量机(svm)、奇异值分解(svd)、非负矩阵分解(nmf),等。
181、在一个示例中,可以基于相应的5hmc轨迹将从该群组的数据中鉴定的高变异基因分组为簇。为此,可以使用聚类方法fcm。该聚类方法可以将具有相似轨迹的基因分组为多个簇,并且可以为每种基因输出隶属度值(membership value)。每种基因的隶属度值可以指示该基因与其分组所属的簇的相似性程度。截止隶属度值可用于选择与簇具有高相关性的基因。例如,截止隶属度值可以是1。作为结果,在该示例中,可将3,000种高变异基因中的1,926种基因分组为8个簇。
182、图8a至图8d描绘了在示例中鉴定的8个基因簇的曲线图800a至800h。这8个基因簇可以各自由具有相似形态特征的5hmc轨迹来表征。显示了四种形态分类,但是可以使用更多的分类。相似的形态特征可以包括相似的斜率、相似的斜率方向(例如,正或负)、相似的一般形态(例如,线性、指数、二次或对数),或其组合。图8a至图8d可以进一步显示跨越年龄范围(例如,从19到82岁)内每个簇中的基因的5hmc轨迹。例如,可以在图8a至图8d中的曲线图800a至800h上描绘5hmc轨迹。每个曲线图800a至800h可以包括相应簇中每种基因的5hmc水平z评分。5hmc水平z评分可以与对应于每种基因的每个对象的真实年龄对比作图。簇的大小可以相对于多个相关基因而变化。
183、如图8a所描绘的,第一簇和第二簇可以包括具有基本上为线性的5hmc轨迹的基因,而其他六个簇可以包括具有基本上为非线性的5hmc轨迹的基因。例如,如图8b所示,第三簇和第四簇可以包括具有基本上为对数的5hmc轨迹的基因。另外,如图8c所示,第五簇和第六簇可以包括具有基本上为二次的5hmc轨迹的基因。此外,如图8d所示,第七簇和第八簇可以包括具有基本上为指数的5hmc轨迹的基因。曲线图800a至800h的每一个中的黑线可以代表每个簇中所有基因的平均值。
184、可以以各种方式确定适用哪种形态分类适用的分类。例如,在不同阶段采集的样本的基因甲基化水平的数据点可以拟合为线,并且如果准确度(例如,r值)在阈值内,则形态分类可以是线性的。可以对其他功能形式进行类似的操作。
185、
b. 基因簇与生物表型之间的关系
186、可以进行基因集合富集分析(gsea)以确定基因簇是否与一种或多种生物表型相关联。例如,gsea分析可以包括确定每个簇的基因是否与富集的生物通路、富集的组织或其组合相关。每个簇的富集的生物通路、富集的组织或其组合可以使用反应组数据库(例如,包括生物通路)、malacards数据库(或提供基因及其与疾病的关系的其他数据库)、其他合适的数据库或其组合来鉴定。
187、基于gsea,可以确定第一簇中的基因以gpcr信号和神经元相关通路表示。与第一簇相关的生物通路可以与为第一簇确定的富集的组织类型一致,所述富集的组织类型可以是脑。另外,簇2的gsea可以表明相应的基因与免疫和止血通路以及相关组织(例如血液和骨髓)有关。对应于第三簇的基因可以涉及代谢(例如生物氧化)和药物adme通路以及相关组织,例如肝脏和肾脏。与第五簇相关的基因也可以与代谢相关,并且可以特别地显示在脂质代谢通路和内皮组织中的富集。第七簇中的基因可以是皮肤相关的。例如,基于gsea,可以确定第七簇中的基因可以与胶原通路和真皮组织富集有关。第八簇可以包括与erbb的信号通路有关的基因,其可以是与神经退行性疾病和一些癌症的发展相关的蛋白质家族(例如,egfr和her2)。另外,基于gsea分析,可以确定8个簇的每一个中的基因在脑或神经元组织中均有富集,这可能表示5hmc在神经发育中的关键作用。
188、图9a至图9d显示了根据本公开的实施方案的基因特异性cfdna 5hmc轨迹的曲线图800a至800h。即,图9a至图9d显示了使用fcm算法鉴定的每个簇中的基因的5hmc轨迹。图9a至图9d进一步包括针对每个簇中的基因确定的富集的生物通路和富集的组织的指示。
189、
c. 基因簇与年龄指示标记
190、除了与特定生物通路和组织有关的簇外,还可以存在与显示甲基化水平轨迹变化的簇相关的衰老阶段。可通过甲基化水平轨迹中的变化点或拐点来指示衰老阶段。对于簇中cpg位点的集合和/或基因的许多或大多数甲基化水平轨迹,变化点或拐点可以是明显的。拐点可以通过簇中cpg位点的集合和/或基因的甲基化水平轨迹斜率的增加或减少来表征。另外,变化点的特征在于簇中cpg位点的集合和/或基因的甲基化水平轨迹的斜率方向的变化(例如,从正到负或从负到正)。
191、图10a显示了具有年龄指示标记1002a至1002d的基因特异性cfdna 5hmc轨迹的曲线图800a至800b。图10b显示了具有年龄指示标记1002e至1002h的基因特异性cfdna 5hmc轨迹的曲线图800c至800d。图10c显示了具有年龄指示标记1002i至1002j的基因特异性cfdna 5hmc轨迹的曲线图800e至800f。图10d显示了具有年龄指示标记1002k至1002n的基因特异性cfdna 5hmc轨迹的曲线图800g至800h。年龄指示标记1002a至1002n可以定位在每个簇的变化点或拐点。
192、例如,如曲线图800a所描绘的,第一簇中基因的5hmc轨迹的方差可以在30岁左右降低。在30岁左右5hmc轨迹的方差变化可以用第一年龄指示标记1002a来标记。第一簇中的5hmc轨迹的斜率也可以在大约75岁左右降低,用第二年龄指示标记1002b作为标记。方差的降低可以指示在30和75岁左右的对象中基因的5hmc水平变化较小。还可以在第二簇(例如,如曲线图800b所描绘)、第三簇(例如,如曲线图800c所描绘)、第四簇(例如,如曲线图800d所描绘)和第八簇(例如,如曲线图800h所描绘)观察到30岁左右对象类似的5hmc轨迹方差的降低。另外,可以在第一簇、第二簇和第七簇(例如,如曲线800g中所描绘)中观察到在75岁左右方差的降低。因此,基于第一簇、第二簇、第三簇、第四簇、第七簇和第八簇的5hmc轨迹的变化,30岁和70岁可以被鉴定为具有相对于5hmc水平的低基因离散度的年龄阶段。
193、另外,第四簇、第五簇、第六簇、第七簇和第八簇可以在大约50岁左右具有变化点。例如,如第八年龄指示标记1002h和第十年龄指示标记1002j所示,第四簇和第六簇中的5hmc水平可以增加直到50岁左右。然后,在50岁后,第四簇和第六簇中的基因的5hmc水平可以降低。基因的5hmc水平的增加或降低可以分别通过5hmc轨迹的正或负斜率来指示。此外,如第九年龄指示标记1002i、第十一年龄指示标记1002k和第十四年龄指示标记1002n所指示的,第五、第七和第八簇中的基因中的5hmc水平可以在50岁以下的对象中降低。然后,第五、第七和第八簇中的基因的5hmc水平可以在50岁以上的对象中增加。
194、因此,基于聚类基因的5hmc轨迹,其中5hmc水平波动性变化的衰老阶段可能发生在30岁、50岁和70岁左右。
195、图11还显示了根据本公开的实施方案的衰老期间cfdna 5hmc轨迹的曲线图1100a至1100c。图11中所描绘的cfdna 5hmc水平轨迹可以代表不同年龄的对象的总cfdna 5hmc水平,而不是代表基因特异性5hmc水平。如图11所示,cfdna的全基因组5hmc水平在处于30岁、50岁和70岁的对象中可能显示出峰值。峰值可以进一步用另外两个群组的数据来证实(shao et al., 2022; walker et al., 2022)。在曲线图1100b至1100c中显示了来自另外两个群组的全基因组5hmc水平。
196、
d. 器官特异性衰老分析
197、血浆cfdna分析可进一步允许评估器官衰老模式。在一些实施方案中,除了血细胞之外,来自肝脏、肺、结肠或其他合适器官的细胞可用于器官特异性衰老分析。为了进行器官特异性衰老分析,可以确定组织特异性甲基化轨迹(例如,组织特异性5hmc轨迹)。例如,可以确定具有相同形态特征的一组基因,并且可以如本文所述鉴定相关组织。然后,使用组织特异性甲基化轨迹,可以预测对象的生物学年龄或相应通路的生物学年龄。
198、1. 器官特异性年龄预测的示例模型
199、可以使用cfdna甲基化水平数据来估计与特定器官或特定生物通路相关的生物学年龄。例如,如图9所示,使用gsea测定,第一簇和第八簇(例如,对应于曲线图800a和800h)可以包括在脑中或神经组织中富集的基因。因此,对应于第一簇和第八簇的基因可以被认为是脑特异性基因。在图9所示的示例中,在第一簇和第八簇之间,存在对应于脑或神经组织的516种基因。
200、在图9所示的示例中,通过用模糊c均值(fcm)的无监督聚类建立第一簇和第八簇。在其他实施方案中,脑特异性或其他器官特异性基因可以以监督方式定义。例如,脑特异性基因可被定义为相对于其他组织,在脑中显示差异5hmc模式的基因。在另一示例中,脑特异性基因可被定义为相对于其他组织,在脑中显示差异表达、甲基化或组蛋白修饰模式的基因。例如,可以选择甲基化水平线性变化的器官特异性基因。
201、使用与第一簇和第八簇中的基因相对应的cfdna 5hmc数据,可以生成脑特异性衰老模型。在一个示例中,脑特异性衰老模型可以使用lasso回归基于cfdna 5hmc数据预测年龄。cfdna 5hmc数据可以包括第一和第八簇中每种基因的5hmc水平。cfdna数据还可以来自第一数据集中没有癌症的对象,并且可以被分成具有例如9: 1比率的训练数据集和测试数据集。
202、在一个示例中,在第二数据集中具有可检测的5hmc信号的脑特异性基因可用于训练和测试脑特异性衰老模型。因此,在该示例中,来自第一簇和第八簇的462种基因可用作脑特异性衰老模型的输入特征。在训练期间,在该示例中,脑特异性衰老模型最终可以选择可用于预测生物脑年龄的一部分基因(例如,180种)。
203、在训练后,可将从测试数据集中选择的基因的5hmc水平输入到脑特异性衰老模型中。然后,脑特异性衰老模型可以输出预测年龄,其可以与相应的未患癌症的对象的真实年龄相关。
204、图12a显示了根据本公开的一些实施方案,脑特异性年龄预测与真实实际年龄对比的曲线图。特别地,图12a可以包括对照(例如,测试数据集中未患癌症的对象)的预测年龄对比对照的真实年龄。来自脑特异性衰老模型的预测的年龄可与真实年龄强烈相关。例如,预测和真实年龄的皮尔森系数可以是0.84。
205、另外,在训练后,可以将从第二数据集中选择的基因的5hmc水平输入到脑特异性衰老模型中。因此,该模型可应用于患有神经胶质瘤的对象。然后,脑特异性衰老模型可以基于从第二数据集中选择的基因的5hmc水平来输出患有神经胶质瘤的对象的预测年龄。患有神经胶质瘤的对象的预测年龄可与对象的真实年龄具有低相关性。例如,皮尔森系数可以是0.40。
206、此外,如图12a所示,患有神经胶质瘤的对象的预测年龄通常可以大于真实年龄。因此,可以预测患有神经胶质瘤的对象可以表现出相对于对照的加速衰老。可以进行威尔科克森秩和检验以确定患有神经胶质瘤的对象的年龄加速是否与未患癌症的对象的年龄加速具有显著差异。
207、图12b显示了根据本公开的一些实施方案的器官特异性年龄加速的箱形图。如图12b所示,对于患有神经胶质瘤的对象的脑特异性年龄预测的中位数年龄加速是25.07,而对于未患癌症的对象的脑特异性年龄预测的中位数年龄加速是-0.99岁。另外,根据威尔科克森秩和检验,低于0.001的p值可以指示年龄加速度之间的显著差异。
208、与图5a至5b相比,与脑特异性年龄预测相关的中位数年龄加速可以大于没有器官特异性的年龄预测的中位数年龄加速。这可能暗示脑特异性衰老时钟(例如,脑特异性衰老模型)可以包含与神经胶质瘤对脑部或神经组织的影响有关的增强信息。
209、2. 器官特异性衰老时钟
210、特定器官的生物学年龄和实际年龄之间的比较可以允许确定器官的生物学年龄的加速或减速,这可能实现与该器官相关的非侵入性疾病检测和预防性干预。为了进一步证明建立用于单个器官的衰老时钟的可行性,使用具有升高的5hmc水平的器官特异性基因构建针对k个不同器官的器官特异性衰老模型。作为示例,k可以至少为5个、6个、7个、8个、9个、10个、11个、12个、13个、14个、15个、16个、17个、18个、19个、20个、21个、22个、23个或更多个器官。例如,脑特异性基因可以指相对于其他组织类型,在脑组织中具有高甲基化水平(例如,高5hmc水平)的基因。在另一示例中,可将器官或组织特异性基因定义为相对于其他器官或组织,在特定器官或组织中显示差异5mc、甲基化、表达或组蛋白修饰模式的基因。
211、在该示例中,基于第一数据集中未患癌症的对象的cfdna 5hmc数据,使用lasso回归开发了k(例如,15)个器官特异性衰老模型。与脑特异性衰老模型类似,每个器官特异性模型可以获得在生物通路中富集、在组织中富集或其他与器官相关的基因的5hmc数据。对应于每个器官的每种基因的cfdna 5hmc数据可以被分成训练数据集和测试数据集。在图13a至图13d中可描绘由每个器官特异性模型使用每个器官的测试和训练数据集提供的预测年龄。图13a至图13d中的预测年龄可以与来自第一数据集的未患癌症的对象的真实年龄对比作图。
212、可以使用皮尔森系数来估计每个器官特异性模型的预测年龄相对于未患癌症的对象的真实年龄的准确度。图14显示了根据本公开的一些实施方案的每个器官特异性年龄模型的皮尔森相关系数的曲线图1400。这些器官特异性模型可以提供在器官水平上对衰老过程的深入了解,这可以允许更精确地评估衰老过程或疾病进展。
213、在一些实施方案中,可以确定两个或更多个器官的年龄。此类器官年龄可以被组合以根据不同的年龄特异性模型(例如肝脏年龄、脑年龄等)确定器官特异性年龄的谱或形势。还可以确定来自各种基因的总年龄并将其用于年龄谱(例如,集合)中。可以将此人的年龄谱与健康人或具有已知病变的人的年龄谱进行比较。
214、
e. 使用形态特性的方法
215、图15是示出根据本公开的一些实施方案的用于检测具有已知实际年龄的对象中的病变(例如,病状或病症)的方法1500的流程图。方法1500的某些方面可以以与方法400和600类似的方式执行。
216、在框1502处,方法1500可以包括接收包括在多个游离dna(cfdna)分子的位点处的甲基化状态的序列读数。序列读数可以包括每个cfdna分子的一个或多个位点。框1502可以以与方法400的框402类似的方式执行。
217、在框1504处,方法1500可以包括将序列读数与参考基因组进行比对。参考基因组可以是对应于对象的物种的dna序列的代表性示例。比对可以涉及搜索在参考基因组中与序列读数最佳匹配的位置。
218、序列读数可以比对到基因组中的cpg位点的集合。在表4中提供了可以与序列读数比对的cpg位点的示例。另外地或者可选择地,可以将序列读数与参考基因组中的基因进行比对。基因可以包括对应于图2中所描绘的和表1所提供的块状点的3,000种基因中的任何数目。在一些示例中,一个或多个cpg位点的集合中的至少一些可对应于基因。因此,至少一些序列读数可以与基因内的cpg位点的集合进行比对。表4显示了与基因相对应的cpg位点的示例。框1504可以以与方法400的框404类似的方式执行。
219、在框1506处,方法1500可以包括,对于一组或多组的cpg位点集合中的每一组,鉴定比对到该组cpg位点的集合中的任何cpg位点的一组序列读数。该组cpg位点的集合可以包括至少3个cpg位点集合。在一些示例中,cpg位点的集合可以包括至少4个、5个、6个、7个、8个、9个、10个、11个、12个、13个、14个、15个、16个、17个、18个、19个、20个、30个、40个、50个、60个、70个、80个、90个、100个、200个或250个cpg位点。此外,在一些示例中,一组cpg位点的集合可包括至少4个、5个、6个、7个、8个、9个、10个、11个、12个、13个、14个、15个、16个、17个、18个、19个、20个、30个、40个、50个、60个、70个、80个、90个或100个cpg位点集合。
220、另外,该组中每个cpg位点的集合对于甲基化水平随年龄的变化可以具有相同的形态分类。形态分类可以选自线性的、对数的、二次的和指数的。因此,该组中每个cpg位点的集合中的每一个cpg位点可以以基本上线性、对数、二次或指数的方式,表现出类似的甲基化水平随时间的变化。
221、另外地或者可选择地,如上文提及的,cpg位点的一个或多个集合可对应于基因。在此类示例中,一组cpg位点的集合可以对应于一组基因,其中每组中的每种基因可以针对甲基化水平随时间的变化具有相同的形态分类。形态分类可以选自线性的、对数的、二次的和指数的。也就是说,该组基因中的每种基因可以以基本上线性、对数、二次或指数的方式,表现出类似的甲基化水平随时间的变化。例如,该组基因可以对应于上文关于图8至图10讨论的簇。
222、在一些示例中,每组cpg位点集合和/或对应于每组cpg位点集合的每种基因可以与特定组织相关联。每个cpg位点的集合或每种基因与特定组织的关联可以基于(1)生物通路或(2)表观遗传模式或(3)在特定组织类型中大于阈值的表达水平来确定。特定组织类型可以是器官。更具体地,组织类型可以包括骨髓、脑、卵巢、胰腺、肝脏、下丘脑、心脏、肾脏、膀胱、前列腺、淋巴结、乳腺、肺、皮肤或睾丸。
223、在框1508处,方法1500可以包括,针对一个或多个组的cpg位点的集合中的每个组,使用该组序列读数的甲基化状态确定一个或多个甲基化水平。在一些示例中,甲基化水平可以是与一组序列读数进行比对的每组cpg位点的集合的甲基化位点的数目。或者,在一些示例中,甲基化水平可以是每组cpg位点的集合的甲基化位点的比例、百分比或其他合适的浓度定量。也就是说,甲基化水平可以是每组cpg位点集合的甲基化位点的数目相对于组中位点总数的量度。作为示例,cpg位点的集合(例如基因)的组的数目可以是至少2组、3组、4组、5组、6组、7组、8组、9组、10组、15组、20组、30组、40组或50组。每种基因可以包括各种数目的cpg位点,例如,本文所述的针对其他方法所列出的数目。
224、例如,为了确定一组cpg位点的集合的甲基化水平(例如,5hmc水平和/或5mc水平),可以确定该一个或多个cpg位点的集合处指示甲基化存在或者指示甲基化不存在的甲基化状态的量(数目)。因此,在一些示例中,比对到一组cpg位点的集合的一组序列读数的甲基化水平可以是该组中每一个cpg位点的指示甲基化存在的甲基化状态的量。
225、或者,在其中一个或多个cpg位点的集合中的至少一些对应于基因的示例中,甲基化水平可以是基因特异性甲基化水平。例如,甲基化水平可以是对应于基因的每个cpg位点的指示甲基化存在的甲基化状态的量。
226、在框1510处,方法1500可以包括使用随年龄变化的模型来确定对象中病变的存在的分类。确定病变的存在的分类可以使用对象的已知实际年龄和一个或多个甲基化水平。该模型可以是年龄依赖性机器学习模型。年龄依赖性机器学习模型可以包括多个子模型,每个子模型对应于不同的实际年龄。该模型可以使用具有已知病变分类的对象的参考样本来生成。
227、在一个示例中,确定分类可以包括将一个或多个甲基化水平与一个或多个阈值进行比较,其中所述一个或多个阈值取决于已知的实际年龄。例如,一个或多个阈值可以使用针对给定的实际年龄的正常范围(例如,在指定数目的标准偏差内)。
228、在一些示例中,确定对象中病变存在的分类可以包括根据该组cpg位点的集合的一个或多个甲基化水平生成特征向量,并将特征向量与代表性参考向量进行比较,所述代表性参考向量是使用具有相同已知病变分类(例如,病症分类)的一组测量的参考向量确定的。可以确定两个向量之间的距离。如果特征向量与第一代表性参考向量足够相似(例如,距离在阈值内或最接近代表性参考向量),则可以确定对象具有对应于第一代表性参考向量的第一分类。
229、模型可以基于具有病变(例如,神经胶质瘤)并与对象年龄相同或相似(例如,相同的年龄范围)的样本对象的参考向量来产生第一代表性参考向量。因此,第一代表性参考向量可以包括针对具有病变的样本对象的cpg位点的集合和/或基因的测量的(包括统计学确定的,例如平均的)甲基化水平。
230、另外,模型可以产生针对与对象年龄相同或相似的健康样本对象的第二参考向量。因此,预测对象中病变的存在的分类可以包括将特征向量与每个代表性参考向量进行比较,并确定特征向量与哪个代表性参考向量最相似。在一些示例中,可以存在对应于任何数目的病变的任何数目的代表性参考向量。
231、每个实际年龄或年龄范围可以具有其自己的代表性特征向量的集合。因此,模型可以被认为包括不同年龄的子模型,其中子模型具有针对不同分类的代表性特征向量的集合。在其他实施方式中,模型可以一次确定所有年龄的相对于所有其他代表性参考向量的距离,但是针对不同年龄的此类参考向量的距离可以具有缩放该维度的权重,使得针对不同年龄的到参考向量的距离通常高于针对相同年龄的到参考向量的距离。
232、另外,在一些示例中,确定病变存在的分类可以包括使用模型预测对象的生物学年龄,将生物学年龄与已知的实际年龄进行比较,并基于比较来确定对象中病变存在的分类。例如,为了基于比较确定分类,方法1500可以包括确定生物学年龄和已知实际年龄之间的差异是否超过阈值。阈值可以基于对象的已知实际年龄。如果差异超过阈值,则分类可以指示对象患有病变(例如,神经胶质瘤)。差异可以是正的(年龄加速)或负的(年龄减速),每一个对应于一种类型的年龄异常。
233、确定病变存在的分类还可以包括使用年龄依赖性机器学习模型预测对象的生物学年龄。然后,方法1500可以包括将生物学年龄与对象的已知实际年龄进行比较,并基于该比较确定对象中病变存在的分类,并且其中该病变是针对特定组织类型的病变。
234、vi. 针对不同特征数目的年龄准确度
235、可以针对不同特征数目确定由模型提供的年龄预测的准确度。在一个示例中,不同特征数目可以是基因的数目。在另一个示例中,不同特征数目可以是cpg位点的数目。
236、图17a显示了训练数据集和测试数据集中的真实实际年龄和预测年龄之间皮尔森相关系数的曲线图1700,所述训练数据集和测试数据集与获得cfdna 5hmc数据并如上文针对图3中所描述的785个对象相关联。皮尔森相关系数各自与在相应的年龄预测模型(例如,上文所述的线性回归模型)中使用的特征数目对比作图,以预测年龄。另外,图17b显示了皮尔森相关系数和来自曲线图1700的特征数目的表1702。
237、在曲线图1700中,特征数目是年龄预测模型用来预测年龄的基因的数目。在与曲线图1700中皮尔森相关系数相关的年龄预测模型中使用的基因选自具有最高归一化标准偏差值的3,000种基因,如图2中的实心黑点所示。在其他示例中,任何数目的基因(例如,至少20、30、40、50、70、80、90、100、150、250种等的基因)可用于年龄预测模型以基于基因的胞嘧啶甲基化水平预测年龄。
238、此外,在曲线图1700中,线1704显示了与训练数据集的年龄预测相关的皮尔森相关系数相对于相应的基因数目的轨迹。相比之下,线1706显示了与测试数据集的年龄预测相关的皮尔森相关系数相对于相应的基因数目的轨迹。在一个示例中,如曲线图1700和表1702所示,当将100种基因的胞嘧啶甲基化水平输入年龄预测模型时,训练数据集和测试数据集的皮尔森相关系数分别为0.9和0.91。
239、图18a还显示了与136个对象相关联的训练数据集和测试数据集中真实实际年龄和预测年龄之间的皮尔森相关系数的曲线图1800。将皮尔森相关系数各自与在相应的年龄预测模型(例如,上文所述的线性回归模型)中使用的特征数目对比作图。图18b显示了来自曲线图1800的皮尔森相关系数和特征数目的表1802。
240、与曲线图1700相比,曲线图1800中的特征数目是由在年龄预测中的相应年龄预测模型使用的cpg的数目。因此,线1804显示了训练数据集的年龄预测的皮尔森相关系数相对于相应的cpg数目的轨迹。然后,线1806显示了测试数据集的预测年龄的皮尔森相关系数相对于相应的cpg数目的轨迹。在一个示例中,如曲线图1800和表1802所示,当将30个cpg的胞嘧啶甲基化水平输入年龄预测模型时,训练数据集和测试数据集的皮尔森相关系数分别为0.96和0.94。
241、在与曲线图1800相关的年龄预测模型中使用的cpg选自上文关于基于胞嘧啶甲基化水平的衰老时钟的49个cpg。任何数目的cpg(例如,至少5、10、20、30、40、49、50个等的cpg)可用于年龄预测模型以基于cpg的胞嘧啶甲基化水平预测年龄。
242、vii. 示例系统
243、图20示出根据本公开的一个实施方案的测量系统2000。所示系统在分析装置2010内包括例如游离dna分子(例如,dna和/或rna)的样本2005,其中可以对样本2005执行分析2008。例如,样本2005可以与分析2008的试剂接触以提供物理特征2015(例如,游离核酸分子的序列信息)的信号(例如,强度信号)。分析装置的示例可以是包括分析的探针和/或引物或微滴移动穿过的管(其中微滴包括分析)的流量槽。通过检测器2020检测样本的物理特征2016(例如,荧光强度、电压或电流)。检测器2020可以按时间间隔(例如,周期性时间间隔)进行测量,获得构成数据信号的数据点。在一个实施方案中,模拟至数字转换器在多个时间将来自检测器的模拟信号转换成数字形式。
244、分析装置2010和检测器2020可形成分析系统,例如根据本文所述的实施方案执行测序的测序系统。将数据信号2025从检测器2020发送至逻辑系统2030。作为一示例,数据信号2025可用于确定核酸分子(例如,dna和/或rna)的参考基因组中的序列和/或位置。数据信号2025可以包括在同一时间作出的各种测量结果,例如用于样本2005的不同分子的荧光染料的不同颜色或不同电信号,并且因此数据信号2025可以对应于多个信号。数据信号2025可储存于局部内存2035、外部内存2040或储存装置2045中。分析系统可以由多个分析装置和检测器组成。
245、逻辑系统2030可以是计算机系统、asic、微处理器、图形处理单元(gpu)等或可以包括计算机系统、asic、微处理器、图形处理单元(gpu)等。还可以包括显示器(例如,监测器、led显示器等)和用户输入设备(例如,鼠标、键盘、按钮等),或与显示器和用户输入设备连接。逻辑系统2030和其他组件可以是独立的或网络连接的计算机系统的一部分,或其可以直接连接至包括检测器2020和/或分析装置2010的装置(例如测序装置)或并入该装置中。逻辑系统2030还可以包括在处理器2050中执行的软件。逻辑系统2030可以包括计算机可读介质,该计算机可读介质储存用于控制测量系统2000以执行本文所描述的方法中的任一种的指令。例如,逻辑系统2030可以向包括分析装置2010的系统提供命令,使得测序或其他物理操作得以执行。此类物理操作可以以特定次序执行,例如以特定次序添加和移除试剂。此类物理操作可通过可用于获得样本和进行分析的机器人(例如包括机器手臂)系统进行。
246、测量系统2000还可以包括可向对象提供治疗的治疗装置2060。治疗装置2060可以确定治疗和/或用于执行治疗。此类治疗的示例可以包括手术、放射疗法、化学疗法、免疫疗法、靶向疗法、激素疗法和干细胞移植。逻辑系统2030可以连接至治疗装置2060,例如以提供本文所描述的方法的结果。治疗装置可从例如成像装置和用户输入的其他装置接收输入(例如以控制治疗,诸如对机器人系统进行控制)。
247、本文中提及的任何计算机系统可以利用任何适合数目的子系统。此类子系统的示例展示于图21的计算机系统10中。在一些实施方案中,计算机系统包括单一计算机设备,其中子系统可以是计算机设备的组件。在其他实施方案中,计算机系统可以包括具有内部组件的多个计算机设备,其各自为一个子系统。计算机系统可以包括台式计算机和笔记本计算机、平板计算机、移动电话和其他移动装置。
248、展示于图21中的子系统经由系统总线75互连。显示额外子系统,例如打印机74、键盘78、一个或多个储存装置79、与显示适配器82连接的监测器76(例如显示屏幕,诸如led)和其他装置。连接至输入/输出(i/o)控制器71的周边装置和i/o装置可以通过本领域中已知的多种装置(例如输入/输出(i/o)端口77(例如usb、firewire®))连接至计算机系统。例如,i/o端口77或外部接口81(例如以太网络(ethernet)、wi-fi等)可用于将计算机系统10连接至广域网(例如因特网)、鼠标输入设备或扫描仪。经由系统总线75实现的互连允许中央处理器73与每个子系统传递信息并控制来自系统内存72或储存装置79(例如固接磁盘,诸如硬盘机,或光盘)的多个指令的执行,以及子系统之间的信息交换。系统内存72和/或储存装置79可以包括计算机可读介质。另一子系统为数据收集装置85,例如照相机、麦克风、加速计等。本文所提及的任何数据可以从一个组件输出至另一个组件并且可以输出给用户。
249、计算机系统可以包括多个相同组件或子系统,例如通过外部接口81、通过内部接口或经由可移动的储存装置连接到一起,可移动的储存装置可以从一个组件连接至另一组件并移动至另一个组件。在一些实施方案中,计算机系统、子系统或设备可以通过网络进行通信。在此类情况下,可以将一个计算机视为客户端并将另一个计算机视为服务器,其中每个计算机可以是同一计算机系统的一部分。客户端和服务器可以各自包括多个系统、子系统或组件。在各种实施方案中,方法可以涉及各种数目的客户端和/或服务器,包括至少10个、20个、50个、100个、200个、500个、1,000个或10,000个装置。方法可以包括装置之间各种数目的通信信息,包括至少100个、200个、500个、1,000个、10,000个、50,000个、100,000个、500,000个或一百万个通信信息。此类通信可以涉及至少1 mb、10 mb、100 mb、1 gb、10 gb或100 gb的数据。
250、实施方案的方面可以使用硬件电路(例如,特定应用的集成电路或现场可编程门阵列)和/或使用以模块化或整合式方式储存于具有通用可编程处理器的内存中的计算机软件以逻辑控制形式实施,并且因此处理器可以包括储存配置硬件电路的软件指令的内存以及具有配置指令的fpga或asic。如本文所使用的,处理器可以包括单核处理器、同一个积体芯片上的多核处理器或单一电路板或网络硬件以及专用硬件上的多个处理单元。基于本公开和本文中所提供的教导内容,本领域中一般技术人员将了解使用硬件和硬件与软件的组合实施本公开的实施方案的其他方式和/或方法。
251、本技术中所描述的任何软件组件或功能可以使用例如常规或面向对象的技术,以软件代码形式实施,软件代码通过处理器使用任何适合计算机语言(例如java、c、c++、c#、objective-c、swift)或脚本处理语言(例如perl或python)执行。软件代码可以以一系列指令或命令形式储存于计算机可读介质上用于储存和/或传输。合适的非暂时性计算机可读介质可以包括随机存取存储器(ram)、只读存储器(rom)、磁性媒体(例如硬盘或软盘)或光学媒体(例如密闭磁盘(cd)或数字光盘(dvd)或蓝光光盘)、闪存及其类似装置。计算机可读介质可以是此类装置的任何组合。另外,可以重新配置操作的次序。处理程序可以在其操作完成时终止,但可以具有不包括于图片中的额外步骤。处理程序可以对应于方法、函数、程序、子例程、子程序等。当处理程序对应于函数时,其终止可以对应于函数传回至调用函数或主函数。
252、此类程序也可以使用适用于经由符合多种协议的有线、光学和/或无线网络(包括因特网)传输的载波信号来编码和传输。因此,计算机可读介质可以使用此类程序编码的数据信号建立。以程序代码编码的计算机可读介质(例如,作为软件)可以与兼容装置一起封装或与其他装置分开提供(例如通过因特网下载)。任何此类计算机可读介质可以存在于单一计算机产品(例如硬盘机、cd或整个计算机系统)上或其内部,并且可以存在于系统或网络内的不同计算机产品上或其内部。计算机系统可以包括用于向用户提供本文所提及的任何结果的监测器、打印机、或其他适合的显示器。
253、本文所述的任何方法可以完全或部分地使用计算机系统来执行,该计算机系统包括一个或多个配置成可以执行所述步骤的处理器。可以实时地执行通过处理器执行的任何操作(例如,比对、测定、比较、计算机计算、计算)。术语“
实时”可以指在某一时间限制内完成的运算操作或过程。时间限制可以是1分钟、1小时、1天或7天。因此,实施方案可以指向配置成以执行本文所描述的任何方法的步骤的计算机系统,其潜在地具有执行相应步骤或相应步骤组的不同组件。尽管以带编号的步骤形式呈现,但本文中的方法的步骤可以同时或在不同时间或以不同顺序执行。此外,这些步骤的一部分可以与其他方法的其他步骤的一部分一起使用。另外,所有或部分步骤可以是可选的。此外,任何方法的任何步骤可以使用用于执行这些步骤的系统的模块、单元、电路或其他装置来进行。
254、可以在不脱离本公开的实施方案的理念和范围的情况下以任何适合方式组合特定实施方案的指定细节。然而,本公开的其他实施方案可以指向与每个单独方面或这些单独方面的特定组合相关的特定实施方案。
255、已出于说明和描述的目的呈现本公开的例示性实施方案的上述描述。其并不意指详尽的或将本公开限于所描述的精确形式,并且鉴于以上教导,许多修改和变化是可能的。
256、除非明确相反的指示,否则“一个(a)”、“一个(an)”或“所述(the)”的叙述旨在意指“一个或多个(种)”。除非明确相反的指示,否则“或(or)”的使用旨在意指“包容或”而并非“排斥或”。提及“第一”组分不一定需要提供第二组分。此外,除非明确陈述,否则提及“第一”或“第二”组分不会将所提及的组分限于特定位置。术语“基于”旨在“至少部分地基于”。
257、权利要求经拟定可以排除可选的任何要素。因此,本声明旨在与对所主张要素的叙述结合,充当使用例如“仅仅(solely)”、“仅(only)”和其类似术语的排他性术语或使用“否定性”限制的前提基础。
258、本文所提及的所有专利、专利申请、出版物和说明书均出于所有目的以引用的方式整体并入本文。不承认任一者为先前技术。当本技术与本文所提供的参考文献之间存在矛盾时,应以本技术为准。
259、viii. 表格
260、上文实施例中的八个簇(组)的基因在下表1中提供。各种实施方案可以使用任何给定的簇的全部或更少数目的基因。
261、
262、
263、
264、
265、
266、
267、
268、
269、
270、
271、
272、表1:对应于来自图8a至图8d的8个簇的基因。
273、用于器官特异性衰老模型的基因提供在下表2中。各种实施方案可以使用任何给定簇的所有或更少数目的基因。
274、
275、
276、
277、
278、
279、
280、
281、
282、
283、
284、
285、
286、
287、
288、
289、
290、
291、
292、
293、
294、
295、
296、
297、
298、
299、
300、
301、
302、
303、
304、
305、
306、
307、
308、
309、
310、
311、
312、
313、
314、
315、
316、
317、表2: 对应于图13a至图13d中的器官的基因。
318、用于衰老模型的基因提供在下表3中。各种实施方案可以使用全部或更少数目的基因。
319、
320、表3: 对应于图16至图19中使用的数据的基因。
321、用于衰老模型的cpg位点提供在下表3中。各种实施方案可以使用全部或更少数目的cpg位点。
322、
323、表4:对应于图16至图19中使用的数据的cpg位点和相应基因组位置。
324、ix. 参考文献
325、cai, j., chen, l., zhang, z., zhang, x., lu, x., liu, w., shi, g.,ge, y., gao, p., and yang, y.(2019). genome-wide mapping of 5-hydroxymethylcytosines in circulating cell-free dna as a non-invasiveapproach for early detection of hepatocellular carcinoma. gut 68, 2195-2205.
326、cai, j., zeng, c., hua, w., qi, z., song, y., lu, x., li, d., zhang,z., cui, x., and zhang, x.(2021). an integrative analysis of genome-wide 5-hydroxymethylcytosines in circulating cell-free dna detects noninvasivediagnostic markers for gliomas. neuro-oncology advances 3, vdab049.
327、fleischer, j.g., schulte, r., tsai, h.h., tyagi, s., ibarra, a.,shokhirev, m.n., huang, l., hetzer, m.w., and navlakha, s.(2018). predictingage from the transcriptome of human dermal fibroblasts. genome biology 19, 1-8.
328、greenberg, m.v., and bourc’his, d.(2019). the diverse roles of dnamethylation in mammalian development and disease. nature reviews molecularcell biology 20, 590-607.
329、hannum, g., guinney, j., zhao, l., zhang, l., hughes, g., sadda, s.,klotzle, b., bibikova, m., fan, j.-b., and gao, y.(2013). genome-widemethylation profiles reveal quantitative views of human aging rates.molecular cell 49, 359-367.
330、hertel, j., friedrich, n., wittfeld, k., pietzner, m., budde, k., vander auwera, s., lohmann, t., teumer, a., vlzke, h., and nauck, m.(2016).measuring biological age via metabonomics: the metabolic age score. journalof proteome research 15, 400-410.
331、horvath, s.(2013). dna methylation age of human tissues and celltypes. genome biology 14, 1-20.
332、koh, k.p., yabuuchi, a., rao, s., huang, y., cunniff, k., nardone,j., laiho, a., tahiliani, m., sommer, c.a., and mostoslavsky, g.(2011). tet1and tet2 regulate 5-hydroxymethylcytosine production and cell lineagespecification in mouse embryonic stem cells. cell stem cell 8, 200-213.
333、kriaucionis, s., and heintz, n.(2009). the nuclear dna base 5-hydroxymethylcytosine is present in purkinje neurons and the brain. science324, 929-930.
334、lehallier, b., gate, d., schaum, n., nanasi, t., lee, s.e., yousef,h., moran losada, p., berdnik, d., keller, a., and verghese, j.(2019).undulating changes in human plasma proteome profiles across the lifespan.nature medicine 25, 1843-1850.
335、leon, s., shapiro, b., sklaroff, d., and yaros, m.(1977). free dna inthe serum of cancer patients and the effect of therapy. cancer research 37,646-650.
336、li, j., xiong, m., fu, x.-h., fan, y., dong, c., sun, x., zheng, f.,wang, s.-w., liu, l., and xu, m.(2023). determining a multimodal aging clockin a cohort of chinese women. med 4, 825-848. e813.
337、liao, p., ostrom, q.t., stetson, l., and barnholtz-sloan, j.s.(2018).models of epigenetic age capture patterns of dna methylation in gliomaassociated with molecular subtype, survival, and recurrence. neuro-oncology20, 942-953.
338、lin, q., and wagner, w.(2015). epigenetic aging signatures arecoherently modified in cancer. plos genetics 11, e1005334.
339、lister, r., mukamel, e.a., nery, j.r., urich, m., puddifoot, c.a.,johnson, n.d., lucero, j., huang, y., dwork, a.j., and schultz, m.d.(2013).global epigenomic reconfiguration during mammalian brain development. science341, 1237905.
340、lo, y.d., corbetta, n., chamberlain, p.f., rai, v., sargent, i.l.,redman, c.w., and wainscoat, j.s.(1997). presence of fetal dna in maternalplasma and serum. the lancet 350, 485-487.
341、lo, y.d., tein, m.s., pang, c.c., yeung, c.k., tong, k.-l., andhjelm, n.m.(1998). presence of donor-specific dna in plasma of kidney andliver-transplant recipients. the lancet 351, 1329-1330.
342、lowsky, d.j., olshansky, s.j., bhattacharya, j., and goldman, d.p.(2014). heterogeneity in healthy aging. journals of gerontology series a:biomedical sciences and medical sciences 69, 640-649.
343、mandel, p.(1948). les acides nucleiques du plasma sanguin chez 1homme. cr seances soc biol fil 142, 241-243.
344、occean, j.r., yang, n., sun, y., dawkins, m.s., munk, r., belair, c.,dar, s., anerillas, c., wang, l., and shi, c.(2023). gene body dnahydroxymethylation restricts the magnitude of transcriptional changes duringaging. biorxiv.
345、oh, h.s.-h., rutledge, j., nachun, d., pálovics, r., abiose, o.,moran-losada, p., channappa, d., urey, d.y., kim, k., and sung, y.j.(2023).organ aging signatures in the plasma proteome track health and disease.nature 624, 164-172.
346、partridge, l., deelen, j., and slagboom, p.e.(2018). facing up to theglobal challenges of ageing. nature 561, 45-56.
347、pastor, w.a., pape, u.j., huang, y., henderson, h.r., lister, r., ko,m., mcloughlin, e.m., brudno, y., mahapatra, s., and kapranov, p.(2011).genome-wide mapping of 5-hydroxymethylcytosine in embryonic stem cells.nature 473, 394-397.
348、peters, m.j., joehanes, r., pilling, l.c., schurmann, c., conneely,k.n., powell, j., reinmaa, e., sutphin, g.l., zhernakova, a., and schramm, k.(2015). the transcriptional landscape of age in human peripheral blood.nature communications 6, 1-14.
349、robinson, o., chadeau hyam, m., karaman, i., climaco pinto, r., ala-korpela, m., handakas, e., fiorito, g., gao, h., heard, a., and jarvelin,m.r.(2020). determinants of accelerated metabolomic and epigenetic aging in auk cohort. aging cell 19, e13149.
350、rutledge, j., oh, h., and wyss-coray, t.(2022). measuring biologicalage using omics data. nature reviews genetics 23, 715-727.
351、satija, r., farrell, j.a., gennert, d., schier, a.f., and regev, a.(2015). spatial reconstruction of single-cell gene expression data. naturebiotechnology 33, 495-502.
352、shao, j., bernicker, e.h., he, c., and li, z.(2022). cell‐free dna 5‐hydroxymethylcytosine as a marker for common cancer detection. clinical andtranslational discovery 2, e136.
353、szulwach, k.e., li, x., li, y., song, c.-x., wu, h., dai, q., irier,h., upadhyay, a.k., gearing, m., and levey, a.i.(2011). 5-hmc–mediatedepigenetic dynamics during postnatal neurodevelopment and aging. natureneuroscience 14, 1607-1616.
354、walker, n.j., rashid, m., yu, s., bignell, h., lumby, c.k., livi,c.m., howell, k., morley, d.j., morganella, s., and barrell, d.(2022).hydroxymethylation profile of cell-free dna is a biomarker for earlycolorectal cancer. scientific reports 12, 16566.
355、xiong, j., jiang, h.-p., peng, c.-y., deng, q.-y., lan, m.-d., zeng,h., zheng, f., feng, y.-q., and yuan, b.-f.(2015). dna hydroxymethylation ageof human blood determined by capillary hydrophilic-interaction liquidchromatography/mass spectrometry. clinical epigenetics 7, 1-11.
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com