
基于扩散补全的药物推荐方法、系统、设备及介质
本发明涉及人工智能医疗,具体地说是一种基于扩散补全的药物推荐方法、系统、设备及介质。
背景技术:
1、随着医疗信息化快速发展,电子健康记录已成为临床决策支持系统的重要数据来源。电子健康记录依托患者标识与就诊时间构建纵向就诊序列,单次就诊记录可涵盖诊断代码、诊疗操作代码、用药代码等多维度临床视图,是智能药物推荐任务的核心数据支撑,模型可依托患者既往就诊序列生成候选用药方案,辅助临床用药决策。
2、但实际临床场景中,电子健康记录普遍存在多视图数据缺失、录入不完整的问题,部分就诊记录存在单一视图缺失、多视图信息不对等的情况,且不同医疗机构数据采集规范不统一,进一步加剧了诊断、操作、用药三类视图的数据完整性差异。直接剔除缺失视图样本会降低数据利用率,破坏患者完整纵向病程信息;而零填充、均值填充、简单掩码等传统补全方式,无法有效挖掘恢复缺失数据中隐藏的诊疗语义,数据补全效果较差。
3、当前临床缺失数据处理多采用静态插补或单条就诊信息重构方式,存在明显技术短板。该类方法无法兼顾群体与个体特征,既难以贴合不同疾病亚型、诊疗模式对应的群体临床分布规律,也无法匹配患者个人的病程演化纵向上下文,易造成插补结果同质化,偏离患者真实诊疗情况。同时,现有技术未建立插补结果可靠性校准机制,对缺乏真实样本支撑、与已有观测信息语义冲突的低可靠插补代码未做区分处理,这类噪声信息会在纵向序列建模中持续传播、放大,降低患者状态表征的准确性。
4、在药物推荐层面,现有模型多依托患者诊疗状态生成用药方案,忽视了药物分子结构、药物间相互作用的关键价值。少数方法虽引入共处方关系与药物作用图谱,但无法在数据缺失、患者状态表征存在不确定性的场景下,有效融合患者状态、药物结构、处方规律及用药安全约束。
5、故如何能够在电子健康记录存在诊断临床代码集合、操作临床代码集合或用药临床代码集合缺失的情况下,对缺失临床代码集合进行补全的同时,兼顾插补信息的可靠性以及药物推荐的精准性与安全性是目前亟待解决的技术问题。
技术实现思路
1、本发明的技术任务是提供一种基于扩散补全的药物推荐方法、系统、设备及介质,来解决如何能够在电子健康记录存在诊断临床代码集合、操作临床代码集合或用药临床代码集合缺失的情况下,对缺失临床代码集合进行补全的同时,兼顾插补信息的可靠性以及药物推荐的精准性与安全性的问题。
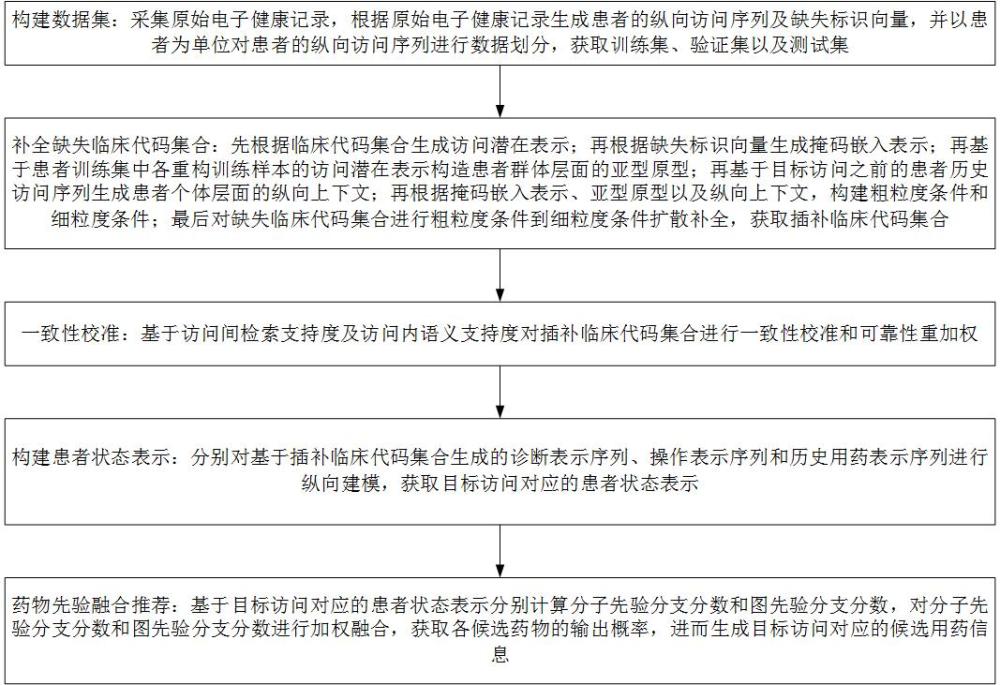
2、本发明的技术任务是按以下方式实现的,一种基于扩散补全的药物推荐方法,该方法具体如下:
3、构建数据集:采集原始电子健康记录,根据原始电子健康记录生成患者的纵向访问序列及缺失标识向量,并以患者为单位对患者的纵向访问序列进行数据划分,获取训练集、验证集以及测试集;
4、补全缺失临床代码集合:先根据临床代码集合生成访问潜在表示;再根据缺失标识向量生成掩码嵌入表示;再基于患者训练集中各重构训练样本的访问潜在表示构造患者群体层面的亚型原型;再基于目标访问之前的患者历史访问序列生成患者个体层面的纵向上下文;再根据掩码嵌入表示、亚型原型以及纵向上下文,构建粗粒度条件和细粒度条件;最后对缺失临床代码集合进行粗粒度条件到细粒度条件扩散补全,获取插补临床代码集合;
5、一致性校准:基于访问间检索支持度及访问内语义支持度对插补临床代码集合进行一致性校准和可靠性重加权;
6、构建患者状态表示:分别对基于插补临床代码集合生成的诊断表示序列、操作表示序列和历史用药表示序列进行纵向建模,获取目标访问对应的患者状态表示;
7、药物先验融合推荐:基于目标访问对应的患者状态表示分别计算分子先验分支分数和图先验分支分数,对分子先验分支分数和图先验分支分数进行加权融合,获取各候选药物的输出概率,进而生成目标访问对应的候选用药信息。
8、作为优选,构建数据集具体为:采集包括患者标识、访问标识、访问时间与各次访问对应的诊断记录、操作记录和用药记录的原始电子健康记录,按照患者标识和访问标识,对诊断记录、操作记录和用药记录进行关联,将具有相同患者标识和访问标识的诊断记录、操作记录和用药记录关联为一次访问记录,并按照访问时间对同一患者的各次访问记录进行升序排序,获取患者的纵向访问序列;根据诊断临床代码集合、操作临床代码集合及用药临床代码集合生成各次访问对应的缺失标识向量;具体如下:
9、关联同一次访问中的多类临床记录:按照患者标识和访问标识,对诊断记录、操作记录和用药记录进行关联,将具有相同患者标识和访问标识的诊断记录、操作记录和用药记录归入同一次访问,获取患者的一次访问记录;对于任一患者,将患者的第次访问记录记为,表示为:;其中,表示第次访问中的诊断临床代码集合;表示第次访问中的操作临床代码集合;表示第次访问中的用药临床代码集合;临床代码是指从诊断记录、操作记录和用药记录中提取并经过格式规范化、无效代码过滤和重复代码去除后获取的离散编码;
10、按照访问时间构建患者纵向访问序列:根据访问时间对同一患者的各次访问记录进行升序排列,获取该患者截至第次访问的纵向访问序列:;其中,分别表示患者按照访问时间排列的第1次至第次访问记录;
11、生成各次访问对应的缺失标识向量:针对第次访问记录,设置三维缺失标识向量:;其中,、和分别表示第次访问中的诊断临床代码集合、操作临床代码集合和用药临床代码集合的缺失标识;当第次访问中任一类临床代码集合在原始电子健康记录中未被记录或临床代码集合为空时,将临床代码集合对应的缺失标识设置为1,表示对应类临床代码集合在当前访问中缺失;当任一类临床代码集合中至少包含一个有效临床代码时,将对应的缺失标识设置为0,表示对应类临床代码集合在当前访问中已被观测;
12、数据集划分:按照预设比例将不同患者划分为训练集、验证集以及测试集;对于归入训练集中的患者,将对应的纵向访问序列、纵向访问序列中包含的全部访问记录以及各个访问记录对应的缺失标识向量作为整体归入患者训练集;对于归入验证集中的患者,将对应的纵向访问序列、纵向访问序列中包含的全部访问记录以及各个访问记录对应的缺失标识向量作为整体归入患者验证集;对于归入测试集中的患者,将对应的纵向访问序列、纵向访问序列中包含的全部访问记录以及各个访问记录对应的缺失标识向量作为整体归入患者测试集。
13、作为优选,补全缺失临床代码集合具体为:先将诊断临床代码集合、操作临床代码集合和用药临床代码集合分别转换为诊断多热向量、操作多热向量和用药多热向量或诊断代码索引序列、操作代码索引序列及用药代码索引序列;再对诊断代码索引序列、操作代码索引序列及用药代码索引序列分别进行代码嵌入操作,获取诊断代码嵌入表示、操作代码嵌入表示及用药代码嵌入表示,并对同一临床代码集合内的代码嵌入进行聚合,获取诊断潜在表示、操作潜在表示及用药潜在表示;再将诊断潜在表示、操作潜在表示及用药潜在表示进行组合处理,获取访问潜在表示;再基于训练集中各重构训练样本的访问潜在表示构造患者群体层面的亚型原型;再基于目标访问之前的患者历史访问序列生成患者个体层面的纵向上下文;再将掩码嵌入与亚型原型进行拼接,获取粗粒度条件;再将掩码嵌入与纵向上下文进行拼接,获取细粒度条件;并根据扩散反向去噪过程的不同阶段对粗粒度条件和细粒度条件进行渐进式切换,进而对缺失临床代码集合进行粗粒度条件到细粒度条件扩散补全;具体如下:
14、构建临床代码嵌入表示并生成访问潜在表示及掩码嵌入表示:分别将诊断代码集合、操作临床代码集合和用药临床代码集合分别转换为诊断多热向量、操作多热向量和用药多热向量或诊断代码索引序列、操作代码索引序列及用药代码索引序列;其中,多热向量中的每一维对应预设代码索引映射中的一个有效临床代码;当任一临床代码出现在当前访问对应的临床代码集合中时,将相应临床代码对应维度置为1,否则置为0;并通过可训练的代码嵌入层分别对诊断代码索引序列、操作代码索引序列及用药代码索引序列进行可训练嵌入操作,获取诊断代码嵌入表示、操作代码嵌入表示及用药代码嵌入表示,并对同一临床代码集合内的代码嵌入表示进行聚合,获取第t次访问对应的诊断潜在表示、操作潜在表示和用药潜在表示:;;;其中,、和分别表示诊断临床代码、操作临床代码和用药临床代码对应的可训练嵌入操作,用于将相应临床代码集合中的有效临床代码转换为代码嵌入表示;表示对同一临床代码集合内的代码嵌入的聚合操作;、和分别表示第次访问中诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的诊断潜在表示、操作潜在表示及用药潜在表示;再将诊断潜在表示、操作潜在表示及用药潜在表示进行组合处理,获取第t次访问的访问潜在表示:;其中,表示访问潜在表示的维度;访问潜在表示是对当前访问记录中诊断临床代码集合、操作临床代码集合及用药临床代码集合进行连续特征化表示后得到的组合潜在特征;再通过可训练的掩码嵌入层对缺失标识向量进行可训练的掩码嵌入操作,获取掩码嵌入表示:;其中,表示可训练的掩码嵌入操作;掩码嵌入表示当前访问中诊断临床代码集合、操作临床代码集合和用药临床代码集合的缺失位置和缺失模式;对于的临床代码集合类型,将对应类型的临床代码集合确定为待补全的临床代码集合;对于的临床代码集合类型,将对应类型的临床代码集合确定为已观测的临床代码集合;其中,,分别对应诊断临床代码集合、操作临床代码集合和用药临床代码集合;
15、构建重构训练样本:从训练集中选取诊断临床代码集合、操作临床代码集合和用药临床代码集合均已观测的访问记录,并对其中至少一类临床代码集合设置训练遮蔽标识,被遮蔽的临床代码集合作为模拟的待补全临床代码集合,原始包含的临床代码作为补全监督目标,形成重构训练样本;其中,训练遮蔽仅用于构造扩散补全模型的训练样本,不改变根据原始电子健康记录确定的缺失标识向量;
16、确定当前访问对应的亚型原型:对于训练集中用于构建重构训练样本的任一完整访问记录,将完整访问记录对应的诊断潜在表示、操作潜在表示以及用药潜在表示组合,获取训练访问潜在表示,并将训练访问潜在表示展开为访问级聚类表示:;其中,表示第个训练访问记录对应的训练访问潜在表示;表示第个训练访问记录对应的访问级聚类表示,表示向量展开操作;再通过k-means聚类算法对训练集中多个访问级聚类表示进行聚类处理,获取由多个临床亚型中心组成的亚型原型集合,表示为:;其中,表示临床亚型中心的数量;表示第个临床亚型中心,用于表征一类患者群体层面的临床模式;再根据访问级聚类表示与各临床亚型中心之间的距离迭代更新各临床亚型中心;对于当前存在待补全临床代码集合的访问记录,根据缺失标识向量保留已观测临床代码集合对应的潜在表示,并将缺失临床代码集合对应的潜在表示置为零向量,获取已观测访问潜在表示;将已观测访问潜在表示展开为访问级表示,并计算访问级表示与亚型原型集合中各临床亚型中心之间的距离,并将距离最小的临床亚型中心确定为当前访问对应的亚型原型;当前访问对应的临床亚型索引表示为:;;其中,表示将临床亚型中心重新排列为与诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的原型表示;亚型原型用于提供与当前访问记录相匹配的群体层面临床模式参考;
17、生成患者个体层面的纵向上下文:分别对患者历史访问中的诊断临床代码集合、操作临床代码集合和用药临床代码集合进行潜在表示编码,获取诊断历史潜在表示序列、操作历史潜在表示序列和用药历史潜在表示序列;分别通过多头注意力编码器对诊断历史潜在表示序列、操作历史潜在表示序列和用药历史潜在表示序列中的时序依赖关系进行建模,并根据历史访问有效标识屏蔽无效位置或者填充位置,获取诊断临床代码集合对应的纵向特征、操作临床代码集合对应的纵向特征和用药临床代码集合对应的纵向特征;将诊断临床代码集合对应的纵向特征、操作临床代码集合对应的纵向特征和用药临床代码集合对应的纵向特征进行组合处理,获取纵向上下文,纵向上下文是对患者历史访问序列进行潜在表示编码和时序聚合后得到的连续特征表示,用于表示目标患者在目标访问之前的个体病程演化信息;其中,患者历史访问序列是由目标访问之前的历史访问记录组成的数据序列; 再分别对患者历史访问中的诊断临床代码集合、操作临床代码集合和用药临床代码集合进行嵌入编码和集合内聚合,获取患者历史访问中的诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的历史潜在表示序列;对于任一临床代码集合类型,历史潜在表示序列表示为:;其中,表示患者第次访问中临床代码集合类型对应的潜在表示;在临床代码集合类型对应的历史潜在表示序列前添加可训练的聚合标记,获取多头自注意力层的输入序列:;其中,表示沿历史访问序列维度进行拼接;表示可训练的聚合标记,用于汇聚患者在临床代码集合类型上的历史访问潜在特征;对于第个注意力头,将输入序列分别输入查询映射、键映射和值映射,得到:;;;其中,,表示多头自注意力层包含的注意力头数量;、和分别表示第个注意力头对应的查询映射矩阵、键映射矩阵和值映射矩阵;、和分别表示对应的偏置参数;、和分别表示第个注意力头的查询矩阵、键矩阵和值矩阵;再根据历史访问有效标识构造临床代码集合类型对应的注意力掩码矩阵;对于聚合标记位置和包含有效历史访问潜在表示的位置,将注意力掩码矩阵中的对应元素设置为0;对于无效历史访问位置或者填充位置,将对应元素设置为负无穷;第个注意力头的输出表示为:;其中,表示每个注意力头的特征维度; 表示键矩阵的转置;表示归一化指数函数;表示第个注意力头输出的历史访问加权特征;再将各注意力头的输出沿特征维度进行拼接,并通过输出映射获取临床代码集合类型 对应的多头自注意力输出:;其中,和分别表示多头自注意力层的输出映射矩阵和偏置参数;表示临床代码集合类型对应的多头自注意力输出;再提取多头自注意力输出中聚合标记所在位置的特征,作为临床代码集合类型 对应的纵向特征:;其中,表示临床代码集合类型对应的纵向特征;表示多头自注意力输出中第一个序列位置,即聚合标记位置对应的输出特征;再根据诊断临床代码集合、操作临床代码集合和用药临床代码集合获取诊断纵向特征、操作纵向特征和用药纵向特征,并按照诊断临床代码集合、操作临床代码集合和用药临床代码集合的顺序进行组合,获取纵向上下文:;
18、构建粗粒度条件和细粒度条件:将掩码嵌入与亚型原型进行拼接,获取粗粒度条件;再将掩码嵌入与纵向上下文进行拼接,获取细粒度条件,形式为:;;其中,表示特征拼接操作;粗粒度条件用于提供当前访问记录中诊断临床代码集合、操作临床代码集合和用药临床代码集合的缺失模式以及患者群体层面的临床模式参考;细粒度条件用于提供当前访问记录中诊断临床代码集合、操作临床代码集合和用药临床代码集合的缺失模式以及目标患者在当前访问之前的个体病程演化信息;
19、根据扩散时间步执行粗到细条件切换:在扩散反向去噪过程中,根据扩散时间步计算由粗粒度条件向细粒度条件过渡的条件切换权重;
20、扩散反向去噪:在扩散采样初始时,先根据诊断临床代码集合、操作临床代码集合和用药临床代码集合当前生成状态的连续潜在特征,构造扩散潜在变量;对于缺失标识指示的待补全临床代码集合,将对应的扩散潜在变量初始化为随机噪声;对于已观测临床代码集合,将对应的扩散潜在变量设置为访问潜在表示中相应临床代码集合的原始潜在表示;再通过去噪网络将当前扩散潜在变量、扩散时间步和当前条件按照从扩散时间步至扩散时间步0的顺序执行反向去噪,分别获取诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的生成潜在表示;其中,去噪网络采用基于自注意力的扩散去噪网络,包括时间步嵌入层、条件嵌入层、位置嵌入层、若干自注意力去噪块、归一化层和潜在映射层;其中,时间步嵌入层用于将扩散时间步转换为时间步嵌入;条件嵌入层用于将当前条件映射为条件嵌入;位置嵌入层用于为时间步嵌入、条件嵌入以及诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的扩散潜在变量加入位置信息;自注意力去噪块用于建模时间步信息、条件信息以及三类临床代码集合对应的潜在表示之间的关联;归一化层和潜在映射层用于输出诊断临床代码集合、操作临床代码集合和用药临床代码集合分别对应的去噪结果;具体为:将扩散时间步经时间步嵌入层处理,获取时间步嵌入,将当前条件经条件嵌入层处理,获取条件嵌入,并将时间步嵌入、条件嵌入和当前扩散潜在变量进行拼接,获取去噪网络的输入序列:;其中,表示位置嵌入;对于第l个自注意力去噪块,处理过程表示为:;其中,表示多头自注意力计算;表示前馈网络;表示层归一化;经若干自注意力去噪块处理后,去除时间步嵌入和条件嵌入对应的位置,仅保留诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的位置,并通过潜在映射层获取去噪网络输出:;其中,表示去噪网络;表示去噪网络在扩散时间步预测的噪声成分;根据缺失标识向量,从反向去噪得到的生成潜在表示中提取待补全临床代码集合对应的生成潜在表示,用于生成相应的插补临床代码;已观测临床代码集合对应的生成潜在表示不用于替换原始已观测临床代码;
21、将生成潜在表示转换为插补临床代码:通过临床代码输出映射层将连续生成潜在表示转换为对应类型候选临床代码的输出概率;临床代码输出映射层采用线性映射层和sigmoid函数;对于任一待补全临床代码集合,将对应的生成潜在表示记为,候选临床代码的输出分数和输出概率分别表示为:;;其中,和分别表示临床代码集合对应的线性映射层的权重参数和偏置参数;表示该候选临床代码的输出分数;表示候选临床代码的输出概率;表示sigmoid函数;根据预设概率阈值对各候选临床代码的输出概率进行离散化处理,即将输出概率不低于预设概率阈值的候选临床代码确定为插补临床代码;将选中的候选临床代码索引通过对应类型的预设代码索引映射的反向映射转换为离散临床代码,获取第次访问对应的插补临床代码集合,再将插补临床代码集合填入目标访问中由缺失标识向量指示的缺失临床代码集合位置,并保留目标访问中的原始已观测临床代码,获取补全后的访问记录表示为:;其中,、和分别表示补全后的诊断临床代码集合、补全后的操作临床代码集合和补全后的用药临床代码集合;再通过可训练的代码嵌入层对补全后的诊断临床代码集合、补全后的操作临床代码集合和补全后的用药临床代码集合进行可训练的代码嵌入操作,获取补全后的诊断临床代码的嵌入表示、补全后的操作临床代码的嵌入表示以及补全后的用药临床代码的嵌入表示,表示为:;;。
22、根据扩散时间步计算由粗粒度条件向细粒度条件过渡的条件切换权重,公式如下:
23、;
24、根据条件切换权重计算当前扩散时间步采用的当前条件:
25、 ;
26、其中,表示第个扩散时间步对应的过渡权重;表示当前扩散时间步;表示扩散总时间步;表示切换比例;表示切换曲线斜率;表示sigmoid函数;表示当前扩散时间步采用的当前条件;通过条件切换方式,在高噪声反向去噪阶段主要利用粗粒度条件中的患者群体亚型原型,使缺失临床代码集合的生成结果优先符合患者群体层面的临床模式;在低噪声反向去噪阶段逐步增强细粒度条件中的纵向上下文,使生成结果进一步结合目标患者在当前访问之前的个体病程演化特征。
27、作为优选,一致性校准具体为:基于目标访问中的原始已观测临床代码集合,从由训练集中三类临床代码集合均被观测的访问记录构建的完整访问库中检索相似访问,获取访问间检索支持度;同时,根据插补临床代码与同次访问中原始已观测临床代码之间的语义一致程度得到访问内语义支持度;根据访问间检索支持度和访问内语义支持度,在纵向患者状态建模之前对插补临床代码进行一致性校准和可靠性重加权;具体如下:
28、构建完整访问库:从训练集中选取诊断代码集合、操作代码集合和用药临床代码集合均为已观测状态的访问记录,并根据预设代码索引映射,将每个完整访问记录中的诊断临床代码集合、操作临床代码集合和用药临床代码集合分别转换为对应的多热向量、和,构建完整访问库;其中,多热向量中的每一维对应一个有效临床代码,当相应临床代码出现在对应临床代码集合中时,相应维度取值为1,否则取值为0;完整访问库仅由训练集中的完整访问记录构建,不包含验证集或者测试集中的访问记录;
29、计算访问间检索支持度:根据缺失标识向量确定第次访问中的已观测临床代码集合类型;对于任一已观测临床代码集合类型,将目标访问在对应类型下的原始已观测临床代码转换为多热查询向量,并计算多热查询向量与完整访问库中第个访问记录对应类型的多热向量之间的jaccard相似度;目标访问与第个完整访问记录之间的综合相似度表示为:;其中,表示临床代码集合类型对应的类型权重, 表示向量内积;表示向量的范数;当各已观测临床代码集合类型对应的类型权重相同时,综合相似度为各已观测临床代码集合类型对应jaccard相似度的算术平均值;按照综合相似度从高到低的顺序,从完整访问库中选取前个访问记录,构成目标访问对应的相似邻居集合;对于位于待补全临床代码集合类型中的插补临床代码,根据插补临床代码在相似邻居访问记录对应类型临床代码集合中的出现情况进行相似度加权投票,获取访问间检索支持度:
30、计算访问内语义支持度:将第次访问中原始已观测临床代码的嵌入表示作为语义锚点,将各临床代码的嵌入表示与所属临床代码集合类型对应的可训练类型嵌入相加,区分诊断临床代码集合、操作临床代码集合和用药临床代码集合;将插补临床代码的嵌入表示作为查询,将同一次访问中原始已观测临床代码的嵌入表示作为键和值,执行跨临床代码集合类型的多头注意力计算,获取插补临床代码对应的类型增强表示和多头注意力分布;针对每一个插补临床代码,分别从多头注意力分布和类型增强表示中提取三类置信特征:第一类置信特征为各注意力头中数值最大的前个注意力值的均值,用于表示同次访问中的原始已观测临床代码对当前插补临床代码的语义支持集中程度;第二类置信特征为各注意力头对应的归一化注意力熵,归一化注意力熵通过将注意力分布的信息熵除以原始已观测临床代码数量的对数得到,用于表示语义支持在原始已观测临床代码之间的分散程度或者不确定程度;当原始已观测临床代码的数量为1时,将归一化注意力熵设置为零;第三类置信特征为插补临床代码的原始嵌入表示与类型增强表示之间的余弦一致性,用于表示插补临床代码自身的语义表示与同一次访问中原始已观测临床代码提供的语义增强信息之间的一致程度;将第一类置信特征、第二类置信特征以及第三类置信特征进行拼接,获取插补临床代码对应的置信特征向量:;其中,表示分别计算各注意力头中前个最大注意力值的均值;表示计算各注意力头对应的归一化注意力熵;表示计算两个嵌入表示之间的余弦相似度;表示特征拼接操作;将置信特征向量输入多层感知机,通过多层感知机对语义支持集中程度、语义支持不确定程度和嵌入方向一致程度进行非线性组合,并将组合结果映射为一个标量;再经sigmoid函数将所述标量转换至0至1之间,获取访问内语义支持度:;访问内语义支持度用于表示插补临床代码与同一次访问中原始已观测临床代码之间的语义一致程度;
31、融合可靠性权重:按照预设融合系数对访问内语义支持度和访问间检索支持度进行加权融合,获取初始融合支持度:;其中,,越大,访问内语义支持度在初始融合支持度中的贡献越大;为避免插补临床代码的嵌入表示被完全置零,在初始融合支持度上设置权重下限,获取最终可靠性权重:;其中,表示可靠性权重下限;当访问间检索支持度和访问内语义支持度中仅有一项能够获取时,将能够获取的访问间检索支持度或访问内语义支持度作为初始融合支持度;当访问间检索支持度和访问内语义支持度均无法获取时,对相应临床代码保持基准权重;
32、对插补临床代码的嵌入表示进行重加权:利用最终可靠性权重对插补临床代码的原始嵌入表示进行重加权,获取重加权后的插补临床代码嵌入:;对于插补临床代码,进行重加权;具体为:对于原始已观测临床代码,保持原始嵌入表示和基准权重不变;将重加权后的插补临床代码嵌入与原始已观测临床代码的嵌入表示按照所属访问和临床代码集合类型重新组合,获取一致性校准后的三类临床代码嵌入集合:;其中,、和分别表示第次访问中诊断临床代码集合、操作临床代码集合和用药临床代码集合对应的一致性校准后嵌入集合;其中,多层感知机包括第一线性映射层、relu激活层和第二线性映射层,处理过程表示为:;其中,和分别表示第一线性映射层的权重参数和偏置参数;和分别表示第二线性映射层的权重参数和偏置参数;表示非线性激活函数。
33、作为优选,构建患者状态表示具体为:在完成一致性校准后,分别对诊断表示序列、操作表示序列和历史用药表示序列进行纵向建模,获取目标访问对应的患者状态表示;具体如下:
34、根据患者第1次访问至第次访问分别获取的一致性校准后的临床代码嵌入集合,获取一致性校准后的纵向临床嵌入序列:;
35、将其中第次访问的一致性校准后的临床代码嵌入集合表示为:;其中,、和分别表示第次访问中一致性校准后的诊断临床代码嵌入集合、操作临床代码嵌入集合和用药临床代码嵌入集合;
36、分别对同一类型临床代码集合内的临床代码嵌入进行聚合,获取第次访问对应的诊断访问表示、操作访问表示和用药访问表示:;;;其中,表示对同一临床代码集合内的临床代码嵌入进行聚合的操作;其中,采用均值聚合方式对同一临床代码集合内的临床代码嵌入进行聚合;当相应临床代码集合中不存在有效临床代码时,将预设零向量作为对应的访问表示;
37、分别采用诊断序列编码器、操作序列编码器和历史用药序列编码器对诊断表示序列、操作表示序列和历史用药表示序列进行纵向编码,获取诊断状态表示、操作状态表示和历史用药状态表示;其中,诊断序列编码器、操作序列编码器和历史用药序列编码器分别采用门控循环单元网络,表示为:;;;其中,、和分别表示诊断序列编码器、操作序列编码器和历史用药序列编码器;
38、对于用于药物先验融合推荐的目标访问,第次访问对应的真实用药代码集合作为候选用药信息生成任务的监督标签,不作为患者状态建模的输入,以避免作为监督标签的真实用药信息直接进入患者状态表示而造成标签泄漏;
39、将诊断状态表示、操作状态表示和历史用药状态表示进行拼接,并将拼接结果输入前馈神经网络,获取目标访问对应的患者状态表示:;其中,表示特征拼接操作,表示前馈映射操作;表示患者状态表示,用于表征目标访问时由诊断表示序列、操作表示序列和历史用药表示序列共同形成的患者当前临床状态。
40、作为优选,药物先验融合推荐具体为:基于患者状态表示分别计算分子先验分支分数和图先验分支分数,并对两类分支分数进行加权融合,获取各候选药物的输出概率,进而生成目标访问对应的候选用药信息;具体如下:
41、构建分子先验分支,具体为:先针对用药临床代码建立的预设代码索引映射确定候选药物集合,候选药物集合由数据集中出现并具有唯一整数索引的不同用药临床代码组成,候选药物集合中的每一个有效用药临床代码对应一个候选药物,并对应分子先验分支分数和图先验分支分数中的一个输出位置;通过预先建立的用药临床代码与药物分子结构信息之间的映射关系,获取各候选药物对应的药物分子结构或者简化分子线性输入规范字符串;获取候选药物对应的药物分子结构信息,并根据药物分子结构信息构建药物分子图:再根据候选药物对应的简化分子线性输入规范字符串构建药物分子图,药物分子图包括原子节点、原子特征以及用于表示原子之间化学键关系的边;再通过消息传递神经网络对药物分子图进行编码,获取各候选药物对应的药物分子表示,并组成药物分子表示矩阵;再计算患者状态表示与药物分子表示矩阵之间的匹配关系,获取分子匹配向量:;其中,表示患者状态表示和药物分子表示的特征维度;表示药物分子表示矩阵的转置;表示sigmoid函数;再通过特征维度的平方根对内积结果进行缩放,调节不同特征维度下匹配结果的数值范围;对分子匹配向量进行残差映射和归一化处理,并利用根据患者状态表示和药物子结构关系得到的局部兼容性向量对处理结果进行调节,获取分子先验分支分数:;其中,表示分子先验分支对应的前馈映射操作;表示层归一化操作;表示逐元素乘法;局部兼容性向量由患者状态表示经线性映射和sigmoid函数处理后,结合药物与药物子结构之间的关联掩码进行掩码线性变换得到;分子先验分支分数用于表示各候选药物的分子结构先验与患者状态表示之间的模型匹配程度;
42、构建图先验分支:先基于训练集中不同药物在同一次访问中的共同出现情况构建药物共处方图 及其邻接矩阵,并基于已知药物之间的不良相互作用关系构建药物相互作用图及其邻接矩阵;药物共处方图用于表示历史共处方关系,药物相互作用图用于表示需要抑制的潜在不良药物相互作用关系;再分别将药物共处方图邻接矩阵和药物相互作用图邻接矩阵输入对应的图卷积网络,获取共处方图表示和相互作用图表示:;;其中,表示药物共处方图对应的图卷积网络;表示药物相互作用图对应的图卷积网络;再根据共处方图表示和相互作用图表示构造药物图先验表示:;;其中,表示可训练的抑制参数;表示经sigmoid函数限制至0至1之间的药物相互作用图抑制系数;通过从共处方图表示中减去按药物相互作用图抑制系数加权的相互作用图表示,使药物图先验表示在保留历史共处方关系的同时,对潜在不良药物相互作用关系进行抑制;药物相互作用图抑制系数不同于用于调节图先验分支整体贡献的图先验分支贡献系数;再计算患者状态表示与药物图先验表示之间的匹配关系,获取图匹配向量 ,并对图匹配向量进行残差映射和归一化处理,获取图先验分支分数 :;;其中, 表示药物图先验表示矩阵的转置;表示图先验分支对应的前馈映射操作;表示层归一化操作;图先验分支分数用于表示候选药物与患者状态之间的匹配关系以及历史共处方关系和药物相互作用关系共同形成的图先验约束;
43、融合分子先验分支分数和图先验分支分数:按照预设图先验分支贡献系数对图先验分支分数进行加权,并将加权后的图先验分支分数与分子先验分支分数相加,获取目标访问对应的候选药物输出分数向量:;其中,表示图先验分支贡献系数,用于调节历史共处方关系和药物相互作用关系形成的图先验信息对候选药物输出分数的整体贡献;
44、生成候选药物概率:对候选药物输出分数向量中的各元素分别执行sigmoid函数,获取候选药物概率向量:;其中,表示目标访问对应的候选药物概率向量;表示sigmoid函数;
45、药物先验融合推荐:设置候选药物概率阈值,将候选药物概率不低于候选药物概率阈值的候选药物确定为目标访问对应的候选药物,生成候选用药信息:;其中,表示针对用药临床代码建立的预设代码索引映射确定的候选药物数量;表示第个候选药物;表示第个候选药物在目标访问中的输出概率;表示目标访问对应的候选用药信息。
46、一种基于扩散补全的药物推荐系统,该系统用于实现如上述的基于扩散补全的药物推荐方法;该系统包括:
47、数据集构建模块,用于采集原始电子健康记录,根据原始电子健康记录生成患者的纵向访问序列及缺失标识向量,并以患者为单位对患者的纵向访问序列进行数据划分,获取训练集、验证集以及测试集;
48、缺失临床代码集合补全模块,用于先根据临床代码集合生成访问潜在表示;再根据缺失标识向量生成掩码嵌入表示;再基于患者训练集中各重构训练样本的访问潜在表示构造患者群体层面的亚型原型;再基于目标访问之前的患者历史访问序列生成患者个体层面的纵向上下文;再根据掩码嵌入表示、亚型原型以及纵向上下文,构建粗粒度条件和细粒度条件;最后对缺失临床代码集合进行粗粒度条件到细粒度条件扩散补全,获取插补临床代码集合;
49、一致性校准模块,用于基于访问间检索支持度及访问内语义支持度对插补临床代码集合进行一致性校准和可靠性重加权;
50、患者状态表示构建模块,用于分别对基于插补临床代码集合生成的诊断表示序列、操作表示序列和历史用药表示序列进行纵向建模,获取目标访问对应的患者状态表示;
51、药物先验融合推荐模块,用于基于目标访问对应的患者状态表示分别计算分子先验分支分数和图先验分支分数,对分子先验分支分数和图先验分支分数进行加权融合,获取各候选药物的输出概率,进而生成目标访问对应的候选用药信息。
52、一种电子设备,包括:存储器和至少一个处理器;
53、其中,所述存储器上存储有计算机程序;
54、所述至少一个处理器执行所述存储器存储的计算机程序,使得所述至少一个处理器执行如上述的基于扩散补全的药物推荐方法。
55、一种计算机可读存储介质,所述计算机可读存储介质中存储有计算机程序,所述计算机程序可被处理器执行以实现如上述的基于扩散补全的药物推荐方法。
56、本发明的基于扩散补全的药物推荐方法、系统、设备及介质具有以下优点:
57、(一)与现有技术相比,本发明能够在电子健康记录存在诊断临床代码集合、操作临床代码集合或用药临床代码集合缺失的情况下,对缺失临床代码集合进行补全、校准和利用,并结合药物分子结构、历史共处方关系以及药物相互作用图进行药物先验融合推荐,兼顾插补信息的可靠性以及药物推荐的精准性与安全性;
58、(二)本发明能够提高不完整电子健康记录中缺失临床代码集合的补全质量:通过粗到细条件扩散补全机制,将群体亚型结构作为粗粒度条件,将患者个体纵向上下文作为细粒度条件,并根据扩散时间步在二者之间进行渐进切换;在高噪声反向去噪阶段,补全过程受到患者群体亚型结构约束,使补全结果符合整体临床分布;在低噪声反向去噪阶段,逐步引入患者个体纵向上下文,使补全结果保留患者自身病情变化特征,能够在缺失临床代码集合重构过程中兼顾整体临床分布和患者个体异质性,减少补全结果向常见临床模式过度收缩或偏离患者真实病程的问题。
59、(三)本发明能够区分不同插补临床代码的可靠性,降低低可靠插补信息对患者状态建模的影响:在纵向患者状态建模之前,对插补临床代码进行一致性校准和可靠性重加权;其中,访问间检索支持度用于提供相似完整访问记录中的群体证据,判断插补临床代码是否能够被相似患者访问记录支持;访问内语义支持度用于提供同一次访问中已观测临床代码的语义证据,判断插补临床代码是否与已观测诊断、操作或用药信息保持语义协调;通过融合访问间检索支持度和访问内语义支持度,能够增强高可靠插补信息的作用,并抑制弱支持或语义不一致插补信息的影响,从而减少低可靠合成信息在纵向患者状态建模过程中的累积和放大;
60、(四)本发明能够提高患者状态表示的准确性和稳定性:在进行纵向患者状态建模之前,先对插补临床代码进行可靠性重加权,再分别对诊断表示序列、操作表示序列和历史用药表示序列进行建模,并融合得到患者当前状态表示,能够在保留诊断、操作和历史用药信息的同时,减弱低可靠插补信息对纵向状态建模过程的干扰,提高患者状态建模在不完整电子健康记录场景下的鲁棒性;
61、(五)本发明能够在药物推荐过程中更充分地融合药物先验知识,提高候选用药信息的安全性:设置分子先验分支和图先验分支,其中,分子先验分支用于建模药物分子结构兼容性,图先验分支用于融合历史共处方关系和药物相互作用关系;通过将两类药物先验与患者状态表示结合,能够使候选用药信息同时考虑患者当前状态、药物分子特征、历史共处方关系以及药物相互作用约束,从而有助于降低不合理药物组合或潜在不良药物相互作用的风险;
62、(六)本发明能够在推荐准确性和用药安全性之间实现更合理的协调:一方面在患者状态表示构建阶段通过一致性校准抑制低可靠插补证据,另一方面在推荐解码阶段融合药物分子结构、历史共处方关系和药物相互作用图,并在训练过程中引入药物相互作用惩罚损失,能够在提高候选用药信息与患者状态匹配程度的同时,降低候选药物组合中潜在药物相互作用风险,从而兼顾药物推荐任务中的有效性和安全性;
63、(七)本发明形成了从不完整电子健康记录输入到候选用药信息输出的完整技术流程,可适用于诊断临床代码集合、操作临床代码集合或用药临床代码集合存在缺失的电子健康记录处理场景,本发明不要求诊断临床代码集合、操作临床代码集合和用药临床代码集合始终完整可用,而是能够针对缺失临床代码集合进行扩散补全,并在补全后进一步进行一致性校准和可靠性重加权,再用于患者状态建模和候选用药信息生成;相比依赖完整电子健康记录输入的传统药物推荐方法,本发明对真实临床数据中的不完整性具有更强适应能力,能够提高药物推荐系统在复杂电子健康记录环境下的实用性和可靠性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com