
一种基于粗粒化分子动力学模型与机器学习加速的丙烯酸乳液乳化剂筛选方法与流程
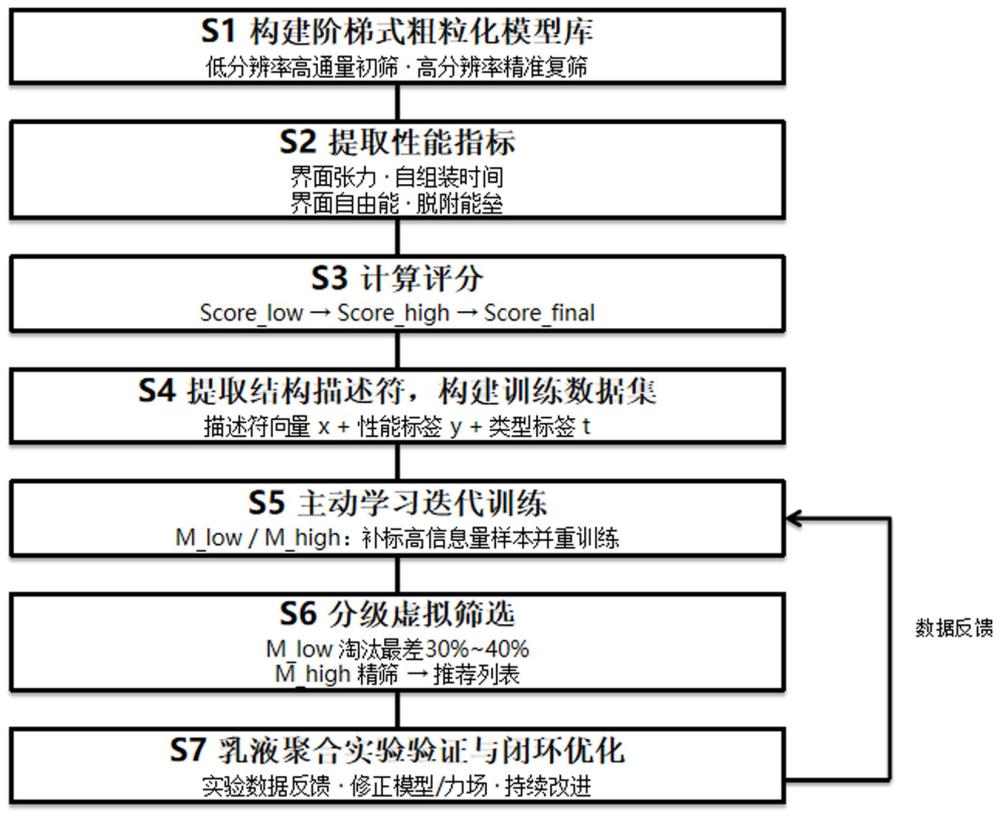
本发明涉及高分子乳液聚合,具体涉及一种丙烯酸乳液聚合用乳化剂的筛选方法,特别是基于粗粒化分子动力学模型与机器学习加速的丙烯酸乳液乳化剂筛选方法。
背景技术:
1、丙烯酸乳液是以丙烯酸酯类单体(包括甲基丙烯酸甲酯(mma)、丙烯酸丁酯(ba)、甲基丙烯酸(maa)等)经乳液聚合制备的高分子水分散体,广泛应用于水性涂料、胶黏剂、纺织涂层等领域。乳化剂是乳液聚合体系中不可或缺的关键组分,直接影响聚合稳定性、乳胶粒粒径、成膜性能及涂膜耐水性等核心品质。
2、根据作用机制的不同,丙烯酸乳液用乳化剂主要分为两类:传统物理吸附型乳化剂(如十二烷基硫酸钠(sds)、十二烷基苯磺酸钠(sdbs)、脂肪醇聚氧乙烯醚等)和反应型乳化剂(又称可聚合乳化剂,分子结构中含有可参与自由基聚合的不饱和双键,如烯丙氧基羟丙基磺酸钠(cops-1)、2-丙烯酰胺-2-甲基丙磺酸(amps)等)。传统物理吸附型乳化剂依靠物理吸附稳定乳胶粒,成本低、种类丰富,但存在游离乳化剂迁移、涂膜耐水性下降等问题;反应型乳化剂通过共价键锚定于乳胶粒表面,可大幅降低游离乳化剂残留、提高涂膜耐水性,但结构设计更为复杂,成本较高。在实际工业应用中,两类乳化剂常单独使用或复配使用,均具有重要的筛选需求。
3、目前,乳化剂的筛选仍严重依赖“经验试错法”,其周期长、成本高、难以规模化。虽然分子动力学(molecular dynamics, md)模拟已被引入表面活性剂的界面行为研究中,但现有技术存在以下关键技术瓶颈:
4、第一,现有粗粒化力场缺乏针对丙烯酸酯单体和乳化剂(尤其是反应型乳化剂)的专门参数化方案。丙烯酸酯单体具有极性酯基,反应型乳化剂含有可聚合双键,直接套用通用粗粒化力场(如martini)会导致界面性质预测的系统性偏差。
5、第二,现有md筛选方法在精度与效率之间难以平衡。全原子md模拟精度高,但计算成本极大——单次模拟耗时数天至数周,难以支撑大规模候选分子的快速筛查。粗粒化md虽能大幅提升计算效率,但单一分辨率的粗粒化模型要么过于简化(每分子仅几个珠子),无法区分同系物之间的细微结构差异;要么分辨率过高,计算成本显著上升。
6、如何在单一粗粒化框架内实现“先快后准”的阶梯式筛选,在反应型乳化剂和丙烯酸单体间未见相关报导。主动学习采样策略在多分辨率粗粒化模拟场景下尚未见到应用。低分辨率粗粒化模拟和高分辨率粗粒化模拟具有不同的计算成本和信息密度,如何设计分层采样策略使主动学习能够在两种分辨率间智能分配标注资源,同时利用低分辨率模拟结果指导高分辨率模拟的初始构型构建,也未见相关报导。
7、因此,开发一种基于粗粒化分子动力学、融合阶梯式分辨率策略、主动学习与机器学习的丙烯酸乳液乳化剂(涵盖传统物理吸附型乳化剂与反应型乳化剂)虚拟筛选方法,对于加速高性能丙烯酸乳液用乳化剂的开发和选型应用,具有重要的技术价值和经济意义。
技术实现思路
1、本发明所要解决的技术问题是提供一种基于粗粒化分子动力学模型与机器学习加速的丙烯酸乳液乳化剂筛选方法,这种方法通过“低分辨率粗粒化高通量初筛→高分辨率粗粒化精准复筛”的分级架构,结合主动学习实现数据高效标注,形成端到端快速筛选,能够实现丙烯酸乳液乳化剂的快速筛选。采用的技术方案如下:
2、一种基于粗粒化分子动力学模型与机器学习加速的丙烯酸乳液乳化剂筛选方法,其特征在于包括下述步骤:
3、s1:分别构建丙烯酸酯单体-水-乳化剂三元界面模型的低分辨率粗粒化模型和高分辨率粗粒化模型,并通过粗粒化分子动力学模拟获取对应的低分辨率粗粒化模拟轨迹和高分辨率粗粒化模拟轨迹;
4、s2:基于所述低分辨率粗粒化模拟轨迹提取低分辨率层次性能指标,基于所述高分辨率粗粒化模拟轨迹提取高分辨率层次性能指标;
5、s3:建立阶梯式粗粒化综合评分模型,基于所述低分辨率层次性能指标生成低分辨率评分用于第一级筛选,基于所述高分辨率层次性能指标生成高分辨率评分用于第二级筛选,并计算综合评分;
6、s4:提取乳化剂分子的结构描述符,并将所述低分辨率层次性能指标和高分辨率层次性能指标作为粗粒化性能标签,构建训练数据集;
7、s5:采用主动学习策略筛选高信息量样本,并迭代扩充训练数据集;
8、s6:利用最终训练的机器学习模型对候选乳化剂库进行分级虚拟筛选,先后经由低分辨率粗粒化模型的第一级筛选和高分辨率粗粒化模型的第二级筛选,输出推荐乳化剂列表。
9、优选方案中,上述基于粗粒化分子动力学模型与机器学习加速的丙烯酸乳液乳化剂筛选方法还包括步骤s7:乳液聚合实验验证与闭环优化。
10、优选步骤s7中,乳液聚合实验验证与闭环优化的方法包括下述步骤:
11、s7-1 取虚拟筛选综合评分排名靠前的若干乳化剂(包括传统物理吸附型乳化剂和反应型乳化剂),按目标丙烯酸乳液配方进行乳液聚合实验;
12、s7-2 将实验数据与预测结果对比,分析偏差来源,据此优化粗粒化力场参数或机器学习模型;
13、s7-3 将实验数据加入训练数据集,重新训练机器学习模型。
14、通过更新机器学习模型,使方法在后续筛选中持续改进,实现“虚拟筛选→实验验证→模型修正”的闭环优化。
15、优选方案中,上述乳化剂包括传统物理吸附型乳化剂和反应型乳化剂;所述反应型乳化剂的分子结构中至少含有一个可参与自由基聚合的碳碳双键。
16、上述步骤 s1中构建丙烯酸乳液乳化剂专用阶梯式粗粒化模型库,包括两个分辨率层次,共享同一套粗粒化力场框架但珠子映射精细程度不同:低分辨率粗粒化模型(cg-low)用于高通量预筛选与快速排序;高分辨率粗粒化模型(cg-high)用于对预筛选后的优选分子进行更精细的界面性质评估。
17、优选方案中,上述步骤s1中,所述低分辨率粗粒化模型中,每个乳化剂分子用3~6个粗粒化珠子表示;所述高分辨率粗粒化模型中,每个乳化剂分子用10~20个粗粒化珠子表示;高分辨率粗粒化模型的初始构型通过将低分辨率模拟的最终构型进行珠子分裂操作获得。
18、优选方案中,上述步骤s1中所述粗粒化模型针对丙烯酸酯单体的极性酯基进行了力场参数校准,包括提高酯基代表珠子与水珠子之间的lennard-jones势阱深度。
19、优选方案中,步骤 s1中构建丙烯酸酯单体-水-乳化剂三元界面模型的低分辨率粗粒化模型的方法包括下述步骤:
20、s1-1-1:建立丙烯酸酯单体和水的低分辨率粗粒化模型;
21、丙烯酸酯单体分子(包括甲基丙烯酸甲酯(mma)、丙烯酸丁酯(ba)、甲基丙烯酸(maa)、丙烯酸乙酯(ea)的一种或多种)在低分辨率层次上按“4对1”或“5对1”的映射方案进行粗粒化,每个粗粒化珠子(bead)代表4~5个重原子;
22、丙烯酸酯单体的酯基官能团和疏水烷基链分别映射为极性珠子和非极性珠子;水分子采用隐式水模型(implicit water model),不显式建入水分子,而是通过设定连续介电常数(ε≈60–80)屏蔽静电相互作用,以最大化计算速度;
23、s1-1-2:建立乳化剂的低分辨率粗粒化模型;
24、依据乳化剂分子的化学结构,采用简化功能模块映射策略:将亲水头基(如硫酸根—so4-、磺酸根—so3-、羧酸根—coo-或聚氧乙烯醚链)映射为1个带有特定电荷和极性的亲水珠子;将疏水尾链(烷基链)映射为1~2个疏水珠子(根据尾链长度决定);对于反应型乳化剂,将其可聚合双键官能团(烯丙基、丙烯酰胺基、乙烯基、甲基丙烯酸酯基等)映射为1个反应性珠子(reactive bead);
25、整体上,每个乳化剂分子在低分辨率粗粒化模型中使用3~6个粗粒化珠子表示;
26、s1-1-3:构建丙烯酸酯单体-水-乳化剂三元界面低分辨率粗粒化模型;
27、在油/水界面两侧按预设的界面面积/乳化剂分子比排布乳化剂分子,添加反离子以中和体系净电荷,随后进行能量最小化、短时间平衡模拟(50~100ns)和生产模拟(1000~2000ns),记录低分辨率粗粒化模拟轨迹。
28、针对低分辨率粗粒化模型,采用经过粗粒度参数校准的martini 3力场或其扩展版本;关键参数包括:不同珠子类型(亲水、疏水、极性、非极性、反应性)之间的lennard-jones势能参数——相互作用势阱深度ε与平衡距离σ;对于反应型乳化剂,还需校准反应性珠子的弹簧常数键合参数。
29、上述重原子(heavy atom)是指分子中除氢原子以外的所有原子(如c、n、o、s 等)。在粗粒化映射中,氢原子由于质量轻、对界面行为贡献小,按 martini 力场惯例作隐式处理(implicit hydrogen)。
30、上述极性珠子、非极性珠子、亲水珠子、疏水珠子、反应性珠子均为"粗粒化珠子"(coarse-grained bead)的具体子类,按物理化学性质和功能划分:按极性分为极性/非极性珠子;按亲疏水性分为亲水/疏水珠子;按反应性分为反应性珠子(仅用于反应型乳化剂)。
31、优选方案中,步骤 s1中构建丙烯酸酯单体-水-乳化剂三元界面模型的高分辨率粗粒化模型的方法包括下述步骤:
32、s1-2-1:高分辨率粗粒化模型的初始构型;
33、通过将低分辨率模拟的最终构型进行珠子分裂细化操作,获得高分辨率粗粒化模型的初始构型:将低分辨率粗粒化模型中的一个粗粒化珠子按照预设的分裂规则,转换为高分辨率粗粒化模型中的多个(如2~4个)第二粗粒化珠子,第二粗粒化珠子的初始位置通过几何插值和局部能量最小化确定;
34、s1-2-2:对构建好的高分辨率粗粒化模型进行短时间再平衡(20~50 ns)后,进行生产模拟(1000~2000ns),记录高分辨率粗粒化模拟轨迹。
35、上述步骤s1-2-1中,通过将低分辨率模拟的最终构型进行珠子分裂细化操作,获得高分辨率粗粒化模型的初始构型,该过程避免了从随机状态重新构建高分辨率粗粒化模型的耗时。
36、在低分辨率粗粒化模型的基础上增加珠子数量,可分辨更细致的分子结构。粗粒化珠子的分裂规则可以是:(1)对于丙烯酸酯单体,将原有的一个极性珠子拆分为两个第二粗粒化珠子,其中一个代表酯基的羰基和氧原子,另一个代表酯基的烷氧基部分;将疏水烷基链按每 2 个碳原子一个珠子的密度进行细化;(2)对于乳化剂,将亲水头基拆分为2~3个第二粗粒化珠子以区分头基内部电荷分布;将疏水尾链按每3~4个碳原子一个第二粗粒化珠子的密度进行细化;(3)对于反应型乳化剂,可聚合双键作为一个独立的、具有明确方向性的反应性珠子保留;(4)整体上,每个乳化剂分子在高分辨率粗粒化模型中使用10~20个第二粗粒化珠子表示。
37、上述步骤 s2中,低分辨率层次性能指标、高分辨率层次性能指标通常均包括界面张力、界面形成能、界面排布特征、脱附自由能中的至少一种;对于含有可聚合双键的乳化剂,还包括双键暴露指数和共聚倾向指数。
38、优选上述步骤 s2中,提取低分辨率层次性能指标和高分辨率层次性能指标的方法包括如下步骤:
39、s2-1:提取低分辨率层次性能指标;
40、低分辨率层次性能指标包括:
41、(1)低分辨率界面张力 γlow:通过应力张量分析法从低分辨率粗粒化模拟轨迹计算;
42、(2)乳化剂在界面处的自组装平衡时间 τeq(从模拟开始到界面覆盖率达到稳态所需的时间);
43、(3)对于反应型乳化剂,计算可聚合双键的低分辨率暴露指数edblow,按如下公式计算:
44、
45、其中nframes代表所截取的总帧数,dmin(t)为第t帧(t≤n),dmin(t)为第t帧中可聚合双键所在反应性珠子与最近单体珠子的质心距离,dc为接触特征距离(取0.6 nm);
46、对于传统物理吸附型乳化剂,该项指标默认edblow设为0;
47、(4)基于低分辨率模拟估算的临界胶束浓度 cmclow(在多个梯度总乳化剂浓度下进行低分辨率模拟,统计未缔合(游离)乳化剂分子浓度,取游离浓度-总浓度曲线由线性上升转为平台(动态平衡)的转折点作为cmclow);
48、s2-2:提取高分辨率层次性能指标;
49、高分辨率层次性能指标包括:
50、(1)高分辨率界面张力 γhigh,作为对低分辨率值的精修;
51、(2)通过高分辨率粗粒化模拟轨迹计算的界面形成能 ∆gads:采用伞状采样(umbrella sampling)方法,沿乳化剂分子质心与界面中心的距离作为反应坐标,计算从水相迁移至界面并稳定吸附的自由能变化;
52、(3)对于反应型乳化剂,计算可聚合双键的高分辨率暴露指数edbhigh以及共聚倾向指数icopol(通过反应性珠子与单体珠子之间的接触频率和结合自由能估算);对于传统物理吸附型乳化剂,这两个指标不参与评分或置为默认值(例如,高分辨率暴露指数、共聚倾向指数的默认值均置为0);
53、所述可聚合双键的高分辨率暴露指数edbhigh按与可聚合双键的低分辨率暴露指数edblow相同的公式计算,仅将模拟轨迹替换为高分辨率轨迹;
54、所述共聚倾向指数icopol定义为:
55、
56、其中δgpair为从高分辨率粗粒化模拟中估算的反应性珠子与单体珠子的结合自由能(kj·mol-1);kcopol为sigmoid函数的缩放系数(无量纲,推荐范围kcopol∈[1, 5]),控制icopol对输入变量的响应灵敏度;αdb为高分辨率双键暴露指数edbhigh的权重系数(无量纲,推荐范围αdb∈[0.3, 0.7]);
57、(4)高分辨率下的界面排布特征参数:分子长轴与界面法线的平均倾角θ(通过计算连接亲水头基中心与疏水尾链末端珠子的向量与界面法线夹角得到),以及倾角分布标准差 σθ;
58、(5)界面脱附自由能能垒∆gdesorp:通过伞状采样计算乳化剂从界面迁移至水相的自由能变化。
59、上述共聚倾向指数icopol算式中,kcopol控制icopol对输入变量的响应灵敏度;kcopol越大,曲线越陡;推荐范围kcopol∈ [1, 5],可通过训练集交叉验证确定。αdb表征双键暴露对共聚倾向的相对贡献。
60、优选上述步骤 s3中,建立阶梯式粗粒化综合评分模型的方法包括如下步骤:
61、s3-1 构建低分辨率评分模型,基于所述低分辨率层次性能指标生成低分辨率评分scorelow,用于第一轮高通量过滤;
62、
63、其中s(·)为min-max归一化函数,对候选库全体分子跨样本归一化至[0,1],方向统一为“越大越优”;δreactive为反应型乳化剂标识(反应型取1,传统物理吸附型取0);w1为低分辨率界面张力s(γlow)的权重(推荐0.2–0.4);w2为自组装平衡时间s(τeq)的权重(0.1–0.3);w3为临界胶束浓度s(cmclow)的权重(0.2–0.4);w4为低分辨率双键暴露指数s(edblow)的权重(0.1–0.3,仅反应型);各权重可按乳化剂类型自动调整或统一为默认值;
64、根据scorelow将候选库分为“优先推荐”(最高的20~30%)、“暂缓”和“淘汰”(最低的30~40%)三个级别;
65、s3-2 对“优先推荐”级别中的分子构建高分辨率评分模型,基于所述高分辨率层次性能指标生成高分辨率评分scorehigh:
66、
67、其中s(·)为min-max归一化函数,对候选库全体分子跨样本归一化至[0,1],方向统一为“越大越优”;w5为高分辨率界面张力s(γhigh)的权重(推荐0.1–0.3);w6为界面形成自由能s(δgads)的权重(0.2–0.4);w7为分子倾角s(θ)的权重(0.1–0.2);w8为脱附自由能s(δgdesorp)的权重(0.1–0.3);w9为高分辨率双键暴露指数s(edbhigh)的权重(0.1–0.3,仅反应型);w10为共聚倾向指数s(icopol)的权重(0.1–0.3,仅反应型);各权重可按乳化剂类型自动调整或统一为默认值;
68、s3-3 构建综合评分模型,生成综合评分scorefinal;
69、
70、其中α为低分辨率评分在最终评分中的权重(0 ≤ α ≤ 1,可根据分子在低分辨率模拟中的置信度动态调整);scorelownorm、scorehighnorm分别为scorelow、scorehigh经整体归一化后的值([0,1])。
71、scorelow由 4 项加权求和得到,scorehigh由 6 项加权求和得到;虽然各项已通过s(·) 归一化到 [0,1],但加权求和后的总评分范围可能不同。直接线性组合会因量级不一致而产生偏倚,因此在代入scorefinal之前,将scorelow与 scorehigh各自做一次整体归一化(如 min-max 归一到 [0,1]),再线性组合。
72、上述步骤s3最终按scorefinal输出推荐排序列表。
73、优选上述步骤s4中,构建训练数据集的方法包括下述步骤:
74、s4-1:提取乳化剂分子的结构描述符向量x,包括:
75、(1)一维描述符:分子量、可旋转键数、氢键供体/受体数;
76、(2)二维拓扑描述符:拓扑极性表面积tpsa、alogp疏水参数、分子折射率、hlb值(按griffin法计算);
77、(3)离子/电荷描述符:亲水头基的离子类型(阴离子型/非离子型/阳离子型)及形式电荷数;
78、(4)反应性描述符(仅对反应型乳化剂):可聚合双键类型、双键位置指数、空间位阻参数;所述双键位置指数为可聚合双键与亲水头基之间的化学键数目,所述空间位阻参数为双键碳上的取代基数目(单取代、1,1-二取代等);对于传统物理吸附型乳化剂,上述反应性描述符全部置0;
79、(5)三维/构象描述符:通过快速力场优化得到的分子最低能量构象下的偶极矩、分子尺寸(回转半径);该构象优化仅为常规的分子结构描述符计算,不涉及分子动力学模拟;
80、s4-2:将步骤s2提取的性能指标构建为性能标签向量y,包括低分辨率性能指标(γlow、τeq、cmclow、edblow)和高分辨率性能指标(γhigh、δgads、θ、δgdesorp、edbhigh、icopol);其中反应型相关指标仅对反应型乳化剂有效,传统物理吸附型乳化剂相应置0;scorelow和scorehigh由步骤s3的固定评分公式计算,不作为机器学习模型的预测目标;
81、s4-3:构建原始训练数据集d0 = {(xi, yi, ti)},其中ti为乳化剂类型标签(传统物理吸附型乳化剂/反应型乳化剂),i 是样本索引(sample index),表示训练数据集中的第 i 个样本(i = 1, 2, …, n;n 为训练集样本总数)。xi为第 i 个乳化剂分子的结构描述符向量(由 s4-1 提取),yi为其对应的性能标签向量(由 s2、s3 计算得到),ti∈ {0, 1}为其类型标签(0 表示传统物理吸附型乳化剂,1 表示反应型乳化剂)。
82、优选上述步骤s5中,采用主动学习策略筛选高信息量样本并迭代扩充训练数据集的方法包括下述步骤:
83、s5-1 训练初始模型:从候选分子中选取少量(10-15个)结构差异较大的代表性乳化剂,执行低分辨率粗粒化模拟并获得性能指标作为标签,与步骤s4的描述符向量x和类型标签t共同构成初始训练集d0;
84、以d0为基础训练两个模型:mlow用于预测低分辨率性能指标,mhigh用于预测高分辨率性能指标;两个模型均以(x,t)为输入特征,能自动区分乳化剂类型;
85、s5-2 找出模型最不确定的分子:对候选池u中尚未标注的分子,用mlow预测其低分辨率性能指标,同时给出不确定性ulow(x),表示模型对该预测的把握程度;ulow(x)以多个模型成员预测值的分散程度(方差)来衡量,预测越分散,模型越没把握;
86、s5-3 分两级选取分子进行标注:
87、第一级采样:从u中选出ulow(x)最大的k1个分子(k1≥5),即模型最不确定的一批分子,对它们执行低分辨率粗粒化模拟,获得低分辨率性能标签;
88、第二级采样:在第一级已标注分子中,按低分辨率评分scorelow从高到低排序,取前k2个(k2≤k1)执行高分辨率粗粒化模拟,获得高分辨率性能标签;高分辨率模拟的初始构型由低分辨率模拟结束时的最终构型经珠子分裂操作获得;
89、s5-4 更新模型:将本轮新标注的样本并入训练数据集,重新训练或微调mlow和mhigh;
90、s5-5 终止条件:重复s5-2至s5-4,直到模型在交叉验证中精度达标(如决定系数r²≥0.8或平均绝对误差mae≤3.5 kj/mol),输出最终的mlow和mhigh。
91、优选上述步骤s6中,利用最终训练的机器学习模型对丙烯酸乳液乳化剂库进行分级虚拟筛选的方法包括下述步骤:
92、s6-1 第一级筛选:利用mlow模型对候选库中所有未标注分子进行快速预测,计算scorelow,淘汰排名最低的30%~40%分子;
93、s6-2 第二级筛选:对通过第一级筛选的剩余分子,利用mhigh模型预测高分辨率性能指标,计算scorehigh和综合评分 scorefinal,输出最终推荐列表。
94、本发明通过“低分辨率粗粒化高通量初筛→高分辨率粗粒化精准复筛”的分级架构,结合主动学习实现数据高效标注,形成端到端快速筛选,能够实现丙烯酸乳液乳化剂的快速筛选。本发明与现有技术相比,具有以下显著优势:
95、1.适用范围广,同时覆盖传统型和反应型乳化剂。该方法针对丙烯酸酯单体体系的极性特征,构建了低分辨率粗粒化高通量预筛选与高分辨率粗粒化精准复筛相协同的阶梯式纯粗粒化筛选框架,适用于传统物理吸附型乳化剂和反应型可聚合乳化剂的统一筛选。
96、 2.使用粗粒化模型,实现阶梯式超高通量筛选。低分辨率模型采用简化珠子映射(每分子3~6珠子),快速计算界面张力、自组装平衡时间等指标,以极低成本淘汰低潜力分子;高分辨率模型通过珠子分裂操作继承低分辨率平衡构型,以更精细的映射(每分子10~20珠子)计算界面形成自由能、脱附能垒等,对于反应型乳化剂还计算双键暴露指数和共聚倾向指数。完全不依赖全原子模拟,由于珠子数量减少5~20倍,时间步长可增大至20~40fs(全原子为2 fs),因此时空尺度可比全原子模拟提升2~3个数量级。以500个候选分子为例,在8块gpu并行条件下,全流程约需2个月。同时本方法采用粗粒化md模拟结果训练两个机器学习替身模型(mlow、mhigh),由替身模型代替昂贵的全库模拟完成筛选,最后以乳液聚合实验验证并反哺模型,形成“训练—筛选—验证”闭环。
97、3. 针对丙烯酸酯体系的力场专项适配填补了技术空白。对粗粒化力场进行系统性校准,首创丙烯酸乳液乳化剂通过粗粒化分子动力学模拟进行虚拟筛选的方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com