
一种基于自适应词典与层级可解释模型的临床疼痛疗效分析方法、系统及存储介质与流程
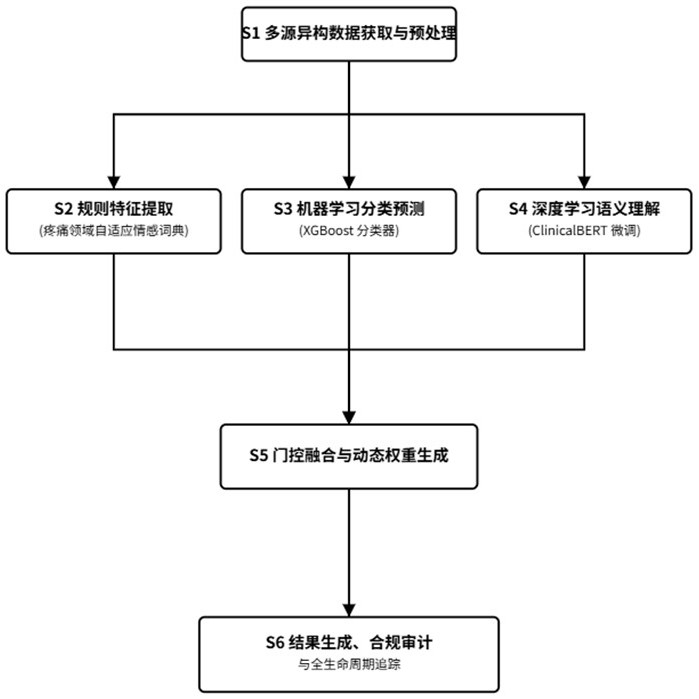
本发明涉及医疗信息学与自然语言处理的交叉,具体来说,涉及一种利用数据驱动方式构建疼痛领域自适应情感词典,并通过多层级可解释模型融合,对临床疼痛主观描述文本、语言或图像等进行自动化疗效信息挖掘与分析的方法、系统及计算机存储介质。
背景技术:
1、在临床试验与新药研发中,患者报告结局(patient-reported outcome, pro)数据的价值日益凸显。疼痛作为最常见的主观症状之一,其疗效评价通常依赖于视觉模拟量表(visual analogue scale, vas)、数值评定量表(numerical rating scale, nrs)或简明疼痛量表(brief pain inventory, bpi)等结构化工具。然而,这些量表存在固有局限:其一,量表评分易受回忆偏差和边界效应影响,患者对"4分"与"5分"的界定常存在个体差异;其二,量表无法捕捉疼痛性质的动态变化(如"锐痛转为钝痛")或伴随症状的改善,而这些信息恰恰是评估治疗综合获益的重要依据。患者对疼痛症状的开放式文本描述,如"疼痛从之前持续的刀割样剧痛转为偶尔的针刺样隐痛"、"虽然还是疼,但忍得住,晚上能睡整觉了",蕴含着远超数字评分量表所能反映的丰富疗效信息。如何从这类充满口语化、个体化表达的非结构化文本中,精准、可解释且可审计地自动挖掘出主观疗效信息,已成为制约pro数据深度利用的关键技术瓶颈。
2、针对文本、语言或图像等情感与语义的自动分析,现有技术中已存在多种方案,但均难以适配临床疗效评估的严苛要求。
3、中国专利申请cn111104515a公开了一种"基于情感词典与机器学习融合的评论情感分析方法"。该方法通过构建一个通用情感词典,提取文本中的情感词作为特征,并将其与词频-逆文档频率(tf-idf)统计特征拼接后,输入至支持向量机(svm)分类器,实现对文本的情感极性判断。然而,该方案仍存在技术缺陷:其一,其依赖的通用情感词典是静态、非领域化的。该词典无法区分"剧痛"、"隐痛"、"压痛"等临床术语在疼痛强度上的连续量级差异,更不能将"减轻"、"缓解"等词汇关联到"疗效改善"这一医学评价维度,导致分析结果临床意义薄弱。其二,其融合机制是简单的特征向量拼接,对于"疼痛是止住了,但恶心的感觉一点没变"这类包含转折关系的复杂句式,模型无法理解语义重心,极易误判,且完全不具备对分析结果的解释能力。
4、再者,中国专利申请cn112632283a公开了一种"基于预训练模型的医疗文本情感分类方法"。该方案直接使用bert模型在医疗文本语料上进行微调,以进行端到端的情感分类。该方法虽然在一定程度上捕捉了深层语义,但其模型决策过程的不透明性带来了两个应用瓶颈:第一,可解释性不足。模型仅输出分类标签,研究者无法获知结论是基于文本中哪些词语、何种逻辑得出,当模型出错时,无法定位错误源头。第二,无法满足合规审计要求。药物临床试验质量管理规范(good clinical practice, gcp)要求影响临床结论的所有数据处理过程可溯源、可稽查,而一个无法解释推理过程的算法模型,其分析结论难以直接作为支持药物注册申请的可靠证据。
5、此外,现有技术中还缺少对ai模型用于临床试验疗效评价时所需的系统性验证方案。具体而言:缺乏使用独立于训练集的外部数据进行模型性能验证的机制;缺乏对模型在不同亚组人群(如不同年龄、性别、基线疼痛等级)中是否存在系统性误判的偏倚评估;缺乏对输入微小变化时模型输出一致性的稳定性测试;缺乏对临床试验长期运行中模型更新换代的版本管理与结果可比性保障机制。
6、在临床可操作性方面,现有技术同样存在缺陷:缺乏对输入数据缺失情况的系统化处理策略;且仅限于纯文本输入,未考虑录音、影像、图片等多模态pro数据的采集与处理。
7、综上所述,如何在保有高精度语义理解能力的同时,赋予分析模型高度的可解释性与全链路审计能力,并配套完善的模型验证与版本管理机制,已成为临床pro文本分析领域亟待突破的技术瓶颈。
技术实现思路
1、本发明的目的在于克服上述现有技术的不足,提供一种基于自适应词典与层级可解释模型的临床试验中疼痛疗效分析方法及系统。本发明通过数据驱动的方式构建了疼痛领域自适应情感词典,并创造性地设计了"规则-统计-语义"三层融合的可解释分析框架,同时内嵌了符合gcp alcoa+标准的审计追踪机制、系统的模型验证与版本管理方案以及多模态数据支持能力,最终实现了一个满足临床试验合规要求的、端到端的自动化分析解决方案。
2、为实现上述目的,本发明首先提供一种基于层级融合模型的临床试验中疼痛主观疗效分析方法,该方法从获取待分析的临床疼痛主观描述文本、语言或图像等开始执行;随后,方法利用预先构建的疼痛领域自适应情感词典,对所述文本进行规则特征提取,生成包含疼痛强度与疗效倾向性信息的情感规则特征向量;同时,方法将所述文本输入至一机器学习分类模型,由其输出基于浅层统计特征的第一疗效预测向量;并将所述文本输入至一深度学习语义理解模型,由其输出基于深层上下文语义的第二疗效预测向量。在此之后,方法将所述情感规则特征向量、所述第一疗效预测向量和所述第二疗效预测向量输入至一预设的门控融合网络,由所述门控融合网络动态生成融合权重,并依据该权重整合得到融合特征向量;最终,方法基于所述融合特征向量,生成所述文本对应的主观疗效分类结果,所述疗效分类结果至少包括缓解/改善、加重、无变化三种倾向类别,并同步构建包含操作者身份标识、融合权重、审核状态及全生命周期追踪信息的审计记录。
3、作为整个方法的前置与重要环节,所述疼痛领域自适应情感词典的构建过程起始于术语归一化步骤:从疼痛相关临床试验指南与标准量表中采集种子词,利用医学系统命名法-临床术语(snomed ct)进行归一化,形成标准疼痛术语列表;在此基础上执行强度自动赋值步骤:获取一训练数据集,所述数据集包含多条患者疼痛文本描述与对应时刻的患者主观疗效锚定评分的配对样本,所述患者主观疗效锚定评分包括视觉模拟量表评分或数值评定量表评分;利用所述配对样本,训练一个文本-强度映射模型,为所述标准疼痛术语列表中的每个术语自动赋予一个连续的情感强度值;随后进入强度插值扩展步骤:对于未在所述训练数据集中出现的衍生疼痛词,利用一预训练语言模型生成词嵌入,通过计算其与已赋值术语的词嵌入相似度,进行强度值插值,实现词典的自动扩展;最后执行疗效倾向性关联步骤:基于依存句法分析,定义谓语-宾语、中心语-修饰语等规则模板,为词典中的术语自动标注其与缓解/改善、加重、无变化三种疗效状态之间的关联倾向性。
4、在本方法的一个优选实施方案中,对所述情感规则特征向量的提取过程被进一步细化。具体而言,系统对文本进行否定词和转折词窗口检测,当一疼痛词位于否定词窗口内时,将其疗效倾向性反转;当检测到转折词时,将基于句法分析判定转折后的分句为语义重心,仅保留该分句的疗效倾向性作为主倾向,以此生成修正后的规则特征向量。此机制从根本上解决了传统方法对"不总是疼"、"虽然疼但能忍"等复杂临床句式判断失准的问题。
5、在本方法的另一个优选实施方案中,所述门控融合网络具体由一全连接层与一softmax激活函数构成,用于动态输出各输入的权重值;而所述审计记录中,除记录并关联了本次分析中该网络输出的所述权重值外,还包含了执行本次分析的操作者身份标识;最终的分类结果在生成后,其初始状态被标记为"待审核",必须经过指定审核人员的电子签名确认后,该结果方可被用于辅助临床试验疗效分析。此外,审计追踪模块支持对已生成结论的修改、复核、驳回等操作的全生命周期追踪,所有关键数据修改均自动留存修改前后值,并强制备注变更原因,日志不可删除、覆盖或篡改。这使得任一条疗效分类结果,均可被回溯解析,展示其依赖词典规则、统计特征与深层语义各部分的贡献比例,并完整重现从生成到确认的完整决策链路。
6、在本方法的又一个优选实施方案中,为了满足临床研究对ai决策可信度的严苛要求,本发明内置了系统的模型验证与版本管理框架。在模型正式部署前,必须使用独立于训练集的、来自不同临床试验或不同中心的外部数据进行验证,并计算模型在各亚组人群(如不同年龄、性别、基线疼痛等级)中的性能指标,以识别并量化潜在的偏倚;同时,通过向输入文本中添加同义词替换、语序微调等微小扰动,监测模型输出的变化程度,以评估模型的鲁棒性。系统为每次模型更新(包括词典扩展、参数调整或架构变更)分配唯一版本号,并记录生效时间。当新版本上线时,系统可自动对同一输入文本同时运行新旧版本,生成详细的版本比对报告,以确保长期临床试验中分析结果的前后可比性。
7、在本方法的又一个优选实施方案中,所述获取待分析的临床试验中疼痛主观描述文本的步骤支持多模态数据来源。通过多模态数据适配器从电子患者报告结局系统、电子数据采集系统、录音设备及影像采集设备获取数据;对于录音数据,通过自动语音识别引擎转写为文本;对于影像数据,通过视频关键帧提取与光学字符识别提取其中包含的文本描述信息。
8、对应地,本发明还提供一种基于层级融合模型的临床试验中疼痛主观疗效分析系统,该系统主要包括多源数据采集模块、词典存储与调用模块、多层级分析引擎结果输出模块、以及审计追踪模块;
9、其中,多源数据采集模块,用于获取待分析的临床试验中疼痛主观描述文本;
10、词典存储与调用模块,用于提供一预先构建的疼痛领域自适应情感词典;
11、多层级分析引擎,其内部包括:
12、规则特征提取单元,用于利用所述词典提取输入文本的情感规则特征向量;
13、机器学习预测单元,用于基于所述文本输出第一疗效预测向量;
14、深度学习预测单元,用于基于所述文本输出第二疗效预测向量;
15、门控融合单元,用于动态生成各输入特征的融合权重,并整合生成融合特征向量;
16、结果输出模块,用于基于所述融合特征向量生成主观疗效分类结果;
17、审计追踪模块,与所述多层级分析引擎耦接,用于实时捕获并记录所述门控融合单元生成的所述融合权重以及各单元的中间处理结果,生成与所述主观疗效分类结果绑定的、符合alcoa+标准的审计日志,所述审计追踪模块内设一审核工作流引擎,用于实现所述分类结果的提交、审核、驳回与修改的全生命周期追踪,并记录执行相应操作的操作者身份标识及电子签名。
18、在本系统的一个优选实施方案中,所述系统还包括一模型验证与版本管理模块,与所述多层级分析引擎耦接,用于存储各版本模型的性能评估报告、偏倚分析结果及稳定性测试数据,并在模型更新时触发版本比对流程。
19、在本系统的另一优选实施方案中,所述多源数据采集模块包括一多模态数据适配器,所述多模态数据适配器支持从电子患者报告结局系统、电子数据采集系统以及录音设备、影像采集设备获取数据;对于录音数据,通过自动语音识别引擎转写为文本;对于影像数据,通过视频关键帧提取与光学字符识别提取其中包含的文本描述信息。
20、此外,本发明还提供一种计算机可读存储介质,其上存储有计算机程序,该程序被处理器执行时实现上述方法的全部步骤。
21、本发明所提出的技术方案相较于现有技术,具有如下有益效果:
22、首先,在分析精度方面,通过数据驱动的词典构建方法,本发明使词典具备了描述疼痛“连续强度”的能力,其强度赋值与患者自评vas、nrs、bpi等 评分具有显著相关性;而三层异构模型的动态融合,使得系统在处理含否定、转折、口语化及多症状并存的复杂句式时,分类性能获得显著提升。
23、其次,在可解释性与合规性方面,通过动态权重记录与回溯机制,本发明赋予模型决策过程以可解释性与透明性。系统不仅能给出疗效结论,还能清楚展示结论的决策依据,并结合操作者身份标识、审核电子签名及全生命周期追踪机制,使分析过程具备完全的透明性、可审计性和责任可追溯性,使ai驱动的pro文本分析结论具备了可以作为符合gcp要求的临床证据的潜力。
24、再次,在ai模型的临床可信度方面,本发明通过强制性的外部验证、亚组偏倚分析、稳定性测试以及版本比对机制,为算法决策的可靠性提供了系统性的量化评估体系,有效消除了监管方和临床研究者对算法模型可靠性的疑虑。
25、最后,在自适应性方面,词典的自扩展机制使其能够自动适应不同患者群体的新式表达,极大降低了人工维护成本;多模态数据支持能力使系统能够适应更丰富的临床数据采集场景;整个构建和训练流程可作为模板,低成本地迁移至疲劳、恶心、焦虑等其他核心临床试验主观症状的分析中。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com