
基于异构图神经网络的蛋白质-配体结合口袋序列的设计方法、蛋白质突变评估方法、系统、设备、介质以及应用与流程
本发明属于计算生物学与人工智能辅助蛋白质设计,具体而言,涉及到基于异构图神经网络的蛋白质-配体结合口袋序列的设计方法、蛋白质突变评估方法、系统、设备、介质以及应用。
背景技术:
1、逆折叠(inverse folding)是蛋白质设计中的核心计算任务,旨在根据目标蛋白质的三维骨架结构反向推导出能够折叠形成该结构的氨基酸序列,其本质是解决“结构到序列”的逆向映射问题。其科学意义在于突破天然蛋白质的进化限制,实现“按需定制”——例如设计高温稳定的工业用酶、高亲和力的靶向药物蛋白、或可降解塑料的人工催化中心,推动合成生物学、精准医疗和绿色化学的发展。同时,逆折叠模型能揭示序列-结构-功能的深层关联,能“零样本”预测突变蛋白的性质,从而架起了从基础蛋白质物理理解到生命科学工程应用的桥梁。
2、目前已有的逆折叠模型通常追求序列的高恢复率,但序列恢复率越高并不一定意味着蛋白质的功能就越强。因此在面对如催化活性优化等零样本预测任务时表现欠佳,其设计的序列可能丧失宝贵的进化优势。此外,这些模型主要依赖主链信息,难以精确描述直接参与催化的侧链所处的物理化学微环境。
3、检索到的相关专利文献:
4、公开国别中国,公开号cn122090950a,公开日期2026年5月26日,该文献公开了蛋白质逆折叠模型的训练方法、设计方法、装置及设备,训练方法包括:获取训练样本集,训练样本包括靶蛋白与结合剂蛋白的结构信息;将训练样本输入蛋白质逆折叠模型,得到结合剂蛋白的多个候选氨基酸序列;计算靶蛋白与各个候选氨基酸序列的结合剂蛋白的结合性能指标,结合性能指标包括复合物构象量化指标和/或结合亲和力量化指标;根据结合性能指标,构建正负样本对;基于强化学习算法和正负样本对,对蛋白质逆折叠模型进行训练,得到训练后的蛋白质逆折叠模型。
5、公开国别中国,公开号cn120032720a,公开日期2025年5月23日,该文献公开了一种基于玻尔兹曼对齐的逆折叠模型预测蛋白质突变效应的方法、系统和装置,通过基于逆折叠模型,选取突变型和野生型蛋白质复合物在结合前后的蛋白质骨架结构,预处理得到蛋白质骨架的结构和序列特征,进而捕捉蛋白质骨架结构的局部和全局特征,预测蛋白质骨架序列的条件概率;基于条件概率,结合玻尔兹曼分布与热力学循环原理预测结合自由能的变化,并通过湿实验测得的结合自由能变化的数据微调参数,求解最终的结合自由能变化值。本发明提供的方法基于逆折叠模型预测蛋白质骨架序列的条件概率,预测结合自由能的变化,并引入湿实验数据标签进行微调,增强了预测精度及泛化能力,提高蛋白质化合物设计的成功率。
6、前述文献代表的现有技术至少存在以下未解决的技术问题或缺陷:
7、1.cn122090950a中预测模型对未见过的突变体(尤其是非天然氨基酸组合)的置信度分数往往虚高、耗时久、成本高,相关证据为:helixfold3等模型预测的plddt、pae和iptm作为构象质量的“金标准”,倾向于生成那些让预测模型“感觉良好”但实际折叠错误的序列;强化学习(尤其是dpo/ppo)需要数万乃至数十万条带标签的样本才能收敛,而真实的spr/itc湿实验通量极低。
8、与传统全局逆折叠方法不同,本技术聚焦于决定催化性能的关键区域——底物结合口袋及其周边结构,从而直接实现“功能导向”的结构到序列映射。我们开发了一种以活性口袋为核心的蛋白质逆折叠模型,专注于分子结合区域的蛋白质重新设计,旨在实现高结合强度和高催化活性。与现有方法相比,本技术的模型同时整合了进化信息和局部相互作用信息,不仅在结构到序列的映射预测上表现更优,在针对蛋白适应性、热稳定性和口袋结构破坏性突变的零样本预测方面也实现了显著提升。这一改进有望为功能导向的酶设计与靶向药物开发提供更可靠的计算工具。
技术实现思路
1、本发明的目的在于提供:
2、一种基于异构图神经网络的蛋白质-配体结合口袋序列的设计方法、评估方法、系统、设备、介质以及应用,及其相关技术,以解决预测概率低、依赖主链信息、描述直接参与催化的侧链所处的物理化学微环境不精确、集合强度和催化活性低等技术问题或其组合。
3、术语说明:
4、除非另有定义,否则本文所有科技术语具有的涵义与权利要求主题所属领域技术人员通常理解的涵义相同。除非另有说明,本文全文引用的所有专利、专利发明、公开材料通过引用方式整体并入本文。如果本文对术语有多个定义,以本章的定义为准。
5、应理解,上述简述和下文的详述为示例性且仅用于解释,而不对本发明的主题作任何限制。在本发明中,除非另有具体说明,否则使用单数时也包括复数。还应注意,除非另有说明,否则所用“或”、“或者”表示“和/或”。此外,所用术语“包括”以及其它形式,例如“包含”、“含”和“含有”并非限制性。
6、可在参考文献“《生物计算模拟与蛋白质设计(化学工业出版社十四五普通高等教育规划教材)》,编者:段谟杰,责编:傅四周,isbn:9787122497024,出版年月:2026-03,出版社:化学工业出版社”中找到对标准术语的定义。
7、除非提出具体定义,本文中使用的各类市售产品的使用,均采用标准技术。例如,可利用厂商对试剂盒的使用说明,或者按照本领域公知的方式或本发明的说明来进行实施。通常可根据本说明书中引用和讨论的多个概要性和较具体的文献中的描述,按照本领域熟知的常规方法实施上述技术和方法。
8、术语“任选/任意”或“任选地/任意地”是指随后描述的事件或情况可能发生或可能不发生,该描述包括发生所述事件或情况和不发生所述事件或情况。
9、本文所用的术语“异构图神经网络”,指:一种能够处理包含多种类型节点和边的图数据的图神经网络架构。在蛋白质-配体相互作用预测中,异构图神经网络将蛋白质-配体复合物编码为包含两类节点(如蛋白质残基节点与配体原子节点)和多种边类型的异构图,通过针对不同节点和边类型设计专用的信息传播与聚合策略,捕获生物异构图中的高阶复杂依赖关系和丰富语义信息。例如,gif-pla方法将蛋白质-配体结合复合物表示为带有元路径的异构图,以捕获拓扑相互作用和高阶非线性关系。
10、本文所用的术语“配体重原子”,指:配体分子中除氢原子以外的重原子(如碳、氮、氧、硫、磷等非氢原子)。在基于图的蛋白质-配体相互作用建模中,配体重原子通常作为异构图中的“配体原子节点”进行编码,其节点特征包括原子元素类型的独热编码(如c、n、o、s、p等)。重原子相较于氢原子携带更丰富的结构信息和化学特征,是配体分子图表示的核心构成单元。
11、本文所用的术语“蛋白质残基节点”,指:将蛋白质中的氨基酸残基作为图神经网络中节点(node)的基本单元。在蛋白质结构图表示中,每个氨基酸残基对应一个节点,携带残基类型(氨基酸种类)、残基索引、位置编码等特征。蛋白质残基节点之间的边代表残基之间的空间或序列关系(如距离、接触、氢键等)。在蛋白质-配体异构图表示中,蛋白质残基节点与配体原子节点构成两类核心节点类型。
12、本文所用的术语“配体原子节点”,指:将配体(小分子)中的原子作为图神经网络中节点的基本单元。在蛋白质-配体异构图表示中,配体原子节点与蛋白质残基节点并列作为两类核心节点类型。配体原子节点的特征通常包括原子元素类型的独热编码(如c、n、o、s、p、zn、fe、cu等),原子在三维空间中的坐标信息,以及原子所属化学基团等属性。配体原子节点之间通过共价键相连形成分子图。
13、本文所用的术语“嵌入编码”,指:将离散的、高维的原始输入数据(如原子类型、残基类型、分子结构等)转换为连续的低维向量表示的过程。在蛋白质设计中,嵌入编码通常通过可学习的神经网络层实现,将每个节点(残基或原子)的原始特征映射到统一的隐空间维度,生成节点嵌入向量(node embedding)。嵌入编码使得图神经网络能够在统一的向量空间中处理不同类型的节点信息,为后续的消息传递和特征融合提供基础。
14、本文所用的术语“残基节点编码模块”,指:专门用于将蛋白质残基的原始特征编码为节点嵌入向量的神经网络模块。该模块接收每个残基的输入特征(如氨基酸类型、主链原子坐标、残基索引等),通过可学习的编码层将其转换为固定维度的隐空间表示。在蛋白质-配体异构图模型中,残基节点编码模块与配体节点编码模块并行工作,分别对两类节点进行特征编码,生成统一维度的节点嵌入。
15、本文所用的术语“配体节点编码模块”,指:专门用于将配体原子的原始特征编码为节点嵌入向量的神经网络模块。该模块接收每个配体原子的输入特征(如原子元素类型、三维坐标、化学键信息等),通过可学习的编码层将其转换为固定维度的隐空间表示。在蛋白质-配体异构图模型中,配体节点编码模块与残基节点编码模块共享相同的架构但接受不同的输入特征维度,两者均生成统一维度的节点嵌入。
16、本文所用的术语“残基内部消息传递模块”,指:在蛋白质-配体异构图神经网络中,专门负责在蛋白质残基节点之间进行信息传播与聚合的模块。该模块通过图神经网络的消息传递机制,使每个残基节点能够从其相邻残基节点(如在三维空间中距离相近的残基,或通过接触图连接的残基)收集信息,更新自身的节点表示。残基内部消息传递模块旨在捕获蛋白质内部的长程相互作用和协同进化信息。
17、本文所用的术语“配体内部消息传递模块”,指:在蛋白质-配体异构图神经网络中,专门负责在配体原子节点之间进行信息传播与聚合的模块。该模块通过图神经网络的消息传递机制,使每个配体原子节点能够从其共价键连接的相邻原子节点收集信息,更新自身的节点表示。配体内部消息传递模块旨在捕获配体分子内部的化学结构和电子效应信息。
18、本文所用的术语“蛋白质-配体跨节点类型消息传递模块”,指: 在蛋白质-配体异构图神经网络中,专门负责在蛋白质残基节点与配体原子节点之间进行跨类型信息传播的模块。该模块使蛋白质节点能够从配体节点获取信息,同时使配体节点能够从蛋白质节点获取信息,从而实现蛋白质与配体之间的双向信息交互。该模块是捕获蛋白质-配体分子间相互作用(如氢键、疏水相互作用、范德华力等)的核心组件。
19、本文所用的术语“图注意力卷积网络gatconv”,指:一种基于注意力机制的图神经网络卷积层,由velikovi等人在2018年iclr会议上提出的图注意力网络(graphattention networks)中的核心卷积层。与传统的图卷积网络不同,gatconv在聚合邻居节点信息时,通过注意力机制为不同的邻居节点分配不同的权重,使模型能够自动关注对当前节点最重要的邻居信息。在蛋白质-配体相互作用建模中,gatconv常用于节点特征的变换和更新。
20、本文所用的术语“注意力交叉消息传递模块”,指:在蛋白质-配体异构图神经网络中,基于注意力机制的跨类型信息传递模块。该模块借鉴transformer中的交叉注意力(cross-attention)机制,将一种类型节点的特征作为query,另一种类型节点的特征作为key和value,通过计算注意力权重来实现两类节点之间的选择性信息交换。注意力交叉消息传递模块能够动态地聚焦于蛋白质-配体相互作用中最重要的特征和关系。
21、本文所用的术语“query向量生成模块”,指:在注意力交叉消息传递模块中,负责生成query(查询)向量的子模块。该模块将源节点(发起信息查询的一方)的嵌入向量通过线性变换投影到查询空间,生成query向量。query向量用于与key向量计算注意力分数,从而确定源节点对目标节点各特征的关注程度。
22、本文所用的术语“key向量生成模块”,指:在注意力交叉消息传递模块中,负责生成key(键)向量的子模块。该模块将目标节点(被查询的一方)的嵌入向量通过线性变换投影到键空间,生成key向量。key向量与query向量共同计算注意力分数,决定源节点应如何从目标节点聚合信息。
23、本文所用的术语“value向量生成模块”,指:在注意力交叉消息传递模块中,负责生成value(值)向量的子模块。该模块将目标节点的嵌入向量通过线性变换投影到值空间,生成value向量。value向量携带目标节点的实际特征信息,在计算出注意力权重后,通过加权求和的方式聚合value向量,得到更新后的节点表示。
24、本文所用的术语“注意力归一化模块”,指:在注意力交叉消息传递模块中,负责对计算得到的注意力分数进行归一化处理的子模块。该模块通常使用softmax函数将原始的注意力分数(query与key的点积或相似度)转换为归一化的注意力权重,使所有目标节点的注意力权重之和为1。注意力归一化模块确保模型能够以概率分布的形式聚焦于最重要的特征信息。
25、本文所用的术语“突变置信度”,指:在蛋白质序列设计或突变效应预测中,模型对某一位置氨基酸突变预测结果的可信程度。在基于深度学习的蛋白质设计中,模型通常输出每个位置各氨基酸类型的概率分布,突变置信度反映了模型对该位置预测结果的确信程度,通常与预测概率值正相关。高置信度的突变位点意味着模型对其预测有较高的把握,可作为实验验证的优先候选。
26、本文所用的术语“负对数概率适应性指标”,指:在蛋白质序列设计与突变评估中,用于衡量模型预测的氨基酸序列与目标结构之间适应程度的指标。该指标通过计算模型为给定序列分配的对数概率的负值来量化——负对数概率值越低,表明模型认为该序列与目标结构的适配性越高。在蛋白质设计任务中,该指标常用于筛选和排序候选突变体。
27、本文所用的术语“突变概率分数”,指:在蛋白质序列设计或突变效应预测中,模型为某一位置指定特定氨基酸类型所赋予的概率值。该分数通常由模型的输出层(如softmax层)产生,表示在给定蛋白质结构和环境条件下,该位置出现某种氨基酸的可能性。突变概率分数越高,表示该突变在结构相容性和功能适应性方面越被模型所偏好,可作为突变筛选和序列设计的重要依据。
28、第一方面,本发明提供了:一种基于异构图神经网络的蛋白质-配体结合口袋序列的设计方法,包括如下步骤:
29、(1)读取信息并解析;
30、(2)构建蛋白质-配体异构图;
31、(3)计算蛋白质残基之间的结构几何特征和非共价相互作用特征;
32、(4)计算蛋白质残基与配体原子之间的非共价相互作用特征;
33、(5)对待设计残基进行掩码处理;
34、(6)构建异构图神经网络并进行消息传递;
35、(7)输出待设计残基对应20种天然氨基酸的预测概率,并根据所述预测概率确定目标氨基酸类型;
36、(8)进行迭代式序列设计后输出模型。
37、优选的,步骤(1)所述的读取信息包括蛋白质受体结构文件和配体小分子结构文件,所述的蛋白质受体结构文件为pdb格式文件,所述配体小分子结构文件为mol2格式文件。
38、优选的,步骤(1)所述的解析的内容为蛋白质残基编号、链编号、原子坐标、配体原子类型、原子电荷、原子成键信息、芳香环信息以及氢键供体和氢键受体信息。
39、优选的,步骤(2)所述的蛋白质-配体异构图为蛋白质残基节点、配体原子节点和边结构。
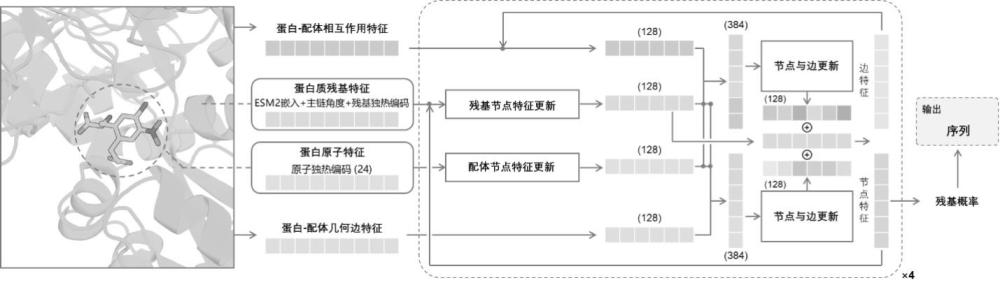
40、优选的,所述的蛋白质残基节点特征为蛋白质语言模型生成的残基嵌入特征、残基主链二面角特征以及氨基酸类型独热编码特征。
41、优选的,所述的蛋白质语言模型为esm2蛋白质语言模型。
42、优选的,所述的残基嵌入特征的维度为640维。
43、优选地,所述的配体原子节点的特征为配体原子sybyl类型的独热编码特征。
44、优选地,所述的边结构为蛋白质残基-残基肽键边、蛋白质残基-残基几何边、蛋白质残基-残基相互作用边、蛋白质残基-配体原子几何边、蛋白质残基-配体原子相互作用边和配体原子-配体原子化学键边。
45、优选地,所述的几何边的特征采用径向基函数展开距离矩阵并结合局部方向投影特征进行编码。
46、优选地,所述的相互作用边的特征采用非共价相互作用接触计数方式编码。
47、优选地,所述的蛋白质残基-残基肽键边是用于表征蛋白质主链拓扑连接关系;
48、所述的蛋白质残基-残基几何边是用于表征残基之间的空间几何关系;
49、所述的蛋白质残基-残基相互作用边是用于表征残基之间的非共价相互作用关系;
50、所述的蛋白质残基-配体原子几何边是用于表征残基与配体原子之间的空间几何关系;
51、所述的蛋白质残基-配体原子相互作用边是用于表征残基与配体原子之间的非共价相互作用关系;
52、所述的配体原子-配体原子化学键边是用于表征配体内部共价键连接关系。
53、优选地,步骤(3)所述的几何特征为原子间距离矩阵经径向基函数展开后的特征、局部坐标系方向投影特征以及归一化距离标量特征。
54、优选地,步骤(3)所述的几何特征包括:蛋白质残基-残基的几何边特征和蛋白质残基-配体原子的几何边特征。
55、优选地,步骤(4)所述的蛋白质残基之间以及蛋白质残基与配体原子之间的非共价相互作用包括:
56、疏水作用、氢键、弱氢键、π-π堆积、盐桥、酰胺-π堆积、阳离子-π作用、卤键、二硫键和卤素多极作用中的一种或者多种。
57、优选地,所述的相互作用采用接触计数方式编码,并编码为边特征向量。
58、优选地,步骤(5)所述的待设计残基的位点采用标记替换原始氨基酸类型,以避免目标残基信息泄露。
59、优选地,步骤(5)所述的待设计残基的相关的相互作用的边特征均置零处理。
60、优选地,步骤(6)所述的异构图神经网络为残基内部消息传递模块、配体内部消息传递模块以及蛋白质-配体跨节点类型消息传递模块。
61、优选地,所述的残基内部消息传递模块分别沿肽键边、残基几何边以及残基相互作用边聚合邻域节点信息。
62、优选地,所述的蛋白质-配体跨节点类型消息传递模块通过残基-配体几何边和残基-配体相互作用边实现蛋白质残基节点与配体原子节点之间的信息交互。
63、优选地,所述肽键边的消息聚合采用图注意力卷积网络gatconv实现。
64、优选地,所述的残基几何边、残基相互作用边、残基-配体几何边以及残基-配体相互作用边采用注意力交叉消息传递模块实现。
65、优选地,所述的注意力交叉消息传递模块为query向量生成模块、key向量生成模块、value向量生成模块以及注意力归一化模块。
66、优选地,所述的value向量由源节点特征、目标节点特征及边特征拼接生成。
67、优选地,步骤(6)所述的消息传递具体为:在每轮消息传递结束后,根据更新后的节点特征同步更新边特征。
68、优选地,步骤(6)所述的异构图神经网络包括4轮消息传递过程。
69、优选地,步骤(7)所述的预测概率通过全连接神经网络输出层获得。
70、优选地,所述的全连接神经网络输出层为layernorm层、relu激活层、dropout层和全连接层。
71、优选地,步骤(8)所述的迭代式序列设计方法为:
72、(8-1)根据预测概率计算待设计残基的预测置信度、排序后锁定残基a;
73、(8-2)将锁定残基对应的预测氨基酸写回蛋白质序列重新计算蛋白质语言模型嵌入特征,重新构建异构图;
74、(8-3)继续对剩余未锁定残基进行预测;
75、(8-4)重复步骤(8-1)至步骤(8-2)直至所有待设计残基完成预测。
76、优选地,步骤(8-1)所述的预测置信度采用softmax概率值计算得到。
77、优选地,步骤(8-1)所述的锁定方法为,若共迭代预测m次,则每次迭代时按照当前轮次的置信度进行排名,依次锁定前1/m、2/m到(m-1)/m数量的残基,到最后一轮把剩余的1/m未知残基预测完成,所述的m≥1。
78、优选地,步骤(8)所述的迭代式序列设计方法还包括蛋白质序列恢复率、预测置信度以及fitness评分的计算步骤。
79、本发明通过异构图结构统一建模蛋白质残基与配体原子的空间关系、化学关系以及序列进化关系,并利用多类型边上的注意力消息传递机制,实现对蛋白质结合口袋局部微环境的精细建模,从而提高蛋白质序列设计精度。
80、第二方面,本发明提供了:一种基于异构图神经网络的蛋白质突变评估方法,包括如下步骤:
81、s1、读取信息并解析;
82、s2、构建突变体蛋白质序列、生成突变体嵌入特征;
83、s3、采用与权利要求1所述设计方法中步骤(2)相同的异构图构建方式构建蛋白质-配体异构图;
84、s4、采用与权利要求1所述设计方法中步骤(6)相同的异构图神经网络构建方法并进行消息传递;
85、s5、采用与权利要求1所述设计方法中步骤(7)相同的输出预测概率的方法并评价突变合理性;
86、s6、输出突变打分结果。
87、优选地,所述的蛋白质突变评估方法采用单次前向传播方式完成突变打分,,无需进行迭代式序列优化。
88、优选地,步骤s1所述的读取信息包括蛋白质受体结构文件、配体小分子结构文件和待评估突变信息。
89、优选地,所述的待评估突变信息包括链编号、原始氨基酸类型、残基编号和目标突变氨基酸类型。
90、优选地,步骤s2所述的构建突变体蛋白质序列的方法为:根据输入的突变信息,将蛋白质序列中对应位置的原始氨基酸直接替换为目标突变氨基酸。
91、优选地,步骤s5所述的评价突变合理性的指标为突变置信度、负对数概率适应性指标和目标突变氨基酸概率值。
92、优选地,所述的突变置信度通过目标突变氨基酸对应预测概率计算得到。
93、优选地,所述的目标突变氨基酸的预测概率越高,表明模型认为该突变越合理。
94、第三方面,本发明提供了:上述的设计方法或上述的蛋白质突变评估方法在蛋白质工程中的应用。
95、优选的,所述的应用包括:蛋白质结合口袋优化、酶活性优化、蛋白质稳定性优化、蛋白质-小分子结合界面优化和药物设计中的一种或多种。
96、第四方面,本发明提供了:一种基于异构图神经网络的蛋白质-配体结合口袋序列设计的系统,包括:
97、结构解析模块,用于读取蛋白质结构文件和配体结构文件并解析结构信息;
98、口袋筛选模块,用于筛选结合口袋范围内的蛋白质残基;
99、异构图构建模块,用于构建蛋白质-配体异构图;
100、序列嵌入模块,用于利用蛋白质语言模型生成残基嵌入特征;
101、相互作用计算模块,用于计算蛋白质残基之间以及蛋白质残基与配体原子之间的相互作用特征;
102、异构图神经网络模块,用于进行多轮消息传递和节点特征更新;
103、预测模块,用于输出待设计残基的氨基酸预测结果;
104、迭代设计模块,用于基于预测置信度进行迭代式序列优化。
105、优选地,所述异构图神经网络模块包括:残基内部消息传递单元、配体内部消息传递单元以及跨节点类型消息传递单元。
106、优选地,所述的跨节点类型消息传递单元通过残基-配体几何边和残基-配体相互作用边实现配体原子节点与蛋白质残基节点之间的信息交互。
107、第五方面,本发明提供了:一种计算机可读存储介质,所述存储介质上存储有计算机程序,其中,所述计算机程序被处理器执行时实现上述的设计方法或上述的蛋白质突变评估方法的步骤。
108、第六方面,本发明提供了:一种计算机设备,包括存储器和处理器,在所述存储器中存储有能够在处理器上运行的计算机程序,所述处理器执行所述计算机程序时实现上述的设计方法或上述的蛋白质突变评估方法的步骤。
109、基于对本发明的技术问题的进一步解决或同时解决多个技术问题,在本发明第一方面所提供的技术方案中,优选方案包括:
110、第一项优先方案:一种基于异构图神经网络的蛋白质-配体结合口袋序列的设计方法。该技术方案在解决了技术问题“现有的模型主要依赖主链信息,难以精确描述直接参与催化的侧链所处的物理化学微环境”的基础上,进一步解决了技术问题“预测概率、集合强度和催化活性低”。
111、本发明的有益效果为:
112、基于输入的蛋白质结构经过多轮迭代输出后可以实现相比现有逆折叠模型更高的序列恢复率。支持对结构-序列的零样本打分功能,零样本打分结果跟蛋白质的适应性功能具有高相关性,可有效评估突变带来的功能变化。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com