
一种高通量纯培养与16SrRNA扩增子测序相结合的细菌分析方法
本发明属于微生物分析,具体涉及一种高通量纯培养与16s rrna扩增子测序相结合的细菌分析方法。
背景技术:
1、微生物高通量纯培养结合16s rrna测序技术比对手段,是现阶段环境微生物资源解析、菌株溯源追踪、微生物群落结构分析的核心技术体系。通过将高通量分离获得的纯培养菌株16s rrna基因全长序列与微生物样本的扩增子序列进行比对匹配,可精准明确环境中可培养功能菌株的分布规律与定植特征,为功能菌株开发利用、生态环境修复、微生物菌种资源保藏等工作提供关键的数据支撑与理论依据。
2、但是目前16s rrna扩增子测序和纯培养细菌菌株鉴定两种技术体系长期相互割裂,尚未形成有效的交叉验证机制与整合分析手段,存在明显的技术断层。一方面,16srrna扩增子测序技术存在固有缺陷。该技术受扩增引物特异性限制,部分微生物的基因序列无法与常规引物有效匹配,导致此类微生物在群落结构分析中被遗漏,无法被检测识别;同时,扩增所得基因片段长度较短,物种种系区分精度不足,难以实现菌株水平的精细化分类鉴定,无法满足高精度微生物研究需求。另一方面,微生物纯培养菌株的16s rrna序列鉴定技术存在明显短板。当前主流鉴定方式为单菌落pcr扩增后,与ncbi等公共数据库开展局部序列比对,该技术通量低、检测效率低,且无法与环境样本扩增子测序数据建立系统性、标准化的对应关联关系。两种主流技术各自独立应用、缺乏联动,致使大量扩增子测序挖掘得到的微生物类群信息,无法与实验室可培养菌株建立精准对应关系,不仅造成海量测序数据资源的闲置与浪费,还极大限制了功能微生物的精准挖掘、筛选及产业化开发利用,制约了环境微生物资源的高效转化与应用。
3、因此,行业内亟需一种可实现纯培养菌株序列与16s rrna扩增子数据系统化、精准化匹配分析的技术方案,打通环境微生物“高通量检测识别”与“实体菌株获取利用”之间的技术壁垒。
4、现有传统的序列匹配分析技术体系存在多项固有技术缺陷,从测序基础、比对算法、数据库适配、判定机制到结果输出均存在短板,大幅降低了序列匹配精度与分析结果的可靠性、全面性,具体缺陷如下:
5、第一,短片段测序菌株分辨率不足。传统方法多采用v3-v4可变区短扩增子测序,序列信息有限,难以区分近缘菌种及同种微生物不同菌株;且短扩增子区间与27f/1492r扩增的全长16s rrna区间不一致,易产生序列比对偏差,鉴定准确率偏低。第二,传统blast比对模式存在固有缺陷。通用全局blast比对未区分16s rrna保守区与高变区,统一的比对规则易造成虚假匹配,难以识别菌株间细微序列差异,菌株水平鉴定精度不足。第三,公共数据库适配效果不佳。现有分析多直接依托ncbi通用数据库,缺少自建纯培养菌株全长序列参考库;公共数据库序列来源复杂、标准不统一,降低序列匹配特异性。第四,序列判定方式僵化,缺少污染质控手段。传统方案依靠固定97%相似度阈值进行判定,无法量化匹配置信度,质控体系缺失。第五,分析结果输出形式单一。仅提供简单定性匹配结论,缺少结果分级与权重评价体系,难以支撑精细化微生物研究及产业化应用。
6、综上所述,现有技术在测序体系设计、比对算法逻辑、数据质控校正、结果判定体系等多个核心维度均存在明显技术短板,无法实现纯培养菌株序列与扩增子数据的精准匹配分析。基于此,行业内亟需一种依托扩增子数据标准序列、搭载改进型精准比对算法、可实现结果量化分级的低成本、高效率创新型序列匹配分析方法。
技术实现思路
1、本发明的目的在于提供一种高通量纯培养与16s rrna扩增子测序相结合的细菌分析方法,本发明所述方法通过算法改良解决传统blast全局比对易出现局部错配、高变区特征丢失、同源序列误匹配的问题,大幅提升全长16s rrna菌株匹配精度与菌株水平分辨率,普适性强、落地性高。
2、本发明提供了一种高通量纯培养与16s rrna扩增子测序相结合的细菌分析方法,包括如下步骤:
3、(1)对待测样本进行随机分组,得到第一组待测样本和第二组待测样本;
4、(2)对第一组待测样本中的细菌进行高通量纯培养,获得若干可培养纯菌株,对所述若干可培养纯菌株的全长16s rrna进行扩增,获得若干16s rrna全长序列;
5、(3)对第二组待测样本中的细菌进行扩增子测序,测序结果按97%序列相似度聚类,获得扩增子细菌操作分类单元(operational taxonomic unit,otu),基于所述扩增子细菌操作分类单元建立标准扩增子库;
6、(4)将所述若干16s rrna全长序列与所述细菌操作分类单元进行分区比对筛选,获得高可信度全长序列;
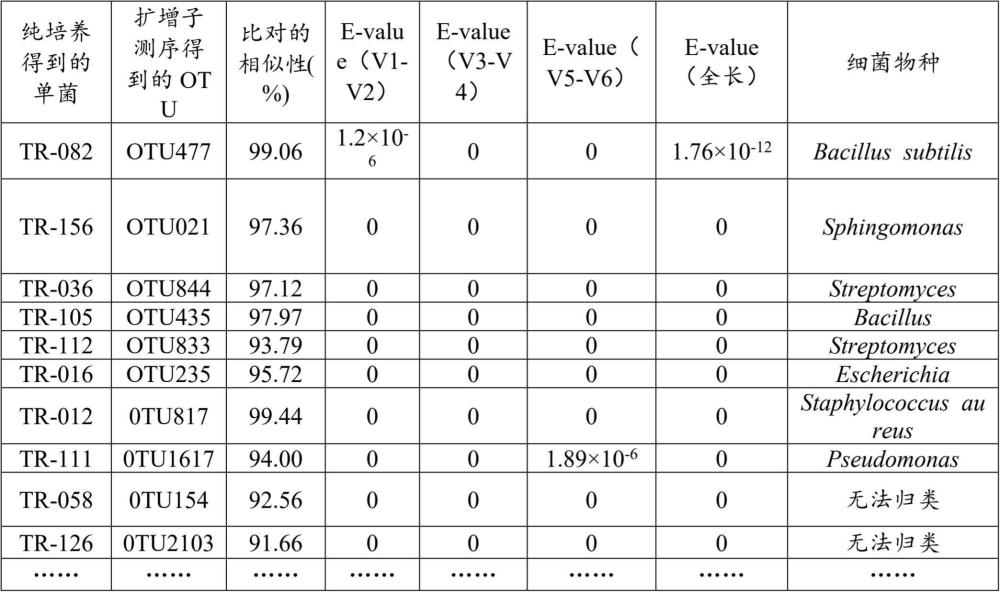
7、所述分区比对筛选的方式包括:对核心高变区进行比对初筛,设置高变区e-value≤1×10⁻⁵;再利用保守区进行全局验证,设置全长整合e-value≤1×10⁻¹⁰,过滤局部同源、整体失真的虚假匹配结果;
8、所述核心高变区包括v1-v2、v3-v4和v5-v6区;所述保守区为c3区;
9、(5)将所述高可信度全长序列与所述细菌操作分类单元进行分区比对,得到高变区平均相似度和保守区相似度,按照式i计算综合相似度;
10、综合相似度=高变区平均相似度×0.8+保守区相似度×0.2 式i;
11、所述高变区平均相似度为v1-v2、v3-v4和v5-v6区相似度的平均值;
12、当所述综合相似度≥99%时,所述16s rrna全长序列对应的细菌与细菌操作分类单元对应的菌株同种;
13、当97.0%≤所述综合相似度<99.0%时,所述16s rrna全长序列对应的细菌与细菌操作分类单元对应的菌株同属;
14、当93.0%≤所述综合相似度<97.0%时,所述16s rrna全长序列对应的细菌与细菌操作分类单元对应的菌株为近缘菌属;
15、当所述综合相似度<93%时,所述16s rrna全长序列对应的细菌为未知菌株或外源杂菌。
16、作为一种优选方案,步骤(2)所述高通量纯培养的方法包括梯度稀释法。
17、作为一种优选方案,步骤(2)所述待测样本包括土壤样本,所述土壤样本的高通量纯培养方法包括以下步骤:
18、将土壤样本制备成土壤菌悬液,对所述土壤菌悬液进行梯度稀释,选取最佳稀释度菌悬液作为接种原液;所述最佳稀释度菌悬液的标准为:接种培养后阳性孔以单一菌株生长为主;
19、将所述接种原液与lb液体培养基混合后进行培养,经筛选、纯化后获得土壤可培养纯菌株。
20、作为一种优选方案,步骤(2)所述扩增的引物包括27f和1492r;所述27f的核苷酸序列如seq id no:1所示;所述1492r的核苷酸序列如seq id no:2所示。
21、作为一种优选方案,步骤(2)还包括基于所述获得16s rrna全长序列建立全长待测子库。
22、作为一种优选方案,步骤(2)所述建立全长待测子库前,还包括对全长16s rrna扩增序列进行质控筛选的过程;
23、所述质控筛选的过程包括:去除嵌合体、低质量碱基占比>5%、片段残缺及结构异常序列;修剪两端冗余碱基,保留完整v1-v9全长序列,剔除基因型完全一致的重复菌株,获得16s rrna全长序列。
24、作为一种优选方案,步骤(2)所述16s rrna全长序列包括v1-v9区。
25、作为一种优选方案,步骤(3)所述扩增子测序使用的引物包括27f和1492r;所述27f的核苷酸序列如seq id no:1所示;所述1492r的核苷酸序列如seq id no:2所示。
26、作为一种优选方案,步骤(3)进行所述相似度聚类前,还包括降噪和去除外源污染的过程。
27、作为一种优选方案,步骤(3)所述建立标准扩增子库前,还包括对所述扩增子细菌操作分类单元进行物种注释的过程。
28、有益效果:本发明提供了一种高通量纯培养与16s rrna扩增子测序相结合的细菌分析方法,包括如下步骤:(1)对待测样本进行随机分组,得到第一组待测样本和第二组待测样本;(2)对第一组待测样本中的细菌进行高通量纯培养,获得若干可培养纯菌株,对所述若干可培养纯菌株的全长16s rrna进行扩增,获得若干16s rrna全长序列;(3)对第二组待测样本中的细菌进行扩增子测序,测序结果按97%序列相似度聚类,获得扩增子细菌操作分类单元,基于所述扩增子细菌操作分类单元建立标准扩增子库;(4)将所述若干16s rrna全长序列与所述细菌操作分类单元进行分区比对筛选,获得高可信度全长序列;所述分区比对筛选的方式包括:对核心高变区进行比对初筛,设置高变区e-value≤1×10⁻⁵;再利用保守区进行全局验证,设置全长整合e-value≤1×10⁻¹⁰,过滤局部同源、整体失真的虚假匹配结果;所述核心高变区包括v1-v2、v3-v4和v5-v6区;所述保守区为c3区;(5)将所述高可信度全长序列与所述细菌操作分类单元进行分区比对,得到高变区平均相似度和保守区相似度,按照式i计算综合相似度;所述高变区平均相似度为v1-v2、v3-v4和v5-v6区相似度的平均值;当所述综合相似度≥99%时,所述16s rrna全长序列对应的细菌与细菌操作分类单元对应的菌株同种;当97.0%≤所述综合相似度<99.0%时,所述16s rrna全长序列对应的细菌与细菌操作分类单元对应的菌株同属;当93.0%≤所述综合相似度<97.0%时,所述16srrna全长序列对应的细菌与细菌操作分类单元对应的菌株为近缘菌属;当所述综合相似度<93%时,所述16s rrna全长序列对应的细菌为未知菌株或外源杂菌。本发明采用全长16srrna基因体系构建纯培养细菌菌株全长待测子库和16s rrna标准扩增子库,创新性提出一种分段优先、容错过滤、分区校验的改进型比对方法,结合全长序列分区加权打分模型、四级匹配置信度分级判定体系,实现环境扩增子序列与纯培养菌株全长序列的高精度、抗干扰、可量化匹配分析。本发明在不增加实验成本的前提下,通过算法改良解决传统blast全局比对易出现局部错配、高变区特征丢失、同源序列误匹配的问题,大幅提升全长16srrna的菌株匹配精度与菌株水平分辨率,普适性强、落地性高,适用于各类环境微生物菌株溯源、资源挖掘与菌种鉴定场景。
29、与现有技术相比本发明还具有以下有益效果:
30、1、引物与序列体系创新:采用27f/1492r全长标准序列,覆盖全部v1-v9区,彻底解决短片段信息残缺、比对错位问题,菌株分辨率显著提升。
31、2、比对算法核心创新:突破传统标准blast全局均质比对模式,首创高变区优先、分区比对、分层容错、局部假匹配过滤的改进型blast机制,解决保守区掩盖特异性差异、近缘菌株错配的核心技术难题,具备极强创造性。
32、3、质控体系创新:增设双重阴性对照背景扣除,从源头消除实验污染导致的假阳性,匹配结果更可靠。
33、4、判定体系创新:采用全长分区加权打分+四级量化分级,摒弃固定阈值一刀切,实现匹配结果精细化、可量化、可溯源。
34、5、成本优势突出:全部创新均为生物信息流程与算法改良,无需新增实验设备、耗材与检测步骤,零额外成本,普适性极强。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com