
一种增加蛋白可溶性表达的多肽的制作方法
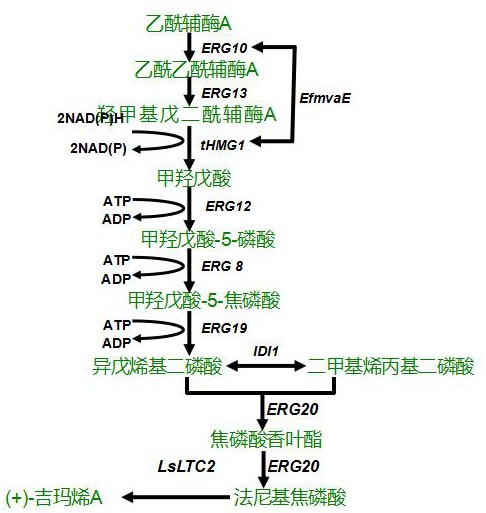
本发明属于生物工程领域,涉及一种增加蛋白可溶性表达的多肽,及其用于提升菌株产量的方法。
背景技术:
1、蛋白质是生命活动的重要组成部分,广泛应用于医药、生物技术、工业等领域。然而,蛋白质的表达和生产面临着诸多挑战。在基因工程中,将目的基因导入宿主细胞(如细菌、酵母、昆虫细胞或哺乳动物细胞)进行表达是常用的方法。然而,由于蛋白质本身的复杂性、翻译后修饰需求以及细胞内的环境因素等,导致蛋白质表达效率低、产量低、可溶性差等问题,严重限制了蛋白质的规模化生产和应用。在生产具有实用量的功能性外源(重组)蛋白的过程中,尤其是在不同重组宿主细胞中表达时,蛋白质的适当折叠的问题特别受到关注。该问题可出现在真核和原核宿主细胞中。在宿主细胞中,外源蛋白在表达过程中的错误折叠经常会导致其在细胞内形成无活性且有毒性的聚集体。这样的聚集体被称作“包涵体”,这会导致蛋白质失去活性,难以进行纯化和进一步应用。包涵体的形成通常是由于蛋白质折叠错误、疏水性表面暴露以及细胞内环境因素(如氧化还原状态、伴侣蛋白缺乏等)所致。因此,提高蛋白质的可溶性表达是解决蛋白质生产问题的关键。
2、目前,研究人员已经开发了多种提高蛋白质表达与可溶性的策略,包括:选择合适的宿主细胞(例如,大肠杆菌是常用的宿主细胞,但其表达的蛋白质往往容易形成包涵体;酵母、昆虫细胞和哺乳动物细胞等真核表达系统,由于具有更完善的翻译后修饰机制,更适合复杂蛋白质的表达);优化目的基因的密码子使用,以匹配宿主细胞的trna丰度,从而提高翻译效率;以及通过定点突变或基因工程手段,改变目的蛋白的氨基酸序列,提高其可溶性等。
3、已有研究报道,短肽融合策略能够在一定程度上减少目标蛋白的聚集,提高溶解性,并避免全长融合蛋白因结构复杂而导致的折叠干扰和降解(dominic e,deb k c;current opinion in biotechnology 2006, 17:353–358)。此外,由于短肽分子量小,结构相对简单,,其对于宿主细胞(如大肠杆菌、酵母)的代谢负担通常较低并且对宿主细胞生长干扰更小,从而有利于蛋白表达过程的稳定性,更易实现高密度发酵并且促进产量提升(生物化学原理(第3版),2018)。
4、因此,本技术针对现有技术中蛋白质可溶性表达的难题,提供了一种新的多肽,所述多肽分子量小、片段小,能够显著提高蛋白质的表达量和可溶性,更易实现高效异源表达。同时,该多肽融合策略可减少后续蛋白处理步骤,如省去酶切步骤,从而有助于简化纯化流程,降低生产成本,并且提高工业化生产的可行性。
技术实现思路
1、本技术提供了多肽,所述多肽的氨基酸序列具有6-97个氨基酸,所述多肽的氨基酸序列对应于氨基酸序列seq id no:1中自第256位氨基酸残基至第352位氨基酸残基中任选的连续6-97个氨基酸组成的氨基酸序列。在优选的实施方式中,所述多肽的氨基酸序列具有6-29个氨基酸,所述多肽的氨基酸序列对应于氨基酸序列seq id no:1中自第276位氨基酸残基至第304位氨基酸残基中任选的连续6-29个氨基酸组成的氨基酸序列。在优选的实施方式中,所述多肽的氨基酸序列具有11-29个氨基酸,所述多肽的氨基酸序列对应于氨基酸序列seq id no:1中自第276位氨基酸残基至第304位氨基酸残基中任选的连续11-29个氨基酸组成的氨基酸序列。在优选的实施方式中,所述多肽的氨基酸序列具有14-29个氨基酸,所述多肽的氨基酸序列对应于氨基酸序列seq id no:1中自第276位氨基酸残基至第304位氨基酸残基中任选的连续14-29个氨基酸组成的氨基酸序列。在优选的实施方式中,所述多肽的氨基酸序列具有14个氨基酸,所述多肽的氨基酸序列对应于氨基酸序列seq idno:1中自第276位氨基酸残基至第304位氨基酸残基中任选的连续14个氨基酸组成的氨基酸序列。
2、在一些实施方式中,所述多肽的氨基酸序列具有6-97个氨基酸,所述多肽的氨基酸序列包含或选自于以下中的任一种:由氨基酸序列seq id no:1中自第276位氨基酸残基开始至少连续12个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第282位氨基酸残基开始至少连续8个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第285位氨基酸残基开始至少连续8个氨基酸残基组成的氨基酸序列、由氨基酸序列seqid no:1中自第288位氨基酸残基开始至少连续17个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第290位氨基酸残基开始至少连续6个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第282位氨基酸残基开始至少连续14个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第276位氨基酸残基开始至少连续29个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第256位氨基酸残基开始至少连续49个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第256位氨基酸残基开始至少连续20个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第264位氨基酸残基开始至少连续25个氨基酸残基组成的氨基酸序列、或者由氨基酸序列seq idno:1中自第256位氨基酸残基开始至少连续97个氨基酸残基组成的氨基酸序列。
3、在某些实施方式中,所述多肽的氨基酸序列具有6-29个氨基酸。在某些实施方式中,所述多肽的氨基酸序列包含或选自于以下中的任一种:由氨基酸序列seq id no:1中自第276位氨基酸残基开始至少连续12个氨基酸残基组成的氨基酸序列、由氨基酸序列seqid no:1中自第282位氨基酸残基开始至少连续8个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第285位氨基酸残基开始至少连续8个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第288位氨基酸残基开始至少连续17个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第290位氨基酸残基开始至少连续6个氨基酸残基组成的氨基酸序列、由氨基酸序列seq id no:1中自第282位氨基酸残基开始至少连续14个氨基酸残基组成的氨基酸序列、或者由氨基酸序列seq id no:1中自第276位氨基酸残基开始至少连续29个氨基酸残基组成的氨基酸序列。
4、在优选的实施方式中,所述多肽包含选自如下所组成的组的多肽片段:如seq idno:1所示的氨基酸序列的第290位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第285位至第292位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第289位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第287位氨基酸、如seq id no:1所示的氨基酸序列的第288位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第256位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第256位至第275位氨基酸、如seq id no:1所示的氨基酸序列的第256位至第352位氨基酸、如seqid no:1所示的氨基酸序列的第264位至第288位氨基酸,以及与所述多肽片段中任一者具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%、81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%或100%)的序列同一性的多肽片段。
5、在优选的实施方式中,所述多肽包含选自如下所组成的组的多肽片段:如seq idno:1所示的氨基酸序列的第290位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第285位至第292位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第289位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第287位氨基酸、如seq id no:1所示的氨基酸序列的第288位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第304位氨基酸,以及与所述多肽片段中任一者具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%、81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%或100%)的序列同一性的多肽片段。
6、在优选的实施方式中,所述多肽包含选自如下所组成的组的多肽片段:如seq idno:1所示的氨基酸序列的第282位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第288位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第276位至第287位氨基酸,以及与所述多肽片段中任一者具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%、81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%或100%)的序列同一性的多肽片段。
7、在某些实施方式中,所述多肽包含选自如下所组成的组的多肽片段:如seq idno:1所示的氨基酸序列的第256位至第304位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第289位氨基酸、如seq id no:1所示的氨基酸序列的第290位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第285位至第292位氨基酸,以及与所述多肽片段中任一者具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%、81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%或100%)的序列同一性的多肽片段。
8、在优选的实施方式中,所述多肽包含选自如下所组成的组的多肽片段:如seq idno:1所示的氨基酸序列的第282位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第282位至第289位氨基酸、如seq id no:1所示的氨基酸序列的第290位至第295位氨基酸、如seq id no:1所示的氨基酸序列的第285位至第292位氨基酸,以及与所述多肽片段中任一者具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%、81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%或100%)的序列同一性的多肽片段。
9、在某些实施方式中,所述多肽的氨基酸序列选自于seq id no:2-seq id no:8、seq id no:56、seq id no:58、seq id no:62、seq id no:64。在某些实施方式中,所述多肽的氨基酸序列选自于seq id no:2-seq id no:8、seq id no:56、seq id no:58。在某些实施方式中,所述多肽的氨基酸序列选自于seq id no:2-seq id no:8。在某些实施方式中,所述多肽的氨基酸序列选自于seq id no:58、seq id no:2-seq id no:5。在某些实施方式中,所述多肽的氨基酸序列选自于seq id no:5-seq id no:8。
10、seq id no:1 erg20氨基酸序列:
11、masekeirrerflnvfpklveelnasllaygmpkeacdwyahslnyntpggklnrglsvvdtyailsnktveqlgqeeyekvailgwciellqayflvaddmmdksitrrgqpcwykvpevgeiaindafmleaaiykllkshfrnekyyiditelfhevtfqtelgqlmdlitapedkvdlskfslkkhsfivtfktayysfylpvalamyvagitdekdlkqardvliplgeyfqiqddyldcfgtpeqigkigtdiqdnkcswvinkalelasaeqrktldenygkkdsvaeakckkifndlkieqlyheyeesiakdlkakisqvdesrgfkadvltaflnkvykrsk
12、作为示例,所述多肽的氨基酸序列可为以下中的任一种:
13、seq id no:2 erg20(290-295aa)氨基酸序列
14、kdsvae
15、seq id no:3 erg20(285-292aa)氨基酸序列
16、enygkkds
17、seq id no:4 erg20(282-289aa)氨基酸序列
18、tldenygk
19、seq id no:5 erg20(282-295aa)氨基酸序列
20、tldenygkkdsvae
21、seq id no:6 erg20(276-287aa)氨基酸序列
22、saeqrktldeny
23、seq id no:7 erg20(288-304aa)氨基酸序列
24、gkkdsvaeakckkifnd
25、seq id no:8 erg20(276-304aa)氨基酸序列
26、saeqrktldenygkkdsvaeakckkifnd
27、seq id no:56 erg20(256-352aa)氨基酸序列
28、gtdiqdnkcswvinkalelasaeqrktldenygkkdsvaeakckkifndlkieqlyheyeesiakdlkakisqvdesrgfkadvltaflnkvykrsk
29、seq id no:58 erg20(256-304aa)氨基酸序列
30、gtdiqdnkcswvinkalelasaeqrktldenygkkdsvaeakckkifnd
31、seq id no:62 erg20(256-275aa)氨基酸序列
32、gtdiqdnkcswvinkalela
33、seq id no:64 erg20(264-288aa)氨基酸序列
34、cswvinkalelasaeqrktldenyg
35、在本发明中,所述多肽可来自于任何宿主来源。在某些实施方式中,所述多肽来源于酵母(优选酿酒酵母)、发酵壳孢菌(zymoseptoria tritici)、白色念珠菌(candidaalbicans)、九苜蓿轮枝菌(verticillium nonalfalfae)等多种宿主。在某些实施方式中,所述多肽来源于酵母,优选酿酒酵母。
36、在本发明中,所述多肽优选为增加蛋白可溶性表达的多肽。例如,所述增加蛋白可溶性表达的多肽当作为(i)目标靶蛋白的融合配偶体(例如所述增加蛋白可溶性表达的多肽与目标蛋白融合表达)或(ii)具有靶蛋白结合结构域的融合配偶体(即所述增加蛋白可溶性表达的多肽)与目标靶蛋白一起在宿主细胞中共表达(但非融合表达)时能够增强所述目标靶蛋白的可溶性表达;其中,所述靶蛋白结合结构域是能够结合所述目标靶蛋白的多肽。
37、本技术第二方面提供了增加蛋白可溶性表达的方法,所述方法包括将如前所述的多肽连接至所述目标靶蛋白。
38、同时,本技术第二方面还提供了增加蛋白可溶性表达的方法,所述方法包括将如前所述的多肽与目标靶蛋白共同表达。
39、在一些实施方式中,本技术提供了增加蛋白可溶性表达的方法,所述方法包括将如前所述的多肽与目标靶蛋白融合表达。
40、本发明第三方面提供了融合蛋白,其包含第一多肽和第二多肽,其中所述第一多肽包含如本文第一方面所述的多肽。
41、在一些实施方式中,所述第二多肽可为野生型蛋白或其功能性突变体。所述第二多肽的选择取决于预期的生物学效应,其既可以是宿主细胞天然表达体系中已有的蛋白,亦可以是通过重组表达系统引入的非天然蛋白。所述功能性突变体保留了野生型蛋白的核心生物学活性,同时可具有改善的稳定性、表达量或底物特异性。
42、在一些实施方式中,所述第二多肽为内源蛋白,即由宿主细胞基因组天然编码的蛋白。在另一些实施方式中,所述第二多肽为外源蛋白,即非宿主细胞天然所有的蛋白。例如,所述外源蛋白可来源于异源物种,或通过人工设计获得。
43、在一些实施方式中,所述宿主细胞可选自真核细胞或原核细胞。
44、在一些实施方式中,所述第二多肽可以为生物代谢与遗传工程核心功能蛋白或基因调控蛋白等。例如,所述生物代谢与遗传工程核心功能蛋白是指在宿主细胞或有机体的物质代谢、能量转换、遗传信息传递或基因工程操作中发挥关键催化、调控或结构支撑作用的蛋白质。在一些实施方式中,所述第二多肽可为宿主细胞或生物体本身所有的生物代谢与遗传工程核心功能蛋白或基因调控蛋白。此类蛋白由宿主细胞基因组天然编码,在宿主细胞的固有生理或代谢过程中发挥基础性功能。通过将编码此类内源蛋白的基因可操作地连接至强启动子、诱导型启动子或增强子元件,可实现其在宿主细胞中的过表达,从而上调宿主细胞固有的代谢通路活性、增强遗传稳定性或强化基因表达调控能力,以满足特定的工程化应用需求。
45、在另一些实施方式中,所述第二多肽可为外源引入的生物代谢与遗传工程核心功能蛋白或基因调控蛋白。此类蛋白非宿主细胞基因组天然编码,其编码基因通过重组表达载体、基因编辑工具介导的位点特异性整合或其他基因转移技术导入宿主细胞。通过表达所述外源蛋白,可在宿主细胞中重构或引入全新的代谢分支、补偿宿主细胞缺失的遗传工程功能、或建立异源的基因调控回路,从而赋予宿主细胞超越其天然生理范围的工程化特性。
46、在一些实施方式中,所述第二多肽可同时包含内源来源与外源来源的蛋白组合。例如,可通过过表达宿主细胞固有的内源生物代谢与遗传工程核心功能蛋白以增强基础代谢通量,同时引入外源基因调控蛋白以构建或控制特定代谢通路的关键节点,从而实现代谢网络与基因表达调控的协同优化,提高目标产物的合成效率、宿主细胞的遗传稳定性或工程化表型的可控性。
47、在一些实施方式中,所述生物代谢与遗传工程核心功能蛋白包括但不限于参与宿主细胞初级代谢、次级代谢、中心碳代谢或遗传物质合成与修饰的关键酶、合成酶、修饰酶、转运蛋白及结构蛋白。示例性地,在萜类化合物生物合成通路中,所述蛋白可包括萜类合酶(如吉玛烯a合成酶、橙花叔醇合成酶、柠檬烯合成酶、紫杉二烯合成酶)、前体供应酶(如牻牛儿基牻牛儿基焦磷酸合成酶、法尼基焦磷酸合成酶、羟甲基戊二酰辅酶a还原酶、甲羟戊酸途径或甲基赤藓糖醇磷酸途径中的关键酶)。
48、在一些实施方式中,所述基因调控蛋白包括但不限于直接参与基因转录、翻译、表观遗传修饰、基因组编辑或细胞内信号级联转导的调控因子。示例性地,所述基因调控蛋白可包括crispr相关蛋白(如cas9、cas12a、cas13a、碱基编辑器、先导编辑器及其核酸酶活性缺失的突变体)等。
49、在一些实施方式中,所述第二多肽可以为生物代谢与遗传工程核心功能蛋白或基因调控蛋白等,例如:吉玛烯a合成酶(gas)、萜烯合成酶(tps)、牻牛儿基牻牛儿基焦磷酸合成酶(ggpps)、crispr相关蛋白(cas蛋白,例如:cas9、cas12a等);优选地,所述第二多肽选自于吉玛烯a合成酶(gas)、牻牛儿基牻牛儿基焦磷酸合成酶、crispr相关蛋白中的一种或多种;优选地,所述第二多肽为吉玛烯a合成酶、橙花叔醇合成酶(nes)、cas9、牻牛儿基牻牛儿基焦磷酸合成酶(ggpps);更为优选地,所述第二多肽为吉玛烯a合成酶、橙花叔醇合成酶;最为优选地,所述第二多肽为吉玛烯a合成酶。在某些实施方式中,所述第二多肽为吉玛烯a合成酶(gas)。
50、在某些实施方式中,所述第二多肽为牻牛儿基牻牛儿基焦磷酸合成酶(ggpps)。在某些实施方式中,所述第二多肽为cas9。在某些实施例中,所述第二多肽为cas12a。在某些实施例中,所述第二多肽为nes1。
51、在进一步的实施方式中,本发明所述吉玛烯a合成酶(gas)是指能够将法尼基焦磷酸转化为吉马烯a的酶(hu y, zhou yj, bao j, huang l, nielsen j, krivoruchko a.metabolic engineering of saccharomyces cerevisiae for production ofgermacrene a, a precursor of beta-elemene. j ind microbiol biotechnol. 2017jul;44(7):1065-1072. doi: 10.1007/s10295-017-1934-z. epub 2017 may 25. pmid:28547322.),其基因可从已知含有吉玛烯a合成酶的植物或微生物中克隆得到,例如可从选自向日葵(helianthus annuus l.)、小白菊(tanacetum parthenium)、莴苣(lactucasativa linn.)、青蒿(artemisia carvifolia)、蓝细菌等物种中克隆得到。仅作为列举,在一些具体的实施方式中,吉玛烯合成酶为来源于小白菊的吉玛烯合成酶stpgmas;在另一些具体的实施方式中,吉玛烯合成酶为来源于细菌anabaena variabilis的吉玛烯a合成酶avgas;在另一些具体的实施方式中,吉玛烯合成酶为来源于真菌daldinia eschscholtzii的吉玛烯a合成酶degas;在另一些具体的实施方式中,吉玛烯合成酶为来源于真菌daldinia loculata的吉玛烯a合成酶dlgas;在另一些具体的实施方式中,吉玛烯合成酶为来源于真菌hypoxylon sp. ec38的吉玛烯a合成酶hsgas;在另一些具体的实施方式中,吉玛烯合成酶为来源于莴苣的吉玛烯合成酶lsltc2。在一些优选的实施方式中,吉玛烯合成酶为来源于莴苣的吉玛烯合成酶lsltc2。
52、在进一步的实施方式中,本发明所述牻牛儿基牻牛儿基焦磷酸基因可从已知含有牻牛儿基牻牛儿基焦磷酸合成酶的植物或微生物中克隆得到,例如可从选自伤口假埃希氏菌(pseudescherichia vulneris)、曼地亚红豆杉(taxus x media)、闪烁古生球菌(archaeoglobus fulgidus)、三孢布拉氏霉(blakeslea trispora)等物种中克隆得到。仅作为列举,在一些具体的实施方式中,牻牛儿基牻牛儿基焦磷酸合成酶来源于细菌pseudescherichia vulneris的牻牛儿基牻牛儿基焦磷酸合成酶pacrte。在另一些具体的实施方式中,牻牛儿基牻牛儿基焦磷酸合成酶为来源于古生菌archaeoglobus fulgidus的牻牛儿基牻牛儿基焦磷酸合成酶afcrte。在另一些具体的实施方式中,牻牛儿基牻牛儿基焦磷酸合成酶为来源于真菌blakeslea trispora的牻牛儿基牻牛儿基焦磷酸合成酶btcrte。在另一些具体的实施方式中,牻牛儿基牻牛儿基焦磷酸合成酶为来源于植物taxusx media的牻牛儿基牻牛儿基焦磷酸合成酶tmcrte。在一些优选的实施方式中,牻牛儿基牻牛儿基焦磷酸合成酶为来源于植物taxus x media的牻牛儿基牻牛儿基焦磷酸合成酶tmcrte。
53、在进一步的实施方式中,本发明所述萜烯合成酶(tps)包括吉玛烯a合成酶、橙花叔醇合酶、薄荷醇合成酶、柠檬烯合成酶等。
54、在进一步的实施方式中,本发明所述crispr相关蛋白(cas蛋白)是指crispr系统中具有rna引导内切核酸酶活性的蛋白,其基因可从已知含有crispr相关蛋白的微生物中克隆得到,例如可从选自化脓性链球菌(streptococcus pyogenes)、金黄色葡萄球菌(staphylococcus aureus)、毛螺科菌(lachnospiraceae bacterium)、发酵酸氨基球菌(acidaminococcus sp. bv3l6)和巨大噬菌体(biggiephage)等物种中克隆得到。仅作为列举,在一些具体的实施方式中,crispr相关蛋白为来源于streptococcus pyogenes的spcas9;在一些具体的实施方式中,crispr相关蛋白为来源于staphylococcus aureus的sacas9;在一些具体的实施方式中,crispr相关蛋白为来源于lachnospiraceae bacterium的lbcas12a;在一些具体的实施方式中,crispr相关蛋白为来源于acidaminococcus sp.的afcas12a;在一些具体的实施方式中,crispr相关蛋白为来源于biggiephage的casφ(cas12j)。
55、在进一步的实施方式中,本发明所述橙花叔醇合酶(nerolidol synthase,nes)是倍半萜合酶的一种,是指能够将法尼基焦磷酸转化为橙花叔醇的萜类合酶,其基因可从已知含有橙花叔醇合酶的植物或微生物中克隆得到,例如可从选自玫瑰(rosa chinensis)、草莓(fragaria ananassa)、雷公藤(tripterygium wilfordii)和猕猴桃(actinidiachinensis)等中克隆得到。在一些优选的实施方式中,橙花叔醇合酶为来源于猕猴桃(actinidia chinensis)的acnes1。
56、本发明所述的第二多肽也包括在从本文所述的宿主来源获得的酶(例如合成酶)基础上通过置换和/或缺失、或增加/减少一个或多个氨基酸而获得的氨基酸序列,只要其也具有原有的催化活性。例如,对于吉玛烯a合成酶来说,原有的催化活性指催化法尼基焦磷酸(farnesyl pyrophosphate,fpp)合成吉玛烯a。
57、在一些优选的实施方案中,所述吉玛烯a合成酶具有seq id no:16所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。
58、在一些优选的实施方式中,所述牻牛儿基牻牛儿基焦磷酸合成酶具有seq id no:18所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。
59、在一些优选的实施方式中,所述crispr相关蛋白具有如seq id no:50或者seq idno:52所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。
60、在一些优选的实施方式中,所述橙花叔醇合酶具有如seq id no:93所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。
61、在本发明的一些优选实施方式中,根据吉马烯a合成酶、牻牛儿基牻牛儿基焦磷酸合成酶、crispr相关蛋白和橙花叔醇合酶的氨基酸序列以及cdna序列信息,根据宿主细胞(工程菌)密码子偏好性,合成经密码子优化的编码序列。
62、在一些具体的实施方式中,所述吉玛烯a合成酶的编码核酸具有seq id no:17所示的核酸序列。
63、在一些具体的实施方式中,所述牻牛儿基牻牛儿基焦磷酸合成酶的编码核酸具有seq id no:19所示的核酸序列。
64、在一些具体的实施方式中,所述crispr相关蛋白的编码核酸具有seq id no:51或者seq id no:53所示的核酸序列。
65、在一些具体的实施方式中,所述橙花叔醇合酶的编码核酸具有seq id no:95所示的核酸序列。
66、在进一步的实施方式中,所述第一多肽和所述第二多肽之间通过或者不通过连接肽连接。在某些实施方式中,所述第一多肽和所述第二多肽之间直接连接。在某些实施方式中,所述第一多肽和第二多肽间通过连接肽连接,所述连接肽包含但不限于:可切割连接肽、不可切割连接肽、肽连接肽、柔性连接肽、刚性连接肽、螺旋连接肽和非螺旋连接肽。在某些实施方式中,所述连接肽包括如ggggs(seq id no:109)、gsg、ygq、gggs、gsggggs(seqid no:110)、gsgeaaak(seq id no:111)、gsgeaaakeaaak(seq id no:112)、gsgmgsssn(seqid no:113)、pqqkkns(seq id no:114)、pggh、yrsqi(seq id no:115)、vipfis(seq id no:116)、flylkf(seq id no:117)、wrfspklq(seq id no:118)、hhvqesqcistv(seq id no:119)、pqqkknsr(seq id no:120)、aggggtggaaggggtgga(seq id no:121)、eaaakeaaak(seqid no:122)、ptptptptp(seq id no:123)等,或者上述所示连接肽序列中的一个、两个、三个、四个或更多个重复。在一些优选的实施方式中,本发明的融合蛋白的连接肽选自gggs、pqqkknsr、aggggtggaaggggtgga、eaaakeaaak、ptptptptp。在一些更优选的实施方式中,本发明的融合蛋白连接肽选自gggs、pqqkknsr、aggggtggaaggggtgga。在一些更优选的实施方式中,本发明的融合蛋白的连接肽为gggs。
67、在某些实施方式中,所述第二多肽位于所述第一多肽的n末端或者c末端。在某些实施方式中,所述第二多肽位于第一多肽的c端。
68、在一些实施方式中,本发明所述的融合蛋白包含第一多肽以及第二多肽,还任选地包含连接肽,其中,所述第一多肽选自seq id no:2-8、seq id no:56、seq id no:58、seqid no:62、seq id no:64中的一种或多种,所述第二多肽选自seq id no:16、seq id no:18、seq id no:50、seq id no:52、seq id no:93。在一些优选的实施方式中,所述第一多肽选自seq id no:2-8、seq id no:56、seq id no:58、seq id no:62、seq id no:64中的一种或多种,所述第二多肽选自seq id no:16、seq id no:18、seq id no:50、seq id no:93。在一些优选的实施方式中,所述第一多肽选自seq id no:2-8、seq id no:56、seq id no:58中的一种或多种,所述第二多肽选自seq id no:16、seq id no:18、seq id no:50、seq idno:52、seq id no:93中的一种或多种。在一些优选的实施方式中,所述第一多肽选自seqid no:2-8、seq id no:56、seq id no:58中的一种或多种,所述第二多肽选自seq id no:16、seq id no:18、seq id no:50、seq id no:93中的一种或多种。在一些优选的实施方式中,所述第一多肽选自seq id no:2-8中的一种或多种,所述第二多肽选自seq id no:16、seq id no:18、seq id no:50、seq id no:93中的一种或多种。在一些优选的实施方式中,所述第一多肽选自seq id no:2-8中的一种或多种,所述第二多肽选自seq id no:16、seqid no:93中的一种或多种。在一些实施方式中,本发明所述的融合蛋白具有如seq id no:20-seq id no:26、seq id no:78-seq id no:81、seq id no:94、seq id no:105、seq idno:107任一项所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。在某些实施方式中,本发明所述的融合蛋白具有如seq id no:20-seq id no:26、seq id no:94、seq id no:105、seq idno:107任一项所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。在一些优选的实施方式中,所述融合蛋白具有如seq id no:23-seq id no:26、seq id no:94、seq id no:105、seq id no:107任一项所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。在一些优选的实施方式中,所述融合蛋白具有如seq id no:23-seq id no:26、seq id no:94任一项所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。在一些优选的实施方式中,所述融合蛋白具有如seq id no:23-seq id no:26任一项所示的氨基酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的氨基酸序列。
69、在一些实施方式中,本发明所述的融合蛋白的编码核酸具有如seq id no:27-seqid no:33、seq id no:82-seq id no:85、seq id no:96、seq id no:106、seq id no:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些实施方式中,本发明所述的融合蛋白的编码核酸具有如seq id no:27-seq id no:33、seq id no:96、seq id no:106、seq idno:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施方式中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33、seq id no:96、seq id no:106、seq id no:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施例中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33、seq id no:96任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施例中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。
70、在某些实施方式中,所述融合蛋白包含标签。在某些实施方式中,所述标签选自下组中的一种或多种:荧光标签、发光标签、纯化标签和生色标签。在一些具体的实施方式中,所述标签选自下组中的一种或多种:myc标签、ha标签、vsv-g标签、flag标签、v5标签和his标签(例如his*6);优选地,所述标签为myc标签。
71、本发明第四方面提供了分离的核酸,其包含编码如本文第一方面所述的多肽的核苷酸序列或包含编码如本文所述的融合蛋白的核苷酸序列。
72、在进一步的实施方式中,所述编码如本文第一方面所述的多肽的核酸包含选自如下所组成的组中的核苷酸序列:seq id no:9-seq id no:15、seq id no:57、seq id no:59、seq id no:63、seq id no:65任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)序列同一性的核苷酸序列。在某些实施方式中,所述编码如本文第一方面所述的多肽的核酸包含选自如下所组成的组中的核苷酸序列:seq id no:9-seq id no:15、seq id no:57、seq id no:59任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)序列同一性的核苷酸序列。在某些实施方式中,所述编码如本文第一方面所述的多肽的核酸包含选自如下所组成的组中的核苷酸序列:seq id no:9-seq idno:15任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)序列同一性的核苷酸序列。在一些优选的实施方式中,所述编码如本文第一方面所述的多肽的核酸为如seq id no:12-seq id no:15任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)序列同一性的核苷酸序列。
73、在进一步的实施方式,所述编码如本文所述的融合蛋白的核酸包含选自下组的核苷酸序列:seq id no:27-seq id no:33、seq id no:82-seq id no:85、seq id no:96、seqid no:106、seq id no:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)序列同一性的核苷酸序列。
74、在一些实施方式中,本发明所述的融合蛋白的编码核酸具有如seq id no:27-seqid no:33、seq id no:96、seq id no:106、seq id no:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施方式中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33、seq id no:96、seq id no:106、seq id no:108任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施例中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33、seq id no:96任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。在一些优选的实施例中,所述融合蛋白的编码核酸具有如seq id no:30-seq id no:33任一项所示的核苷酸序列或与其具有至少70%(例如,至少70%、71%、72%、73%、74%、75%、76%、77%、78%、79%、80%,81%、82%、83%、84%、85%、86%、87%、88%、89%、90%、91%、92%、93%、94%、95%、96%、97%、98%、99%,或100%)同一性的核苷酸序列。
75、本发明第五方面提供了表达盒,所述表达盒能够表达如本文第一方面所述的第一多肽、本文所述的第二多肽和/或本文第三方面所述的融合蛋白。在一些实施方式中,所述表达盒能够表达如本文第一方面所述的第一多肽和/或本文所述的第二多肽,或者本文第三方面所述的融合蛋白。
76、在一些实施方式中,所述表达盒包含编码如本文第一方面所述的第一多肽的核酸、编码本文所述的第二多肽的核酸和/或编码本文第三方面所述的融合蛋白的核酸序列。
77、在进一步的实施方式中,所述表达盒包括启动子和终止子。在进一步的实施方式中,所述表达盒中的启动子和终止子的具体类型不受特别限制,只要其能够在相应宿主细胞中有效驱动和终止目标蛋白编码序列的转录即可。本领域技术人员可根据宿主细胞的类型,选择本领域已知的任何合适的启动子和终止子。在某些实施方式中,所述启动子选自ppgk1、ptef2、ptdh3、picl1、phxt7、padh2、pjen1、pura3、pgap、pt7、pgal1、pgal10、ppck1、phis3、ptrp1、pfba1、ptef1或pssa1;优选地,所述启动子选自ptef2、pura3、pgap、pt7、pgal1、pgal10、phis3、ptrp1、pfba1、ptef1或pssa1。在某些实施方式中,所述终止子选自ttrp1、terg12、terg8、terg19、this3、terg13、tgal80、tidi1、tura3、tcyc1、taox1、tadh2或tadh1;优选地,所述终止子选自ttrp1、terg12、terg8、terg19、this3、terg13、tgal80、tidi1、tura3、tcyc1、tadh1。在某些实施方式中,所述启动子为pssa1,且终止子为tadh1。在某些实施方式中,所述启动子为pgap,且终止子为taox1。在某些实施方式中,所述启动子为pt7,且终止子为tt7。在某些实施方式中,所述启动子为pssa1,且终止子为tadh1。
78、在优选的实施方式中,所述第一多肽可与第二多肽处于相同或者不同的表达盒中。
79、例如,关于第一多肽的表达盒可为pssa1-编码第一多肽的核苷酸序列-tadh1、ptef1-编码第一多肽核苷酸序列-tcyc1等。
80、例如,关于第二多肽的表达盒可为pssa1-编码第二多肽的核苷酸序列-tadh1、pgap-编码第二多肽的核苷酸序列-taox1等。
81、在一些实施方式中,关于融合蛋白的表达盒可含有以下中的任一种:
82、启动子-编码第一多肽的核苷酸序列-编码第二多肽的核苷酸序列-终止子;
83、启动子-编码第一多肽的核苷酸序列-编码连接肽的核苷酸序列-编码第二多肽的核苷酸序列-终止子;
84、启动子-编码第二多肽的核苷酸序列-编码第一多肽的核苷酸序列-终止子;或者
85、启动子-编码第二多肽的核苷酸序列-编码连接肽的核苷酸序列-编码第一多肽的核苷酸序列-终止子。
86、在一些实施方式中,关于融合蛋白的表达盒可含有以下中的一种或多种:
87、(a) pssa1-编码第一多肽的核苷酸序列-编码第二多肽的核苷酸序列-tadh1
88、(b) pssa1-编码第一多肽的核苷酸序列-gggs-编码第二多肽的核苷酸序列-tadh1;
89、(c) pssa1-编码第二多肽的核苷酸序列-编码第一多肽的核苷酸序列-tadh1;
90、(d) pssa1-编码第二多肽的核苷酸序列-gggs-编码第一多肽的核苷酸序列-tadh1;
91、(e) pgap-编码第一多肽的核苷酸序列-编码第二多肽的核苷酸序列-taox1;
92、(f) pgap-编码第一多肽的核苷酸序列-gggs-编码第二多肽的核苷酸序列-taox;
93、(g) pgap-编码第二多肽的核苷酸序列-编码第二多肽的核苷酸序列-taoxdh1;
94、(h) pgap-编码第二多肽的核苷酸序列-gggs-编码第二多肽的核苷酸序列-taox1;
95、(i) pgap-编码第一多肽的核苷酸序列-编码第二多肽的核苷酸序列-taox1;
96、(j) pgap-编码第一多肽的核苷酸序列-gggs-编码第二多肽的核苷酸序列-taox1;
97、(k) pgap-编码第二多肽的核苷酸序列-编码第一多肽的核苷酸序列-taox1;或
98、(l) pgap-编码第二多肽的核苷酸序列-gggs-编码第一多肽的核苷酸序列-taox1。
99、所述第一多肽、第二多肽、融合蛋白和连接肽的核苷酸序列和/或氨基酸序列如本文所描述。
100、本发明第六方面提供了载体,所述载体包含如本文第一方面所述的多肽、本文第三方面所述的融合蛋白和/或本文第四方面所述的表达盒。
101、在一些实施方式中,所述载体可包含用于将所述多肽或融合蛋白的编码序列导入宿主细胞中进行表达的外源基因表达盒。所述外源基因表达盒包含启动子、编码如本文所述多肽或融合蛋白的目的基因以及终止子。所述外源基因表达盒在宿主细胞(例如酿酒酵母)中可整合入宿主细胞基因组中进行稳定表达,也可以游离于宿主细胞基因组外,以质粒形式进行表达。
102、在一些实施方式中,所述宿主细胞是指能够表达外源基因的细胞,包括原核细胞和真核细胞。所述原核细胞包括大肠杆菌、枯草芽孢杆菌等;所述真核细胞包括酵母细胞、哺乳动物细胞、植物细胞等。在一些实施方式中,所述宿主细胞优选为酵母细胞或大肠杆菌,所述酵母细胞包括但不限于酿酒酵母、毕赤酵母、假丝酵母等。
103、在一些实施方式中,所述外源基因包括但不限于编码吉马烯a合成酶(gas)、牻牛儿基牻牛儿基焦磷酸合成酶(ggpps)、crispr相关蛋白(cas蛋白)和/或橙花叔醇合酶(nes)的基因。所述外源基因可为天然存在的基因序列,或为密码子优化后的基因序列。
104、所述载体中所述编码基因可为编码如本文所述多肽的天然多核苷酸序列,包括cdna序列、基因组序列或rna序列,或其简并的变异体。如本文所用,“简并的变异体”是指能够编码所述多肽、但与天然多核苷酸序列有差别的多核苷酸序列,优选使用密码子优化的dna序列。所述多核苷酸可通过pcr扩增法、重组法或人工合成的方法获得。
105、在一些实施方式中,例如,所述载体中所编码的多肽可为如本文所述的法尼基焦磷酸合成酶,如erg20。
106、在一些实施方式中,所述载体中编码的多肽可为:(a)天然存在的野生型多肽;(b)野生型多肽经过一个或多个氨基酸残基的取代、缺失或添加而形成的、或是添加信号肽序列后形成的,并具有相应活性的多肽;(c)序列中含有(a)或(b)中所述多肽序列的多肽;(d)氨基酸序列与野生型多肽的一致性≥85%(较佳地≥90%,优选≥95%),并具有相应活性的多肽。
107、在一些实施方式中,所述载体可为整合型载体或游离型载体。所述外源基因表达盒可整合入宿主细胞基因组中进行表达,也可以游离于基因组外的质粒形式表达。所述外源基因表达盒包含启动子、目的基因和终止子。
108、在一些实施方式中,所述载体为游离型载体,所述游离型载体可为本领域已知的任何可用于将外源基因导入宿主细胞进行表达的质粒载体。所述游离型载体可包含复制起点、筛选标记和所述外源基因表达盒。在一些实施方式中,所述游离型载体可为商购的载体,或具有相同功能的任何载体。例如,所述游离型载体可为酵母表达载体或大肠杆菌表达载体,其中,酵母表达载体可为基于prs425、pl2μ、pesc、ppiczαa等骨架构建的重组质粒,用于表达带标签或不带标签的包括但不限于例如lsltc2、erg20(包括全长或截短形式)、sacas9、acnes1、tmcrte等及其融合蛋白;大肠杆菌表达载体可为基于pet28a等骨架构建的重组质粒。
109、在一些实施方式中,所述载体可为整合型载体,将外源基因整合入宿主基因组的方法主要为同源重组。示例性地,同源重组的方法包括:扩增整合位点的上下游序列作为上游同源臂和下游同源臂,构建目的基因表达盒,例如通常在上游同源臂中还含有筛选标记基因;然后将上述构件按照上游同源臂、基因表达盒和下游同源臂的顺序进行连接,以形成可用于同源重组的片段或重组质粒;将获得的用于同源重组的片段或重组质粒导入宿主细胞中,根据筛选标记筛选阳性转化子,从而获得整合型宿主(工程菌)。
110、在一些实施方式中,所述载体的筛选标记包括营养缺陷型筛选标记和抗性筛选标记。其中,营养缺陷型筛选标记可为leu2、his3、ura3、trp1等。抗性筛选标记可为遗传霉素g418、博莱霉素抗性基因bleor、潮霉素抗性基因hyg、卡那霉素抗性基因(kan)等。
111、在一些实施方式中,所述载体为质粒载体,其可选自本领域常用的表达载体,例如酵母表达载体prs425系列(如prs425-leu2)、pesc系列载体(如pesc-trp)、基于2μ复制子的酵母表达载体(如pl2μ系列载体)、大肠杆菌表达载体pet28a系列以及毕赤酵母表达载体ppiczαa等。
112、在一些实施方式中,所述载体为质粒载体,其选自prs425-leu2、prs425、pl2μ、pet28a、pesc-trp、ppiczαa等。
113、在一些实施方式中,所述载体可采用本领域已知的方法将同源重组片段或重组质粒导入宿主细胞中。其中,转化宿主细胞的方法可使用本领域技术人员已知的各种转化方法,例如电转化法、醋酸锂化学转化法、氯化钙化学转化法等。
114、在一些实施方式中,所述载体中还包含用于降低基因表达水平或酶活性的调控元件。降低基因表达水平或酶活性的方法包括但不限于:替换启动子元件、基因敲除、定点突变或rna干扰(rnai)。
115、本发明第七方面提供了经重组的宿主细胞,所述经重组的宿主细胞包含或者表达如本文所述融合蛋白;优选地,所述经重组的宿主细胞包含编码如本文所述述融合蛋白的表达盒。
116、在优选的实施方式中,所述宿主细胞为酵母或大肠杆菌,因此,所述经重组的宿主细胞也称为工程菌。在某些实施方式中,所述宿主细胞为毕赤酵母。在某些实施方式中,所述宿主细胞为酿酒酵母。在某些实施方式中,所述宿主细胞为大肠杆菌。本发明的酵母或者大肠杆菌可为本领域可获得的任何酵母或者大肠杆菌,例如,可商购的酿酒酵母cen.pk2-1d、酿酒酵母invsc1、酿酒酵母by4742、酿酒酵母yph499、酿酒酵母w303-1b、毕赤酵母gs115、大肠杆菌bl21(de3)、大肠杆菌rosetta等。
117、在更优选的实施方式中,所述宿主细胞可来自野生型酵母菌或大肠杆菌、或诱变或工程化而来的突变型酵母菌或大肠杆菌。在更为优选的实施方式中,所述宿主细胞可来自能够提供法尼焦磷酸(fpp)的野生型酵母菌或大肠杆菌、或诱变或工程化而来的突变型酵母菌或大肠杆菌。
118、例如,为了筛选或生物合成的目的,对宿主细胞进行诱变或工程化改造。在一些实施方式中,可对所述宿主细胞进行诱变或工程化改造,以赋予或增强其特定的生物学功能,从而满足筛选标记应用或目标产物生物合成的需求。所述诱变或工程化改造旨在优化宿主细胞的代谢网络、基因表达调控模式或细胞生理特性,包括但不限于提高目标化合物的合成通量与转化率、解除代谢瓶颈或反馈抑制、降低副产物生成、增强细胞对发酵环境胁迫(如产物毒性、渗透压、氧化应激或极端ph)的耐受性,或建立异源生物合成通路以实现非天然产物的从头合成。
119、在一些实施方式中,所述经重组的宿主细胞为生产异戊二烯焦磷酸或萜类化合物的工程细胞。在一些实施方式中,所述经重组的宿主细胞包含或者表达如本文所述的吉马烯合成酶的融合蛋白。本发明所述的宿主细胞可以为未经改造或者改造的宿主细胞。在某些实施方式中,所述改造为特定氨基酸合成缺陷(例如通常为营养缺陷型筛选标记)的恢复,所述氨基酸合成缺陷的恢复包括但不限于如下方式:特定核苷酸生物合成基因的原位回填,即对失活位点进行修复;通过在非原始基因座位点整合包含氨基酸生物合成基因的表达框,或者通过例如游离型质粒表达所述氨基酸生物合成基因,以宿主细胞合成相应氨基酸的能力,,例如从而将所述氨基酸生物合成基因用作营养缺陷型筛选标签。在一些实施方式中,所述营养缺陷型筛选标记可与一个或多个目的基因共表达或融合构建于同一表达载体上,使得在缺乏相应氨基酸的选择压力下,仅携带所述载体并表达所述氨基酸生物合成基因的宿主细胞能够存活和增殖,由此同时实现转化子的筛选和目的基因的维持。优选地,所述筛选标记用于多轮基因组编辑或连续转化中的正筛选或反筛选(counter-selection),例如通过ura3标记反筛选循环敲除内源基因,同时利用同一标记的互补进行新一轮阳性筛选。在某些实施方式中,所述改造为甲羟戊酸(mva)途径优化,即通过过表达mva途径中的限速酶(如hmg-coa还原酶)、消除mva途径中间产物的积累、平衡mva途径各酶的表达水平,或通过密码子优化和启动子强度以及增加拷贝数调整增强mva途径的代谢通量,以提高异戊二烯焦磷酸或萜类化合物等产物的产量。
120、在某些实施方式中,所述宿主细胞包含一种或多种内源酶,所述内源酶包括异戊烯基焦磷酸异构酶(idi1)、3-羟基-3-甲基戊二酰辅酶a合成酶(erg13)、角鲨烯合成酶(erg9)、甲羟戊酸激酶(erg12)、磷酸甲羟戊酸激酶(erg8)、法尼基焦磷酸合酶(erg20)、甲羟戊酸焦磷酸脱羧酶(erg19);优选地,所述内源酶包括角鲨烯合成酶erg9。在某些实施方式中,所述宿主细胞包含一种或多种外源酶,所述外源酶包括乙酰辅酶a c-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae等。
121、在进一步的实施方式中,所述宿主细胞包含以下任一种或多种:表达的乙酰辅酶ac-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae、过表达的异戊烯基焦磷酸异构酶idi1、过表达的3-羟基-3-甲基戊二酰辅酶a合成酶erg13、过表达的甲羟戊酸激酶erg12、过表达的磷酸甲羟戊酸激酶erg8、过表达的法尼基焦磷酸合酶erg20、过表达的甲羟戊酸焦磷酸脱羧酶erg19;优选地,所述宿主细胞包含失活或者抑制的活性或表达水平的负责法尼醇合成的lpp1和负责转录调控的gal80,在进一步优选的实施方式中,所述宿主细胞包含过表达2个拷贝的甲羟戊酸激酶erg12。在一些优选的实施方式中,所述宿主细胞包含表达水平改变的内源酶,包括角鲨烯合成酶erg9,其中所述角鲨烯合成酶的活性或表达水平被弱化(例如降低),且所述弱化通过以下方式实现:(a)替换所述酶的编码基因的启动子;和/或(b)将内源酶角鲨烯合成酶erg9替换为表达活性降低的角鲨烯合成酶突变体(例如erg9(k325e)或erg9(r225a))。
122、在一些实施方式中,在酵母宿主细胞中,所述宿主细胞进一步地包括以下特性中的一种或多种:
123、增加乙酰辅酶ac-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae的活性,例如增加的表达水平;
124、提高的甲羟戊酸激酶erg12的活性,例如增加的表达水平;
125、提高的磷酸甲羟戊酸激酶erg8的活性,例如增加的表达水平;
126、提高的甲羟戊酸焦磷酸脱羧酶erg19的活性,例如增加的表达水平;
127、提高的法尼基焦磷酸合酶erg20的活性,例如增加的表达水平;
128、提高的3-羟基-3-甲基戊二酰辅酶a合成酶erg13的活性,例如增加的表达水平;
129、降低的负责调控gal启动子表达的gal80的活性,例如降低的表达水平;
130、提高的异戊烯基焦磷酸异构酶idi1的表达活性,例如增加的达水平;或者
131、降低的负责法尼醇合成的基因lpp1的表达水平;或者
132、降低的角鲨烯合成酶erg9的活性,例如降低的表达水平
133、在一些实施方式中,在酵母宿主细胞中,所述宿主细胞进一步包括以下特性中的一种或多种:
134、降低的负责法尼醇合成的基因lpp1的表达水平;
135、提高的乙酰辅酶a c-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae的活性;
136、降低的负责调控gal启动子表达的gal80的活性;
137、提高的异戊烯基焦磷酸异构酶idi1的活性;
138、提高的甲羟戊酸激酶erg12的活性;
139、提高的法尼基焦磷酸合酶erg20的活性;
140、提高的磷酸甲羟戊酸激酶erg8的活性;
141、提高的甲羟戊酸焦磷酸脱羧酶erg19的活性;
142、提高的3-羟基-3-甲基戊二酰辅酶a合成酶erg13的活性;或者
143、降低的角鲨烯合成酶 erg9的活性,例如降低的表达水平。
144、示例性地,所述增加的活性可通过常规的基因工程方法实现,例如通过改变其启动子、酶改造、或增加其拷贝数等方式实现。或者,活性的增加可通过使用本文所述的方法进行,例如与第一方面所述的多肽共同表达(例如以融合蛋白的形式,可在原位表达或在非原始基因座位置表达),这些方式都落入了本技术所保护的范围内。
145、示例性地所述降低的活性可通过常规的基因工程方法实现,例如通过改变启动子、酶改造、敲除、减少拷贝数等方式实现。
146、在一些实施方式中,所述宿主细胞通过引入/插入乙酰辅酶a c-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae的编码基因表达盒来表达efmvae。
147、在一些实施方式中,所述宿主细胞通过引入/插入异戊烯基焦磷酸异构酶idi1的编码基因表达盒来过表达idi1。
148、在一些实施方式中,所述宿主细胞通过引入/插入3-羟基-3-甲基戊二酰辅酶a合成酶erg13的编码基因表达盒来过表达erg13。
149、在一些实施方式中,所述宿主细胞通过引入/插入法尼基焦磷酸合酶erg20的编码基因表达盒来过表达erg20。
150、在一些实施方式中,所述宿主细胞通过引入/插入甲羟戊酸激酶erg12的编码基因表达盒来过表达erg12。
151、在一些实施方式中,所述宿主细胞通过引入/插入甲羟戊酸磷酸激酶erg8的编码基因表达盒来过表达erg8。
152、在一些实施方式中,所述宿主细胞通过引入/插入甲羟戊酸焦磷酸脱羧酶erg19的编码基因表达盒来过表达erg19。
153、在一些实施方式中,通过在宿主细胞(例如酵母细胞)中破坏、取代、缺失或敲除gal80和/或lpp1,从而失活或抑制gal80和/或lpp1,在一些优选的实施方式中,通过在酵母中敲除gal80和/或lpp1,从而失活gal80和/或lpp1。在一些优选的实施方式中,所述宿主细胞通过插入角鲨烯合成酶erg9突变体的编码基因表达盒,并敲除内源角鲨烯合成酶,所述erg9突变体为erg9(k325e)或erg9(r225a)。
154、在一些实施方式中,所述宿主细胞包括一个或多个表达盒,所述表达盒包括启动子、编码序列及终止子。所述启动子和终止子可分别选自适用于宿主细胞的功能性启动子和终止子。所述宿主细胞可为真核细胞或原核细胞,例如酵母细胞或大肠杆菌细胞。
155、在一些实施方式中,所述表达盒用于表达代谢通路相关酶、调控蛋白以及目标蛋白。在一些实施方式中,所述代谢通路相关酶包括但不限于erg12、erg8、erg19、erg20、idi1、erg13、efmvae、lpp1等。在一些实施方式中,所述调控蛋白包括但不限于erg9或其突变体(例如erg9(r225a)或erg9(k325e))、gal80等。在一些实施方式中,所述目标蛋白包括如本文所述第一多肽、第二多肽或其融合蛋白。
156、例如,在一些实施方式中,所述宿主细胞(例如酵母细胞)包含或者表达如本文所述的吉马烯合成酶的融合蛋白,并任选地具有活性提高的法尼基焦磷酸合酶erg20。
157、在一些实施方式中,所述表达盒可为酵母表达盒,其启动子选自pssa1、ptef1、ptef2、pfba1、perg9、pgal1、pgal10、ptrp1、phis3或pura3,终止子选自tadh1、tcyc1、terg8、terg9、terg12、terg19、tidi1、tgal80、ttrp1、this3或tura3。在一些实施方式中,所述启动子为pssa1,且终止子为tadh1。在某些实施方式中,所述启动子为pgap,且终止子为taox1。
158、在另一些实施方式中,所述表达盒可为大肠杆菌表达盒,其启动子为t7启动子,终止子为适用于t7转录体系的终止子。
159、在优选的实施方式中,多个所述表达盒可串联构建为多基因表达模块,用于在同一宿主细胞中同时表达多个代谢通路酶和/或目标蛋白。
160、在一些实施方式中,所述表达盒包含启动子和终止子,所述启动子包括但不限于ptef1、ptef2、ptrp1、perg12、pfba1、phis3、pgal1、pgal10、pura3、pssa1、perg9、pgap或ppgk1等。在一些实施方式中,所述终止子包括但不限于tadh2、tadh1、ttrp1、terg12、terg8、terg19、this3、terg13、tgal80、tura3、tcyc1、tidi1或terg9等。
161、在一些实施方式中,所述表达盒为ptrp1-trp1-ttrp1、ptef1-erg12-terg12、pfba1-erg8-terg8、ptef2-erg19-terg19、phis3-his3-this3、ptef1-erg12-terg12、terg13(rc)-erg13(rc)-pgal1(rc)、pgal10-efmvae-tgal80、pura3-ura3-tura3、ptef1-erg20-tadh1、ptef2-idi1-tidi1、pura3-ura3-tura3、perg9-erg9(r225a)-terg9、perg9-erg9(k325e)-terg9、ptef-kanmx-tadh2、pgap-lsltc2-taox1、pgap-截短erg20-任选的连接肽的编码序列-lsltc2-taox1-bleor等。
162、例如,所述表达盒为ptrp1-trp1-ttrp1-ptef1-erg12-terg12-pfba1-erg8-terg8-ptef2-erg19-terg19(seq id no:45)、phis3-his3-this3-ptef1-erg12-terg12-terg13-erg13-pgal1-pgal10-efmvae-tgal80(seq id no:46)、pura3-ura3-tura3-ptef1-erg20-tadh1-ptef2-idi1-tidi1(seq id no:47)、trp1-289::trp1(seq id no: 48)、pura3-ura3-tura3-phis3-his3-this3(seq id no:49)、ptrp1-trp1-ttrp1-perg9-erg9(r225a)-terg9(seq id no: 90)或ptrp1-trp1-ttrp1-perg9-erg9(k325e)-terg9(seq idno:91)、δerg9-ptef-kanmx-tadh2(seq id no: 92)、pgap-lsltc2-taox1-bleor(seq idno: 66)、pgap-terg20-lsltc2-taox1-bleor(seq id no: 77)等。
163、在一些实施方式中,所述表达盒为ptrp1-trp1-ttrp1-ptef1-erg12-terg12-pfba1-erg8-terg8-ptef2-erg19-terg19,其结构由seq id no:45所示的核苷酸序列构成,或为与seq id no:45所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:45所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:45所示序列具有至少99%的序列同一性。
164、在一些实施方式中,所述表达盒为phis3-his3-this3-ptef1-erg12-terg12-terg13-erg13-pgal1-pgal10-efmvae-tgal80,其结构由seq id no:46所示的核苷酸序列构成,或为与seq id no:46所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:46所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:46所示序列具有至少99%的序列同一性。
165、在一些实施方式中,所述表达盒为pura3-ura3-tura3-ptef1-erg20-tadh1-ptef2-idi1-tidi1,其结构由seq id no:47所示的核苷酸序列构成,或为与seq id no:47所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:47所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:47所示序列具有至少99%的序列同一性。
166、在一些实施方式中,所述表达盒为pura3-ura3-tura3-phis3-his3-this3,其结构由seq id no:49所示的核苷酸序列构成,或为与seq id no:49所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:49所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:49所示序列具有至少99%的序列同一性。在一些实施方式中,所述表达盒为ptrp1-trp1-ttrp1-perg9-erg9(r225a)-terg9,其结构由seq id no:90所示的核苷酸序列构成,或为与seq id no:90所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:90所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:90所示序列具有至少99%的序列同一性。
167、在一些实施方式中,所述表达盒为ptrp1-trp1-ttrp1-perg9-erg9(k325e)-terg9,其结构由seq id no:91所示的核苷酸序列构成,或为与seq id no:91所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:91所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:91所示序列具有至少99%的序列同一性。
168、在一些实施方式中,所述表达盒为δerg9-ptef-kanmx-tadh2,其结构由seq idno:92所示的核苷酸序列构成,或为与seq id no:92所示核苷酸序列具有至少90%序列同一性的核苷酸序列,例如至少90%、91%、92%、93%、94%、95%、96%、97%、98%或99%的序列同一性。在优选的实施方式中,所述表达盒的核苷酸序列与seq id no:92所示序列具有至少95%的序列同一性;在更优选的实施方式中,所述表达盒的核苷酸序列与seq id no:92所示序列具有至少99%的序列同一性。
169、在进一步的实施方式中,所述宿主细胞是通过在酿酒酵母(例如cen.pk2-1d酿酒酵母菌)包含或者表达如本文所述的吉马烯合成酶的融合蛋白,并任选地具有活性提高的法尼基焦磷酸合酶erg20。在进一步的实施方式中,所述宿主细胞是通过在酿酒酵母(例如cen.pk2-1d酿酒酵母菌),利用营养缺陷型筛选标记(包括但不限于,leu、trp1、his、ura等),在基因组中的一个或多个位点插入erg12、erg8、erg19、erg12、erg13、efmvae、erg20、idi1表达盒,同时敲除了gal80和lpp1。在一些实施方式中,所述表达盒可插入期望敲除的基因位点,以同时实现插入和敲除。在进一步的实施方式中,所述宿主细胞是通过在酿酒酵母(例如cen.pk2-1d酿酒酵母菌),利用营养缺陷型筛选标记(包括但不限于,leu、trp1、his、ura等),在xi-3位点或1622b或416d或xii-1等中性位点插入erg12、erg8、erg19,在gal80位点插入erg12、erg13、efmvae表达盒,同时敲除了gal80;在lpp1位点插入erg20、idi1的表达盒,同时敲除了lpp1。
170、在进一步的实施方式中,所述宿主细胞是通过在cen.pk2-1d酿酒酵母菌中xi-3位点插入ptrp1-trp1-ttrp1-ptef1-erg12-terg12-pfba1-erg8-terg8-ptef2-erg19-terg19(seq id no:45),使用trp1筛选标记进行筛选;敲除gal80,在gal80位点插入phis3-his3-this3-ptef1-erg12-terg12-terg13-erg13-pgal1-pgal10-efmvae-tgal80(seq id no:46),使用his筛选标记进行筛选;lpp1敲除后,在lpp1位点插入pura3-ura3-tura3-ptef1-erg20-tadh1-ptef2-idi1-tidi1(seq id no:47),使用ura3筛选标记进行筛选。
171、在某些实施方式中,所述宿主细胞是通过在cen.pk2-1d酿酒酵母菌中在trp1-289位点回填trp1基因;敲除lpp1,在lpp1位点插入pura3-ura3-tura3-phis3-his3-this3(seqid no:49),使用ura3和his3筛选标记进行筛选。
172、进一步的,在某些实施方式中,所述宿主细胞在1622b位点插入ptrp1-trp1-ttrp1-perg9-erg9(r225a)-terg9(seq id no:90)或ptrp1-trp1-ttrp1-perg9-erg9(k325e)-terg9(seq id no:91),并使用kanmx筛选标记敲除内源erg9。
173、在优选的实施方式中,本发明提供了宿主细胞,所述宿主细胞包含或者表达上述融合蛋白,所述宿主细胞选自于酵母、大肠杆菌,优选选自于酿酒酵母、毕赤酵母和大肠杆菌,最优选为酿酒酵母。在具体的实施方式中,所述宿主细胞为未经改造或者改造的宿主细胞,优选地,所述改造为mva途径优化,所述mva途径优化通过以下方式实现:在所述宿主细胞中引入编码异源双功能酶乙酰辅酶a c-乙酰转移酶/3-羟基-3-甲基戊二酸单酰辅酶a还原酶efmvae的基因、过表达异戊烯基焦磷酸异构酶idi1、过表达3-羟基-3-甲基戊二酰辅酶a合成酶erg13、过表达甲羟戊酸激酶erg12、过表达磷酸甲羟戊酸激酶erg8、过表达法尼基焦磷酸合酶erg20、过表达甲羟戊酸焦磷酸脱羧酶erg19。在一些优选的实施方式中,所述宿主细胞包含失活或抑制的负责法尼醇合成的lpp1和负责转录调控的gal80,在某些优选的实施方式中,所述宿主细胞包含过表达2个拷贝的甲羟戊酸激酶erg12。进一步地,在一些优选的实施方式中,所述宿主细胞通过替换内源性角鲨烯合成酶为角鲨烯合成酶突变体。
174、在一些实施方式中,可用的酵母基因筛选标记可为本领域技术人员已知的任何筛选标记,只要向同一酵母菌株导入不同片段或质粒时所使用的筛选标记彼此不同即可。常见的筛选标记有营养缺陷型筛选标记和抗性筛选标记。其中,营养缺陷型筛选标记可选自leu2、his3、ura3或trp1。抗性筛选标记可为遗传霉素g418、博莱霉素抗性基因bleor或潮霉素抗性基因hyg。
175、在一些实施方式中,可用的大肠杆菌筛选标记可为本领域技术人员已知的任何筛选标记,只要向同一大肠杆菌导入不同片段或质粒时所使用的筛选标记彼此不同即可。常见的筛选标记有抗性筛选标记,例如氨苄青霉素抗性基因amp、卡那霉素抗性基因kan、氯霉素抗性基因等。
176、本发明第八方面提供了本文所述第一方面的多肽或包含其的融合蛋白或者宿主细胞的用途。在一些实施方式中,如本发明第一方面所述的多肽具有促进可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进吉玛烯a合成酶可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进牻牛儿基牻牛儿基焦磷酸合成酶可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进lsltc2可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进tmcrte可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进合成crispr相关蛋白可溶性蛋白表达的用途。在一些实施方式中,本发明第一方面所述的多肽具有促进acnes1蛋白可溶性蛋白表达的用途。
177、在进一步的实施方式中,包含本发明第一方面所述的多肽的融合蛋白具有生产萜类化合物(如吉玛烯a、榄香烯)、牻牛儿基二磷酸、类胡萝卜素、橙花叔醇中的用途。在进一步的实施方式中,包含本发明第一方面所述的多肽的融合蛋白根据所融合的蛋白具有生产萜类化合物(如吉玛烯a、榄香烯)、牻牛儿基二磷酸、橙花叔醇中的用途。在一些优选的实施方式中,包含本发明第一方面所述的多肽的融合蛋白包含吉玛烯a合成酶,并具有生产吉玛烯a的用途。在一些优选的实施方式中,本发明第一方面所述的多肽的融合蛋白包含吉玛烯a合成酶,具有生产榄香烯的用途。在一些优选的实施方式中,包含本发明第一方面所述的多肽的融合蛋白包含牻牛儿基牻牛儿基焦磷酸合成酶,具有生产牻牛儿基二磷酸的用途。在一些优选的实施方式中,包含本发明第一方面所述的多肽的融合蛋白根据其所融合的蛋白还具有生产类胡萝卜素的用途。在一些优选的实施方式中,包含本发明第一方面所述的多肽的融合蛋白包含橙花叔醇合成酶,具有生产橙花叔醇的用途。
178、本发明所述的经重组的宿主细胞(或工程菌)可具有多种用途,如用于生产萜类化合物,包括但不限于吉玛烯a、榄香烯、瓦伦烯、橙花叔醇等;用于生产牻牛儿基二磷酸;以及用于生产crispr相关蛋白。
179、进一步的,本发明所述的经重组的宿主细胞(或工程菌)相对于野生型宿主细胞具有更高的萜类化合物产量,例如更高的吉玛烯a生产量和/或更高的橙花叔醇生产量。
180、本发明第十方面提供了生产萜类化合物的方法,所述方法包括培养如本文所述的经重组宿主细胞并发酵,以获得所述萜类化合物,其中,所述萜类化合物包括但不限于吉玛烯a、榄香烯、瓦伦烯、橙花叔醇等。其中,所述经重组宿主细胞包含或表达对应的萜类化合物合成酶,特别是本技术所述的融合蛋白。
181、本发明第十一方面提供了生产吉玛烯a或者橙花叔醇的方法,所述方法包括培养如本文所述的经重组的宿主细胞并发酵。其中,所述经重组的宿主细胞包含或表达对应的吉玛烯a或者橙花叔醇的合成酶,所述合成酶优选处于包含本文第一方面的多肽的融合蛋白形式。
182、本发明第十一方面提供了生产β-榄香烯的方法,包括如下步骤:
183、1)发酵本文所述的经重组的宿主细胞或工程菌得到发酵液,其中所述经重组的宿主细胞或工程菌包含或表达对应的吉玛烯合成酶,所述合成酶优选处于包含本文第一方面的多肽的融合蛋白形式;
184、2)有机溶剂萃取所述发酵液,收集有机相;
185、3)将所述有机相加热,得到β-榄香烯。
186、其中,步骤1)中所述发酵包括酵母发酵和/或大肠杆菌发酵。可使用本领域中已知的方法进行酵母发酵和/或大肠杆菌发酵。
187、在一些实施方式中,所述发酵包括双相发酵或单相发酵。
188、在一些实施方式中,所述发酵温度为16-40℃。在一些实施方式中,所述发酵温度为16-37℃。在一些实施方式中,所述发酵温度为37℃。在一些实施方式中,所述发酵温度为30℃。在一些实施方式中,所述发酵温度可为16-30℃。在一些实施方式中,所述发酵温度可为20-30℃。在一些实施方式中,所述发酵温度为25℃。在一些实施方式中,所述发酵温度为30℃。
189、在一些实施方式中,所述发酵转速为100-500rpm。在一些实施方式中,所述发酵转速为250rpm。
190、在一些实施方式中,所述发酵时间在40-144h的范围内。在一些实施方式中,所述发酵时间在40-120h的范围内。在一些实施方式中,所述发酵时间在40-72h的范围内。
191、在一些实施方式中,所述发酵为酵母单相发酵。所述酵母单相发酵包括将所述宿主细胞单克隆接种至发酵培养基,发酵温度30℃,发酵转速250rpm,发酵时间为40-72h。在接种至发酵培养基之前,所述宿主细胞可经过扩增培养,包括一级或多级扩增培养。在一些具体的实施方式中,所述酵母单相发酵包括将所述宿主细胞单克隆接种至发酵培养基,发酵温度30℃,发酵转速250rpm,发酵时间为72h;或者,所述酵母单相发酵包括将所述宿主细胞单克隆接种至发酵培养基,发酵温度30℃,发酵转速250rpm,发酵时间为40h。250rpm在接种至发酵培养基之前,所述宿主细胞可经过扩增培养,包括一级或多级扩增培养。
192、在一些实施方式中,所述发酵为酵母双相发酵。所述酵母双相发酵包括:(1)将所述宿主细胞单克隆接种至扩增培养基,发酵温度30℃,发酵转速250rpm,振荡培养120-168h;(2)按5vol%-10vol%转接量分别取培养的菌液转接至装有发酵培养基及正十二烷的三角瓶中,发酵温度30℃,发酵转速250rpm,培养120-168h。在一些实施方式中,所述发酵为大肠杆菌双相发酵,包括:(1)将所述宿主细胞单克隆至扩增培养基,发酵温度30℃,发酵转速250rpm,培养过夜;(2)按5vol%-10vol%转接量分别取培养过夜的菌液转接至装发酵培养基及正十二烷的三角瓶中,发酵温度30℃,发酵转速250rpm,培养72-120h。在双相发酵中,具体地,在接种至发酵培养基之前,所述宿主细胞可经过一级或多级扩增培养。
193、在一些实施方式中,所述发酵过程中可产生萜类化合物,例如吉马烯a、橙花叔醇等。
194、在一些实施方式中,所述吉马烯a通过萃取或者层析方式提取。在一些实施方式中,所述用于萃取的有机溶剂包括但不限于正十二烷、肉豆蔻异丙酯、正己烷、正庚烷等。在一些实施方式中,所述用于萃取的有机溶剂为正十二烷。
195、在一些实施方式中,所述吉马烯a可通过加热转化转为β-榄香烯。
196、最后,本发明提供了角鲨烯合成酶erg9突变体在生产和/或提高榄香烯产量中的用途,其中,所述角鲨烯合成酶erg9突变体为erg9(k325e)和/或erg9(r225a)。
197、本发明的有益效果:
198、本发明所述的多肽片段小,分子量小,能够有效提升蛋白可溶性表达,更易实现高效异源表达。同时,所述多肽融合省去酶切步骤,减少纯化试剂和时间从而简化纯化流程,降低生产成本,最终实现产物高效生产和产业化。
199、定义
200、除非另有说明,本公开中所用的下列术语具有下列含义。一个特定的术语在没有特别定义的情况下不应该被认为是不确定的或不清楚的,而应该按照本领域普通的含义去理解。当本文中出现商品名时,意在指代其对应的商品或其活性成分。
201、术语“野生型”分别是指天然存在的编码蛋白的多核苷酸序列或其部分、或者蛋白序列或其部分,如通常在体内所存在的。
202、术语“核酸”是本领域公知的。本文所用的“核酸”通常是指含有核碱基(nucleobase)的dna、rna、或它们的衍生物或类似物的分子(即链)。核碱基包括例如dna 中发现的天然存在的嘌呤或嘧啶碱基(例如,腺嘌呤“a”、鸟嘌呤“g”、胸腺嘧啶“t”或胞嘧啶“c”)或rna中发现的天然存在的嘌呤或嘧啶碱基(例如,a、g、尿嘧啶“u”或c)。术语“核酸”涵盖术语“寡核苷酸”和“多核苷酸”。
203、在本文中,除非另有特别指明,本技术中所有氨基酸序列的位置编号及示出方向,均以由氨基端(n端)至羧基端(c端)的方向为准,其中第1位对应n端起始氨基酸,后续位置依次向c端递增;所有核苷酸序列的位置编号及示出方向,均以由5'末端至3'末端的方向为准,其中第1位对应5'末端起始核苷酸,后续位置依次向3'末端递增。
204、在本文中,术语“外源的”指存在于细胞中的非其天然来源的物质。当在本文中使用时,术语“外源的”是指通过涉及人工的过程引入生物系统(如细胞或有机体)的核酸(例如编码吉马烯合成酶的核酸)或蛋白(例如,吉马烯合成酶多肽),这些核酸或蛋白在所述生物系统中通常并不存在或在所述生物系统中以较低的量存在。如果物质是被引入细胞或所述细胞的祖先细胞(遗传所述物质),那么所述物质(例如编码吉马烯合成酶转录因子的核酸;或蛋白,例如吉马烯合成酶多肽)将被认为是外源的。相反,术语“内源的”指生物系统或细胞(例如分化细胞)本身的物质。
205、进一步地,当核酸序列虽与宿主细胞基因组中天然存在的内源基因序列相同或具有实质性同 一性(例如,编码甲羟戊酸激酶erg12的内源基因序列),但该核酸是通过涉及人工的过程(如重组表达载体、转座子系统、基因编辑介导的异源位点整合或其他基因转移技术)引入细胞或所述细胞的祖先细胞,并在所述内源基因的原始基因组座位之外的位点进行表达时,则该核酸仍被视为外源核酸,其所整合的位点或携带的载体视为外源表达单元。然而,由上述异位引入的内源基因序列所编码的蛋白(例如,由异位引入的内源甲羟戊酸激酶erg12基因编码的甲羟戊酸激酶erg12),若其氨基酸序列与所述宿主细胞天然编码的内源蛋白序列相同或具有实质性同一性,则该蛋白在功能分类上仍视为内源蛋白的过表达形式或功能等同物,而不因其编码基因的异位引入或外源表达单元的存在而被归类为外源蛋白。
206、本文中,“目标靶蛋白的融合配偶体”,是指通过将编码本发明所述多肽的核苷酸序列与编码目标靶蛋白的核苷酸序列在同一读码框内直接连接,从而使得所述多肽与所述目标靶蛋白以单一多肽链的形式被表达和翻译。所述融合配偶体可通过可选的接头肽(linker)连接或直接连接。
207、本文中,术语“具有靶蛋白结合结构域的融合配偶体”,是指一种重组蛋白,其包含:(a) 本发明所述的多肽;以及 (b) 一个靶蛋白结合结构域,该结合结构域能够与目标靶蛋白发生特异性非共价结合(如抗原-抗体结合、受体-配体结合、或多肽-多肽相互作用),从而使得所述融合配偶体与目标靶蛋白在表达后形成共存的蛋白复合物。
208、在本文中,“增加蛋白可溶性表达”是指在宿主细胞中,当目标靶蛋白与作为其融合配偶体共表达时,所述目标靶蛋白的可溶性表达水平相较于其单独表达时获得提高。
209、本文中,氨基酸序列的“一致性”、“同一性”、“序列同一性”或“同一性百分比”可以互换使用,是指两个多核苷酸或多肽序列在最佳比对时的残基匹配程度。所述百分比是通过将待测序列与本发明的参考序列进行比对,并在参考序列的全长范围内计算相同残基的比例。用于确定所述序列同一性的比对程序和算法包括:利用默认参数的blastp、blastn、align等程序。当所述算法或程序之间产生比对差异时,以使用默认参数的ncbi blast 2.0软件计算得出的结果为最终判定标准。
210、“启动子”是控制转录起始和速率的核酸序列区。它可含有调节蛋白和分子(例如rna聚合酶和其它转录因子)可结合于其上以启动核酸序列的特异性转录的元件。
211、“终止子”是一种基于序列的元件,其作用是定义转录单位(例如基因)的末端,并启动从转录机制中释放新合成rna的过程。终止子位于待转录基因的下游,通常直接出现在任何 3' 调控元件之后,例如聚腺苷酸化或poly(a)信号。
212、如本文所用,术语“工程菌”是指经过基因工程改造、能够表达外源基因并生产目标产物的宿主细胞,优选为酿酒酵母、大肠杆菌等微生物。
213、除非上下文另有明确指示,本文中的单数术语涵盖复数的指示对象,反之亦然。类似地,未限定数量的名词也包括复数指示物。除非另有说明,本文中的词语“一个”或“一种”意指“至少一个”或“至少一种”。除非上下文另有明确指示,本文中的词语“或”意在包括“和”。
214、在本文中,除非另有说明,术语“包含、包括和含有(comprise、comprises和comprising)”或其等同物(例如contain、containing、include、including)为开放式表述,应理解为“包括但不限于”,意味着除所列出的要素、组分和步骤外,还可涵盖其它未指明的要素、组分和步骤。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com