
基于临床情境模拟的AI培训系统的制作方法
本发明涉及模拟学习,具体为基于临床情境模拟的ai培训系统。
背景技术:
1、虚拟现实、增强现实与高精度传感器技术的成熟,构建高度仿真的三维培训环境已成为可能。医疗行业对操作标准化、患者安全以及降低临床差错提出了更高要求,需超越传统练习的培训手段。而人工智能,特别是计算机视觉、自然语言处理和强化学习技术的突破,为实时分析复杂的人类行为并给予智能反馈提供了技术基石。
2、传统及现有的临床模拟培训方法依赖导师肉眼观察和事后回忆进行评估,反馈往往不及时且不精确,难以精准定位细微错误;高端模拟设备成本高昂,物理模拟人无法灵活生成海量变异病例,难以覆盖各类罕见、危重或突发并发症情境,培训的广度与深度受限;现有系统大多提供固定脚本,无法根据学员的实时表现动态调整情境难度或提供针对性强化训练,多数系统仅记录整体结果,难以对操作流程中的手法、力度、顺序以及与患者的语言交互等进行多维度的数据化分析与归因。
技术实现思路
1、(一)解决的技术问题
2、针对现有技术所存在的上述缺点,本发明提供了基于临床情境模拟的ai培训系统,能够有效地解决现有技术的问题。
3、(二)技术方案
4、为实现以上目的,本发明通过以下技术方案予以实现:
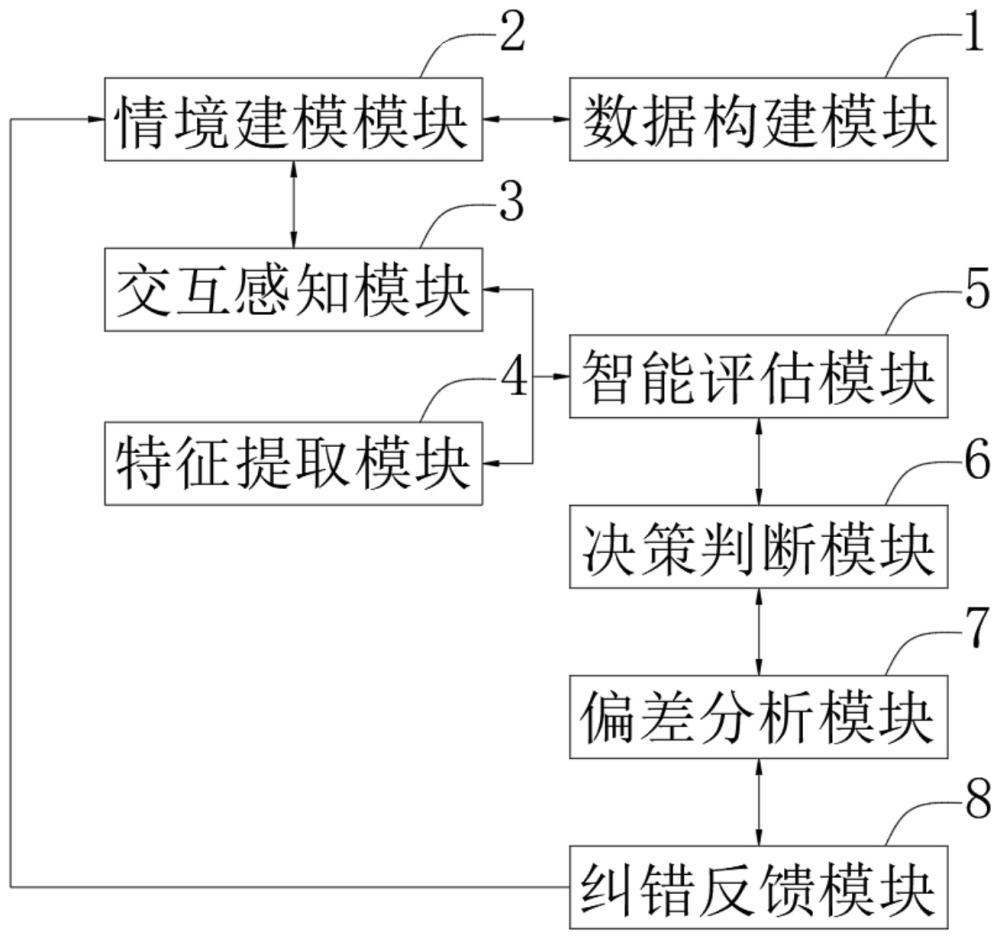
5、本发明公开了基于临床情境模拟的ai培训系统,包括:
6、数据构建模块,用于根据预设的临床操作指标,从临床数据库中对应获取历史临床案例的表现参数与结果参数,形成原始训练数据集;
7、情境建模模块,用于提供用户界面,基于原始训练数据集,构建预设有多种不同临床情境的三维培训模型,所述三维培训模型生成并投射与所选情境对应的指导性视频或音频内容;
8、交互感知模块,用于通过图像与音频采集设备,实时捕获用户响应所选情境而产生的动作图像和语音反馈;图像采集设备为深度摄像头或动作捕捉传感器,用于获取用户动作的空间坐标与关节点数据;音频采集设备为若干麦克风阵列;
9、特征提取模块,用于对捕获的动作图像和语音反馈进行处理,分别提取描述用户动作的形态、方位、时序的关键动作特征,以及描述用户语音的语义、语调、关键词的关键语音特征;
10、智能评估模块,用于通过强化学习算法预训练状态识别模型,模型以关键动作特征和关键语音特征为输入,通过计算与预设情境下理想状态的匹配度,输出表征用户当前综合反馈质量的合格系数;
11、决策判断模块,用于将合格系数与预设的合格阈值进行比较,判断用户反馈是否符合要求;预设合格阈值是可预设配置的动态值,根据所选培训情境的复杂度和培训阶段自适应调整;
12、偏差分析模块,用于在决策判断模块判断为不符合要求时,触发对用户反馈的关键特征与目标特征进行逐项比对,识别出动作方位或幅度偏差,以及语音内容的语义偏差;
13、纠错反馈模块,用于根据偏差分析模块的输出,生成包括对错误动作的方位或幅度进行视觉标注的纠错图形标记,以及包括对错误语音内容进行提示的语音纠错标记,并将所述标记反馈至情境建模模块的用户界面,将纠错标记数据、用户后续表现数据反馈至交互感知模块与智能评估模块,实现模型参数的持续优化与培训情境的动态调整。
14、更进一步地,所述数据构建模块中预设的操作指标包括临床操作步骤、时间效率和错误率;所述历史临床案例的表现参数包括操作步骤序列、操作时间、器械使用数据或生命体征监测数据;所述结果参数包括患者预后指标、并发症发生状态或操作成功率。
15、更进一步地,所述情境建模模块预设的多种临床情境,包括常规诊疗流程、突发危重症抢救和医患沟通场景,且三维培训模型支持情境的动态切换与难度分级选择。
16、更进一步地,所述特征提取模块中关键动作特征的提取过程,包括:
17、对图像采集设备捕获的连续图像序列进行降噪和增强处理,构建用户动作的三维骨骼模型;
18、基于三维骨骼模型,根据动作的起始、峰值和结束点,自动识别并提取描述该完整动作单元的一个或多个关键帧;
19、对关键帧中的三维骨骼模型进行计算,提取量化特征,所述量化特征包括:特定关节点的三维空间坐标、相邻关节之间的矢量角度、动作轨迹的平滑度、动作执行的周期时间或速度,以及双手或器械相对于虚拟解剖结构的标准方位距离;
20、将所述量化特征与临床操作的标准流程时序相结合,编码形成动作特征向量,作为表征用户动作形态、方位及时序的关键动作特征输出。
21、更进一步地,所述特征提取模块中关键语音特征的提取过程,包括:
22、对所述音频采集设备捕获的用户语音反馈进行降噪和增强处理,并采用自动语音识别技术将其转化为对应的文本序列;
23、对所述文本序列进行自然语言处理分析,提取深层语义特征,获取识别出的医学术语或标准沟通短语的准确性、所述术语与预设临床情境的关联度、陈述内容的逻辑完整性以及是否包含关键信息项;
24、对原始语音信号进行分析,提取副语言特征,副语言特征包括:语音的语调、响度、语速变化模式、是否存在不当的犹豫或中断,以及整体的情感倾向;
25、将所述文本序列、语义特征及副语言特征进行融合与向量化,形成语音特征向量,作为表征用户语音内容、逻辑及表达方式的关键语音特征输出。
26、更进一步地,所述智能评估模块中的状态识别模型采用深度q网络模型,以关键动作特征和关键语音特征共同构成的观测状态作为输入,输出为在当前观测状态下执行所有可能反馈动作所对应的预估价值,状态识别模型的构建过程,包括以下步骤:
27、步骤51:建立经验回放记忆库,用于存储由历史交互数据定义生成观测状态、采取的动作、获得的即时奖励和新的观测状态,构成的四元组训练样本;
28、步骤52:将当前培训周期中由特征提取模块提取的关键动作特征和关键语音特征,与预设情境下的目标状态特征进行比对,并将此特征差异向量,作为当前深度q网络模型的输入观测状态;
29、步骤53:初始化一个当前q网络和一个结构相同但参数延迟更新的目标q网络;
30、步骤54:使用从经验回放记忆库中随机采样的批次样本对当前q网络进行训练,通过计算目标q值与当前q网络输出值之间的时序差分误差作为损失函数,以最小化该损失为目标更新当前q网络的参数;目标q值计算过程为基于目标q网络对下一状态的最大预估价值与即时奖励之和;
31、步骤55:定期将当前q网络的参数复制给目标q网络;
32、步骤56:通过步骤52至步骤55的迭代训练,直至模型收敛。
33、更进一步地,所述偏差分析模块中动作方位或者幅度偏差的识别过程为:
34、基于情境建模模块中当前临床情境,提取预设的标准操作动作的三维空间坐标序列,形成动作模板;
35、通过交互感知模块中的图像采集设备捕获用户连续动作帧,采用骨骼跟踪或人体姿态估计算法,实时解算用户关键身体部位及器械的三维空间坐标;
36、将实时解析的用户坐标序列与动作模板进行逐帧或关键帧匹配,计算在三维空间中的方位偏差矢量、运动轨迹的相似度、关节角度的差异以及操作时序的延迟或超前;
37、当方位偏差矢量的模长、关节角度差异、轨迹相似度或时序差异度不符合预设阈值时,判定存在对应的方位偏差或幅度偏差。
38、更进一步地,所述偏差分析模块中语音内容的语义偏差的识别过程为:
39、对特征提取模块提取的语音文本,采用自然语言处理技术进行意图识别与实体抽取,生成用户语音的语义框架;
40、基于当前临床情境,调用预设的规范沟通脚本或关键信息清单,所述规范包括必需的病情告知要点、医学术语、指令清晰度及人文关怀用语;
41、将用户语义框架与规范标准进行比对,识别是否存在信息遗漏、术语误用、逻辑顺序错误或潜在歧义;
42、分析语音的副语言特征,包括语速、停顿、语气坚定度,并与针对该情境的理想表达模式进行比对,当语义逻辑存在错误或所述表达特征偏离理想模式超出允许范围时,判定存在语义偏差或规范性偏差。
43、更进一步地,所述纠错反馈模块生成的纠错图形标记是叠加于实时视频画面上的箭头、高亮框或虚拟骨骼线的纠正示意;生成的语音纠错标记是语音提示或正确的语音示例回放。
44、更进一步地,所述数据构建模块与情境建模模块通过无线网络交互连接,所述交互感知模块与情境建模模块、特征提取模块和智能评估模块通过无线网络交互连接,所述决策判断模块与智能评估模块和偏差分析模块通过无线网络交互连接,所述偏差分析模块与纠错反馈模块通过无线网络交互连接。
45、(三)有益效果
46、采用本发明提供的技术方案,与已知的现有技术相比,具有如下有益效果:
47、1、 通过构建状态识别模型,替代了传统依赖人为主观判断的评估模式,系统能实时采集学员的动作与语音数据,并即刻转化为可量化的合格系数与具体的偏差分析,极大减轻了导师负担,更确保了评估标准的客观一致性,使学员能够第一时间认识到错误细节,加速了正确技能模式的形成。
48、2、 通过三维建模与预设情境库,能够生成多样化的培训场景,从常规操作到极端危重病例均可模拟,打破了实体模拟设备在空间、时间和成本上的限制,培训内容可根据培训目标、学员层级进行动态选择和难度调整,实现了个性化训练,极大地提升了培训的真实感与学员的参与度,有效锻炼其在高压环境下的临床决策与应变能力。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com