
基于语义与声学韵律特征的认知障碍早期识别方法及系统
本发明属于认知障碍辅助筛查,具体涉及一种基于语义与声学韵律特征的认知障碍早期识别方法及系统。
背景技术:
1、轻度认知障碍是正常认知衰老向痴呆状态演进过程中的重要过渡状态之一,也是开展早期识别和早期干预的关键窗口期,其中部分患者可进一步发展为阿尔茨海默病等痴呆。现有轻度认知障碍和阿尔茨海默病的临床评估与诊断通常需要结合认知量表、神经心理学测验、脑脊液生化检查及脑成像检查等多种手段综合完成,普遍存在流程复杂、成本较高、部分检查具有侵入性、对专业医疗资源依赖程度高以及难以面向大规模人群开展早期筛查等问题。
2、已有研究表明,在记忆力等核心认知功能出现明显下降之前,认知受损个体往往已经在语言表达层面表现出细微异常,例如词汇检索困难、语义内容贫乏、主题延续性下降、叙事逻辑组织减弱、病理性停顿增多及语速下降等。尤其是在连续叙事任务中,认知受损个体的异常不仅体现在局部词汇选择和单句表达上,还体现在随着叙事推进逐步显现的时序性退化,例如主题推进能力减弱、前后内容衔接异常以及叙事链条中断等。
3、随着人口老龄化趋势的加剧,阿尔茨海默病等痴呆症的早期筛查已成为重要的公共卫生需求。研究表明,认知功能退化在临床前期和轻度认知障碍阶段即可在语言行为中表现出可检测的异常特征,因此基于语音和语言分析的认知功能评估方法逐渐成为一种具有应用前景的非侵入式筛查途径。
4、然而,目前基于语音和语言特征的痴呆症早期评估技术虽然已显示出一定应用价值,但在任务设计、特征建模和多模态融合方面仍存在明显不足,主要体现在以下几个方面:
5、(1)现有任务范式对连续叙事能力的激发不足。现有方法中较常见的语音采集任务包括单幅图片描述、语义流利性测试、词语命名或自由对话等。此类任务多属于静态、局部或短时语言任务,难以同时激发事件顺序组织、上下文衔接、主题延续、跨段整合等更高层次的认知功能。由于所获取的语音数据不具备完整的事件推进顺序和上下文衔接关系,后续分析模型缺乏对叙事时序退化模式进行建模的数据基础。
6、(2)现有文本特征建模方法对叙事时序异常的刻画不足。现有方法通常采用预训练语言模型对转录文本进行上下文语义编码,虽然能够捕捉语义贫乏、命名困难等局部语义偏差信息,但对完整叙事过程中的顺序依赖关系、主题延续关系和长程时序关系的建模能力有限。仅依赖上下文语义编码而不引入专门的时序建模机制,难以有效捕捉主题延续性下降、叙事链条中断、语义内容回退等随叙事动态演变的异常特征。此外,现有方法在将变长文本序列转化为定长特征表示时,通常采用cls标记提取或平均池化等方式,未充分考虑不同文本片段对认知筛查的贡献差异,导致与诊断高度相关的关键语言片段在最终特征表示中的权重不足。
7、(3)现有声学特征提取方法对病理性韵律异常的表征粒度不足。 第一类方法采用端到端预训练声学模型直接从原始音频中提取深层嵌入向量,此类方法所生成的声学嵌入为高维黑盒表示,缺乏与认知退化行为表现之间的明确对应关系,导致模型的可解释性和临床可审查性不足。第二类方法提取语速、平均停顿时长等传统声学统计量,此类特征虽具有可解释性,但在停顿特征的表征粒度上仍然不足。现有方法通常仅统计停顿总次数和平均时长等粗粒度总量指标,未对停顿时长的区间分布进行分层统计。然而,较短停顿通常与正常语言组织相关,而较长停顿更可能对应词汇检索失败或语义记忆提取困难等病理性认知过程,缺乏停顿时长区间的分层统计使得现有方法难以区分正常停顿与病理性停顿。
8、(4)现有多模态融合方式难以建模语义内容与声学韵律之间的映射关系。部分现有方法将文本特征和语音特征进行简单拼接后输入分类器,完全忽略了语义内容与声学韵律之间的逻辑关联。另一部分方法在拼接特征的基础上引入注意力机制,但由于查询和键值均来源于同一拼接特征空间,注意力计算缺乏明确的跨模态引导方向,无法显式建立从语义内容到声学韵律的定向检索关系。
9、然而在认知障碍筛查中,文本内容反映受测人员试图表达的目标语义,而停顿、语速和构音效率等声学韵律特征反映其实现该语义表达时的认知负荷和执行代价。因此,应当以语义内容为基准,定向检索与之关联的声学韵律异常。现有融合方式由于缺乏这种语义引导的定向检索机制,难以有效捕捉对早期认知障碍具有识别意义的隐性跨模态特征。
技术实现思路
1、有鉴于此,本发明提供一种基于语义与声学韵律特征的认知障碍早期识别方法及系统。
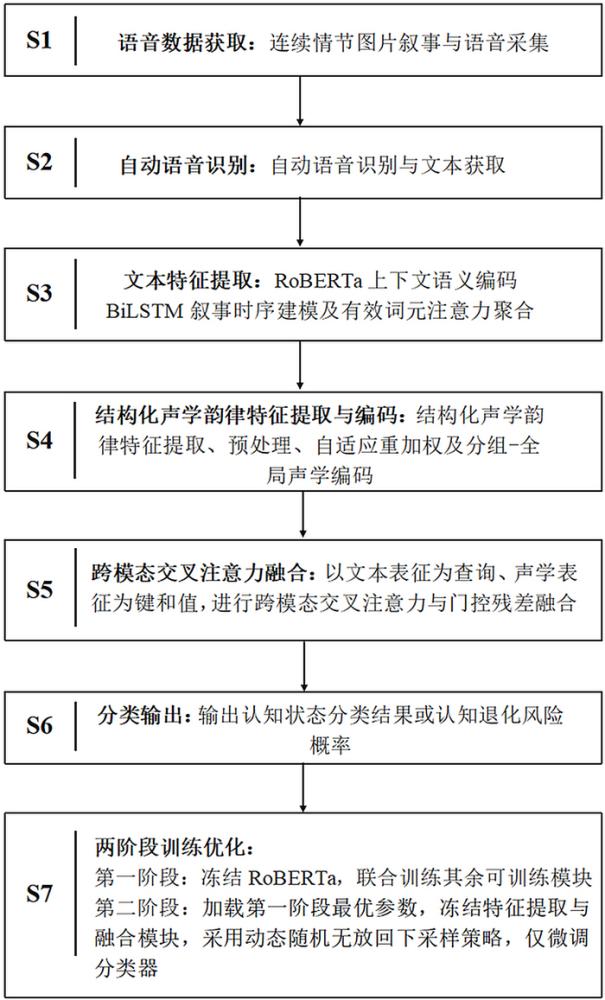
2、本发明采用如下技术方案:一种基于语义与声学韵律特征的认知障碍早期识别方法,包括以下步骤:
3、步骤s1:向受测人员呈现具有连续情节关系的图片序列,引导受测人员基于所述图片序列进行故事叙述,获取受测人员形成的语音数据;
4、步骤s2:对所述语音数据执行自动语音识别,得到与所述语音数据对应的文本数据,并根据需要对识别结果进行人工校正;
5、步骤s3:采用预训练语言模型进行上下文语义编码,利用双向时序建模网络进行叙事时序建模,并通过基于有效词元的注意力加权聚合及投影处理得到文本全局语义向量;
6、步骤s4:识别语音区间和停顿区间,提取结构化声学韵律特征;对至少部分非负偏态特征进行对数变换,基于训练样本统计参数按特征维度进行标准化及自适应重加权,按照声学韵律属性构建分组声学表征,并根据全部结构化声学韵律特征构建全局声学表征;
7、步骤s5:以所述文本全局语义向量作为查询向量,以所述分组声学表征和全局声学表征作为键向量和值向量进行跨模态交叉注意力计算,并通过门控残差融合得到多模态特征;
8、步骤s6:将融合后的多模态特征输入分类器,输出所述受测人员的认知状态分类结果或认知退化风险概率;
9、步骤s7:采用两阶段训练策略,第一阶段冻结预训练语言模型并采用带标签平滑的交叉熵损失联合训练其余可训练模块;第二阶段严格复用第一阶段各折的数据划分、特征顺序和标准化参数,加载相应折的第一阶段最优模型,冻结分类器以外的参数,并采用动态随机无放回下采样策略,在每轮训练中保留全部少数类样本,从多数类中随机抽取预设数量的样本,使用交叉熵损失微调分类器。
10、具体的,所述步骤s1中,所述图片序列包括具有事件推进顺序和情节因果关系的连续情节图片,所述语音数据来源于受测人员对所述图片序列所构成完整故事情节的连续叙述。
11、具体的,所述步骤s3具体包括:
12、采用预训练模型对所述文本数据进行上下文语义编码,得到上下文隐藏状态矩阵,表示第个词元对应的上下文语义向量,表示文本序列中的词元数量;
13、采用双向长短期记忆网络(bilstm)对所述隐藏状态矩阵进行叙事时序建模,将前向和后向隐藏状态拼接得到文本序列表示;
14、对所述文本序列表示h执行掩码注意力池化,屏蔽补齐位置并对有效位置进行加权求和,再经投影处理得到文本全局语义向量。
15、具体的,所述预训练语言模型为roberta模型,且在第一阶段训练中冻结其参数;所述bilstm在roberta输出的上下文语义编码基础上提取双向顺序依赖关系,用于表征主题延续性下降、叙事链条中断和内容回退等动态时序异常。
16、具体的,所述步骤s4中的结构化声学韵律特征包括:音频总时长、净言语时长、停顿总次数、停顿总时长、平均停顿时长、单位时间停顿频次、停顿时长占比、音节总数、音节速率、构音速率、六个预设停顿时长区间各自对应的停顿次数,以及三个停顿组成比例。
17、具体的,所述六个预设停顿时长区间包括小于0.5秒、0.5秒至1秒、1秒至2秒、2秒至3秒、3秒至4秒以及4秒及以上六个区间,并根据各区间停顿次数和停顿总次数计算0至2秒、2至3秒及3秒及以上停顿的组成比例。
18、具体的,所述步骤s4通过声学特征门控网络对标准化后的结构化声学韵律特征进行自适应重加权,并分别编码时长特征组、总体停顿特征组、语言输出与语速特征组、细粒度停顿次数特征组和停顿组成比例特征组,同时将全部结构化声学韵律特征编码为全局声学表征。
19、具体的,所述步骤s5将文本全局语义向量作为查询来源,将分组声学表征和全局声学表征组成的声学表征矩阵作为键和值来源对于第个注意力头,其中=1...n,通过下式计算融合特征:
20、;
21、;
22、;
23、;
24、;
25、其中,、、分别为第个注意力头可学习的线性映射矩阵,为注意力子空间维度,为第个注意力头计算得到的注意力权重,为第个注意力头的交叉注意力输出;
26、进一步地,将个注意力头的输出进行拼接,并通过输出映射矩阵得到多头交叉注意力融合结果:
27、;
28、其中,concat为经跨模态交叉注意力获得的声学上下文向量,并计算门控向量:
29、;
30、.
31、其中,[;]表示向量拼接,⊙表示逐元素乘法,为多模态融合特征;所述门控残差融合在保留文本判别信息的同时,自适应控制声学上下文特征的贡献。当前实施例采用一个注意力头,以降低低维结构化特征和小样本条件下的模型复杂度。
32、具体的,所述步骤s7采用两阶段训练策略。第一阶段冻结roberta参数,采用带标签平滑的交叉熵损失,训练bilstm、基于有效词元的注意力聚合与文本投影、声学特征自适应重加权、分组-全局声学编码、跨模态交叉注意力、门控残差融合及分类模块;第二阶段严格复用第一阶段各折保存的训练样本与验证样本标识、特征顺序和标准化参数,加载相应折的第一阶段最优模型参数,冻结分类器以外的全部参数,不重新初始化分类器,采用动态随机无放回下采样策略和交叉熵损失仅微调分类器。
33、第二阶段在每个训练轮次保留全部少数类样本,并按照一定的比例从多数类样本中无放回随机抽取子集。第二阶段未改善综合性能或类别均衡性时保留第一阶段模型。
34、本发明还提供一种基于语义与声学韵律特征的认知障碍早期识别系统,包括:
35、语音数据获取及自动语音识别模块,用于向受测人员呈现具有连续情节关系的图片序列,引导受测人员基于所述图片序列进行故事叙述,采集受测人员叙述过程中的语音数据,并对所述语音数据执行自动语音识别得到对应的文本数据;
36、文本特征提取模块,用于对所述文本数据进行上下文语义编码提取文本隐藏表示,对所述文本隐藏表示进行叙事时序建模提取故事叙述过程中的顺序依赖关系、主题延续关系和长程时序关系,并通过掩码注意力池化进行加权聚合得到文本全局语义向量;
37、结构化声学韵律特征提取与编码模块,用于识别语音区间和停顿区间,提取结构化声学韵律特征,对至少部分非负偏态特征进行对数变换,基于训练样本统计参数按特征维度进行标准化和自适应重加权,并构建分组声学表征和全局声学表征;
38、跨模态交叉注意力融合模块,用于以文本全局语义向量为查询、以分组声学表征和全局声学表征为键和值,获取声学上下文特征并通过门控残差方式得到多模态融合特征;
39、分类输出模块,用于将所述融合后的多模态特征输入分类器,输出所述受测人员的认知状态分类结果或认知退化风险概率;
40、训练优化模块,用于执行两阶段训练,第一阶段冻结预训练语言模型并联合训练其余可训练模块;第二阶段严格复用第一阶段各折的数据划分、特征顺序和标准化参数,加载第一阶段最优参数,冻结分类器以外的参数,不重新初始化分类器,采用动态随机无放回下采样策略和交叉熵损失仅微调分类器。
41、本发明的有益效果:
42、与现有技术相比,本发明展现出如下突出优势:
43、(1)本发明采用连续故事叙事任务作为数据采集与评估基础,与单幅图片描述、简短问答或静态语言任务相比,连续叙事任务能够在较长时间跨度内诱发受测人员进行连贯表达,更充分地反映其事件组织、语义衔接和主题维持能力,从而更容易暴露轻度认知损害阶段在叙事连贯性和信息整合能力方面的细微异常。因此,本发明能够获取更接近自然交流场景、时间结构更完整的叙事样本,有利于提高早期认知退化相关语言线索的可观测性。
44、(2)本发明通过连续故事叙事任务同步采集语音及对应文本,使受测人员在完成语言表达时同时暴露词汇提取、语义组织、主题延续、上下文衔接和故事组织能力,因而能够获得比单一静态语言任务更丰富的早期认知退化线索。
45、(3)本发明在文本分支中采用roberta与bilstm的级联建模方式,在上下文语义编码基础上进一步刻画叙事展开过程中的双向顺序依赖关系、主题延续关系和逻辑组织能力,有利于识别语义断裂、内容回退、重复和故事结构松散等动态异常。
46、(4)本发明在声学分支中显式提取具有行为学解释意义的结构化声学韵律特征,包括停顿总次数、停顿总时长、平均停顿时长、单位时间停顿频次、停顿时长占比、音节总数、音节速率、构音速率、多个停顿时长区间对应的停顿次数及停顿组成比例,从而细粒度刻画认知受损人员在表达流利性和词汇检索过程中的异常表现。
47、(5)本发明将结构化声学韵律特征进行自适应门控和语义分组编码,并同时构建覆盖全部声学特征的全局表征;以文本全局语义向量作为查询,对分组声学表征和全局声学表征进行交叉注意力检索,再通过门控残差方式完成融合,从而在保留文本判别信息的同时,自适应引入与当前叙事语义相关的声学韵律信息。
48、(6)本发明采用两阶段训练策略:第一阶段学习稳定的多模态表征,第二阶段严格复用第一阶段各折的数据划分和预处理参数,冻结分类器以外的参数,仅通过动态多数类下采样和交叉熵微调原分类器;每个训练轮次保留全部少数类且不进行重复扩增,并无放回抽取不同多数类子集,有利于缓解多数类偏置并降低少数类过拟合风险。
49、综上,本发明通过连续故事叙事任务设计、roberta与bilstm联合文本建模、可解释结构化声学韵律特征提取、分组与全局声学表征构建、文本引导的交叉注意力及门控残差融合,以及严格复用第一阶段表征并动态调整分类边界的第二阶段训练,提高了认知障碍早期辅助识别的稳定性、可解释性和类别均衡性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com