
一种单片机机器人的语音交互方法及存储介质
本申请属于语音识别的,尤其涉及一种单片机机器人的语音交互方法及存储介质。
背景技术:
1、随着智能家居与服务机器人的普及,语音交互已成为人机交互中最自然、最重要的方式之一。单片机机器人因其低成本、低功耗和高集成度等优势,在消费级和教育级机器人市场中占据主导地位。
2、目前,在老年人的应用场景中,针对此类资源受限设备的语音交互技术主要分为纯云端依赖的语音交互方案、传统的本地关键词检索与固定模板匹配方案、基于字典树的轻量级语义解析方案等。纯云端依赖的语音交互方案严重依赖网络连接,存在显著的延迟,在网络不佳或无网环境下完全瘫痪,且用户语音数据上传至云端存在隐私泄露风险。传统的本地关键词检索与固定模板匹配方案对发音人的口音、语速极其敏感,缺乏灵活性和泛化能力。基于字典树的轻量级语义解析方案虽然查找效率高,但其内存占用往往超出单片机的承受范围,且未考虑指令执行层面的物理延迟。
3、因此,急需一种单片机机器人的语音交互方法及存储介质。
技术实现思路
1、针对现有技术存在的单片机资源受限下语义解析效率低、语音模型无法自适应个性化发音以及语音指令与物理动作执行时延不同步的问题,本申请通过一种面向单片机机器人的语音交互方法,利用双数组字典树实现高效语义解析,结合本地模型增量更新与反向动力学补偿,实现了高准确率、低延迟且个性化的语音交互体验。
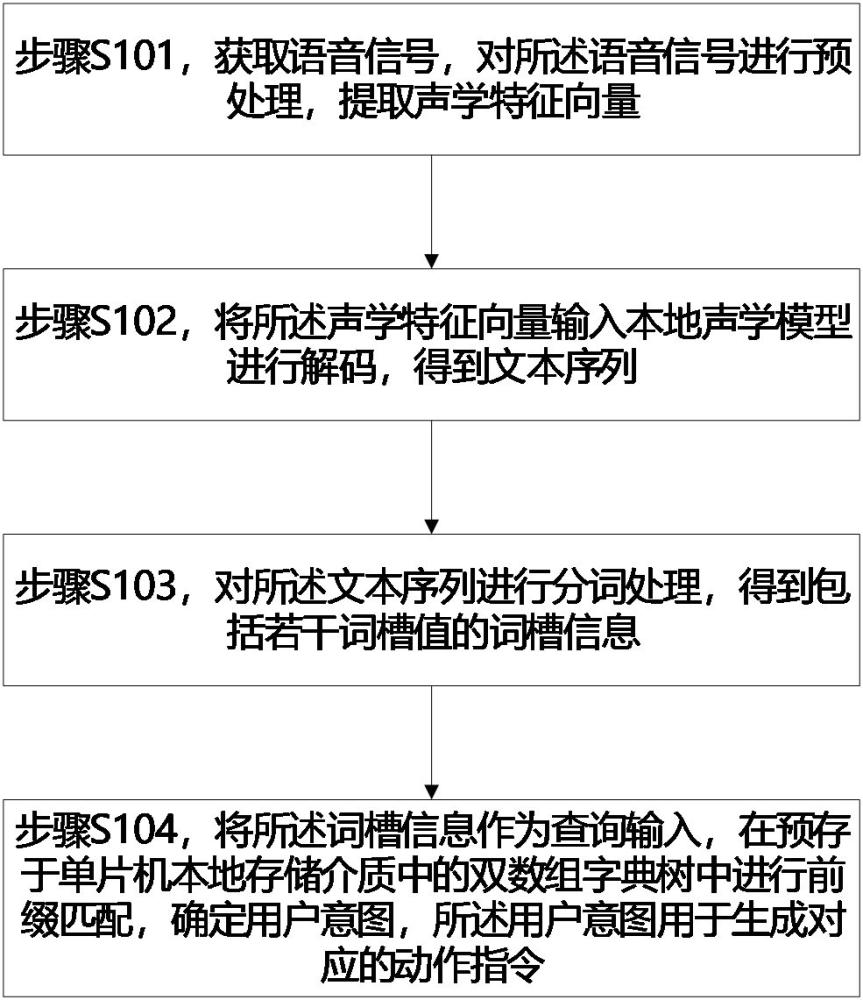
2、本申请的第一方面提出了一种面向单片机机器人的语音交互方法,包括:
3、获取语音信号,对所述语音信号进行预处理,提取声学特征向量;
4、将所述声学特征向量输入本地声学模型进行解码,得到文本序列;
5、对所述文本序列进行分词处理,得到包括若干词槽值的词槽信息;
6、将所述词槽信息作为查询输入,在预存于单片机本地存储介质中的双数组字典树中进行前缀匹配,确定用户意图,所述用户意图用于生成对应的动作指令;
7、其中,所述双数组字典树由第一数组和第二数组构成,所述第一数组用于记录状态转移的基地址偏移量,所述第二数组用于记录转移目标状态的父节点校验信息,所述第一数组与第二数组协同形成连续的线性存储结构,以将字典树的树形节点关系压缩编码为数组索引关系。
8、上述方案通过双数组字典树的第一数组和第二数组协同形成连续的线性存储结构,将字典树的树形节点关系压缩编码为数组索引关系,实现了字典树的高密度压缩和无回溯的前缀匹配,减少了单片机内存的动态申请,解决了单片机资源受限下的高效语义理解与意图识别问题。用声学模型解码,声学模型天然具备一定的泛化能力,比固定模板对口音、语速的容忍度更高,灵活性和泛化能力更好。
9、优选地,所述对所述语音信号进行预处理,提取声学特征向量,包括:
10、对所述语音信号进行语音活动检测,切分出有效语音信号段;
11、对所述有效语音信号段进行频域变换,提取声学特征向量。
12、上述方案通过语音活动检测精准切分有效语音信号段,剔除了静音和背景噪声,提高了特征提取的准确性。
13、优选地,所述对所述有效语音信号段进行频域变换,提取声学特征向量,包括:
14、对所述有效语音信号段施加窗函数处理后进行快速傅里叶变换,提取梅尔频率倒谱系数特征向量或感知线性预测特征向量。
15、上述方案通过提取梅尔频率倒谱系数特征向量或感知线性预测特征向量,提供了符合单片机算力限制的声学特征。
16、优选地,所述将所述声学特征向量输入本地声学模型进行解码,得到文本序列,包括:
17、将所述声学特征向量输入隐马尔可夫模型-高斯混合模型声学模型,通过维特比算法搜索最优状态序列,输出音素概率分布,并基于所述音素概率分布转换为文本序列。
18、上述方案采用隐马尔可夫模型-高斯混合模型声学模型,计算复杂度低,适合单片机的定点运算。
19、优选地,所述确定用户意图,包括:
20、查找每个词槽值对应的意图集合;取所有词槽值对应的意图集合的交集,作为最终确定的用户意图。
21、上述方案通过交集验证法消除了意图歧义,提高了意图识别的准确性。
22、优选地,所述方法还包括:
23、将所述动作指令存入指令执行队列, 实时监测所述指令执行队列的队列深度;
24、当所述队列深度降至预设值时,触发中断服务程序;
25、在所述中断服务程序中,根据当前电机的运行状态生成反向制动信号。
26、上述方案通过监测指令执行队列的队列深度并在队列深度降至预设值时触发中断服务程序,实现了对动作执行进度的精准预判,从而在动作即将结束前提前注入反向制动信号,有效消除了电机惯性带来的过冲现象,使得语音控制与机器人动作高度同步。
27、优选地,所述根据当前电机的运行状态生成反向制动信号,包括:
28、获取当前电机的转速和负载惯量;查询预设的补偿映射表,确定其对应的补偿参数;
29、根据所述补偿参数生成反向pwm脉冲,并将所述反向pwm脉冲注入所述单片机机器人的电机驱动电路。
30、上述方案通过查询预设的补偿映射表,实现了精准的反向动力学补偿。
31、优选地,所述方法还包括:
32、计算验证通过的同一用户意图对应的有效语音样本的数量;
33、当所述有效语音样本数量达到预设阈值时,触发对所述本地声学模型的参数增量更新操作。
34、上述方案通过计算有效语音样本数量并在达到预设阈值时触发模型增量更新,保证了模型更新的可靠性,实现了模型对用户发音习惯的自适应学习。
35、优选地,所述触发对所述本地声学模型的参数增量更新操作,包括:
36、提取所述有效语音样本的声学特征向量;
37、基于聚类算法计算新的模型参数,并采用滑动平均法更新所述本地声学模型中的高斯分量参数;
38、利用更新后的本地声学模型对历史样本进行交叉验证,计算识别置信度;
39、当所述识别置信度超过设定阈值时,将更新后的模型参数固化存储。
40、上述方案通过交叉验证与置信度校验,确保了模型参数更新的有效性。
41、本申请的第二方面提出了一种计算机可读存储介质,存储有计算机程序,所述计算机程序被执行时实现如第一方面中任一项所述的语音交互方法。
1.一种面向单片机机器人的语音交互方法,其特征在于,包括:
2.根据权利要求1所述的语音交互方法,其特征在于,所述对所述语音信号进行预处理,提取声学特征向量,包括:
3.根据权利要求2所述的语音交互方法,其特征在于,所述对所述有效语音信号段进行频域变换,提取声学特征向量,包括:
4.根据权利要求1所述的语音交互方法,其特征在于,所述将所述声学特征向量输入本地声学模型进行解码,得到文本序列,包括:
5.根据权利要求1所述的语音交互方法,其特征在于,所述确定用户意图,包括:
6.根据权利要求1所述的语音交互方法,其特征在于,所述方法还包括:
7.根据权利要求6所述的语音交互方法,其特征在于,所述根据当前电机的运行状态生成反向制动信号,包括:
8.根据权利要求1所述的语音交互方法,其特征在于,所述方法还包括:
9.根据权利要求8所述的语音交互方法,其特征在于,所述触发对所述本地声学模型的参数增量更新操作,包括:
10.一种计算机可读存储介质,其特征在于,存储有计算机程序,所述计算机程序被执行时实现如权利要求1至9中任一项所述的语音交互方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com