
基于双特征拼接图注意力网络的匿名说话人语音溯源方法
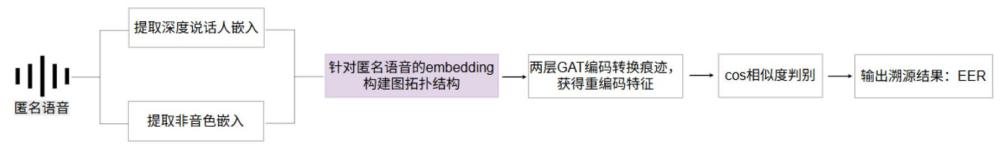
本发明涉及语音信号处理、自动说话人验证和图神经网络,具体涉及一种基于双特征拼接图注意力网络的匿名说话人语音溯源方法。
背景技术:
1、说话人匿名化技术通过改变语音中的身份相关信息,使处理后的语音难以被常规自动说话人验证系统识别,从而保护原始说话人的隐私。匿名化方法可以采用说话人嵌入替换、声学特征扰动、语音转换、神经声码器重合成等方式。经过匿名化处理后,语音内容通常仍然可以被理解,但原始说话人的声纹信息会发生不同程度的变化。
2、在授权取证、匿名系统安全评估、语音数据泄露追踪和模型滥用检测等场景中,需要从匿名语音中判断其源说话人身份。该任务与面向干净语音的常规说话人验证不同,匿名化处理会使特征分布发生偏移,同一源说话人的不同匿名语音可能出现较大的类内差异,不同源说话人的匿名语音也可能被映射到相近区域,从而导致验证性能下降。
3、现有方法通常直接使用单一路说话人嵌入进行余弦相似度计算。单一嵌入能够保留部分源身份信息,但其表示容易受到匿名化算法、重合成声码器和传输压缩的影响。为了获得更稳定的匿名语音表示,可以从同一语音中提取由不同模型产生的多路嵌入,使不同表示空间中的信息在一定程度上形成互补。
4、常见多特征融合方法包括加权求和、门控融合、注意力融合和特征投影等。这些方法需要设置额外参数或增加训练模块,在样本数量有限或者匿名化条件变化较大时,可能增加优化难度。本发明采用更直接的处理方式:分别归一化深度说话人嵌入和非音色嵌入,然后在特征维度进行直接拼接,不引入额外的可学习融合结构。
5、图注意力网络能够将每条匿名语音作为图节点,并根据节点之间的相似关系聚合邻域信息。与仅对单条语音嵌入进行独立评分相比,图注意力网络可以利用多个相关语音节点之间的关系更新节点表示。因此,需要一种结构简单、实现明确的匿名说话人语音溯源方法,将两路特征直接拼接形成节点输入,再利用图注意力网络学习适合匿名语音身份匹配的溯源嵌入。
技术实现思路
1、发明目的:为了克服匿名语音条件下单一说话人特征容易发生分布偏移、直接余弦评分性能有限以及复杂特征融合结构实现成本较高等问题,本发明提出一种基于图注意力机制联合深度嵌入的匿名源说话人溯源方法。该方法分别提取深度说话人嵌入和非音色嵌入,对两路特征进行归一化后拼接融合,记为联合特征表示,通过图注意力机制聚合联合嵌入领域关系,如此提取联合深度说话人表征,从而获得更适用于匿名说话人身份匹配的溯源嵌入。
2、本发明主要用于匿名变声、语音重合成、声纹脱敏以及网络压缩等条件下的源说话人身份识别与身份匹配。本发明涉及语音信号处理、自动说话人验证和图神经网络技术领域。匿名化处理会改变语音中的说话人身份信息,使传统自动说话人验证模型产生明显的特征偏移,导致同一源说话人的匿名语音之间相似度降低,其等错误率升高。为解决上述问题,本发明利用voiceprivacy比赛的基线5的系统对原始语音进行匿名,然后从同一匿名语音中分别提取深度说话人嵌入和非音色嵌入,对两路特征分别进行归一化后拼接融合,记为联合特征表示。其中深度说话人嵌入采用vpc2026的asv模型提取,对匿名语音中的残留声纹身份信息进行建模以提取,表征说话人可区分性的深度声纹嵌入。非音色嵌入采用orange/speaker-wavlm-pro模型中的wnta128分支提取,其目标是提取与说话人相关包括韵律、节奏、重音、语调变化及口音等非音色线索。由此,深度说话人嵌入与非音色嵌入分别从声纹身份判别空间和非音色残留空间对同一匿名语音进行互补表征。随后,为捕捉联合特征之间的相似关系,本发明通过图注意力机制聚合联合嵌入领域关系,如此提取联合深度说话人表征,以聚类同一说话人嵌入。此外,训练阶段采用加性角间隔softmax损失和监督式对比损失进行联合优化;推理阶段计算注册语音与待测匿名语音溯源嵌入之间的余弦相似度,并根据验证阈值完成同源或异源判定。本发明利用图注意力机制建模深度说话人嵌入和非音色嵌入,以充分利用身份残留线索与非音色线索的互补性,提高匿名语音条件下源说话人特征的判别能力和溯源准确率。
3、技术方案:1、一种基于图注意力机制联合深度嵌入的匿名源说话人溯源方法,其特征在于,从匿名语音中分别提取深度说话人嵌入和非音色嵌入,将两路特征分别归一化后拼接融合,记为联合特征表示,通过图注意力机制聚合联合嵌入领域关系,如此提取联合深度说话人表征,所述方法包括以下步骤:
4、(1.1)匿名语音预处理。获取vpc比赛b5系统匿名后的匿名语音样本及训练阶段对应的源说话人标签,对匿名语音进行单通道化、采样率统一和长度处理,使其满足两路特征提取模型的输入要求。
5、(1.2)深度说话人嵌入提取。将预处理后的匿名语音输入vpc2026自动说话人验证模型,获得用于描述匿名语音中源说话人身份残留信息的深度说话人嵌入。
6、,
7、其中,yᵢ表示第i条匿名语音,aᵢ表示深度说话人嵌入。
8、(1.3)非音色嵌入提取。将预处理后的匿名语音输入wavlm大模型派生的wnta128模型,获得主要表征韵律、口音及说话习惯等非音色属性的非音色嵌入。
9、,
10、其中,yᵢ表示第i条匿名语音,wᵢ表示非音色嵌入。
11、(1.4)图节点特征构建。每条匿名语音作为一个图节点,将每条语音的深度说话人嵌入和非音色嵌入分别进行l2归一化后,在特征维度拼接,作为图节点的特征。
12、,
13、其中,xᵢ表示两路特征直接拼接得到的联合节点特征。
14、(1.5)图注意力网络构建。以每条匿名语音为节点,根据深度说话人嵌入建立余弦距离近邻图。为减少单向近邻和偶然高相似度造成的错误边,只保留互为近邻的节点对,利用非音色嵌入生成门控系数gij。最终边权定义为:
15、,
16、其中saij表示节点间的深度说话人嵌入余弦相似度,当wij小于最小边权阈值时删除该边;
17、(1.6)图注意力编码。构建两层gatv2网络。第一层采用多头注意力完成邻域特征聚合,随后进行批归一化、elu激活和dropout;第二层输出固定维度的说话人节点嵌入:
18、,
19、其中,x表示联合节点特征矩阵,e表示图边集合,z表示图注意力网络输出的溯源嵌入矩阵。
20、(1.7)模型训练。使用匿名语音对应的源说话人标签监督图注意力网络训练,采用加性角间隔softmax损失增强不同说话人的类别间隔,并采用监督式对比损失约束同一源说话人的嵌入相互接近。由于完整数据图的节点数和边数较大,直接进行全图训练会带来较高的显存和计算开销,采用局部子图训练方式:每个训练步骤随机选择若干说话人,并从每名说话人中抽取固定数量的语音构建局部图,保证每个子图中同时包含多个正样本和负样本,有利于aam-softmax和监督对比损失的联合优化。采用损失函数如下:
21、,
22、其中,l(aam)表示加性角间隔softmax损失,l(supcon)表示监督式对比损失,表示对应损失的权重。
23、(1.8)匿名说话人溯源推理。将注册语音和待测匿名语音按照步骤(1.1)至步骤(1.4)处理,获得相应的溯源嵌入,并计算二者之间的余弦相似度。
24、,
25、其中,ze表示注册语音嵌入,zt表示待测匿名语音嵌入;当相似度高于预设阈值时判定为同一源说话人,否则判定为不同源说话人。
26、相对于现有技术,本发明的有益效果是:通过联合利用匿名语音中的深度说话人嵌入和非音色嵌入,对身份残留信息及韵律、口音和说话习惯等互补线索进行表征,并结合互为近邻约束、非音色特征门控和图注意力机制聚合语音节点间的关联信息,从而减小匿名化处理造成的特征偏移和同源语音类内差异,提高匿名语音条件下源说话人特征的判别能力和溯源准确性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com