
基于视频模型的心脏超声标准切面自主获取方法及系统与流程
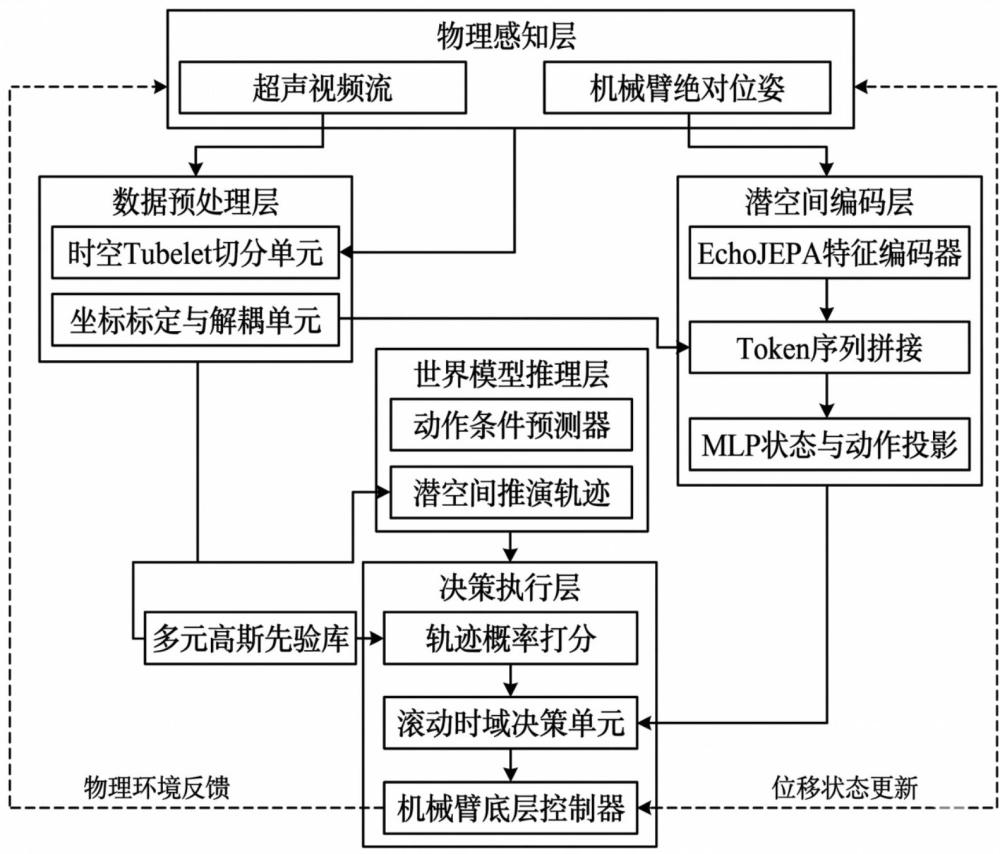
本发明属于图像处理,更具体地,涉及一种基于视频模型的心脏超声标准切面自主获取方法及系统。
背景技术:
1、心脏超声是临床诊断心血管疾病、评估心脏功能的首选无创影像学手段。在临床扫查过程中,获取标准切面是进行各项功能量化分析的前提。然而,高质量标准切面的获取极度依赖超声医师对复杂心脏空间解剖结构的理解以及精细的手眼协调能力。由于心脏在胸腔内的动态收缩、呼吸运动的干扰以及透声窗的受限,导致探头寻迹的学习曲线极长。为了解决这一问题,利用协作机器人辅助或代替人工进行扫查的自主超声扫查系统已成为行业研究的热点,旨在通过自动化控制实现扫查过程的标准化。
2、目前,已有专利公开了多种提升超声自主扫查效果的方法。例如,专利文献cn121882091a公开了一种用于心脏超声机器人动作轨迹规划的影像处理方法,其通过差分注意力机制提取单帧超声影像的空间判别特征,并直接映射为控制机器人的关节扭矩序列以生成动作轨迹。此外,专利文献cn121817960a公开了一种胸骨旁短轴切面扫查方法,其通过显式分割左心室轮廓并进行椭圆拟合来计算探头位姿偏移量,同时基于灰度变化提取心动周期以辅助探头姿态的调整。这些技术通过引入视觉注意力机制与显式的轮廓几何计算,在一定程度上降低了机器人扫查对专家经验的依赖,推动了超声机器人系统的自主化进程。
3、然而,对上述背景技术进行客观评价,现有方案在动态、复杂临床环境下仍存在显著不足。首先,多数视觉特征提取方法仍主要基于单帧图像进行空间特征感知,缺乏对内蕴时空动力学规律的建模,在面对快速跳动的心脏时难以彻底解决心动周期带来的时间歧义性问题;其次,现有技术在处理低信噪比、斑点噪声严重的超声流时鲁棒性较差,极易出现动作闪烁;最关键的是,传统的视觉伺服控制往往依赖于端到端的像素级预测或显式的图像轮廓提取,此类方法不仅极易受声影遮挡的干扰而导致目标丢失,这限制了现有技术在多变临床场景中的普及应用。
技术实现思路
1、针对现有技术的以上缺陷或改进需求,本发明提供了一种基于视频模型的心脏超声标准切面自主获取方法及系统,其通过力-视觉多模态反馈判定探头与皮肤的首次接触,建立局部任务坐标系以消除环境域偏置;随后利用预训练的视频基础模型对实时视频流执行原生3d时空管道化特征提取,并结合多层感知机将物理位姿与动作增量投影为统一的token序列。在控制阶段,利用训练完成的动作条件预测器在潜空间内执行自回归推演,无需进行像素级图像解码即可预测未来时域的解剖特征演变,并结合高斯解剖学先验对候选轨迹进行实时概率密度打分。最后,依据滚动时域策略输出最优动作指令驱动机械臂闭环运行,从而显著提升了系统在复杂临床环境下获取心脏超声标准切面图像的实时性、鲁棒性与泛化能力。
2、为实现上述目的,按照本发明的一个方面,提出了一种基于视频模型的心脏超声标准切面自主获取方法,包括以下步骤:
3、步骤一,获取超声视频流以及与所述超声视频流同步对齐的探头位姿数据,基于扫查起始时刻的探头位姿建立局部任务坐标系,将所述探头位姿数据转化为所述局部任务坐标系下的相对位姿,并计算相邻时间步之间的动作增量,以进行空间位姿解耦;
4、步骤二,将所述超声视频流映射为潜在特征空间内的时间切片特征序列,并将所述相对位姿与所述动作增量经特征投影后与对应时刻的所述时间切片特征融合,构建多模态特征序列;
5、步骤三,针对候选动作序列,利用预先训练的动作条件预测模型,基于当前控制步的所述多模态特征序列在潜在特征空间内进行自回归推演,生成未来预测时刻的推演特征;
6、步骤四,计算所述推演特征与预构建的目标先验分布模型之间的匹配评分,其中所述目标先验分布模型用于表征超声标准切面的解剖特征分布规律,根据所述匹配评分选取最优动作序列,并依据滚动时域控制策略执行动作指令,驱动探头获取心脏超声标准切面。
7、作为进一步优选的,步骤一包括以下步骤:
8、执行离线手眼标定以确定超声探头接触面相对于机械臂末端法兰坐标系的静态变换矩阵;
9、在线扫查过程中,获取包含连续帧图像的3d视频流,并实时获取机器人基座坐标系下的法兰位姿矩阵;
10、利用齐次变换矩阵乘法,计算出当前时刻t探头工具中心点在基座坐标系下的绝对位姿;
11、定义探头首次与患者皮肤表面产生有效声学接触的瞬时为扫查起始时刻,记录该瞬时的绝对位姿,并将其定义为本次扫查任务的局部任务坐标系原点,即,在后续的每一时间步t,计算当前探头位姿相对于局部任务坐标系原点的相对位姿状态;
12、定义相邻两个时间切片之间的相对位姿变换为动作增量,设当前时间切片对应的物理时刻为t,下一时间切片对应的物理时刻为,则所述动作增量的计算公式为:,其中,表示将齐次变换矩阵映射为向量形式。
13、作为进一步优选的,所述绝对位姿的计算公式为:
14、所述相对位姿状态的计算公式为:。
15、作为进一步优选的,步骤二具体包括:
16、接收长度为的超声视频序列张量,其中,c、h、w分别代表图像通道数、高度与宽度,采用预训练且参数冻结的视频基础模型作为骨干编码器,将所述超声视频序列张量沿时间和空间维度进行三维网格化切割,生成一系列时间深度为帧的时空数据块,经过所述骨干编码器的前向传播处理,将连续的视频流在潜在特征空间中离散化为特征张量,作为所述时间切片特征序列;
17、构建独立的状态投影网络与动作投影网络,将提取的相对位姿状态向量与动作增量向量进行非线性空间映射,将其从原始的低维连续实数空间升维至与所述特征张量相同的潜在特征维度d,转化为高维的状态感知token与动作条件token;
18、将所述状态感知token、所述动作条件token与当前时间切片展平后所包含的空间视觉token,沿序列长度维度进行拼接组合,生成多模态统一token序列,作为所述多模态特征序列。
19、作为进一步优选的,步骤三具体包括:
20、在动作空间内利用交叉熵方法生成m候选动作序列,每条所述候选动作序列包含长度为h步的未来动作指令,记为;
21、针对每一条所述候选动作序列,将初始视觉条件设为当前时间步的真实切片特征,初始位姿设为当前时间步的物理位姿状态;
22、沿时间轴迭代执行自回归推演直至达到视野深度h,在推演的第h步,基于动作序列逐步更新虚拟物理位姿,所述虚拟物理位姿的计算公式为,所述虚拟物理位姿反映如果机械臂执行该动作序列在未来第步时探头所处的预期物理方位;
23、利用动作条件预测器推演下一时刻的虚拟切片特征,通过上述自回归递推运算,获得m条所述候选动作序列在预测视野末端所对应的预测特征集合,作为所述未来预测时刻的推演特征。
24、作为进一步优选的,所述下一时刻的虚拟切片特征的计算公式包括:
25、。
26、作为进一步优选的,步骤三中,所述预先训练的动作条件预测模型通过双轨损失函数驱动的离线训练算法构建,具体包括以下步骤:
27、利用所述参数冻结的视频基础模型编码器从原始视频流中提取出连续个时间步的真实特征序列作为基准特征池,记为,其中每一时刻的真实切片特征均由公式计算得出;
28、构建基于真实历史引导的单步预测轨道,对于任意推演步长,强制将预测器的初始输入修正为真实的特征状态,使网络以前一时刻的真实切片、真实的探头物理位姿以及实际执行的动作增量为输入进行前向传播,映射出当前步的单步预测特征,并计算用于捕捉动作与画面变化一阶相关性的单步预测损失函数;
29、构建多步自回归推演轨道,除起始步使用真实特征进行初始化外,后续各推演步骤的输入均强制使用预测器在前一时刻自身生成的推演特征,依循递推范式进行潜在特征空间内的长程闭环推演,并计算用于惩罚复合偏差的多步自回归推演损失函数;
30、引入动态平衡系数,将所述单步预测损失函数与所述多步自回归推演损失函数进行加权合并,构建总体优化目标函数:
31、;
32、在训练过程中采用课程学习策略,在训练初期设置较小的所述动态平衡系数的值以侧重单步因果映射学习,随着训练进程的推进逐步增大的权重以引导网络攻克多步自回归推演,直至所述动作条件预测模型收敛,以此实现在无真实视觉反馈的潜空间内仅凭动作指令推演未来的解剖学特征演化。
33、作为进一步优选的,步骤四具体包括:
34、预先通过统计拟合构建多元高斯分布作为所述目标先验分布模型,其中,为均值向量,为协方差矩阵,用于量化各特征维度间的相关性及解剖结构的波动容忍;
35、在推演阶段,将各条候选动作序列推演轨迹的末端特征代入所述多元高斯分布,计算其对数概率得分作为所述匹配评分;
36、选取得分最高的动作序列作为所述最优动作序列,依据滚动时域控制原理,仅向机械臂控制器下达该最优动作序列中的第一步动作,驱动探头产生物理位移;
37、随后系统状态前进一步,在新的物理反馈下重新触发图像采集与潜空间推演过程,以形成动态闭环机制。
38、作为进一步优选的,所述波动容忍的计算模型包括:
39、
40、式中,为协方差矩阵,n为目标样本的总数,i为样本的索引序号,为第i个目标样本的时间切片特征向量。
41、作为进一步优选的,所述对数概率得分的计算模型包括:
42、
43、式中,为第m条候选动作序列的匹配得分,为推演末端特征向量,const为常数项。
44、按照本发明的另一个方面,还提供了一种基于视频模型的心脏超声标准切面自主获取系统,包括:
45、时空视频流与同步状态采集模块,用于获取超声视频流以及与所述超声视频流同步对齐的探头位姿数据;
46、空间位姿解耦与局部任务坐标系模块,用于基于扫查起始时刻的探头位姿建立局部任务坐标系,将所述探头位姿数据转化为所述局部任务坐标系下的相对位姿,并计算相邻时间步之间的动作增量,以进行空间位姿解耦;
47、特征编码模块,用于利用视频编码模型将所述超声视频流映射为潜在特征空间内的时间切片特征序列,并将所述相对位姿与所述动作增量经特征投影后与对应时刻的所述时间切片特征融合,构建多模态特征序列;以及
48、潜空间自回归滚动规划模块,用于针对候选动作序列,利用预先训练的动作条件预测模型,基于当前控制步的所述多模态特征序列在潜在特征空间内进行自回归推演,生成未来预测时刻的推演特征,计算所述推演特征与预构建的目标先验分布模型之间的匹配评分,其中所述目标先验分布模型用于表征超声标准切面的解剖特征分布规律,根据所述匹配评分选取最优动作序列,并依据滚动时域控制策略执行动作指令,驱动探头获取心脏超声标准切面。
49、总体而言,通过本发明所构思的以上技术方案与现有技术相比,主要具备以下的技术优点:
50、1.本发明基于训练完成的动作条件预测器,在无需生成像素级图像的前提下,直接在高维潜在特征空间内利用候选动作指令进行自回归动作推演。通过计算推演末端特征与高斯解剖先验分布的概率密度得分,并结合滚动时域控制策略输出最优首步动作。这一突破有效克服了传统图像端到端伺服算法因计算瓶颈导致的动作滞后与系统震荡问题,极大提升了机器人系统在实际扫查环境下的控制平顺性。
51、2.本发明通过引入基于原生3d时空管道化的特征编码机制,赋予了系统对动态解剖结构的内在时序感知能力,从根本上消除了传统单帧视觉模型固有的心动周期时间歧义性缺陷。本发明针对现有单帧ai技术在动态、低信噪比超声流中容易出现局部漏检与动作闪烁的痛点,采用视频基础模型将连续的物理视频帧切割并压缩为具有固定时间深度的时间切片。该机制不仅静态表征了心脏的空间解剖形态,更天然捕获了心肌收缩的瞬时速率。在此基础上,通过将物理状态进行mlp投影并作为条件token无缝拼接入视觉序列,使得模型在充满斑点噪声与声影伪影的恶劣声学环境下,依然能够输出极具时序一致性和物理因果性的鲁棒特征表达。
52、3.本发明开发了双轨损失函数驱动的动作预测器训练范式,并结合解耦的局部任务坐标系与高斯先验基准,极其显著地提升了系统在长程推演下的保真度以及跨患者、跨设备的临床泛化能力。本发明在世界模型训练阶段,引入了单步预测与多步自回归推演相结合的双轨误差计算,并通过动态平衡系数引导模型克服累积误差,杜绝了长程潜空间推演中常见的特征漂移现象。同时,系统在执行阶段以探头首次接触点建立局部任务坐标系,消除了不同超声床位带来的刚性坐标域偏置;并利用多元高斯分布的协方差矩阵精确量化生理学容错度,使得系统无需依赖海量的异常标注数据即可自适应不同体型、不同病理状态患者的心脏解剖变异,大幅增强了自主超声机器人技术在真实基层医疗场景中的落地可行性与实用价值。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com