
同时检测拷贝数变异与基因组纯合区域的方法、系统、设备及介质与流程
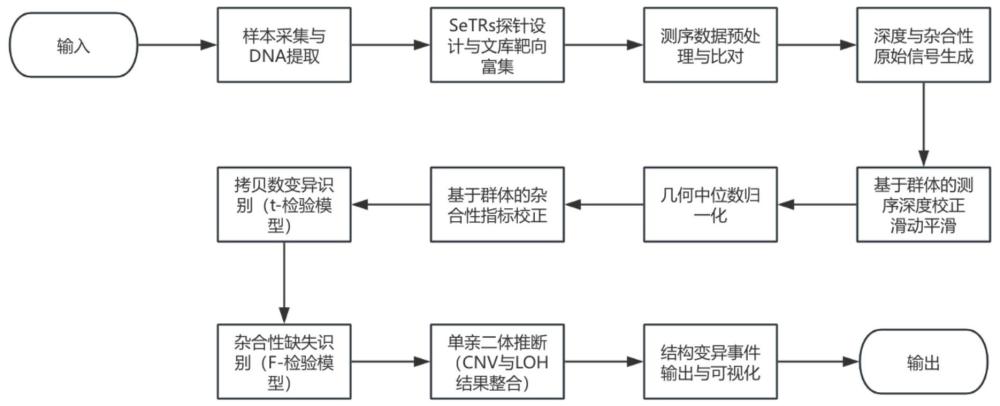
本发明涉及生物信息领域,尤其涉及同时检测拷贝数变异与基因组纯合区域的方法、系统、设备及介质。
背景技术:
1、人类基因组并非绝对稳定不变,其上存在大量结构性变异(structuralvariants, svs),其中拷贝数变异(cnv)和纯合性区域(roh)是最为常见且临床意义重大的两类。拷贝数变异是指长度通常大于1千碱基对(kb)的dna片段在基因组中发生的拷贝数增加(重复/扩增)或减少(缺失),直接影响相关基因的剂量效应。纯合性区域是指在拷贝数正常的染色体区域(即仍保留两个等位基因),该区域内所有等位基因序列完全相同,表现为纯合状态。特别地,当roh事件发生时,若拷贝数并未发生改变(即仍为二倍体),其本质是单亲二体(uniparental disomy, upd),即个体的某对同源染色体均来源于同一亲本。这些大型基因组畸变已被证实是导致众多常见遗传性疾病(如自闭症谱系障碍、智力障碍、癫痫)、先天性畸形、复发性流产以及多种恶性肿瘤(如白血病、实体瘤)发生、发展和预后判断的关键分子基础。
2、在过去的数十年中,染色体核型分析(karyotyping)和荧光原位杂交(fish)是检测大型基因组畸变的主要手段,但它们通量低、分辨率有限(通常>5-10 mb),难以满足精准医学的需求。随后,基于dna微阵列的技术,如单核苷酸多态性芯片(snp array)和比较基因组杂交芯片(acgh),因其高通量和相对较高的分辨率(可达10-100 kb)而成为临床检测cnv和roh的标准方法。然而,这些技术存在固有的局限性:首先,其检测信号依赖于杂交荧光强度,易受实验噪音、gc含量偏倚和探针设计密度不均等因素影响,数据质量不稳定,解读结果常需经验丰富的技术人员进行主观干预;其次,芯片技术仅能检测预设探针位点上的变异,无法发现探针区域外的新型变异,且对变异断点的精确定位能力有限;最后,芯片平台在检测基因组纯合区域roh(upd)时,虽然能通过snp分型信息间接推断,但仍需家系样本或匹配的正常对照样本作为参照,这在许多临床场景下是难以获得的。
3、随着下一代测序(next-generation sequencing, ngs)技术的飞速发展及其成本的指数级下降,基于全基因组测序(whole genome sequencing, wgs)的方法因其无偏倚、高分辨率和可提供序列层面信息的优势,逐渐成为检测基因组结构变异的新金标准。目前,wgs检测cnv的主要策略包括基于测序深度(read-depth)、配对末端(paired-end)、分割读段(split-read)以及从头组装(de novo assembly)等。然而,为了获得足够高的测序深度以实现全基因组范围内的高灵敏度和高特异性检测,wgs的成本依然居高不下,极大地限制了其在常规临床诊断中的普及应用。作为折中方案,全外显子组测序(whole exomesequencing, wes)因其成本较低而被广泛使用,但其靶向区域仅占全基因组的~1-2%,且主要集中于编码区。这种非均匀、非全基因组的覆盖模式,使其在检测基因组规模(尤其是非编码区)的大型cnv和roh时能力严重不足,存在巨大的检测盲区。
4、为克服wgs的成本瓶颈和wes的覆盖局限,靶向测序(targeted sequencing)作为一种经济高效的策略被提出。然而,现有的靶向测序方法多聚焦于特定致病基因或已知热点区域,用于检测小的插入缺失(indels)或单核苷酸变异(snvs),其探针设计原则与全基因组结构变异检测的需求相去甚远。这类方法在分析cnv/roh时面临诸多挑战:探针在基因组上的分布极不均匀,长基因和高gc区域覆盖不佳;目标区域(target regions, trs)之间非连续,给计算上的信号平滑和区域合并带来巨大困难;多数算法难以精确区分单拷贝缺失与二拷贝缺失,或三拷贝扩增与更高倍数的扩增;更重要的是,它们严重依赖于匹配的正常对照样本(matched normal)来进行标准化和背景校正,而该对照样本在产前诊断、不明原因发育迟缓等许多临床场景中是无法获取的。此外,对于roh(upd)的检测,现有靶向方法更是鲜有报道,通常需要家系信息进行亲子验证,缺乏独立判别的能力。。
技术实现思路
1、当前技术领域亟需一种能够兼顾高检测性能、低成本、高通量且无需匹配对照样本的全基因组cnv/roh/upd同步检测方案。该方案需要一个经过精心设计的、覆盖全基因组的标准化靶标区域集,以及一套与之配套的、基于群体统计的、能够自动进行信号校正、变异识别与整合分析的强大生物信息学系统。本发明正是在这一深刻洞察下,为解决上述技术难题而提出的创新性解决方案。
2、为实现上述发明目的,本发明一个方面提供同时检测拷贝数变异与基因组纯合区域的方法,包括以下步骤:
3、步骤s1,构建覆盖全基因组、分布高度均匀、序列特性稳定且富含多态性信息的dna探针集合,所述探针集合最大化信号的稳定性与代表性,最小化由gc含量偏差、重复序列干扰或捕获效率不均所导致的技术噪音;
4、步骤s2,将原始高通量测序数据进行过滤处理,转化为用于下游分析的标准化信号矩阵,包括测序深度信号与杂合性指标信号;
5、步骤s3,通过群体几何中位数归一化策略,针对原始测序深度矩阵和原始杂合性指标矩阵,分别应用独立的信号处理算法进行校正;
6、步骤s4,基于统计推断模型,分别识别cnv与roh事件,并通过逻辑整合判定upd;
7、步骤s5,系统性能验证。
8、进一步的,步骤s1包括以下步骤:
9、步骤s101,从公共数据库中筛选出具有较高杂合度的snp位点形成集合;
10、步骤s102,从集合中提取出满足比对要求的点位组成集合;
11、步骤s103,对集合进行空间分布均匀化处理后得到集合;
12、步骤s104,对集合进行填补间隙并确定最终探针位置。
13、进一步的,步骤s2包括以下步骤:
14、步骤s201,将待测个体的基因组打断修复构建原始双端测序文库;
15、步骤s202,对原始测序数据进行质控与过滤;
16、步骤s203,对经过步骤s202处理的数据进行序列比对,并排序生成bam文件;
17、步骤s204, 提取步骤s203产生的bam文件的原始测序深度与杂合性系数。
18、进一步的,遍历排序后的bam文件,统计每个setr探针区域内成功比对的读段总数,记为,其中下标 i 表示第 i 个探针区域。同时,提取位于探针内且属于集合 的snp位点的等位基因计数信息。对于第 j 个snp位点,设非参考等位基因(b-allele)的支持读段数为,总覆盖深度为,则其原始b等位基因频率定义为:,由此构建两个原始信号矩阵:原始深度矩阵:,其中=278,800 ;
19、原始杂合性矩阵:,其中为所有样本中共有的高质量snp位点数量。
20、进一步的,步骤s3包括以下步骤:
21、步骤s301,对测序深度信号进行滑动平均平滑处理,并引入群体几何中位数进行二次归一。
22、进一步的,为降低局部捕获效率波动的影响,对每个样本的原始深度进行滑动平均平滑处理。定义平滑后的深度值为:,其中,窗口大小=10 ,即取当前探针及其后10个相邻探针的平均值。进一步计算全局平均深度(),具体计算为:,得到初步校正的深度系数,具体计算方式为,为消除不同样本间系统性偏差(如文库浓度、测序批次效应),引入群体几何中位数进行二次归一。设有 k 个样本参与分析,则第 i 个探针在群体中的几何中位数 hᵢ 定义为:,其中表示第 k 个样本在第 i 个探针处的深度系数。最终得到完全校正的深度比值的计算方式为:,该值理论上在拷贝数正常(cn=2)区域应趋近于1.0。
23、步骤s302,对杂合性信号进行标准化处理。
24、进一步的,对于每个snp位点 j,其在第 k 个样本中的原始杂合性指标为。定义其标准化后的杂合性系数 为:,此变换使得完全杂合状态(f=0.5)对应 q=0.5,而完全纯合状态(f=0或1)对应 q=0。同样,计算该位点在群体中的几何中位数计算 方式为:最终校正后的杂合性系数定义为:。在正常杂合状态下,;而在roh区域,由于等位基因失衡,。
25、进一步的,步骤s4包括以下步骤:
26、步骤s401,应用单样本t-检验模型,以群体校正值为参照,识别出深度比值显著偏离1.0的靶标区域,并根据偏离方向和幅度推断拷贝数状态,合并相邻区域形成cnv事件;对于每个探针区域 i,其校正深度比值在拷贝数正常的群体中服从正态分布。现针对某一测试样本,检验其是否显著偏离群体均值。
27、构造单样本t-检验统计量的计算方式为:
28、其中为该探针在群体中值的标准差,分母项中的用于补偿群体均值估计误差。若对应的p值小于 0.048,则认为该探针存在显著的拷贝数偏离。
29、进一步,将连续至少 45 个探针划分为一个潜在cnv区间。要求其中至少 3 个探针的p值 < 0.048,且第四个探针的p值不超过 0.19(即四倍于主阈值)。随后对整个区间的平均计算最终拷贝数:,其中,round函数表示四舍五入取整。例如,若=0.98 ,则 cn = round(1.92) = 2;若=1.53 ,则 cn = round(3.00) = 3。
30、步骤s402,基于校正后的纯合性系数,应用f-检验模型,检测其方差相对于群体基线是否显著降低,识别roh事件;对于任一基因组区间,若其内部多个snp位点的杂合性系数显著低于群体水平,则提示roh发生。采用f-检验比较测试样本与群体在该区间内的方差差异。设某区间包含 m 个snp位点,测试样本的样本方差为 v_test,群体中位数的样本方差为 v_mul,则f统计量定义为:,自由度均为 。若f检验所得p值小于 0.012,则拒绝原假设,判定该区域发生roh。roh事件的最小跨度为连续 3个snp位点。允许扩展:只要新增探针的p值 < 0.095,且整个区域的平均p值仍低于 0.095,即可合并为更大roh区域。
31、步骤s403,将cnv和roh的结果进行逻辑交集运算:若某区域被同时识别为roh事件且其拷贝数被判定为2,则判定该区域存在单亲二体事件。
32、进一步的,步骤s5包括以下步骤:
33、步骤s501,收集样本,构建样本验证队列;
34、步骤s502,构建对比方法并设计实验;
35、步骤s503,对实验结果进行性能评估与分析。
36、本发明的第二个方面提供同时检测拷贝数变异与基因组纯合区域的系统,包括选择性靶标区域集构建模块,测序数据预处理与信号生成模块,群体基线校正与信号标准化模块,变异识别与整合分析模块,系统验证模块,其中:
37、选择性靶标区域集构建模块,用于构建覆盖全基因组、分布高度均匀、序列特性稳定且富含多态性信息的dna探针集合,所述探针集合最大化信号的稳定性与代表性,最小化由gc含量偏差、重复序列干扰或捕获效率不均所导致的技术噪音;
38、测序数据预处理与信号生成模块对经靶标区域集富集后获得的ngs原始数据(fastq格式)进行质控过滤(去除低质量碱基和接头污染),并将高质量的测序读段(reads)比对到人类参考基因组上,生成标准的序列比对/映射(sam/bam)文件。随后,计算每个靶标区域的测序深度信号,并对位于靶标区域集中snp位点的等位基因频率进行计算,生成原始测序深度矩阵和原始杂合性指标矩阵;
39、群体基线校正与信号标准化模块针对原始测序深度矩阵和原始杂合性指标矩阵,分别应用独立的信号处理算法进行校正。对于测序深度信号,先采用滑动窗口均值法进行平滑处理以降低局部噪音,再利用待测样本群体中所有样本在该靶标位点的几何中位数进行归一化,得到最终的校正深度比值。对于杂合性指标,同样通过群体几何中位数进行校正,得到校正后的杂合性系数。
40、变异识别与整合分析模块用于基于统计推断模型,基于校正后的深度比值,应用单样本t-检验模型,以群体校正值为参照,识别出深度比值显著偏离1.0的靶标区域,并根据偏离方向和幅度推断拷贝数状态,进而合并相邻区域形成cnv事件。同时,基于校正后的纯合性系数,应用f-检验模型,检测其方差相对于群体基线是否显著降低(即趋向于0),以识别roh事件。最后,将cnv和roh的结果进行逻辑交集运算:若某区域被同时识别为roh事件且其拷贝数被判定为2,则判定该区域存在单亲二体(upd)事件。
41、系统验证模块用于进行系统性能验证。
42、本发明的第三个方面提供一种电子设备,其包括处理器和存储器;所述存储器用于存储程序,当所述程序被所述处理器执行时,使得所述处理器实现:同时检测拷贝数变异与纯合性区域的系统及方法,用于在疾病的分子诊断、产前筛查或胚胎植入前遗传学检测中的应用,所述疾病包括遗传性发育障碍、先天性畸形、复发性流产、智力障碍、癫痫或肿瘤。
43、本发明的第四个方面提供一种计算机可读介质,所述计算机可读介质上存储有计算机程序,所述计算机程序被处理器执行时实现:同时检测拷贝数变异与纯合子区域的系统及方法,用于在疾病的分子诊断、产前筛查或胚胎植入前遗传学检测中的应用,所述疾病包括遗传性发育障碍、先天性畸形、复发性流产、智力障碍、癫痫或肿瘤
44、由于采用本系统和方法,与现有技术相比,具有以下优点:
45、本发明通过创新性地整合四大核心模块:(1)选择性靶标区域集构建模块;(2)测序数据预处理与信号生成模块;(3)群体基线校正与信号标准化模块;(4)变异识别与整合分析模块,突破了传统cnv/roh检测方法对匹配正常对照样本或家系信息的依赖,首次在靶向测序框架下实现了对cnv、roh和upd的三合一同步检测。该方法通过群体统计建模替代个体对照,显著降低了临床应用门槛;其设计的选择性靶标区域集与创新的信号处理算法,有效克服了靶向测序因区域非连续性与捕获效率差异导致的信号噪声问题,在保障高灵敏度与高特异性的前提下,将检测成本降低至全基因组测序的1/10以下。具有显著的技术先进性、临床适用性与可扩展性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com