
一种检测同一染色体中两个基因座的基因型及基因座间单倍型关系的方法与流程
本发明属于生物检测,具体涉及一种检测同一染色体中两个基因座的基因型及基因座间单倍型关系的方法。
背景技术:
1、同源染色体之间不同遗传位点的组合对生物表型有重要影响。单倍体基因型(简称“单倍型”)指同一染色体上共同遗传的多个基因座上等位基因的组合,亦指一个染色单体中具有统计学关联的一类单核苷酸多态性。单倍型等位基因间差异对基因表达、功能及其表型都有着重要影响。
2、单倍型分析(即单倍型分型)能够帮助研究同一条染色体上不同调控元件遗传变异之间的顺式相互作用,具有广泛的应用价值,如:在基因组学研究中,可用于解析同源染色体差异、基因表达调控及复杂性状的遗传机制奠定基础;在医学研究中,可用于挖掘致病基因和探索疾病机理;在农业育种中,可作为改良作物的重要依据;在法医遗传学中,可作为一种突变率低、杂合度高的遗传标记,用于族源推断、混合物分析、个体识别与亲缘关系鉴定。
3、对单倍型进行分析是基因组研究的基础,主要方法可分为间接推断法和直接实验法。间接推断法(如群体推断法、家族推断法)用遗传标记对家系进行连锁分析并对某一染色单体进行测序,以及用数学模型和计算软件估计群体中各种单倍型频率等的方法;直接实验法则通过物理或分子技术(如单分子稀释法、单染色体测序法、strand-seq、hi-c以及单细胞全基因组测序等)在有限染色体区域或整条染色体上获得精确的单倍型信息。其中,单倍型组装是单倍型分析中的难点,涉及将测序获得的snp位点等数据准确分类并拼接至各自所属的同源染色体上。
4、当前最常用的单倍型关系分析方法是基于pacbio smrt或者ont的全基因组测序方法。虽然全基因组测序技术可以对多个单倍型相关性进行分析,但是需要对整个基因组dna直接测序,其测序成本效率低,需要测序大量的数据量才可以获得目的基因信息。如果将pcr技术与长读段基因组测序技术结合,虽然可以解决少部分单倍型相关分析,但大部分的单倍型相关分析仍然不能解决,因为在很多情况下,用于长读段基因组测序的dna需要通过对基因组dna进行pcr扩增来获得,但是pcr扩增受限于扩增的长度,当目标序列的长度达到数十甚至上百kb的情况下,pcr扩增后也很难获得足量的产物用于后续长读段基因组测序分析。
技术实现思路
1、本发明的目的是克服现有技术的不足,提供一种检测同一染色体中两个基因座的基因型及基因座间单倍型关系的方法。
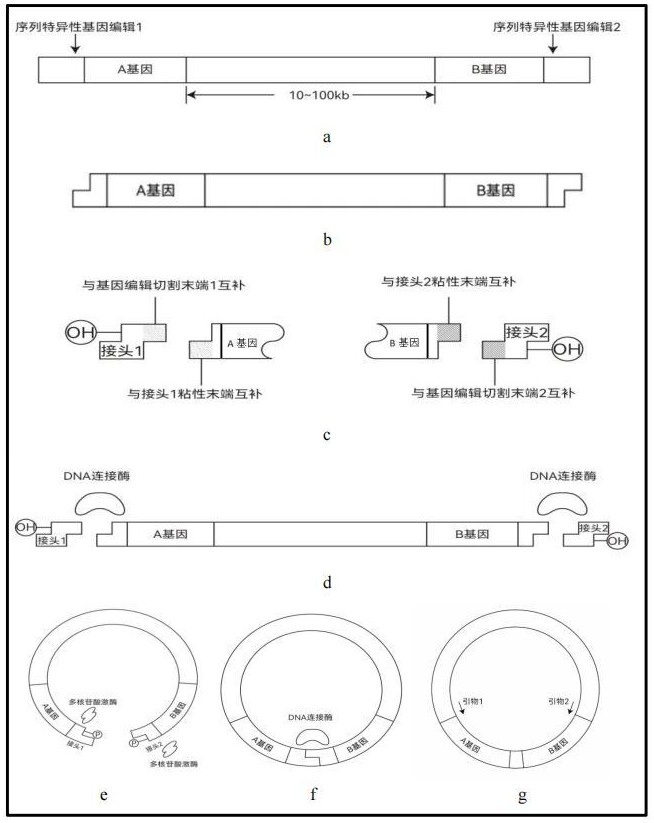
2、两倍体生物体中,同一基因座可能存在多种基因型;位于同一染色体的两个基因座,不同基因型在两条同源染色体上会形成不同组合;这种组合,即单倍型,一定条件下会决定生物体不同的形状,因此单倍型的确定在分子遗传等领域具有重要研究价值。当位于同一染色体的两个基因座相距较远时,现有生物学技术检测dna片段的大小无法同时完全覆盖这两个基因座,因此不容易确定它们的单倍型。本发明的方法利用染色体dna环化技术,通过使用序列特异性的基因编辑体系和环化自连接体系,将位于同一染色体、但被大片段基因组dna相隔的两个等位基因反向相连,从而在保留原有单倍型关系的前提下,有效缩短两个基因座之间的dna序列距离,从而使直接扩增包含这两个基因座的dna片段成为可能。进而可以对扩增产物进行长读段基因组测序、实现这两个基因座基因型和单倍型的分析。
3、本发明解决技术问题的技术方案具体如下:
4、本发明提供了一种检测同一染色体中两个基因座的基因型及基因座间单倍型关系的方法,所述的方法步骤如下:
5、1)提取细胞基因组dna;
6、2)序列特异性的基因编辑处理;利用dna序列特异性的基因编辑体系,体外特异性切割同一染色体中包含两个基因座的目标序列两侧的特定序列;
7、3)环化自连接处理;使用环化自连接体系,将切割下来的目标序列环化;环化后两基因座之间的反向距离显著短于染色体上原来的距离;
8、4)目标序列的反向扩增、长读段基因组测序及基因型和单倍型判定:使用pcr扩增技术获得足量扩增产物,用后续检测技术进行长读段基因组测序(如纳米孔测序),确定两个基因座的基因型和它们的单倍型关系。
9、进一步地,所述的步骤2)中,所述的dna序列特异性的基因编辑体系,可以是任何一种具有靶点序列选择性的基因编辑体系,优选为crispr(clustered regularlyinterspaced short palindromic repeats)系统,包含酶切后可产生粘性末端的cas蛋白,优选为crispr-lbcas12a蛋白。所述的基因编辑体系,还包含2条与目标序列两侧特定序列相同或互补的向导序列grna1和grna2,其用于引导基因编辑体系对目标序列两侧的特定序列进行特异性切割。
10、进一步地,所述的步骤2)中,序列特异性的基因编辑处理的具体步骤如下:crispr-lbcas12a蛋白在两条序列特异性的grna1和grna2的引导下,精准靶向切割染色体目标序列的两侧序列,特异性切割出目标序列的线性染色体dna片段。
11、进一步地,所述的步骤3)中,所述的环化自连接体系含有两个序列特异性的连接接头,所述的两个连接接头,其一端为具有连接活性的粘性末端,两个接头的这段序列分别与目标序列切割后两末端的序列互补;另一端为5’末端被羟基化、不具备连接活性的粘性末端,两个接头的这段序列彼此互补。两个连接接头彼此互补的序列分别为6~10个碱基,优选8个碱基,且末端的5’端为羟基化修饰。
12、进一步地,所述的步骤3)中,所述的环化自连接体系含有dna连接酶,所述的dna连接酶,优选t4dna连接酶。所述的dna连接酶用于将连接接头的粘性末端分别与切割后的目标序列的两端连接。所述的dna连接酶还用于在连接接头5’末端磷酸化后将目标序列环化。
13、进一步地,所述的步骤3)中,所述的环化自连接体系含有多核苷酸激酶。所述的多核苷酸激酶,优选t4多核苷酸激酶。所述的多核苷酸激酶用于在连接接头与酶切后的目标序列连接后,对连接接头游离端羟基化的5’末端进行磷酸化。
14、进一步地,所述的步骤3)中,环化自连接处理的具体步骤如下:
15、1)设计两种连接接头,接头1和接头2;其中接头1一侧的粘性末端与grna1引导切割后目标序列一侧的粘性末端互补;接头2一侧的粘性末端与grna2引导切割后目标序列另一侧的粘性末端互补;接头1与接头2另外一侧的粘性末端彼此互补;彼此互补的序列长度为6~10个碱基,优选8个碱基,且末端的5’端为羟基化修饰。
16、2)利用dna连接酶,将两个接头连接到基因编辑处理后含有目标序列的线性染色体dna的两端,并用磁珠对dna进行纯化,去除没有连接上的接头,得到dna连接产物。
17、3)完成接头连接后,使用多核苷酸激酶对dna连接产物进行5’末端磷酸化修饰;
18、4)利用dna连接酶,将连有磷酸化修饰目标序列dna片段自连,形成完整闭合的环状dna。
19、进一步地,所述的步骤4),具体步骤如下:使用dna聚合酶以及适配环状dna模板的pcr引物对,反向扩增环化后的含有两基因座的目标序列;因为环化后两个待测基因座反向的距离显著短于原有距离,从而可使用pcr扩增技术获得足量相应扩增产物。扩增后的pcr产物采用长读段基因组测序完成大片段的测序(如:纳米孔测序),对扩增子全长序列进行分析,从而确定同一染色体中两个基因座的基因型和它们单倍型关系。
20、在本发明的一个具体实施方案中,提供了一种检测同一染色体中两个基因座的基因型及基因座间单倍型关系的方法,其中两个基因座为人基因组中hla-dqa1和hla-dqb1,所述的方法步骤如下:
21、第一步:序列特异性的基因编辑处理
22、提取细胞基因组dna。使用crispr酶切体系对dna进行特异性切割,选择可产生粘性末端的crispr-lbcas12a蛋白。用于引导cas蛋白的grna为人工合成序列,其序列5’端与crispr-lbcas12a蛋白匹配,序列3’端与两个目标序列特异性切割位点匹配,2条grna序列分别如下:
23、grna1:5’uaauuucuacuaaguguagauggugucuucagauuuccuugucu 3’(seq id no:1)
24、grna2:5’uaauuucuacuaaguguagauugaagguucucaauccagugccu 3’(seq id no:2)
25、将合成后的grna用无核酸酶水均稀释至300nm浓度,然后按照以下比例配制crispr酶切体系:
26、无酶水: 16μl
27、nebuffer r2.1 reaction buffer (10x): 3μl
28、300nm grna1: 3μl
29、300nm grna2: 3μl
30、1 µm engen lba cas12a: 2μl
31、将配制好的反应体系先在25℃下孵育10min,然后加入3μl的基因组dna,轻轻混匀,在37℃下孵育30min进行酶切反应,然后65℃孵育10min使酶失活。酶切后立刻使用dna纯化磁珠进行dna纯化,在酶切反应液中按照1:1的比例加入纯化磁珠进行纯化,得到纯化dna1。
32、第二步:接头连接
33、首先人工合成连接接头1和连接接头2,接头一端均被5’羟基化修饰。接头与基因组dna相连端为匹配酶切的粘性末端;两个接头彼此互连端为8个碱基的粘性末端,两个连接接头序列和结构如下:
34、
35、将连接接头1和连接接头2使用无核酸酶水均稀释至300pm浓度,使用t4 dna连接酶进行连接。按照以下体系配制接头和dna1的连接反应:
36、t4 dna ligase buffer (10x): 2μl
37、dna1: 15μl
38、连接接头1: 1μl
39、连接接头2: 1μl
40、t4 dna ligase: 1μl
41、将配制好的反应体系轻轻混匀,在16℃孵育过夜连接,然后65℃孵育10min使酶失活。连接接头后使用dna纯化磁珠进行dna纯化,在连接反应液中按照1:0.5的比例加入纯化磁珠进行纯化,纯化磁珠比例为0.5。得到纯化dna2。
42、第三步:环化自连接
43、将纯化后的dna2使用t4多核苷酸激酶进行5’末端磷酸化修饰,反应体系如下:
44、t4 pnk reaction buffer (10x): 5μl
45、atp (10 mm): 5μl
46、t4 pnk: 1μl
47、dna2: 20μl
48、nuclease-free water: 19μl
49、将配制好的反应体系轻轻混匀,在37℃孵育30min,然后65℃孵育20min使酶失活。将磷酸化修饰后的dna使用纯化磁珠进行dna纯化,按照1:1的比例加入纯化磁珠进行纯化。然后使用qubit测量纯化后的dna浓度,将dna用te溶液稀释到0.2ng/μl,得到dna3。使用t4dna连接酶进行连接。按照以下体系配制连接反应:
50、t4 dna ligase buffer (10x): 2μl
51、dna3: 17μl
52、t4 dna ligase: 1μl
53、将配制好的反应体系轻轻混匀,在16℃孵育过夜连接,然后65℃孵育10min使酶失活,得到dna4。
54、第四步:目标序列的反向扩增
55、配制pcr反应体系,对连接反应后的dna4进行扩增。dna聚合酶使用高保真、长片段dna聚合酶。扩增反应体系如下所示:
56、omnipotent pcr mix: 25μl
57、上游引物(10μm): 1μl
58、下游引物(10μm): 1μl
59、dna4: 2μl
60、ddh2o: 21μl
61、扩增程序为95℃ 2min;98℃ 10s,60℃ 30s,72℃ 8min,35个循环;上游引物序列为:ccgcttcaactgtaaccagtctc(seq id no:7);下游引物序列为:caggcatcacagaagagtgataacc(seq id no:8)。
62、第五步:长读段基因组测序
63、将扩增后的pcr产物按照1:2的比例使用纯化磁珠进行纯化,然后使用ont公司的建库试剂盒(nbd114.96)进行pcr产物末端修复、barcode连接、马达蛋白接头连接等步骤。将建库完成的pcr产物使用ont公司的gridion测序仪和flo-min114芯片进行纳米孔测序。
64、第六步:基因型和单倍型判定
65、测序数据下机后采用生物信息学分析获得hla-dqa1和hla-dqb1所有蛋白编码序列在内的基因型信息,以及hla-dqa1和hla-dqb1连锁基因信息。
66、本发明具有如下技术效果:
67、(1)将序列特异性的基因编辑体系和环化自连体系结合使用,完整保留单倍型:本发明优选lbcas12a蛋白搭配双grna的序列特异性的基因编辑体系,可特异性识别目标序列两侧序列并精准切割产生粘性末端;相较于传统限制性内切酶、随机物理断裂方式,酶切靶向性极强,无随机断裂偏差,能够精准获取完整的目标染色体大片段,保留目标序列的单倍型信息,从源头保障单倍体分型的完整性与准确性。
68、(2)将序列特异性的基因编辑体系和环化自连体系结合使用,并对环化dna产物进行反向扩增,可以避免因两基因座间长片段dna而导致的pcr扩增失败;反向扩增一方面可以扩增出包含两基因座片段,同时可以有效缩短整个扩增子的大小,从而保证pcr成功扩增。
69、(3)环化自连体系中连接接头的设计有效提升环化自连的效率:本发明设计双差异化接头结构,通过接头5’末端羟基化修饰,彻底规避接头自身互补末端自连的问题,大幅减少无效连接产物;配合t4多核苷酸激酶末端磷酸化修饰工艺,精准调控dna环化时机,显著提升染色体dna环化成功率,有效解决传统环化建库效率低、杂产物多的技术痛点。
70、(4)与长读段基因组测序结合,实现超长dna片段的全长测序,无需片段拼接,避免片段拼接过程中序列模糊性引起的相位错配。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com