
基于深度学习的GDM/GDM-HDP早期风险预测方法及系统
本发明属于人工智能与医学信息,具体涉及一种基于深度学习的gdm/gdm-hdp早期风险预测方法及系统,尤其涉及一种基于可解释深度学习的妊娠期糖尿病及其高血压共病表型早期风险预测方法及系统。
背景技术:
1、妊娠期糖尿病(gdm)是妊娠期间发生的糖代谢异常疾病,主要由于妊娠期胰岛素抵抗增加以及胰岛β细胞代偿能力不足所导致。作为妊娠期常见的代谢性并发症之一,gdm发生率较高,不仅与巨大儿、剖宫产、新生儿代谢异常等不良妊娠结局相关,同时还会增加女性产后发生2型糖尿病及心血管代谢疾病的长期风险。妊娠期高血压疾病(hdp)是另一类常见且严重的妊娠并发症,包括妊娠期高血压、子痫前期、子痫以及hellp综合征等。临床研究发现,gdm与hdp之间存在较高的共存风险,二者可能共同受到代谢异常、胰岛素抵抗、炎症反应以及血管功能障碍等因素影响。gdm与hdp共病状态相比单一疾病表型具有更复杂的病理特征,并显著增加母婴不良结局发生风险。因此,针对gdm及其高血压共病表型进行孕早期风险识别,对于实现高危孕妇筛查、个体化管理以及早期干预具有重要意义。目前,针对gdm风险预测的方法主要基于孕妇人口学信息、体格指标、生化检测指标以及部分代谢相关标志物进行风险评估。例如,基于糖脂代谢构建的复合指标(如tyg、tyhgb、mets-ir、aip等)能够从不同角度反映胰岛素抵抗及代谢异常状态;部分炎症指标(如sii、nlr等)以及蛋白类生物标志物也被用于辅助评估妊娠期代谢及免疫变化。然而,现有方法通常依赖单一指标或有限变量组合,不同指标之间复杂的非线性关系及交互作用难以充分整合,同时部分高维生物标志物检测成本较高,限制了其在常规临床环境中的推广应用。随着人工智能技术的发展,基于机器学习和深度学习的方法逐渐应用于医学风险预测领域。相比传统统计模型,人工智能模型能够通过非线性特征学习挖掘临床数据中的复杂关联模式,提高疾病风险预测能力。然而,现有gdm相关人工智能预测方法仍存在一定不足:一方面,多数模型主要针对gdm单一结局进行构建,对于gdm与hdp共病等复杂妊娠表型的风险预测研究相对不足;另一方面,部分模型依赖单中心数据,缺少独立外部验证,其跨人群和跨医疗环境的泛化能力仍需进一步评价;此外,深度学习模型通常具有较高复杂度,预测过程缺乏透明解释,限制了其在临床辅助决策中的实际应用。
2、因此,现有技术仍缺少一种能够基于孕早期常规临床信息,实现gdm及其高血压共病表型早期风险预测,同时兼顾预测准确性、跨中心泛化能力以及模型解释性的智能化预测方法及系统。
技术实现思路
1、本发明的目的在于提供一种基于深度学习的gdm/gdm-hdp早期风险预测方法及系统以解决现有gdm及gdm-hdp共病表型风险预测方法中存在的不足。具体而言,本发明通过融合孕早期多维临床特征,构建基于深度学习的风险预测模型,实现对gdm及gdm-hdp共病表型的早期识别与风险评估,重点解决现有预测方法中存在的特征交互关系挖掘不足、单一疾病表型预测局限、模型泛化能力不足以及预测结果缺乏可解释性等问题。本发明通过多策略特征筛选方法提取关键临床预测因子,并结合可解释深度学习模型对不同临床特征之间的复杂非线性关系进行学习,同时利用模型解释方法解析影响个体风险预测的关键因素,从而提高预测结果的透明性和临床应用价值。本发明可基于常规孕早期临床检测信息,实现gdm及其高血压共病表型的自动化风险预测、风险分层及辅助决策支持。
2、为了实现上述目的,本发明采用如下技术方案:
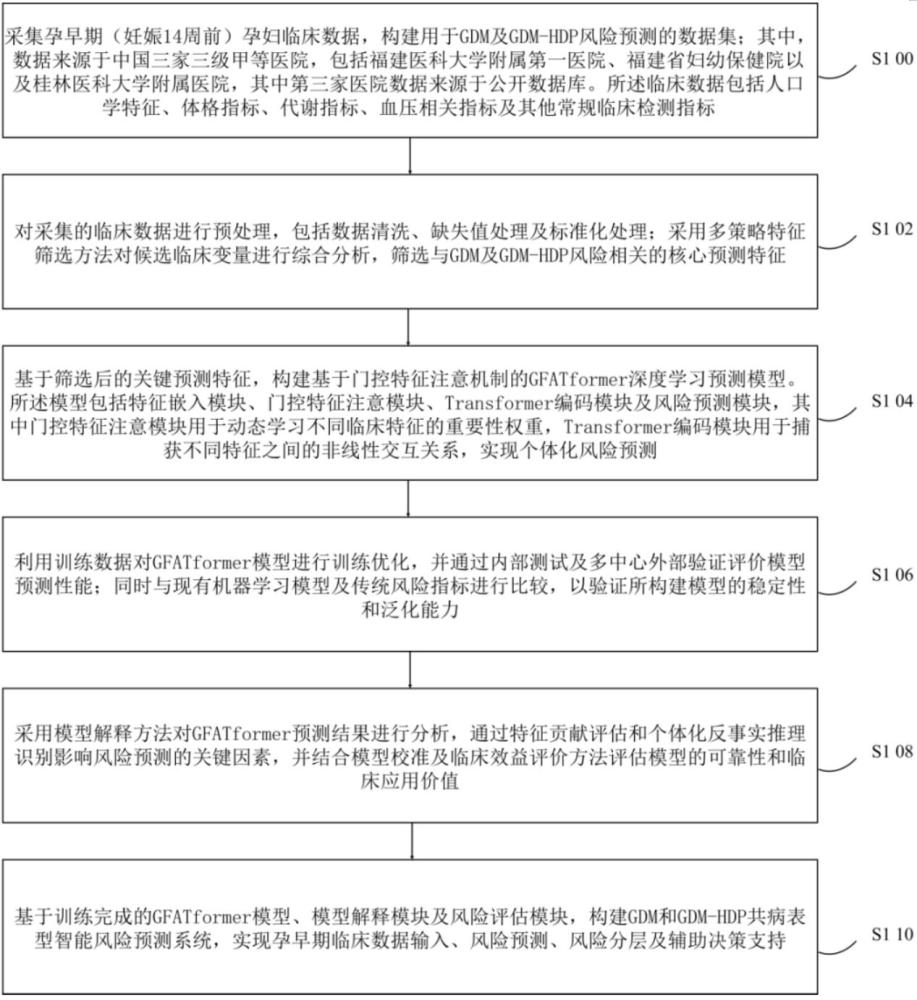
3、一种基于深度学习的gdm/gdm-hdp早期风险预测方法,包括:
4、s1、收集孕早期(妊娠14周前)孕妇临床数据,所述临床数据包括人口学特征、体格指标、糖脂代谢指标、血压相关指标以及其他常规临床检测指标,并对所获取的数据进行数据清洗、缺失值处理、编码及标准化处理,构建用于妊娠代谢异常风险预测的临床特征数据集;
5、s2、采用多策略特征筛选方法对所述临床特征数据集进行变量筛选,通过统计学关联分析方法、稀疏特征选择方法及特征重要性评估方法确定与妊娠期糖尿病(gdm)和妊娠期糖尿病-妊娠期高血压疾病共病表型(gdm-hdp)相关的关键预测指标,获得用于模型构建的核心临床特征集合;
6、s3、基于筛选后的关键预测特征,构建基于transformer编码器的门控特征注意深度学习预测模型gfatformer,所述模型包括特征表示模块、门控特征注意模块、transformer编码模块及风险预测输出模块;其中,门控特征注意模块用于根据不同个体的临床特征信息动态调整特征权重,transformer编码模块用于捕获临床变量之间的非线性交互关系和高阶依赖关系,进而输出个体化风险预测结果;
7、s4、对所建立的预测模型进行模型训练、内部测试及性能评估,并与现有机器学习模型及预测指标进行比较分析,同时对不同临床特征组合及候选指标的预测效能进行评价,确定具有最佳风险识别能力的模型结构及关键预测指标组合;
8、s5、基于训练完成的预测模型开展模型解释分析、多中心外部验证及临床适用性评价,通过特征贡献分析和风险推断方法解析模型预测依据,并进一步构建智能辅助预测系统,实现孕早期妊娠代谢异常风险的自动化评估、风险分层及临床辅助决策支持。
9、优选地,步骤s1中所述临床数据来源于中国三家三级甲等医院,分别为福建医科大学附属第一医院、福建省妇幼保健院和桂林医科大学附属医院,并依次定义为中心一、中心二和中心三数据集。其中,中心一数据集共纳入994例孕妇,用于模型开发及内部测试;中心二数据集共纳入190例孕妇,用于模型独立外部验证;中心三数据集共纳入1073例孕妇,其临床数据来源于dryad公开数据库。由于中心三数据集仅包含健康妊娠和gdm两类结局,因此该数据集仅用于gdm预测模型的外部验证,不用于gdm-hdp共病表型分析。所采集的临床变量包括:人口学及体格指标,包括年龄(age)、体质指数(bmi)和平均动脉压(map);代谢相关指标,包括空腹血糖(fbg)、总胆固醇(tc)、甘油三酯(tg)、高密度脂蛋白胆固醇(hdl-c)和低密度脂蛋白胆固醇(ldl-c);肝肾功能指标,包括天门冬氨酸氨基转移酶(ast)、丙氨酸氨基转移酶(alt)、总胆红素(tbil)、尿素氮(b bun)、肌酐(cr)和尿酸(ua);血液学指标,包括中性粒细胞计数(neu)、淋巴细胞计数(lym)和血小板计数(plt);以及妊娠相关指标,包括孕期体重增长(gwg)。根据妊娠结局,将研究对象划分为健康妊娠组、gdm组以及gdm-hdp组,其中健康妊娠组定义为妊娠期间未发生任何不良并发症的孕妇。
10、优选地,步骤s2中所述多策略特征筛选方法包括单因素logistic回归分析、lasso回归分析以及boruta算法,用于从候选临床变量中筛选与妊娠期糖尿病及其高血压共病表型相关的关键预测特征。具体地,首先采用单因素logistic回归分析评估各候选临床变量与研究结局之间的统计关联性,筛选满足预设显著性水平的候选变量;随后采用lasso回归方法对候选变量进行进一步压缩和筛选,并通过10折交叉验证确定最优正则化参数,保留回归系数不为零的变量。同时,采用基于随机森林算法的boruta特征选择方法对候选变量的重要性进行评估,通过与随机扰动特征的重要性进行比较,识别具有稳定预测贡献的关键特征。最终,将上述三种特征筛选方法共同识别的变量取交集,确定为用于构建预测模型的核心预测因子,并通过多因素logistic回归分析进一步验证所筛选变量与妊娠期糖尿病及其高血压共病表型之间的独立关联性。
11、优选地,所述核心预测因子包括:针对gdm预测任务,通过多策略特征筛选方法最终确定age、bmi、fbg、tg和gwg共5项核心预测因子,其中fbg在多种特征筛选方法中均表现出较高的重要性。针对gdm-hdp共病表型预测任务,通过相同特征筛选流程进一步确定fbg、age、tg、map、bmi、ua、tbil和plt共8项核心预测因子,用于构建gdm-hdp风险预测模型。
12、优选地,步骤s3中所述gfatformer是一种面向表格临床数据设计的深度学习预测模型,由特征嵌入层、门控特征注意力模块(gated feature attention,gfa)、transformer编码器和预测头(mlp head)组成。模型的核心思想是在特征交互建模之前强化关键特征并抑制低贡献变量,从而提高临床特征的表达能力。对于输入样本,其中n表示输入特征数量。首先通过独立的非线性映射(token embedding)将每个临床变量转换为高维特征token,同时引入可学习的cls token构建输入序列。为突出关键风险因素并抑制冗余信息,gfa模块首先利用cls token生成全局学习的特征权重:
13、
14、其中和为可学习参数,表示特征权重向量。随后结合sigmoid门控机制对加权后的特征进行进一步调制,通过特征重加权和门控筛选的两阶段策略增强关键特征表示:
15、
16、其中为门控映射参数,表示sigmoid函数,表示逐元素乘法,
z为gfa模块输出的特征表示。增强后的特征序列随后输入由3层transformer encoder组成的编码模块,通过多头自注意力机制建模临床变量之间复杂的非线性依赖关系,从而捕获潜在的高阶特征交互信息。最终,通过mlp结构的预测头输出目标事件发生概率。
17、优选地,所述gfatformer模型基于开发队列进行训练。首先,将开发队列按照7:3的比例随机划分为训练集和测试集,其中训练集用于模型参数优化,测试集用于模型性能初步评估。模型训练过程中,采用自研设计的cbfloss损失函数作为优化目标,以提高模型在类别不平衡条件下对不同风险表型的识别能力。采用adamw优化算法对模型参数进行迭代更新,初始学习率设置为0.0005,权重衰减系数设置为0.005。模型训练最大迭代轮数设置为1000轮,并根据训练过程中的模型性能变化完成参数优化。模型性能评价过程中,采用1000次bootstrap重采样方法计算各项评价指标的95%置信区间,以评估模型预测性能的稳定性和可靠性。预测模型训练完成后,采用多种现有机器学习模型及深度学习模型进行性能对比评价,以验证gfatformer模型的预测能力。其中,用于比较的预测模型包括catboost、lightgbm、xgboost、随机森林(rf)、规则拟合森林(rgf)、极端随机树(et)、可解释增强模型(ebm)、adaboost、mlp、支持向量机(svm)、逻辑回归(lr)以及tabpfn模型。同时,基于孕早期临床代谢相关指标构建多种现有风险预测指标,并对其预测效能进行比较分析,所述预测指标包括tyg、tyg-bmi、tyhgb、tynir、tg/hdl、mets-ir、aip、ucr、sii以及nlr。模型性能评价采用受试者工作特征曲线下面积(auc)、敏感度(sensitivity)、平均精确率-召回率曲线下面积(aupr)、准确率(accuracy)、特异度(specificity)、精确率(precision)以及f1分数(f1-score)等指标,对不同模型及预测指标的风险识别能力进行综合评价。
18、优选地,步骤s5中所述模型解释分析通过shap分析和反事实推理方法实现对gfatformer预测结果的可解释分析。其中,shap分析用于量化不同临床特征对模型预测结果的贡献程度,评估特征重要性及其对风险预测的影响;通过特征贡献分析及依赖关系分析,识别影响模型预测结果的关键因素及潜在特征交互关系。反事实推理用于构建个体化解释样本,通过模拟关键特征变化对预测结果的影响,确定改变个体风险判定的关键因素及变化方向。
19、所述临床适用性评价通过校准曲线评价模型预测风险概率与实际观察风险之间的一致性,并通过决策曲线分析(dca)评价模型在不同风险阈值条件下的临床净获益,以综合评估模型预测可靠性及临床应用价值。
20、本发明进一步保护一种基于深度学习的gdm/gdm-hdp早期风险预测系统,用于实现上述方法,包括:
21、特征输入模块,用于获取孕早期临床特征数据,所述特征数据包括fbg、bmi、age、tg、gwg、map、ua、plt、孕周以及糖尿病家族史和既往gdm病史等等;
22、预测生成与评估模块,用于调用可解释深度学习预测模型对录入的特征数据进行推理分析,输出包括置信度、风险概率值、风险层级(低风险、中风险、高风险)以及对应的临床辅助诊疗建议;
23、决策可解释性展示模块,用于可视化输出影响当前评估结果的关键影响因子及其贡献度排序(包括gwg、fbg、tg、age及bmi);
24、系统支撑与控制模块,用于实现前端逻辑与后端api的模型调用对接、限制临床常见指标范围以降低异常值干扰的输入校验、以及明确辅助评估适用范围使用边界的控制。
25、本发明进一步保护一种电子设备,包括存储器、处理器及存储在所述存储器上并可在所述处理器上运行的计算机程序,所述处理器执行所述计算机程序时实现上述的方法。
26、本发明进一步保护一种计算机可读存储介质,其上存储有计算机程序,所述计算机程序被处理器执行时实现上述的方法。
27、相较于现有技术,本发明具有以下有益效果:
28、(1)现有技术多聚焦于单一妊娠期糖尿病(gdm)的风险预测,而本发明首次系统性地构建了针对gdm及其与妊娠期高血压疾病(hdp)共病表型的预测模型。通过明确区分健康妊娠、单纯gdm及gdm-hdp共病三类结局,填补了当前对妊娠期复杂代谢性共病早期识别技术的空白,有助于临床在孕早期(14周前)即对高危共病人群进行精准分层。
29、(2)本发明提出了基于transformer编码器的门控特征注意深度学习模型(gfatformer)。相较于传统机器学习模型(如logistic回归、随机森林、xgboost等)及现有深度学习模型,该模型通过门控特征注意模块动态调整特征权重,突出关键风险因素,并结合transformer编码模块有效捕获临床变量间复杂的非线性交互与高阶依赖关系。实验验证表明,该模型在auc、敏感度、精确率及f1分数等多维评价指标上均表现出显著优越性,且通过1000次bootstrap重采样验证了其预测性能的稳定性和可靠性。
30、(3)本发明摒弃了单一的变量筛选方式,创造性地融合了单因素logistic回归、lasso回归及boruta算法三种互补策略,通过取交集的方式筛选出最具稳定预测贡献的核心因子。针对gdm任务仅需年龄、体质指数、空腹血糖、甘油三酯和孕期体重增长5项指标;针对共病任务仅需8项指标。该机制有效降低了数据采集成本和模型复杂度,同时排除了大量冗余临床变量的干扰,极大提升了模型的临床实用性和泛化潜力。
31、(4)本发明基于国内三家三甲医院的多中心临床数据进行开发和验证,开发队列(中心一)、内部测试及两个独立外部验证集(中心二、中心三)的设置,严格证明了模型在不同地域、不同医疗环境及不同人群特征下均能保持优异的预测能力。同时,模型兼容公开数据库与本地电子病历数据,具有较强的数据适应性和推广价值。
32、(5)本发明突破了传统深度学习“黑箱”模型的局限,整合了shap分析与反事实推理方法。一方面,能够量化并可视化展示每个临床特征对个体风险预测结果的贡献度及排序;另一方面,通过模拟关键特征变化对风险判定的影响,为临床医师提供了直观、个体化的解释依据。结合校准曲线与决策曲线分析(dca),从预测一致性、临床净获益等多角度证实了模型的实际应用价值。
33、(6)本发明在模型训练中引入了自研的cbfloss损失函数,有效解决了临床数据中gdm-hdp共病样本占比少、类别分布不平衡的问题。该策略确保了模型对高危共病表型的识别灵敏度,降低了漏诊风险,更符合临床对高危妊娠“宁可预警、不可遗漏”的实际需求。
34、(7)本发明将预测模型与解释模块有机结合,构建了完整的智能辅助风险预测系统。该系统涵盖特征自动录入与校验、风险概率实时计算、风险层级(低/中/高)自动划分、关键影响因子展示及个性化辅助诊疗建议输出等全流程功能。该系统可直接嵌入临床工作流,为产科医生提供便捷、直观的决策支持工具,有效提高高危孕妇的筛查效率,为实现妊娠期代谢异常的早期精准干预提供了坚实的技术支撑。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com