
基于选择性状态空间模型的预制混凝土配方逆设计方法与流程
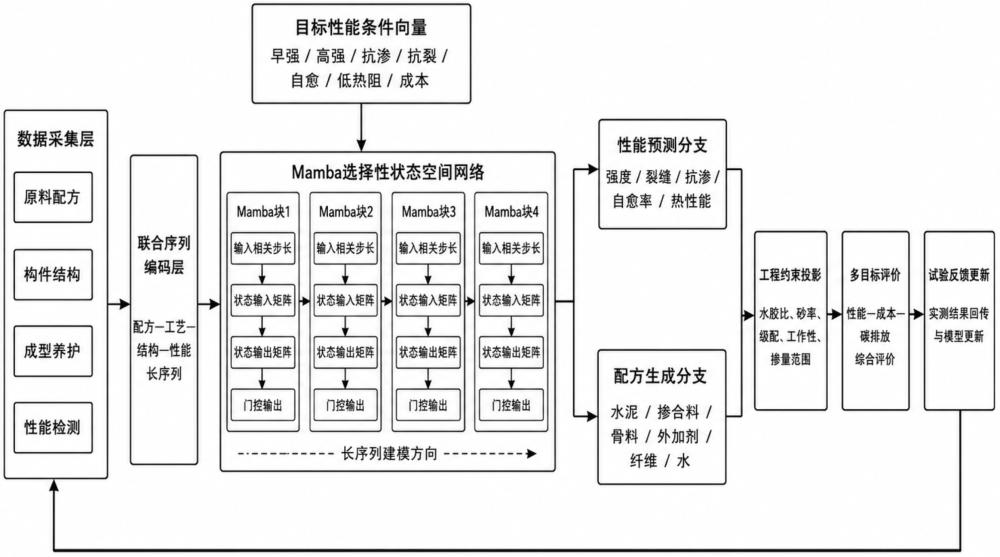
本发明属于智能材料设计与预制混凝土电力构件制造,具体涉及基于选择性状态空间模型的预制混凝土配方逆设计方法。
背景技术:
1、预制电力构件通常包括环网箱预制基础、箱式变电站预制基础、装配式混凝土电力井、预制电缆沟以及多孔电缆排管等。该类构件多在工厂内采用模具成型,之后运输至现场安装,具有尺寸稳定、施工时间短、现场湿作业少等特点。例如:预制电缆排管可形成4+2孔、6+2孔、9+2孔、12+2孔、16+2孔和20+2孔等系列,构件长度、宽度、高度、覆土深度和垫层厚度均会影响构件受力、热传导、抗渗和运输吊装安全。
2、现有混凝土配方设计主要依赖经验试配和单性能评价,常以28天抗压强度、坍落度或抗渗等级作为核心指标,难以同时兼顾早期脱模强度、孔口抗裂、长期抗渗、自愈性能、低热阻、电缆运行散热、成本及碳排放等多目标要求。现有机器学习方法虽然已用于预测混凝土抗压强度或自愈效率,但多数方法只把水泥、矿渣、粉煤灰、水、骨料、龄期等视为普通表格特征,未将预制电力构件的孔数、截面尺寸、覆土条件、振动成型和恒温恒湿养护等参数纳入同一序列。同时,常规神经网络和树模型难以对“原料—工艺—构件结构—性能”之间的长程依赖进行选择性记忆,生成的候选配方也容易违反水胶比、体积平衡、砂率、外加剂掺量和生产可行性等工程约束。因此,需要一种能够在预制电力构件场景下,将配方变量、结构变量、工艺变量和实测性能变量联合建模,并能根据目标性能反向生成可生产配方的技术方法。
3、与rnn、transformer和gnn等模型相比,本发明处理的是按“原料类别—结构变量—工艺时间—性能指标”组织的异质长序列。rnn在长序列中容易对早期配方变量产生衰减,transformer自注意力在序列长度增加时计算量和显存占用增长较快,gnn需要预先构造材料组分与结构参数之间的图连接关系且难以直接表达工艺顺序。选择性状态空间模型通过输入相关的状态更新,在保持长序列建模能力的同时具有更高的计算效率,适合工厂不断累积批次数据后进行在线或准在线配方推荐。
4、选择性状态空间模型优选采用mamba结构,其具有对长序列进行近似线性复杂度建模、根据输入内容选择性传播信息的特点,适于处理混凝土配方中多组分、多工艺、多性能指标之间的关联。本发明并非仅将常规模型替换为mamba,而是利用其“选择性保留或遗忘”机制与混凝土材料设计中的物理约束相配合:例如水胶比会持续影响水化反应、孔隙率、收缩、抗渗和后期强度,适合在长程状态中持续保留;振动时间主要影响早期密实度和孔隙分布,其影响在后续龄期性能预测中可被逐步衰减;导热矿物料和构件孔数量对热阻、温升及抗裂目标具有结构相关性,适合通过输入相关状态参数选择性强化。本发明基于该类选择性状态空间模型构建配方逆设计方法,并引入条件配方生成器、工程约束投影、多目标评价和试验反馈更新,使模型输出更符合预制电力构件生产条件的混凝土配方。
技术实现思路
1、本发明提供基于选择性状态空间模型的预制混凝土配方逆设计方法,旨在解决现有配方设计依赖人工试配、目标性能单一、不能同时利用构件结构参数和生产工艺参数、候选配方容易违反工程约束的问题。
2、本发明采用下述技术方案:基于选择性状态空间模型的预制混凝土配方逆设计方法,其中,所述方法包括如下步骤s1至s6。所述序列建模网络基于选择性状态空间模型,优选为mamba模型;在不改变输入相关状态选择机制和工程约束投影机制的前提下,也可采用其他能够实现输入依赖状态转移、选择性保留或遗忘长程信息的状态空间模型。优选的,所述预制电力构件包括预制电缆排管、预制电缆工井、环网箱预制基础、装配式混凝土电力井、预制电缆沟和箱式变电站预制基础中的至少一种;所述目标性能包括早期脱模强度、抗压强度、抗渗等级、裂缝宽度、自愈率、导热系数、收缩率、成本和碳排放中的至少两种。
3、步骤s1:构建配方—结构—工艺—性能联合样本。采集每一组混凝土样本的原料用量、构件结构参数、成型养护工艺参数和性能检测结果,形成联合样本向量。所述原料用量包括水泥、矿渣、粉煤灰、硅灰、水、细骨料、粗骨料、导热矿物料、减水剂、纤维、自愈组分和膨胀组分等;所述性能检测结果可由压力试验、裂缝宽度检测、导热检测、抗渗检测和自愈观察获得。
4、步骤s101:将第i个混凝土样本的配方变量、构件结构变量、生产工艺变量、性能变量以及样本可信度变量进行组合,构建联合样本向量:
5、(1)
6、式中:表示第i个联合样本;表示配方变量向量;表示构件结构变量向量;表示生产工艺变量向量;表示性能变量向量;表示样本来源、试验批次和可信度变量。
7、步骤s102:将第i个混凝土样本中各原料的单位体积用量表示为配方变量向量:
8、(2)
9、式中:为水泥用量;为矿渣用量;为粉煤灰用量;为硅灰用量;为水用量;为细骨料用量;为粗骨料用量;为导热矿物料用量;为减水剂用量;为纤维用量;为自愈组分用量;为膨胀组分用量;单位均可采用kg/m3。
10、步骤s103:将构件类型、孔数量、构件几何尺寸、覆土深度和垫层厚度表示为构件结构变量向量。
11、(3)
12、式中:表示构件类型;表示电缆孔数量或功能孔数量;表示构件长度;表示构件宽度;表示构件高度;表示等效孔径;表示覆土深度;表示垫层厚度。对于非多孔构件,可取为功能孔数量或取预设空值标记。
13、步骤s104:对联合样本中的连续特征进行归一化处理,并对缺失特征引入可学习的缺失值表示。
14、(4)
15、式中:表示归一化后的第j个特征;表示缺失标记;表示原始特征值;和分别表示第j个特征的均值和标准差;为防止除零的微小常数;表示缺失值学习向量。
16、步骤s105:对样本来源进行可信度标注,并在训练损失中引入可信度权重。所述样本来源至少包括公开抗压强度样本、企业实测生产样本、标准试件检测样本、经物理模型校核的数值模拟样本和专家经验样本;其中企业实测生产样本和标准试件检测样本的可信度权重高于数值模拟样本,数值模拟样本仅用于冷启动、样本扩充或边界条件敏感性分析,并在获得实测数据后通过反馈更新进行校准。
17、对于自愈率、导热系数、预制电力构件结构参数和部分试验结果采用模拟方式获得的情形,所述模拟样本需记录物理模型类型、材料参数取值、边界条件、网格或计算步长、校核依据和可信度等级,并作为样本可信度变量的一部分输入模型,使本领域技术人员能够依据相同条件复现实验性数据或以实测数据替换相应模拟字段。
18、步骤s2:建立预制电力构件混凝土的工程可行域。对配方变量设置工程约束,所述工程约束包括水胶比约束、体积平衡约束、材料掺量范围约束(骨料级配约束、外加剂约束、导热矿物料约束等)、砂率约束、外加剂掺量约束以及构件孔隙率约束。优选的,对于预制电缆排管,孔数越多、截面越大时,所述工程可行域同时引入导热系数下限和裂缝宽度上限。
19、步骤s201:根据胶凝材料和功能粉体的用量,计算第i个样本的总胶凝及功能粉体用量:
20、(5)
21、式中:表示第i个样本的总胶凝及功能粉体用量;、、、、和分别为水泥、矿渣、粉煤灰、硅灰、自愈组分和膨胀组分用量。
22、步骤s202:根据用水量与总胶凝及功能粉体用量的比值,建立水胶比约束:
23、(6)
24、式中:表示第i个样本的水胶比;表示用水量;表示总胶凝及功能粉体用量;和分别表示水胶比下限和上限。
25、步骤s203:根据各材料质量、表观密度和含气体积,建立混凝土配方的体积平衡约束:
26、(7)
27、式中:表示参与体积平衡计算的材料集合;表示第i个样本中第j种材料的质量;表示第j种材料的表观密度;表示含气体积;表示允许的体积平衡偏差。
28、步骤s204:根据构件孔数量、等效孔径和截面尺寸,计算多孔预制构件的孔面积占比和实体截面比例:
29、(8)
30、式中:表示孔面积占截面面积比例;表示孔数量;表示等效孔径;和分别表示构件宽度和高度;表示实体截面比例;和用于约束多孔排管的抗裂与导热目标。
31、步骤s3:配方—结构—工艺联合序列编码。将数值变量、类别变量和目标性能变量转换为序列化输入,使模型能够同时读取材料组分、构件规格、成型养护参数和目标性能。优选的,采用不同类型嵌入区分原料、结构、工艺和性能特征,并以目标性能向量作为反向生成条件。
32、步骤s301:根据特征分组、特征类型和特征位置,将归一化后的单个特征映射为嵌入向量。
33、(9)
34、式中:表示第i个样本第j个特征的嵌入向量;表示与特征分组对应的线性变换矩阵;表示对归一化特征的数值编码;表示特征类型嵌入;表示特征位置嵌入。
35、步骤s302:按照预设特征顺序,将各特征嵌入向量排列为样本输入嵌入序列。
36、(10)
37、式中:表示第i个样本的输入嵌入序列;表示序列长度;至分别为各特征的嵌入向量。
38、步骤s303:将目标性能、构件结构变量和期望工艺变量映射为目标条件向量。
39、(11)
40、式中:表示目标条件向量;和分别为目标条件映射矩阵和偏置;表示希望达到的性能目标;表示构件结构变量;表示期望的工艺变量。
41、步骤s304:将目标条件向量与输入嵌入序列进行拼接,形成送入选择性状态空间网络的最终序列,所述选择性状态空间网络优选为mamba网络。
42、(12)
43、式中:表示送入选择性状态空间网络的最终序列;表示目标条件向量;表示配方、结构、工艺和已知性能的嵌入序列。
44、步骤s4:构建基于选择性状态空间模型的序列建模网络。所述选择性状态空间模型优选为mamba模型,所述mamba网络由至少一个选择性状态空间块构成;在其他实施方式中,也可以采用具有输入相关离散步长、输入相关状态输入矩阵和输入相关状态输出矩阵的选择性状态空间模型。其特征在于,状态转移参数根据当前输入动态生成,使模型能够对水胶比、导热矿物料、自愈组分、孔数、振动时间和养护温湿度等特征进行选择性保留或遗忘。
45、具体而言,水胶比、胶凝材料活性和养护温湿度对水化程度、孔隙结构、收缩和强度发展具有跨龄期影响,模型通过较小的遗忘尺度在长程状态中保留该类信息;振动时间、入模温度和初始坍落度主要影响早期密实度,模型可在后续性能预测中降低其状态贡献;导热矿物料掺量、孔面积占比和覆土深度对导热系数、等效热阻和温升目标具有结构耦合关系,模型通过输入相关状态输出矩阵增强其对热性能分支的贡献。上述选择机制使模型不仅输出统计相关结果,还能够与预制电力构件混凝土的物理约束相对应。
46、步骤s401:根据当前输入向量生成输入相关的离散步长,使模型对不同特征赋予不同的状态更新尺度。
47、(13)
48、式中:表示第t个序列位置的离散步长;表示平滑非负激活函数;和分别表示步长生成参数;表示第t个输入向量。
49、步骤s402:根据当前输入向量生成状态输入矩阵和状态输出矩阵,使状态空间参数随配方及工艺特征动态变化。
50、(14)
51、式中:表示输入相关的状态输入矩阵;表示输入相关的状态输出矩阵;和为可训练矩阵;为第t个输入向量。
52、步骤s403:根据输入相关离散步长、连续状态矩阵和状态输入矩阵,更新序列位置t的隐状态。
53、(15)
54、式中:表示第t个位置的隐状态;表示前一位置隐状态;表示连续状态矩阵;表示离散状态转移矩阵;表示离散状态输入矩阵;表示单位矩阵。
55、步骤s404:根据状态输出、跳连项和门控项,获得第t个序列位置的选择性状态空间模型输出向量;在优选实施例中,所述输出向量为mamba输出向量。
56、(16)
57、式中:表示第t个位置的输出向量;表示跳连矩阵;表示逐元素乘法;表示sigmoid函数;表示门控矩阵;表示输入向量。
58、步骤s5:建立多性能预测、自愈评价和训练目标。基于选择性状态空间模型输出向量预测混凝土性能。所述性能优选包括1天、3天、7天和28天抗压强度,抗渗等级,裂缝宽度,自愈率,导热系数,收缩率,成本和碳排放。对于需要自愈功能的构件,模型将初始裂缝宽度、养护龄期和自愈组分作为显著变量输入。
59、步骤s501:对选择性状态空间网络的序列输出进行池化,并映射得到混凝土多性能预测向量。
60、(17)
61、式中:表示模型预测的性能向量;和分别表示性能预测层的权重和偏置;表示池化函数;表示第i个样本所有序列位置的输出向量。
62、步骤s502:根据预测初始裂缝宽度和养护后的预测裂缝宽度,计算预测自愈率。
63、(18)
64、式中:表示预测自愈率;表示预测初始裂缝宽度;表示经t天养护后的预测裂缝宽度;表示防止除零的微小常数。
65、步骤s503:根据预测导热系数计算预测等效热阻,并结合等效发热量计算温升指标。
66、(19)
67、式中:表示预测等效热阻;表示预测导热系数;表示防止除零的微小常数;表示预测温升指标;表示电缆运行或试验条件下的等效发热量。
68、步骤s504:根据预测性能与实测性能之间的偏差构建性能预测损失,并加入模型参数正则项。
69、(20)
70、式中:表示性能预测损失;m表示性能指标数量;表示第l个性能指标的权重;表示huber损失函数;和分别表示预测值和实测值;表示正则化系数;表示模型参数。
71、步骤s6:进行配方逆设计、工程约束投影和试验反馈更新。输入目标性能后,通过条件配方生成器生成候选配方,并将候选配方投影到工程可行域;之后根据多目标评价和不确定性选择需要试验的候选配方。试验结果反馈至训练数据,使序列建模网络、性能预测分支和配方生成器在多轮迭代后输出满足目标性能的预制电力构件混凝土配方。
72、步骤s601:将目标性能向量、构件结构向量、目标工艺向量和探索向量输入配方生成器,生成候选混凝土配方。所述配方生成器为独立的条件生成网络,优选与性能预测分支共享特征嵌入层或目标条件编码层,但具有独立的生成参数;其并非简单地对性能预测网络进行逆向传播求解,而是根据目标条件直接输出满足工程约束前的候选配方。
73、(21)
74、式中:表示第k轮生成的候选配方;表示配方生成器;表示目标性能向量;表示构件结构向量;表示目标工艺向量;表示采样噪声或探索向量。
75、具体地,所述配方生成器包括条件编码层、探索向量采样层、至少一个选择性状态空间块或门控多层感知机、配方输出层和可行域映射层。条件编码层将目标性能向量、构件结构向量和目标工艺向量映射为条件隐向量;探索向量采样层输入服从高斯分布、均匀分布或拉丁超立方采样分布的探索向量,以产生多样化候选配方;配方输出层分别输出水泥、矿渣、粉煤灰、硅灰、水、细骨料、粗骨料、导热矿物料、减水剂、纤维、自愈组分和膨胀组分的未约束用量。
76、为保证输出可实现性,配方输出层对各原料用量采用softplus、sigmoid区间缩放或归一化体积分配方式,使原料用量为非负并落入预设掺量范围;对于纤维类型、自愈组分类型等离散变量,采用softmax或独热编码输出;随后由工程约束投影算子修正水胶比、砂率、体积平衡和功能组分掺量。配方生成器的训练目标包括真实配方重构损失、生成配方经性能预测分支得到的目标性能偏差损失、工程约束惩罚损失和候选配方多样性损失。
77、步骤s602:将候选配方投影至由水胶比、体积平衡、砂率、掺量范围和性能阈值限定的工程可行域内。
78、(22)
79、式中:表示投影后的可生产配方;表示工程约束投影算子;表示由水胶比、体积平衡、砂率、掺量上限和性能阈值形成的可行域;表示二范数。
80、步骤s603:根据多目标代价、预测不确定性和期望改进量,计算候选配方的采集函数值。
81、(23)
82、式中:表示候选配方的采集函数值;表示多目标代价的预测均值;表示预测不确定性;表示探索权重;表示改进权重;表示期望改进量。
83、步骤s604:将被选中配方的试验结果加入已有数据集,并根据新增样本规模和样本分布变化选择增量微调或全量重训练策略更新模型参数。
84、(24)
85、式中:表示第k轮已有数据集;表示被选中并完成试验的配方;表示对应构件结构向量;表示工艺向量;表示试验所得性能结果;表示更新后的模型参数。
86、当新增实测样本数量低于预设阈值,或者新增样本与已有样本的特征分布差异低于预设漂移阈值时,采用增量微调策略:冻结前若干选择性状态空间块,仅更新配方生成器、性能预测层以及最后若干选择性状态空间块,并以较小学习率和早停策略防止过拟合;同时保留部分历史样本进行经验回放,避免模型遗忘已验证配方。
87、当累计迭代达到预设轮次、验证集误差连续升高、或新增实测样本覆盖新的构件类型、孔数范围、导热矿物料区间或自愈组分区间时,采用全量重训练策略:将历史样本、新增实测样本和经校核的模拟样本按可信度权重混合训练,并重新优化序列建模网络、性能预测分支和配方生成器的全部参数。
88、本发明的有益效果包括:
89、(1)本发明将构件结构参数、生产工艺参数和配方参数纳入同一序列,使模型能够区分不同预制电力构件对混凝土性能的差异化要求;
90、(2)本发明采用选择性状态空间模型处理长序列特征,优选采用mamba选择性状态空间网络,相比rnn对早期信息的逐步衰减和transformer在长序列下较高的注意力计算开销,能够以输入相关状态更新方式选择性保留水胶比、导热矿物料、自愈组分和孔面积占比等关键物理变量,更适合表达多材料、多工艺和多性能之间的长程关联;
91、(3)本发明通过工程约束投影保证候选配方满足水胶比、体积平衡、外加剂掺量、砂率和生产工艺要求,降低不可生产配方出现概率;
92、(4)本发明可根据目标性能进行反向生成,适于高强、抗裂、抗渗、自愈、低热阻和低成本等多目标设计;
93、(5)本发明将试验结果回传至模型并更新参数,能够随着企业生产检测数据增加而提高配方推荐精度。
94、(6)本发明明确配方生成器的条件生成结构和训练目标,能够说明候选配方的生成来源,避免仅依赖性能预测网络逆向传播造成的公开不充分问题;
95、(7)本发明对模拟样本设置物理模型、边界条件和可信度权重,并在获得实测试验结果后采用增量微调或全量重训练更新模型,提高了技术方案的可复现性和工程实现可靠性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com