
一种多模态情感自适应感官代偿交互方法及系统
本发明涉及人机交互,尤其涉及一种多模态情感自适应感官代偿交互方法及系统。
背景技术:
1、园艺疗法作为一种辅助性康复手段,通过让参与者接触植物和自然环境来缓解压力、改善情绪,已被广泛应用于心理康复与特殊教育领域。然而,传统园艺疗法高度依赖视觉观察植物形态与色彩、听觉聆听风声水声鸟鸣等自然音律,视障者无法感知花卉的视觉美感,听障者无法聆听自然声景,感官壁垒使得视障与听障群体被天然排除于园艺疗愈体验之外,难以获得相应的康复效果。
2、目前,针对残障人士的辅助设备主要包括读屏软件、语音提示装置及单频率震动马达等,这些设备仅能提供单一模态的感官补偿,缺乏视觉、触觉、听觉与光效等多感官通道的协同代偿机制。同时,现有情感状态调节手段多依赖预设固定脚本或人工康复指导人员,采用统一的干预策略,无法根据用户实时的情绪波动进行动态调整,存在个性化程度低、千人一面、服务成本高昂等问题。此外,现有算法严重绑定特定硬件平台,每适配一种新终端均需重新开发,扩展性和可移植性较差。
技术实现思路
1、本发明的目的是为了解决现有技术中存在能提供单一模态的感官补偿,缺乏视觉、触觉、听觉与光效等多感官通道的协同代偿机制等缺点,而提出的一种多模态情感自适应感官代偿交互方法及系统。
2、为了实现上述目的,本发明采用了如下技术方案:
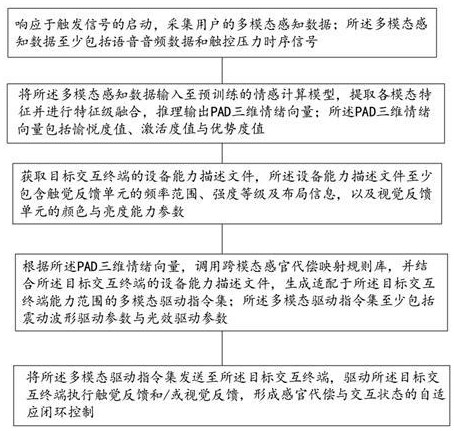
3、本发明第一方面提出了一种基于多模态情感计算的自适应感官代偿交互方法,其具体包括以下步骤:
4、步骤s1:响应于触发信号的启动,采集用户的多模态感知数据;所述多模态感知数据至少包括语音音频数据和触控压力时序信号;
5、步骤s2:将所述多模态感知数据输入至预训练的情感计算模型,提取各模态特征并进行特征级融合,推理输出pad三维情绪向量;所述pad三维情绪向量包括愉悦度值、激活度值与优势度值;
6、步骤s3:获取目标交互终端的设备能力描述文件,所述设备能力描述文件至少包含触觉反馈单元的频率范围、强度等级及布局信息,以及视觉反馈单元的颜色与亮度能力参数;
7、步骤s4:根据所述pad三维情绪向量,调用跨模态感官代偿映射规则库,并结合所述目标交互终端的设备能力描述文件,生成适配于所述目标交互终端能力范围的多模态驱动指令集;所述多模态驱动指令集至少包括震动波形驱动参数与光效驱动参数;
8、步骤s5:将所述多模态驱动指令集发送至所述目标交互终端,驱动所述目标交互终端执行触觉反馈和/或视觉反馈,形成感官代偿与交互状态的自适应闭环控制。
9、进一步的,所述跨模态感官代偿映射规则库包括:
10、视觉-触觉映射子规则,用于将目标对象的视觉纹理粗糙度特征映射为震动波形的频率与波形类型,其映射函数为:频率 f = 60 + r × 240 hz,其中r为粗糙度值;波形类型根据r值域划分为正弦波、方波或随机噪声;
11、听觉-视觉映射子规则,用于将音频信号的主频特征映射为led光效的色调与呼吸周期,其映射函数为:色调 h = (f_aud - 100)/800 × 240°,呼吸周期 t_br = 5000/(f_aud/100) ms,其中f_aud为音频主频。
12、进一步的,步骤s2中所述情感计算模型为轻量化神经网络模型,该模型通过量化压缩和参数高效微调部署于边缘计算单元;所述量化压缩包括int8量化,所述参数高效微调采用低秩分解或适配器模块中的至少一种方法。
13、进一步的,步骤s4中还包括情感自适应调节子步骤:
14、监测所述pad三维情绪向量中的激活度值a和愉悦度值p;
15、若所述激活度值a大于预设的第一阈值,则自适应降低所述多模态驱动指令集中的震动强度参数和/或延长光效呼吸周期,以降低用户唤醒水平;
16、若所述愉悦度值p小于预设的第二阈值,则自适应提高所述多模态驱动指令集中的色彩饱和度参数与震动节奏参数,以提升用户正向情绪。
17、进一步的,所述多模态感知数据还包括生理信号数据或面部表情数据中的至少一种;步骤s2中所述特征级融合采用掩码机制处理缺失模态,根据当前可用的模态类型动态调整所述情感计算模型中各模态特征的融合权重。
18、进一步的,还包括危机干预与数据记录步骤:
19、监测所述pad三维情绪向量中的激活度值a是否大于第三阈值且愉悦度值p是否小于第四阈值,且该状态持续超过预设时长;若是,则触发危机干预流程,所述危机干预流程包括转接人工热线或通知预设紧急联系人;
20、记录每次交互的完整日志数据,并根据累积的日志数据生成长期康复档案,所述长期康复档案包括情绪波动规律、主题偏好及干预效果趋势。
21、本发明第二方面还提出了一种基于多模态情感计算的自适应感官代偿交互系统,具体包括:
22、触发介质,用于存储唯一场景标识并响应外部交互动作生成触发信号;
23、多模态输入装置,至少包括麦克风阵列和压力传感阵列,分别用于采集用户的语音音频信号及触控力度时序信号;
24、计算处理单元,包括边缘计算设备和/或云端服务器,所述计算处理单元集成有情感推理引擎与跨模态映射引擎,用于执行上述的方法,并输出多模态驱动指令集;
25、多模态交互终端,至少包括线性马达阵列和可控led光源阵列,用于接收所述多模态驱动指令集并产生震动反馈和/或光效反馈;
26、其中,所述计算处理单元与所述多模态交互终端之间通过无线通信方式连接,且所述多模态交互终端向所述计算处理单元上报其设备能力描述文件,所述计算处理单元基于所述设备能力描述文件动态适配驱动指令。
27、进一步的,所述多模态交互终端选自以下任一种或多种形态:
28、智能手机、平板电脑、智能手环、模块化景观交互终端、触觉手套。
29、进一步的,所述模块化景观交互终端至少包括:
30、嵌入式微控制器;
31、近场通信读头,用于读取所述触发介质的标识信息;
32、至少8个可独立控制的线性振动执行器,呈阵列式布局;
33、可编程led光源阵列,采用单总线控制的全彩rgb灯带;
34、以及触控压力传感阵列,用于采集用户在终端表面的按压分布数据。
35、进一步的,所述触发介质选自以下任一种:
36、nfc卡片、rfid标签、二维码卡片或蓝牙信标。
37、本发明提出的一种多模态情感自适应感官代偿交互方法及系统,有益效果在于:本发明通过构建视觉-触觉映射子规则和听觉-视觉映射子规则,将视觉纹理特征转化为震动波形、将音频主频特征转化为光效色调与呼吸周期,使视障用户能够通过触觉感知花卉纹理,听障用户能够通过光效感知声音律动,有效打破了传统感官交互的壁垒,实现了跨模态感官代偿。
38、其次,通过部署于边缘计算单元的轻量化情感计算模型实时输出pad三维情绪向量,并结合情感自适应调节机制,根据用户激活度与愉悦度的实时变化动态调整震动强度与光效参数,使交互反馈能够随用户情绪波动自适应变化,避免了传统预设脚本的僵化模式,实现了真正个性化的情感疗愈干预。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com