
一种基于跨样本图交互网络的多模态情感分析方法
本发明涉及情感分析的,尤其涉及一种基于跨样本图交互网络的多模态情感分析方法。
背景技术:
1、随着社交媒体平台如tiktok、youtube的发展,网络数据已从纯文字向包括视频、音频在内的多模态形式演变,导致情感分析的数据源从单模态扩展到多模态。从这些数据中提取情感信息对决策者了解公众意见、作出明智决策至关重要。此外,多模态情感分析对人工智能领域的发展尤为重要,它有助于深入理解人类的情绪表达和交流机制,对通用型人工智能的发展具有重要推动作用。
2、在当今多模态情感分析领域,研究者越来越注重于如何在框架内融合不同模态信息,即多模态融合。传统方法如基于递归神经网络(recurrent neural network,rnn)的张量融合网络(tensor fusion network,tfn)和记忆融合网络(memory fusion network,mfn),通过不同模态特征向量的级联或求和来整合多种模态内的信息。但随着transformer的崛起,一些新的方法如多模态transformer(multimodal transformer,mult)、多式联运适应门bert(multimodal adaptation gate-bert,mag-bert)、多模态情感分析中的模态不变和模态特定(modality-invariant and-specific representations for multimodalsentiment analysis,misa)和用于多模态情感分析的自监督多任务学习(self-supervised multi-task learning for multimodal sentiment analysis,self-mm)等应运而生,这些方法利用transformer的优势,推动不同模态的有效交互。例如,misa通过独特的双子空间学习策略,同时捕捉模态间的共性和个性,有效解决了模态差异问题,self-mm则提出一种结合自监督学习与权重调整策略的方法,有效捕捉多模态数据的一致性和差异性,提升多模态任务性能。尽管这些方法增强了模态间的交互和对齐,但仍忽视了模态内特征的复杂结构和多模态数据优化的失衡。
3、无论基于rnn还是transformer的多模态融合方法都倾向于简化不同模态信息的交互融合,但往往忽略了模态内部的复杂性。模态内复杂性体现在文本的语义层次、视频的非言语行为细节、音频的声调与情感强度变化等方面。这些微小但关键的特性构成了情感表达的深层结构,简单的融合策略难以精准捕捉这些细微差异,导致模型无法准确理解复杂情感。此外,忽视模态内深层共性限制了模型对共性特征的深入理解和提炼,使模型难以从有限训练样本中抽象出通用情感规律,面对未知或质量较差的数据时性能大幅下降。这就体现出了模型泛化能力的局限性和在捕捉模态内共性特征方面的不足。
4、在探讨多模态模型的训练问题时,常被忽视的一点是各模态数据在优化路径上的不一致。各模态因其基础性能、学习速率、信息丰富度及抗噪声能力的差异,导致在模型训练过程中优化速度参差不齐。这种速度不匹配造成了模态间的优化不平衡,阻碍了模型充分利用每个模态的独特信息,尽管总体上多模态模型可能仍优于单模态模型。
5、因此,随着多模态数据在情感分析中的广泛应用,如何有效整合来自不同模态的信息以提高情感分析的准确性和鲁棒性已成为一个重要的问题。尽管当前使用transformer的融合方法在一定程度上增强了模态间的交互和对齐,但模态内特征复杂性被忽略和多模态数据优化不平衡等问题限制了多模态模型对各模态信息的充分利用。
6、伴随着新一代社交媒体的兴起,人们的观点表达方式正经历着从单一的文字形式向融合文本、面部表情及声音特征的短视频的转变,这种多媒体化的趋势对情感分析提出了新的挑战,即向多模态情感分析的深度发展。
7、在多模态情感分析(msa)的探索历程中,早期的融合策略主要有“早期融合”和“晚期融合”两种模式。早期融合在模型构建初期,将不同模态的数据(如文本、视频、音频)拼接,再送入单模态模型进行特征提取和情感预测。例如,多内核学习方法(multiple kernellearning,mkl)将各模态特征拼接后送入决策层进行情感分类;mfn采用参数独立的长短期记忆网络(long short-term memory,lstm)对每个模态的序列数据建模,以此确保各模态数据在时间轴上的一致性。晚期融合策略则是先对每种模态的数据单独分析和预测,最后依据模态特性和预测结果的相关性加权平均,以得出最终判断。例如,onno kampman等人,对每个模态提取的特征分别进行预测,并在决策层根据情感权重对所有模态的预测结果加权平均。近年来,还发展出了使用更为广泛的多阶段融合方法,如在tfn和分割征服与结合(divide,conquer and combine,dcc)中,通过张量融合生成局部和全局融合张量,减少了冗余信息。
8、随着google提出transformer,预训练模型飞速发展,带动了msa进入新的发展阶段。此时,msa中的方法开始注重使用预训练模型以获取更多、更优质的模态特征。在mag-bert中,直接将所提出的关系与类比视觉传感(relational and analogical visualreasoning,raven)模块添加在bert模型中,得到更好的模态融合表示。在misa、self-mm以及双双模态融合网络(bi-bimodal fusion network,bbfn)中,已经开始使用预训练的bert模型直接从文本中提取特征。
9、在以往的工作中,传统的融合方法无法充分利用各模态内样本间的共性情感信息,而基于transformer的方法又过分依赖上下文关系,在一定程度上忽略了样本间的相似性关系。为了更好地处理样本间的相似关系,充分利用模态内相似样本间的共性情感信息,在我们的工作中使用了更适合处理非欧几里得数据的图卷积网络(gcn)。gcn通过构建样本间的图结构来处理相似关系,利用图的拓扑信息和节点特征进行高效学习。
10、近年来,图卷积网络(graph convolutional network,gcn)作为一种新兴的数据处理技术,因其在处理非欧数据问题上的良好表现,在学术界和工业界得到了广泛关注和应用,在多模态情感分析领域gcn也展现出了其独特的优势。
11、杨某等人引入图注意力机制(graph attention mechanism,gat)用来处理非对齐的多模态语言序列并将其对齐。黄某等人的工作则聚焦于利用图卷积捕捉与整合跨模态的时间依赖性和情感特征。肖某等人进一步深化了情感融合策略,采用多通道注意力图卷积巧妙地综合了不同模态的情感信息。万某等人的研究则探索了知识图谱与异构图卷积的协同作用,特别针对方面级的多模态情感分析。赵某等利用图卷积与异质数据融合技术有效地集成多种模态的信息。谭某等则利用图卷积网络在图像和文本情感分析中融合多模态信息。
12、在上面的工作中可以看出,无论是在数据融合、特征提取还是情感识别等方面,gcn均展现出了其独特的价值。然而,在以往的工作中大多过分专注于模态间的交互与融合,试图通过跨模态信息的互补来提升整体分析的准确性,但却在一定程度上忽视了每个模态内部样本间所蕴含的情感共性,以及这些信息在情感理解中的关键作用。因此,可以通过使用模态内的跨样本图卷积来学习相似样本间的情感特征共性,加深对情感特征的理解。
13、在如今的多模态情感分析(msa)领域,虽然使用多模态联合训练已经成为主流,但杜某和孙某的研究揭示了一个重要问题:即便增加数据量,大部分多模态学习方法的性能提升并不明显。在此基础上,王某等人进一步探讨了多模态联合训练中模态优化速度的不一致性,指出不同模态的收敛速率可能相差甚远,这种不均衡性可能导致多模态模型的整体表现无法超越或仅与单模态模型相当,无法充分发挥多模态学习的优势。此外,winterbottom等人的研究说明了在特定数据集(如基于电视剧视频的问答数据集tvqa)中,模型可能对某一模态(如文本字幕)产生固有偏见。这种偏见源于某模态在数据集中的主导地位,不仅限制了模型的泛化能力,还会引起模态优化的公平性问题。
14、针对多模态学习中的优化不平衡问题,研究者们积极探索,提出了多种解决方案。其中,杜某等人引入外部知识,借助预训练模型中的知识来增强多模态模型的训练,特别是强化单模态编码器,以此来缓解模态间的优化差异,提升整体性能。另一方面,王某等人则从模型过拟合的角度出发,设计了一种基于模型过拟合行为的梯度混合策略。该策略能够根据训练过程中的过拟合现象,动态调整不同模态之间的梯度贡献,以实现优化平衡。
15、在这些研究中,尽管在一定程度上对模态优化进行了平衡,但这两种主要的解决方法仍存在一些问题:通过预训练模型引入外部知识会导致模型的泛化能力下降;针对过拟合现象进行梯度混合无法在模型训练全过程动态调控优化差异。
技术实现思路
1、针对现有多模态情感分析方法存在的两个关键问题:一是未能充分利用模态内部数据中的复杂共性情感信息;二是在多模态模型训练过程中,因不同模态具有不同的优化特性而导致的优化不平衡问题,本发明提出一种基于跨样本图交互网络的多模态情感分析方法,利用多模态动态优化调谐策略在训练的全过程中量化分析各模态间的优化差异,精准识别并动态调控不同模态的优化速度,有效避免了某一模态过快收敛而阻碍整体性能提升的问题,同时保持了模型较好的泛化能力。
2、为了达到上述目的,本发明的技术方案是这样实现的:
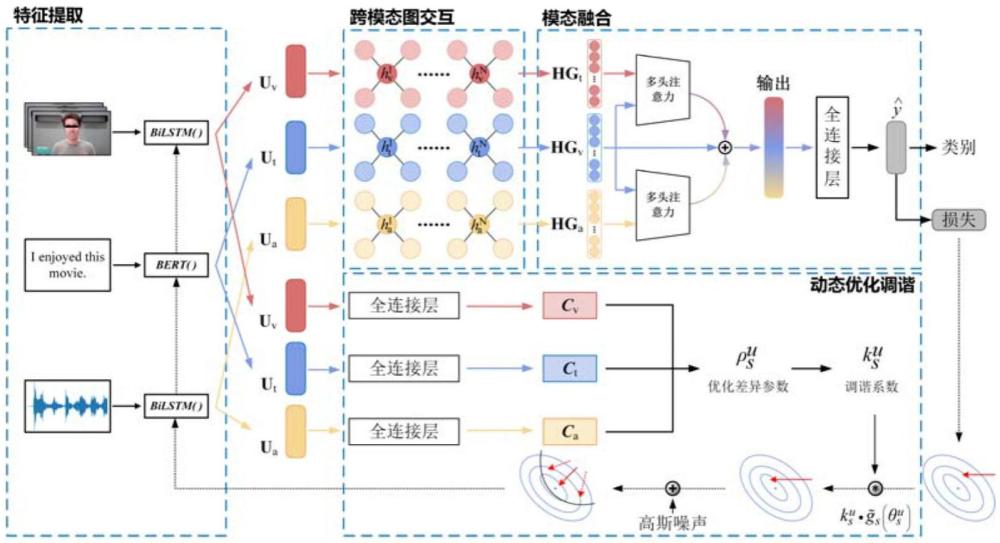
3、将原始视频数据输入到特征提取模块,获得文本模态的语境级模态表征、声学模态的语境级模态表征和视觉模态的语境级模态表征;
4、将所述文本模态的语境级模态表征、声学模态的语境级模态表征和视觉模态的语境级模态表征输入到跨样本图交互模块,获得信息增强的文本模态表征、信息增强的视觉模态表征和信息增强的声学模态表征;
5、将所述信息增强的文本模态表征、信息增强的视觉模态表征和信息增强的声学模态表征输入到动态优化调谐模块得到文本模态、视觉模态和声学模态之间的优化差异和调谐系数,在训练过程中对各模态优化进程实施动态调谐;
6、将所述信息增强的文本模态表征、信息增强的视觉模态表征和信息增强的声学模态表征输入到跨模态交互模块中,获得跨模态交互增强视觉模态表征和跨模态交互增强声学模态表征;
7、将所述信息增强的文本模态表征、跨模态交互增强视觉模态表征和跨模态交互增强声学模态表征输入到模态融合模块得到融合表征;
8、将所述融合辩证输入情感预测模块,输出情感预测结果。
9、一种基于跨样本图交互网络的多模态情感分析方法,包括如下步骤:
10、步骤一:将原始数据集按照一定的比例随机分成训练集、验证集和测试集;
11、步骤二:特征提取模块分别提取训练集中视频数据的文本、视频和音频的特征,得到文本模态、声学模态和视觉模态的语境级模态特征;
12、步骤三:跨样本图交互模块根据各个模态的语境级模态特征计算样本间的语义相似度,根据语义相似度和情感相似度确定各个模态中每个样本的相似样本,每个样本作为中心节点、相似样本作为边缘节点构造跨样本交互图,跨样本交互图经过图卷积处理得到中心节点和边缘节点组成的特征矩阵,根据特征矩阵获得信息增强后的重构特征矩阵;
13、步骤四:动态优化调谐模块根据各模态的重构特征矩阵计算每个模态的单模态性能,根据单模态性能计算模态之间的优化差异,并利用优化差异更新模型参数;
14、步骤五:模态融合模块利用跨模态注意力机制处理文本模态、视觉模态、声学模态的重构特征矩阵,获得跨模态交互增强视觉模态特征和跨模态交互增强声学模态特征,跨模态交互增强视觉模态特征矩阵、跨模态交互增强声学模态特征矩阵和文本模态的重构特征矩阵进行拼接得到融合特征矩阵;最后,利用融合特征计算预测情感得分,根据预测情感得分确定情感预测结果;
15、步骤六:循环步骤二至步骤五利用训练集对特征提取模块、跨样本图交互模块、动态优化调谐模块和模态融合模块组成的多模态情感分析模型进行训练,通过反向传播算法优化模型参数;
16、步骤七:将验证集中视频数据的文本、视频和音频输入训练完成后的多模态情感分析模型中,选择在验证集上损失函数最小的模型参数,作为最终多模态情感分析模型,将测试集中视频数据的文本、视频和音频输入最终多模态情感分析模型,依次经过步骤二、步骤三和步骤五得到情感预测结果。
17、优选地,所述步骤二中特征提取模块分别提取训练集中视频数据的文本、视频和音频的特征的实现方法为:
18、一段原始的视频数据分割成多个小的视频片段,提取视频片段中文本、视频和音频;
19、使用预训练bert模型提取文本中的文本特征,得到文本的初始表示;
20、使用预训练的openface模型从视频片段中视频中提取初始视频特征向量;使用预训练的covarep模型从视频片段中音频提取初始音频特征向量;使用双向长短时记忆网络来分别处理初始视频特征向量和初始音频特征向量捕获上下文时序特性,分别得到视频的初始表示和音频的初始表示;
21、利用各模态的编码器分别处理各个模态的初始表示得到各个模态的语境级模态特。
22、优选地,所述确定各个模态中每个样本的相似样本的方法为:
23、根据样本间的语义相似度构建各个模态的语义相似度矩阵sm,利用样本间的情感相似度构建各个模态的情感相似度矩阵em;其中,m∈{v,t,a}表示视频、文本或音频三种模态;
24、定义两个超参数τf和τs分别表示语义相似度和情感相似度的阈值,通过超参数τf和τs分别对语义相似度矩阵sm和情感相似度矩阵em中的元素进行筛选,生成一个与语义相似度矩阵sm大小相同的掩码矩阵mm,将样本间情感相似度小于超参数τf或情感相似度大于超参数τs的样本对在掩码矩阵mm中对应的位置记为false,将语义相似度矩阵sm中掩码矩阵mm为false的对应位置反向填充为负无穷;选取语境级模态特征um中每个样本的特征表示作为中心节点,每一个中心节点在掩码矩阵mm中找出自身所在行中值不为false的对应列,在语义相似度矩阵sm中找出对应列中与中心节点对应的前k个语义相似度最高的样本作为相似样本
25、优选地,所述预训练bert模型提取文本中的文本特征的方法为:预训练bert模型使用多头注意力对输入的文本it进行自注意力,之后通过前馈层对经过自注意力后的向量进行非线性变换,选择最后一层中的第一个词向量作为整个句子的文本初始表示;
26、所述语义相似度的计算方法为:对每个模态的语境级模态特征进行归一化处理,根据生成的归一化样本特征计算任意两个样本间的余弦相似度作为语义相似度;
27、所述情感相似度为任意两个样本间的真实情感得分的曼哈顿距离;
28、所述跨样本交互图为星型拓扑结构;各个模态中每个样本的跨样本交互图为一个星型拓扑结构的加权无向图其中,顶点集合v的规模为k+1,包括锚样本及其k个相似样本;锚样本为中心节点,其余k个相似样本为边缘节点;边集合ε的规模为k,包含k条表达边缘节点与中心节点相似关系的边;
29、所述加权无向图中的节点包括中心节点和边缘节点其中i∈{1,2,3,…,n},j∈{1,2,3,…,k},n表示样本数量。
30、优选地,所述跨样本交互图经过图卷积处理的计算方法为:
31、
32、其中,为模态m的第i个样本的加权无向图的对称归一化拉普拉斯矩阵,表示加权无向图中中心节点和边缘节点组成的特征矩阵;表示经过图卷积后得到的以第i个样本为中心节点及其边缘节点特征组成的特征矩阵,表示模态m中第i个样本的归一化度矩阵,表示模态m中第i个样本的加权无向图的带自旋边邻接矩阵,带自旋边邻接矩阵为带权邻接矩阵加上单位矩阵;
33、所述带权邻接矩阵中的元素为连接中心节点和边缘节点的边权重:
34、
35、其中,表示模态m内第i个样本的特征表示,表示加权无向图中与中心节点相连的第j个边缘节点的特征表示,arccos表示反余弦函数,similarity表示计算两个节点的余弦相似度。
36、优选地,所述利用优化差异更新模型参数的方法为:将优化差异系数集成到adam优化策略中,迭代时间步s时的模型参数更新为:
37、
38、其中,分别表示时间步s和s+1时的模型参数,表示当前模型参数的梯度,和分别表示时间步s时的一阶矩动量和二阶矩方差的估计值,和是超参数,α为学习率,∈是一个很小的常数;为优势模态,为非优势模态;
39、所述优化差异系数:
40、
41、其中,ξ为用来控制梯度调谐程度的超参数,tanh表示使用tanh函数处理数据;分别表示非优势模态与优势模态之间的优化差异和优势模态与模型整体之间的优化差异。
42、优选地,所述计算每个模态的单模态性能的方法为:将模态m的重构特征矩阵hgm经过softmax函数进行二分类,得到每个样本的真实标签的二分类概率,将二分类概率进行累加求和,得到模态m的单模态性能cm;
43、所述计算模态之间的优化差异的方法为:选取单模态性能最高的模态作为优势模态,其余模态作为非优势模态;通过单模态性能计算非优势模态与优势模态之间的优化差异和优势模态与模型整体之间的优化差异;
44、所述模态m的单模态性能为:
45、
46、所述非优势模态与优势模态之间的优化差异为:
47、
48、所述优势模态与模型整体之间的优化差异为:
49、
50、其中,bs=max(cm)为时间步s的优势模态的单模态性能,m∈{v,t,a},和分别是时间步s下模态m的权重和特征映射函数,代表模态m的第i个样本的经图卷积操作信息增强后的重构特征;表示只取预测类别k等于第i个样本的真实标签yi时的概率,m表示可能预测出的类别总数,softmax表示使用softmax函数处理数据,表示模态m的softmax激活层中的参数,表示非优势模态的单模态性能。
51、优选地,将各模态每个样本的加权无向图中各节点特征组成的特征矩阵中的中心节点的特征表示取出并纵向拼接,生成跨样本交互后的单模态样本序列,得到信息增强后的重构特征矩阵hgm;
52、所述跨模态注意力机制的处理方法为:利用多头注意力将文本模态的重构特征矩阵作为查询,视频模态和音频模态的重构特征矩阵分别作为视频模态和音频模态的键和值进行跨模态交互,分别得到跨模态交互增强视觉模态特征矩阵和跨模态交互增强声学模态特征矩阵;
53、所述融合特征矩阵
54、f=concat(cmav→t,cmaa→t,hgt);
55、其中,cmav→t表示跨模态交互增强视觉模态特征矩阵,cmaa→t表示跨模态交互增强声学模态特征矩阵,hgt表示文本模态的重构特征矩阵;concat表示进行拼接操作的函数;
56、所述利用融合特征计算预测情感得分的方法为:
57、
58、其中,fcout()表示产生模型最终输出的全连接层的处理函数,θout表示全连接层中的参数,relu()表示全连接层中的relu激活函数,wout和bout分别表全连接层中的权重矩阵和偏置项;
59、所述损失函数为:
60、
61、其中,yi代表第i个样本的真实情感得分,为第i个样本的预测情感得分,n个样本的训练集中的样本数。
62、一种计算机设备,包括存储器和处理器,存储器和处理器相连接,所述存储器用于存储计算机程序;所述处理器在调用所述计算机程序时执行所述的基于跨样本图交互网络的多模态情感分析方法。
63、一种计算机可读存储介质,其上存储有计算机程序,所述计算机程序被执行时实现所述的基于跨样本图交互网络的多模态情感分析方法。
64、本发明的有益效果:提出了一种新的多模态情感分析模型---跨样本图交互(csgi-net)模型,该模型由两个核心模块组成:跨样本图交互(csgi)模块和动态优化调谐(dot)模块,csgi模块通过使模态内各样本与其相似样本交互学习,使csgi-net模型能够充分学习相似样本间的情感共性,从而加深对情感特征的理解并提高对噪声的过滤能力。dot模块在训练过程中量化计算各模态间的优化差异,并根据这些差异动态调整优化幅度,使得欠优化的模态获得更多优化机会,从而实现模态间的平衡发展。
65、实验结果表明,本发明的csgi-net模型在cmu-mosei和cmu-mosi这两个多模态情感分析领域重要基准数据集上均表现出优越的性能,特别是在cmu-mosei数据集上达到了当前最先进的性能(sota),其中acc-2和f1-score均达到了90.3%。
66、本发明的csgi-net模型通过学习模态内相似样本间的共性,深度挖掘情感共性特征;同时,在模型训练过程中,通过动态控制各模态的优化过程平衡模态间的优化差异;csgi-net模型不仅强化了对复杂情感的精细理解,而且有效过滤了无关信息,减少了噪声干扰;设计了一种跨样本交互图,跨样本交互图中通过构建每个样本与其相似样本之间的连接,并根据样本间的相关度动态调整权重,从而学习模态内相似样本间的共性特征;设计了一种多模态(文本、视频、音频)动态优化调谐方法,通过在训练过程中动态控制各模态的优化过程,解决了模态间的优化不平衡问题,显著增强了csgi-net模型的泛化能力。同时,动态优化调谐(dot)模块是一个高度灵活的可插拔模块,可以融入现有的多模态框架中,具有良好的通用性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com