
一种机器学习整合网络邻近度的中药方剂适应症筛选方法和系统
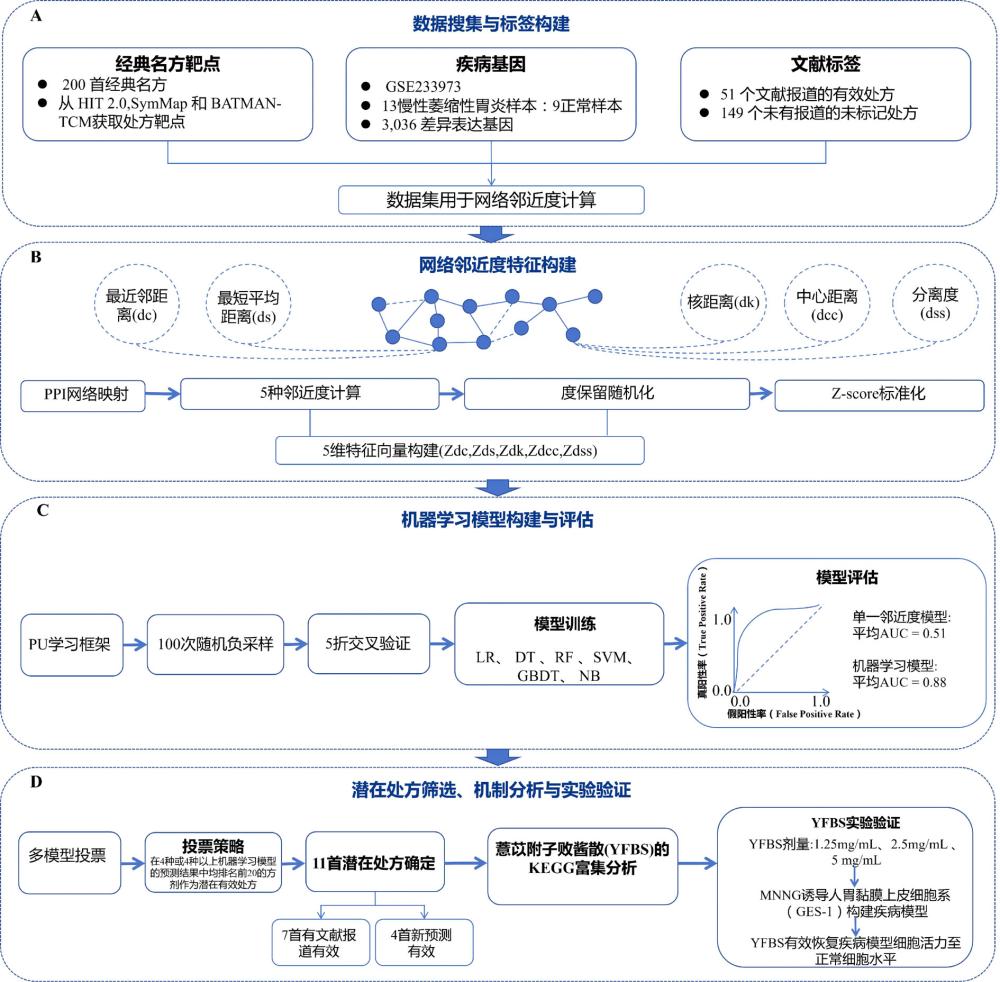
本发明属于中医药生物信息挖掘、网络药理学与机器学习,具体涉及一种机器学习整合网络邻近度的中药方剂适应症筛选方法和系统。
背景技术:
1、国家中医药管理局发布《古代经典名方目录》收录200首汉族传统经典方剂,历经千年临床实践验证,具备稳定、可溯源的临床疗效基础,是创新中药开发的核心资源库。但该类方剂原始主治描述以中医阴阳、脏腑、气血津液等传统术语表述,无法直接对应现代医学疾病分型、病理分期与临床症状,大量经典方剂潜在现代适应症长期处于未开发状态。
2、针对现有经典名方药效研究所采用的回溯式研究范式,即先依靠临床个案、医师经验选定单一方剂开展动物/细胞实验或临床观察,再反向解析分子机制。该模式存在三个技术缺陷:一是筛选通量极低,200首经典名方仅50余首存在针对单一疾病的文献报道,绝大多数方剂缺乏系统性定量评估;二是主观偏差严重,完全依赖研究者临床经验,极易遗漏具备潜在治疗价值但无临床文献支撑的创新候选方剂;三是研发成本高、周期长,盲目开展体内外实验造成大量科研资源浪费,无法实现高通量批量方剂预筛选。例如:专利cn110731997b、cn119833065a均为先依托临床验方、已报道有效方药开展靶点与通路解析,仅对已知有效方剂反向验证机制,不具备面向全目录方剂的前置高通量预筛选能力。
3、以慢性萎缩性胃炎(chronic atrophic gastritis,cag)这类胃癌前病变疾病为例,西医现有干预手段仅包含幽门螺杆菌根除、质子泵抑制剂对症治疗、内镜定期监测,针对已形成的胃黏膜萎缩、肠上皮化生病变无有效逆转手段,长期质子泵抑制剂用药还会提升胃癌发病风险。中药复方多成分、多靶点调控优势适配cag多基因、多通路紊乱病理特征,但行业内缺少可批量从200首经典名方中定量筛选cag适配方剂的标准化计算框架,传统人工筛选模式难以覆盖全部方剂资源。
4、针对网络医学领域提出的网络邻近度算法,即通过量化药物靶点集合与疾病蛋白集合在蛋白质互作网络(protein-protein interaction,ppi)中的拓扑距离,定量表征药物与疾病的匹配程度,已应用于西药药物重定位、抗病毒药物筛选、中药单味药靶点预测场景。然而,现有中医药研究仅采用单一网络邻近度指标开展方剂疗效预测,存在显著技术问题:
5、第一,单一邻近度指标仅能从单一维度刻画靶点网络拓扑关系。常用最近邻距离dc、最短平均距离ds、核距离dk、中心距离dcc、分离度dss五类指标分别侧重局部邻域距离、全局平均路径、指数衰减关联、中心节点偏移、组间整体分离度,单指标仅捕捉局部信息,特征信息存在严重缺失;
6、第二,预测精度极差,单一网络邻近度指标分类auc均值仅0.51左右,接近随机预测水平,无法实现有效区分;
7、第三,未消除ppi网络无标度拓扑偏差。原始网络距离受靶点基因度分布干扰,未通过度保留随机化校正,计算结果存在系统性偏移;
8、第四,无标准化特征融合方案,无法将多维度邻近度特征进行统一整合,缺乏标准化特征向量输入框架。
9、现有少量研究尝试将网络邻近度用于中药注射液疗效评估,但仅局限单味中药、单类注射制剂,未构建适配多靶点复方、适配无标签方剂数据集的标准化流程,不存在针对整套经典名方目录、融合多机器学习模型、配套机制解析与体外实验验证的完整筛选体系。例如,现有涉及网络邻近度的中医药计算专利(cn117789857a、cn121215092a)仅采用单维度网络距离指标开展方药匹配,仅计算单一最近邻距离dc完成方剂与疾病关联打分,未构建五维互补拓扑特征向量。
10、此外,针对现有中药靶点、方剂疗效预测机器学习模型,存在如下四个技术缺陷:
11、(1)监督学习标签噪声问题:传统二分类模型将无文献报道方剂全部标记为阴性样本,但“无文献”不等于“无药效”,大量潜在有效新方剂被错误标注为阴性,训练模型引入不可逆标签噪声,大幅降低预测准确率;
12、(2)模型单一化,算法鲁棒性不足:仅采用随机森林、svm单一机器学习模型,受算法固有偏好影响,输出结果偶然性强,无多模型共识投票降噪机制,假阳性、假阴性样本占比高;
13、(3)特征体系单薄,仅依托中药成分、靶点数量简单特征,未融合多维网络拓扑定量特征,缺少可表征方剂-疾病全局分子关联的高维特征输入;
14、(4)模型验证体系残缺:仅依靠roc曲线完成计算层面性能验证,未配套疾病临床症状靶向映射、kegg通路分子机制解析、体外细胞模型药效定量验证三重验证链条,筛选结果可信度不足,无法直接支撑后续药物研发。
15、例如,公开机器学习中药筛选专利cn121215092a、cn119833065a仅采用单一种类机器学习模型(随机森林或svm)开展复方药效预测,特征仅依托中药成分理化、配伍频次数据,并未融合多维网络邻近度拓扑特征。
16、针对当前中医药生物信息工具、机器学习建模工具、细胞实验统计工具相互独立,分属不同软件平台,需要人工跨平台导出、导入数据的情况,存在操作流程繁琐、易出现数据泄露、数据格式转换错误;不存在一套一体化硬件软件协同系统,无法同步完成数据采集、特征计算、模型训练、候选方剂筛选、机制富集、细胞实验数据分析全流程自动化运算,科研人员操作门槛高,难以规模化推广使用等技术问题。
17、此外,现有网络药理学仅分析方剂与整体疾病的靶点关联,忽略了疾病伴随核心临床症状的分子靶点特征。同一疾病不同临床症状对应完全独立的基因调控网络,传统技术无法定量匹配方剂对胃痛、恶心、食欲不振等单一症状的靶向适配能力,不能实现“疾病整体+细分症状”双层精准方剂匹配,临床指导价值受限。
技术实现思路
1、有鉴于此,本发明的一个目的在于提供一种机器学习整合网络邻近度的中药方剂适应症筛选方法和系统。
2、本发明采用如下技术方案实现上述目的。
3、一方面,本发明提供一种机器学习整合网络邻近度的中药方剂适应症筛选方法,包括如下步骤:
4、s1,数据采集与标签构建步骤:分别采集目标中药方剂集的中药方剂靶点数据集、目标疾病的疾病基因数据集和文献标签数据集,数据标准化预处理,构建模型输入样本集;
5、s2,多维度网络邻近度特征构建步骤:基于蛋白质-蛋白质相互作用ppi网络,计算每一首目标中药方剂与目标疾病之间的多种原始网络邻近度指标,通过度保留随机化策略对全部原始网络邻近度指标进行z-score标准化,生成每首中药方剂对应的多维标准化网络邻近度特征向量;
6、s3,机器学习集成建模与模型性能评估步骤:以所述多维标准化网络邻近度特征向量为输入特征,构建多类异构机器学习回归模型,采用正样本-未标记pu学习框架,基于所述模型输入样本集和独立负采样迭代与分层交叉验证进行模型训练,以auc-roc为评价指标完成多模型性能评估,并量化计算各网络邻近度指标在各机器学习模型内的特征重要性;
7、s4,多模型共识投票候选方剂筛选步骤:对每一种机器学习模型按预测疗效分值对全部中药方剂降序排序,提取各模型排名前预设位次的方剂集合,将同时被超过半数机器学习模型纳入前预设位次的方剂判定为目标疾病高置信度候选中药方剂;
8、s5,候选方剂机制解析步骤:对筛选得到的高置信度候选中药方剂,依次开展症状靶点网络邻近度映射、kegg通路富集分析,获得候选方剂作用于目标疾病及对应临床症状的分子作用通路;
9、s6,体外细胞模型验证步骤:选取多模型共识投票结果稳定的候选中药方剂制备冻干粉,构建化学诱导的胃黏膜上皮细胞损伤模型,采用cck-8检测法验证候选方剂对损伤细胞的保护活性,完成筛选结果生物学验证。
10、根据本发明所述的方法,优选地,所述s1具体包括:
11、s11,中药方剂靶点数据集采集子步骤:获取官方经典名方目录内全部方剂的药物组成,依据药典规范统一中药名称,联合多套中药靶点数据库合并去重,得到每首方剂对应的靶点基因集;
12、s12,目标疾病的疾病基因数据集采集子步骤:检索geo公共基因表达数据库,筛选含病理确诊疾病样本与正常对照样本的人源组织芯片数据集,采用差异表达分析筛选满足阈值标准的差异表达基因,作为所述目标疾病的疾病基因数据集;
13、s13,文献标签构建子步骤:检索学术数据库,筛选原始实验类文献,将文献证实对目标疾病有效的中药方剂标记为阳性样本,剩余方剂标记为未标记样本,构建pu学习标签数据集;
14、s14,样本集划分子步骤:每次模型迭代训练时,从未标记样本中等量随机抽取样本作为训练负样本,独立重复预设次数随机负采样流程,生成多组训练样本子集。
15、根据本发明所述的方法,优选地,所述s2具体包括:
16、s21,原始网络邻近度计算子步骤:基于标准化的蛋白质-蛋白质相互作用ppi网络,分别计算所述中药方剂靶点数据集与所述目标疾病的疾病基因数据集之间的最近邻距离dc、最短平均距离ds、核距离dk、中心距离dcc、分离度dss五种原始网络邻近度指标;
17、s22,度保留随机化校正子步骤:针对每一首中药方剂的原始靶点集合,生成预设数量与原始靶点度分布一致的随机参考靶点集,分别计算所述随机参考靶点集与所述目标疾病的疾病基因数据集的所述五种原始网络邻近度指标,并确定各类指标的随机分布均值与标准差;
18、s23,z-score标准化子步骤:按照公式对每一项原始网络邻近度指标进行标准化,生成由zdc、zds、zdk、zdcc、zdss构成的五维标准化特征向量,作为机器学习模型输入特征。
19、根据本发明所述的方法,优选地,所述s3具体包括:
20、s31,异构机器学习模型构建子步骤:以所述多维标准化网络邻近度特征向量为输入特征,构建线性回归lr、决策树dt、随机森林rf、支持向量机svm、梯度提升决策树gbdt和朴素贝叶斯nb六类异构机器学习回归模型;
21、s32,分层交叉验证训练子步骤:每次负采样迭代内采用五折分层交叉验证,各折内部仅基于训练子集拟合标准化参数并统一变换训练和验证集数据,规避数据泄露;
22、s33,模型性能对比子步骤:单独以每一类原始标准化网络邻近度指标作为单特征分类模型,采用相同交叉验证流程s32计算单指标模型auc;同步计算全部六类异构机器学习回归模型的验证集auc,基于所述单指标模型auc和所述验证集auc,通过显著性检验对比单指标模型与集成模型的预测性能差异;
23、s34,特征重要性量化子步骤:针对不同类型机器学习回归模型采用对应特征贡献度计算规则,归一化全部特征重要性数值,完成五类网络邻近度指标的贡献度排序。
24、根据本发明所述的方法,优选地,所述s34中不同类型机器学习回归模型的特征重要性数值的计算规则包括:
25、线性回归lr取回归系数绝对值;决策树dt、随机森林rf、梯度提升决策树gbdt采用节点分裂残差/均方误差下降累积贡献;朴素贝叶斯nb取不同类别下特征分布均值差值绝对值;支持向量机svm采用特征置换auc衰减幅度衡量重要性。
26、根据本发明所述的方法,优选地,所述s4具体包括:
27、s41,单模型方剂排序子步骤:每一种机器学习回归模型输出全部中药方剂的疗效预测分值,依据分值从高至低完成方剂排序,提取各模型排序前20位的方剂形成单模型候选集;
28、s42,多模型共识判定子步骤:统计每一首方剂进入各单模型前20候选集的模型数量,将同时被不少于4类机器学习回归模型纳入前20位次的方剂定义为高置信度候选方剂;
29、s43,候选方剂分类子步骤:将所述高置信度候选方剂划分为文献已验证阳性方剂和未报道新预测方剂两类,分别输出两类方剂清单。
30、根据本发明所述的方法,优选地,所述s5具体包括:
31、s51,症状靶点富集筛选子步骤:基于疾病临床诊疗共识提取目标疾病核心临床症状,检索所述目标疾病核心临床症状的对应靶点基因集,采用ssgsea富集分析结合秩和检验筛选在疾病样本中显著富集的目标症状;
32、s52,症状-方剂邻近度投票子步骤:计算候选方剂与各显著富集症状靶点集的五类标准化网络邻近度,单指标排名第一则方剂对该症状计1票,得票最高方剂作为对应症状最优适配方剂;
33、s53,推定靶点追溯子步骤:选取所述不同类型机器学习回归模型中特征重要性排名首位的网络邻近度指标,对候选方剂每一个靶点匹配网络距离最近的疾病蛋白,去重合并得到方剂推定疾病治疗靶点,同步取方剂推定靶点与症状靶点交集得到推定症状靶点;
34、s54,kegg通路富集子步骤:分别对所述推定疾病治疗靶点和所述推定症状靶点开展kegg通路富集分析,采用多重检验校正筛选显著富集信号通路,定位方剂调控疾病及对应症状的核心共同通路。
35、根据本发明所述的方法,优选地,所述s6具体包括:
36、s61,候选方剂冻干粉制备子步骤:依据经典名方法定剂量配比中药材,经水提、浓缩、冷冻干燥制备候选方剂冻干粉;
37、s62,造模浓度与给药安全浓度筛选子步骤:梯度设置化学损伤诱导剂浓度处理黏膜上皮细胞,选取细胞存活率降至50%左右的诱导剂浓度作为造模浓度;梯度设置方剂冻干粉给药浓度,将细胞存活率≥80%的浓度区间确定为安全给药区间;
38、s63,分组干预与cck-8检测子步骤:设置空白组、正常对照组、模型损伤组、方剂低/中/高剂量干预组,多复孔同步培养,经诱导损伤、方剂干预后加入cck-8试剂检测吸光度,计算各组细胞存活率;
39、s64,统计学差异分析子步骤:采用正态性检验、单因素方差分析或非参数检验对比模型组与各给药组细胞存活率,验证候选方剂对损伤上皮细胞的剂量依赖性保护作用。
40、根据本发明所述的方法,优选地,所述方法全部数据处理、建模、绘图流程基于python与r语言编程实现,python调用networkx、scikit-learn工具包,r调用limma、clusterprofiler生物信息分析包;全部统计检验双侧检验,检验水准α=0.05。
41、另一方面,本发明还提供一种机器学习整合网络邻近度的中药方剂适应症筛选系统,用于实施第一方面的方法,包括:
42、数据采集与标签构建模块,用于执行数据采集与标签构建步骤:分别采集目标中药方剂集的中药靶点数据集、目标疾病的疾病基因数据集和文献标签数据集,完成数据标准化预处理,构建模型输入样本集;
43、多维网络邻近度特征生成模块,用于执行多维度网络邻近度特征构建步骤:基于蛋白质-蛋白质相互作用ppi网络,计算每一首目标中药方剂与目标疾病之间的多种原始网络邻近度指标,通过度保留随机化策略对全部原始网络邻近度指标进行z-score标准化,生成每首中药方剂对应的多维标准化网络邻近度特征向量;
44、机器学习集成建模评估模块,用于执行机器学习集成建模与模型性能评估步骤:以所述多维标准化网络邻近度特征向量为输入特征,构建多类异构机器学习回归模型,采用正样本-未标记pu学习框架,基于所述模型输入样本集和独立负采样迭代与分层交叉验证进行模型训练,以auc-roc为评价指标完成多模型性能评估,并量化计算各网络邻近度指标在各机器学习模型内的特征重要性;
45、多模型共识方剂筛选模块,用于执行多模型共识投票候选方剂筛选步骤:对每一种机器学习模型按预测疗效分值对全部中药方剂降序排序,提取各模型排名前预设位次的方剂集合,将同时被超过半数机器学习模型纳入前预设位次的方剂判定为目标疾病高置信度候选中药方剂;
46、方剂分子机制解析模块,用于执行候选方剂机制解析步骤:对筛选得到的高置信度候选中药方剂,依次开展症状靶点网络邻近度映射、kegg通路富集分析,获得候选方剂作用于目标疾病及对应临床症状的分子作用通路;
47、体外验证数据解析模块,用于执行体外细胞模型验证步骤:选取多模型共识投票结果稳定的候选中药方剂制备冻干粉,构建化学诱导的胃黏膜上皮细胞损伤模型,采用cck-8检测法验证候选方剂对损伤细胞的保护活性,完成筛选结果生物学验证。
48、本发明的方法和系统的有益效果:
49、1、本发明融合五类互补网络邻近度构建五维特征向量,结合六类异构机器学习模型集成学习,预测平均auc由0.51提升至0.88,显著提升经典名方适应症筛选准确度。
50、2、引入pu正样本-未标记学习与100次独立负采样迭代,规避传统监督学习将无文献方剂误标为阴性带来的标签噪声,保留潜在有效新方剂信号,筛选效率为随机筛选的2.4倍。
51、3、采用多模型≥4/6共识投票策略,降低单一算法偏好造成的假阳性;区分文献已验证、新预测两类候选方剂,适配不同中药研发方向。
52、4、搭建“疾病整体-细分临床症状”双层解析流程,可定量匹配方剂对胃痛、恶心等症状适配性,并追溯推定靶点、挖掘共有调控通路,机制解释贴合临床表征。
53、5、配套标准化复方冻干粉制备、细胞损伤模型及cck-8验证流程,实现计算筛选到体外生物学验证闭环,预测结果具备细胞实验支撑。
54、6、整套方法不绑定特定疾病与方剂库,参数、软件版本固定可复现;配套模块化系统,减少人工跨平台数据处理,降低中医药交叉生物信息分析操作门槛。
55、
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com