
一种基于变分自编码器的RNA家族序列从头设计方法
本发明涉及人工智能学与核酸序列设计,具体涉及一种基于变分自编码器的rna家族序列从头设计方法。
背景技术:
1、核糖核酸(rna)早已超越了其作为dna与蛋白质之间单纯信使的经典角色,正逐渐成为众多生物学过程中的关键参与者,其作用涵盖基因调控、催化反应乃至免疫应答等多个方面。这种功能上的多样性在现代治疗应用中得到了生动体现。例如,针对严重急性呼吸综合征冠状病毒2(sars-cov-2)的工程化mrna疫苗在预防2019冠状病毒病(covid-19)方面展现出了卓越的疗效;而经过理性设计的rna适配体也成功展现出了荧光活性。这些实例充分表明,通过序列设计赋予rna的可编程性,已使其站在了新一代治疗手段与合成生物学工具的最前沿。
2、尽管前景广阔,但rna的从头设计(de novo design)仍是一项巨大的挑战。rna分子的功能与其三维结构有着密不可分的联系,而三维结构又由其一级核苷酸序列和二级结构共同决定,要想设计出一条既能折叠成目标结构,又具备所需功能特性的序列,就必须在生物物理稳定性与进化合理性这双重约束下,于极其庞大的序列空间中进行探索。传统方法将rna设计视为一个“逆向折叠”(inversefolding)问题:即寻找一条能够折叠成预设二级结构(对应最低自由能构象)的核苷酸序列。这些方法高度依赖基于物理学的热力学模型,因此往往会忽略关键的生物学特征,例如在天然rna家族中观察到的保守序列基序(sequencemotifs)和进化约束。近年来,机器学习(尤其是大语言模型)通过实现直接从大规模生物数据集中学习复杂的“序列-结构-功能”关系的数据驱动方法,引发了一场范式转变。这催生了一批具备功能感知能力的新型rna设计框架,rnagg是一种用于生成rna家族序列的、基于语法的代表性框架,该框架将源自无歧义g4语法的改进型随机上下文无关文法(scfg)与变分自编码器(vae)相结合。在rnagg中,rna序列及其二级结构首先被联合表示为一棵解析树,随后被编码为一个二值矩阵b。关键在于,该矩阵被划分为两个独立的组件:bn(核苷酸序列的独热编码)和bg(由文法衍生的结构规则的独立编码)。尽管该方法通过文法在形式上捕捉了rna二级结构的层次性,但其根本局限在于这种割裂的表示方式:序列(bn)和结构(bg)在vae中被作为独立的通道进行处理。这种分离掩盖了核苷酸身份与结构上下文之间固有的、协同进化的耦合关系——而这种关系对于维持生物学真实性至关重要。此外,它还使解码过程变得复杂,需要使用动态规划算法从独立解码的bn和bg组件中重构出有效的解析树,以最大化一个复合评分。因此,本领域迫切需要一种解决现有技术中序列与结构表征分离、生成序列与自然家族序列相似度低问题的方法。
3、公开号cn121215034a公开了一种基于核酸语言模型的核酸从头设计模型的构建方法,所述方法包括使用selex数据微调后的核酸语言模型对输入数据进行编码,将输入数据转化为高维低偏差的隐藏空间,并利用线性层将隐藏空间转换为低维低噪声的隐空间向量;利用ehebo算法和亲和力先验数据对隐空间向量进行筛选,从而获得亲和力最优的隐空间向量;进一步,利用线性层和自注意力层对亲和力最优的隐空间向量进行解码,从而生成候选序列,该方法未考虑生成结果的稳定性,及推理的合理性。
技术实现思路
1、为现有技术中序列与结构表征分离、生成序列与自然家族序列相似度低的问题,从而实现高保真度的rna家族序列从头设计,本发明提供一种基于变分自编码器的rna家族序列从头设计方法。
2、为实现上述目的,本发明采用以下技术方案:
3、一种基于变分自编码器的rna家族序列从头设计方法,包括以下步骤:
4、s1:获取rna家族的多序列比对数据及其对应的二级结构数据,并进行筛选;
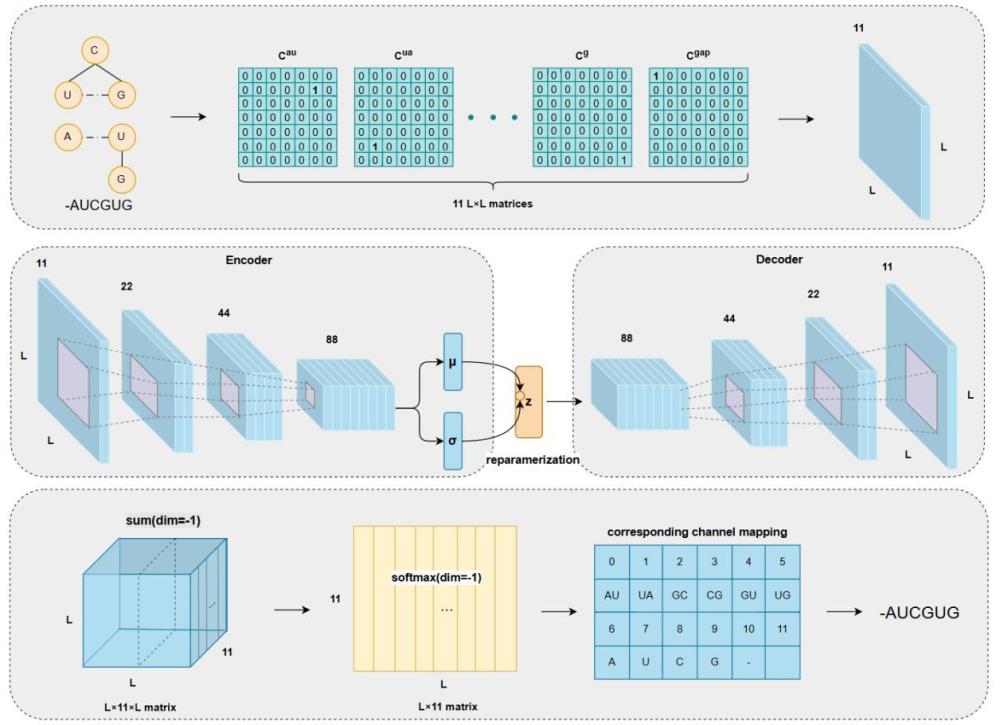
5、s2:将多序列比对数据和二级结构数据联合编码为二维矩阵;
6、s3:构建变分自编码器模型,所述变分自编码器模型的编码器部分采用二维卷积神经网络;所述变分自编码器模型的解码器部分采用二维转置卷积神经网络;
7、s4:训练变分自编码器模型,模型的损失由重构损失和kl散度组成,并通过调节超参数β来平衡重构损失和kl散度正则化项;
8、s5:进行随机抽样,并利用所述变分自编码器模型的解码器输出生成的二维矩阵,并通过以下方式转换为rna序列:对碱基配对通道进行对称化处理,强制满足碱基配对的物理约束;在空间维度上求和并应用softmax函数,确定每个位置的最大概率符号;根据符号映射规则输出最终的rna核苷酸序列。
9、3.进一步地,步骤s1中,所述筛选包括剔除了以下序列:包含非规范字符的序列;重复序列;以及无法被g4语法解析的序列,以及无法被扩展的g4语法解析的序列,扩展的g4语法如下:
10、
11、其中
i,
j为序列核苷酸位置,
s,
t,
u为非终止符,
n,为配对的核苷酸,。
12、进一步地,步骤s2中,所述二维矩阵为一个11通道的二维矩阵,包括6个碱基配对通道和5个单核苷酸状态通道。
13、进一步地,步骤s2中,将序列中配对的氨基酸进行编码,每个配对的氨基酸对应一个l×l矩阵,若氨基酸x在序列中的位置为i,氨基酸y在序列中的位置为j,并且,则矩阵在i行和j列位置上的元素为1,其他位置元素为0;根据对称性,yx配对的氨基酸对应的矩阵。
14、进一步地,步骤s2中,将序列中未配对的氨基酸进行编码,每个未配对的氨基酸对应一个l×l矩阵;若氨基酸
x在序列中的位置为i,并且,则矩阵在i行和i列的对角线位置上的元素为1,其他位置元素为0。
15、进一步地,步骤s3中,编码器包含三个连续的二维卷积层,通道维度分别为22、44和88;解码器包含三个连续的二维转置卷积层,通道维度分别为44、22和11。
16、进一步地,步骤s4中,重构损失采用dice损失,计算方式为:其中g,t分别表示生成的矩阵和真实矩阵。
17、进一步地,步骤s4中,kl散度计算公式为:其中,为第i个样本潜在空间均值和标准差。
18、进一步地,步骤s5中,具体转化方式为:对碱基配对通道进行对称化处理,强制满足碱基配对的物理约束关系,其中和通过vae恢复后的通道;交换第一维和第二维,矩阵的维度尺度变为l×11×l,并在第三维度上求和应用softmax函数,并通过argmax计算索引,确定每个位置的最大概率符号,计算公式为,m是求和后的矩阵;根据符号映射规则输出最终的rna核苷酸序列;沿着第一维,对于l中每个位置都有1个整数索引,根据氨基酸对和单氨基酸整数编码关系,将整数索引映射到氨基酸,若整数索引对应的是氨基酸对,则取氨基酸对的第一个氨基酸。
19、进一步地,步骤s5后还包括,s6:对生成的序列进行去重,移除与训练集重复和自身重复的序列,使用infernal软件中cmalign家族的cm模型,计算bitscore得分,计算生成序列与种子序列的apni。
20、与现有技术相比,本发明的有益效果在于:
21、本发明生成的序列中位数比特评分(bit score)显著高于现有技术(如rnagg),表明其更符合目标rna家族的协方差模型,本发明生成的序列与自然种子序列的平均成对比对一致性(apni)更高,且方差更低,说明生成结果更稳定、更接近天然生物学特征,相较于基于解析树的复杂解码算法,本发明基于矩阵运算的卷积神经网络具有更高的训练和推理效率。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com