
一种基于蛋白质语言模型和迁移学习筛选高活性麦芽四糖生成酶突变体的方法
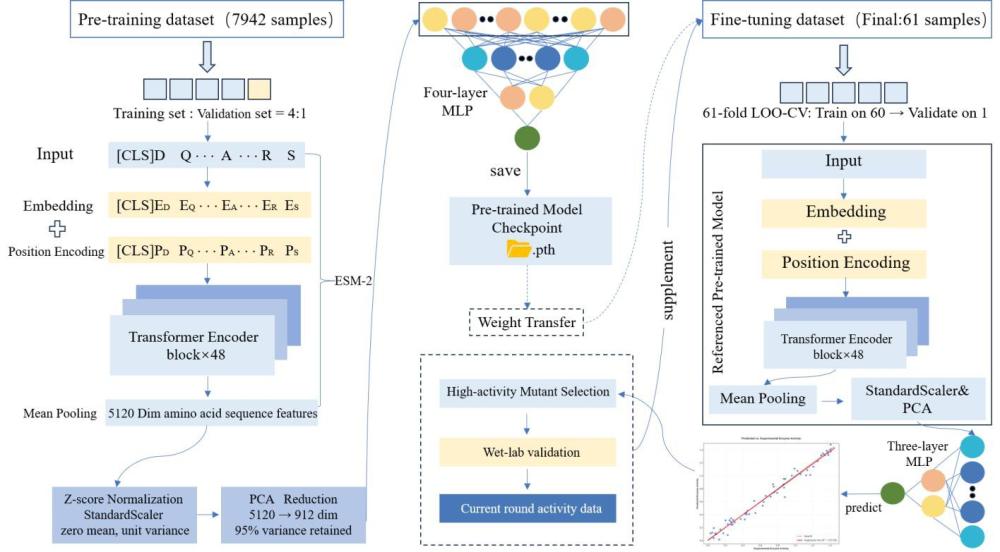
本发明涉及一种基于蛋白质语言模型和迁移学习筛选高活性麦芽四糖生成酶突变体的方法,属于酶工程、蛋白质工程、人工智能辅助蛋白质设计、食品生物技术和淀粉深加工领域。
背景技术:
1、麦芽四糖是由四个葡萄糖单元通过-1,4糖苷键连接形成的直链麦芽低聚糖,具有低甜度、良好水溶性、适宜黏度和较好加工适应性,在食品加工和功能性配料领域具有应用价值。酶法制备麦芽四糖具有反应条件温和、绿色环保和底物适应性较强等优点,其中麦芽四糖生成酶的催化活性直接影响产物生成效率和生产成本。
2、来源于
pseudomonas saccharophila stb07的麦芽四糖生成酶mfaps酶是生产直链麦芽四糖的重要酶制剂。去除或截短碳水化合物结合结构域后获得的 mfaps-δcbm 具有较好的产物特异性和进一步改造潜力。然而,现有麦芽四糖生成酶在催化活性和工业化应用效率方面仍有提升空间。
3、传统酶分子改造主要包括理性设计、半理性设计和定向进化。理性设计依赖对蛋白质三维结构、催化机制和关键残基的深入理解;定向进化通常需要构建和筛选大量突变体,实验工作量大、周期长、成本高。对于mfaps酶等工业酶,突变体实验数据积累有限,直接从头训练深度学习模型容易过拟合,单纯依赖经验突变或全空间筛选也难以高效获得正向突变体。
4、随着蛋白质语言模型和机器学习技术的发展,基于序列表征和数据驱动模型的突变体预测为酶工程提供了新的技术路径。但现有方法若仅停留在计算筛选层面,可能缺乏足够的实际产品或突变体落脚点;若仅保护单一突变体,又可能难以充分体现突变体获得过程中的计算筛选技术贡献。因此,有必要将小样本突变体筛选方法与经实验验证的高活性突变体进行结合,形成兼具方法创新和具体技术效果的保护方案。
技术实现思路
1、1、技术问题
2、本发明要解决的技术问题是:现有 mfaps酶突变体筛选效率低、实验成本高;目标酶突变体数据少,从头建模难以稳定预测高活性突变体;同时,单纯计算方法缺少明确高活性突变体落脚点。
3、2、本发明方案
4、本发明提供一种将蛋白质语言模型、源域预训练、目标域迁移学习、分子动力学模拟和主动学习实验反馈相结合的高活性麦芽四糖生成酶突变体筛选方法,并通过该方法获得e160a高活性突变体。
5、一种基于蛋白质语言模型和迁移学习筛选高活性麦芽四糖生成酶突变体的方法,包括:
6、步骤s1,获取源域突变效应数据集和目标酶候选突变体序列;
7、步骤s2,利用蛋白质语言模型分别提取源域样本和目标酶候选突变体的序列表征;所述源域样本为源域突变效应数据集中的样本;
8、步骤s3,对所述序列表征进行标准化和降维处理,获得突变体特征向量;
9、步骤s4,利用所述源域突变效应数据集对突变体活性预测模型进行预训练,获得源域预训练模型;
10、步骤s5,利用目标域数据集对所述源域预训练模型进行迁移学习,获得目标酶突变体活性预测模型;所述目标域数据集中为目标酶湿实验标记数据;
11、步骤s6,通过分子动力学模拟分析目标酶与底物复合物的构象稳定性、柔性区域和酶-底物相互作用,确定候选突变区域;
12、步骤s7,利用步骤s5得到的优化后的目标酶突变体活性预测模型对候选突变区域内的候选突变体进行粗酶液相对酶活预测,并根据预测结果筛选候选突变体进行实验以便后续采用主动学习策略对目标酶突变体活性预测模型进行参数优化;
13、步骤s8,采用主动学习策略将步骤s7中实验获得的粗酶液相对酶活数据补充至目标域数据集中,更新所述目标酶突变体活性预测模型;
14、步骤s9,重复步骤s7和步骤s8,直至目标域数据集中的样本数达到预定值,利用最终更新后的目标酶突变体活性预测模型筛选高活性突变体。
15、可选的,所述步骤s1中源域突变效应数据集为包含单氨基酸替换序列及其相对功能活性标签的蛋白质突变数据集;优选地,所述源域突变效应数据集为 ascas12f 深度突变扫描数据集。
16、可选的,所述步骤s1中目标酶为麦芽四糖生成酶;优选地,目标酶候选突变体为来源于
pseudomonas saccharophila stb07 的麦芽四糖生成酶截短体mfaps-δcbm。
17、可选的,所述步骤s2中蛋白质语言模型包括 esm-2、esm-1b、prott5、protbert、progen、tranception 或其功能等同模型;优选地,所述蛋白质语言模型为 esm-2。
18、可选的,所述步骤s3中采用 z-score 标准化和主成分分析降维。
19、可选的,所述步骤s4中突变体活性预测模型包括全连接神经网络、多层感知机、随机森林、梯度提升树、支持向量回归、图神经网络或其组合;优选地,所述突变体活性预测模型为多层感知机回归模型。
20、可选的,所述多层感知机回归模型以降维后的突变体特征向量作为输入,以突变体粗酶液相对酶活作为输出标签。
21、可选的,所述分子动力学模拟包括对目标酶-底物复合物进行 rmsd、rmsf、蛋白-配体氢键和残基间相互作用分析,并根据活性口袋周边柔性区域、底物结合位置和酶-底物相互作用确定候选突变区域。
22、可选的,所述主动学习策略每轮根据预测粗酶液相对酶活值选择 10-20 个候选突变体进行湿实验验证;优选地,每轮选择 15 个候选突变体。
23、可选的,所述目标酶湿实验标记数据为目标酶单点突变体的粗酶液相对酶活数据。
24、可选的,所述步骤s6中确定的候选突变区域包括位点66-70、77-80和158-161。
25、本发明的第二个目的在于提供一种高活性麦芽四糖生成酶突变体,所述突变体由上述方法筛选获得,或在氨基酸序列如seq id no.1所示的麦芽四糖生成酶亲本酶基础上,将其氨基酸序列中对应第 160 位的谷氨酸 e 突变为丙氨酸 a。
26、可选的,氨基酸序列如seq id no.1所示的麦芽四糖生成酶亲本酶的编码核苷酸序列如seq id no.2所示;该麦芽四糖生成酶为来源于
pseudomonas saccharophila stb07的麦芽四糖生成酶截短体 mfaps-δcbm。
27、可选的,麦芽四糖生成酶突变体的氨基酸序列如seq id no.3所示。
28、本发明的第三个目的在于提供一种编码任一上述麦芽四糖生成酶突变体的基因。
29、本发明的第四个目的在于提供一种携带上述基因的载体。
30、可选的,所述载体包括质粒pp43nmk。
31、本发明的第五个目的是提供一种表达任一上述麦芽四糖生成酶突变体的重组细胞。
32、可选的,所述重组细胞是以枯草芽孢杆菌或大肠杆菌为宿主。
33、可选的,所述重组细胞是以
bacillus subtilis wb600为宿主。
34、本发明的第六个目的是提供任一上述的麦芽四糖生成酶突变体或上述基因或任一上述载体或任一上述重组细胞在医药生产、化工或食品生产中的应用。
35、可选的,所述应用包括制备麦芽四糖。
36、本发明有益效果是:
37、(1)本发明通过源域预训练和目标域迁移学习缓解了mfaps酶突变体样本不足导致的模型过拟合问题,提高了小样本条件下的突变体筛选能力。
38、(2)本发明结合分子动力学模拟和酶-底物相互作用分析限定候选突变区域,减少无关位点筛选,提高突变体筛选针对性。
39、(3)本发明通过主动学习将模型预测与湿实验验证形成闭环,在有限实验通量下逐轮补充目标域数据并更新模型。
40、(4)本发明不仅提供计算筛选方法,还提供采用上述方法筛选得到且经实验验证的高活性e160a突变体,具有明确的酶活提升效果和应用落脚点。
41、(5)本发明所述e160a突变体在粗酶液酶活和比酶活方面均较mfaps-δcbm提升(实验验证表明,e160a 的粗酶液酶活较 mfaps-δcbm 提高约 26%,比酶活提高约 18%,比酶活达到 4643.55 u/mg),可用于麦芽四糖制备和工业酶催化性能提升。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com