
一种基于血清代谢、多肽标志物的食管癌判别方法及其应用
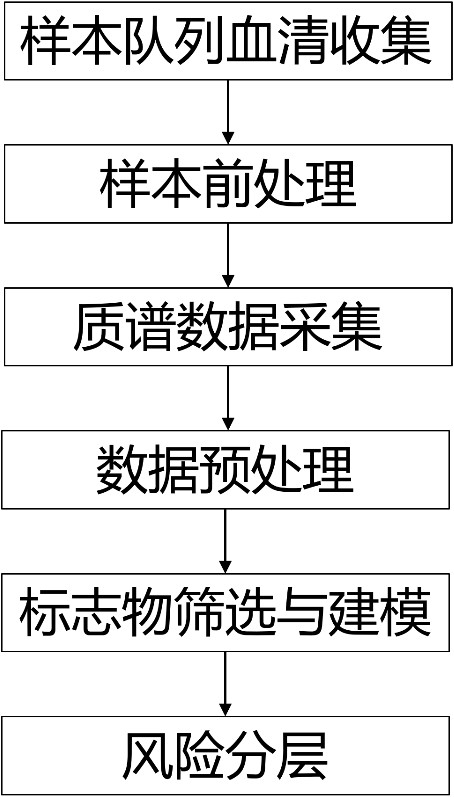
本发明涉及生物,具体涉及一种基于血清代谢、多肽标志物的食管癌判别方法及其应用。
背景技术:
1、食管癌是全球最常见的恶性肿瘤之一。食管癌由于早期缺乏特异性临床表现,大多数患者被诊断时已处于中晚期,治疗选择有限,预后不佳。目前食管癌筛查和诊断的“金标准”为上消化道内镜检查结合病理活检。然而,内镜检查具有侵入性、操作依赖专业人员、成本较高、患者耐受性差等显著缺点,不适宜在大规模无症状人群中普筛。液体活检作为一种新兴的无创检测手段,通过检测外周血中的循环肿瘤标志物,有望在各类肿瘤的早期诊断中发挥重要作用。但从临床实际需求来看,目前液体活检在食管癌筛查中的应用仍面临敏感性不足的技术瓶颈。
2、多肽组学是研究生物体内源性多肽的组学技术。与主要关注完整蛋白的蛋白质组学不同,多肽组学的优势在于,它可以直接分析那些由细胞内特定酶切产生的天然活性肽段,而这些肽段往往直接参与疾病过程中的信号传递,能够更实时地反映生理或病理的动态。研究这些肽段,有助于发现早期病变中极低浓度的特异信号,并揭示肿瘤微环境中的关键酶活特征。代谢组学则是对生物样本中的小分子代谢物(通常分子量小于1500道尔顿,且为非肽类物质)进行全面的定性和定量分析。代谢物处于中心法则的最下游,能最直接地反映生命体当前的生理或病理状态,是基因组、转录组和蛋白质组变化的综合“输出”结果。癌症会导致细胞代谢发生显著的“重编程”(如瓦博格效应),因此通过对比肿瘤患者与健康人的代谢物谱,可以系统性地发现癌症相关的异常代谢通路,为早期诊断和个性化治疗提供标志物。在食管癌检测应用中,多肽组学与代谢组学具有互补性。多肽组学直接反映上游蛋白质的功能性加工过程,而代谢组学则呈现了这一系列事件后的最终生理效应。联合这两种组学方法,可以从不同维度描绘肿瘤的分子全景,为寻找更可靠的食管癌生物标志物组合提供了可能。
3、基质辅助激光解吸电离飞行时间质谱(maldi-tof ms)是一种强大的生物分子分析技术,已被广泛应用于蛋白/多肽组学、代谢脂质组学、微生物鉴定和临床诊断领域。其原理是通过激光软电离技术使生物分子获得能量并电离,电离后的离子在飞行管中因质荷比(m/z)不同而产生不同的飞行时间,据此实现质荷比的精确测定。maldi tof ms质谱结合硅基微纳颗粒以及硅基芯片,可实现同一平台的双组学检测。该方法具有样本用量少、操作简单、分析速度快、灵敏度高、通量高、分析成本低廉等突出优点。而lc-ms质谱检测方法对样本前处理要求高,检测通量低,不适用于临床需求。
4、目前临床上广泛使用的食管癌诊断技术包括:1、食管镜结合病理活检为金标准;2、传统食管癌相关蛋白标志物如cea、ca19-9、scc和cyfra21-1等多标志物联检;3、基于maldi-tof ms结合弱阳离子交换磁珠(wcx-mb)方法,提纯血清蛋白质/肽后,经maldi-tofms检测,筛选差异表达多肽,构建食管癌诊断模型;4、基于lc-ms平台的血清代谢组学诊断模型,该诊断模型中的标志物对于食管癌具有较好的灵敏性和特异性,可用于食管癌诊断包括早期诊断。5、基于ctdna甲基化的食管癌诊断技术。
5、针对上述临床上广泛使用的食管癌诊断技术,其缺点在于:
6、1)食管镜结合病理活检方法。内镜检查具有侵入性、操作依赖专业人员、成本较高、患者耐受性差等显著缺点,不适宜在大规模无症状人群中普筛;
7、2)传统食管癌相关蛋白标志物如cea、ca19-9、scc和cyfra21-1等多标志物联检。广谱标志物不具备特异性,不推荐用于食管癌的早期筛查或诊断。它们的主要价值在于术后监测、疗效评估和复发预警,而不是“早期发现”;
8、3)基于maldi-tof ms结合弱阳离子交换磁珠(wcx-mb)方法;4)基于lc-ms平台的血清代谢组学检测;5)基于ctdna甲基化的食管癌诊断技术;
9、3)、4)、5)方法缺点:
10、1、均为单一组学标志物,信息维度不足。食管癌作为一种多种分子事件共同驱动的复杂疾病,仅依靠单一组学信息(多肽或代谢物)难以获得足够的信息维度来支撑高灵敏度的早期诊断。多肽反映的是肿瘤直接分泌或宿主对肿瘤应答的蛋白/肽段信息,代谢物则反映肿瘤引起的整体生理代谢紊乱。单一组学信息量的先天不足,限制了检测灵敏度和特异性的进一步提升。
11、2、缺乏风险分层功能,无法支持精准的分层管理。现有技术仅能给出二元输出结果癌或非癌,或仅用于预后预测和治疗效果评估(如ccrt疗效评估)。然而,食管癌筛查的临床实际需求远不止于简单的“是/否”诊断——医护人员需要对高危人群进行科学的风险分层,据此优化内镜资源的使用,将有限的内镜筛查资源精准分配给真正的高风险个体,避免对低风险人群的不必要侵入性检查。现有的生物标志物检测技术普遍缺乏低、中、高三等级风险分层设计,导致其在“高危人群分层管理”这一临床场景中的实用性较差。
12、3、对良性食管病变的区分能力不佳。现有食管癌血清检测方法大多以健康人群作为阴性对照进行模型构建和验证,缺乏对良性食管病变(如食管炎症、低级别/高级别上皮内瘤变)的系统纳入研究。良性食管病变患者是食管癌筛查工作中最易出现假阳性的群体,若检测方法无法有效区分食管癌与良性病变,将导致大量不必要的内镜转诊和焦虑。现有技术中虽有研究纳入癌前病变分析,但通常仅作为单一样本分组,而没有将良性病变作为独立的分母纳入模型设计和验证中。
13、4、lc-ms质谱检测方法对样本前处理要求高,检测通量低,不适用于临床需求;
14、5、ctdna甲基化标志物依赖于肿瘤细胞的凋亡、坏死才能被检测到,在早期食管癌检测中不具备优势。
15、因此,本领域亟需一种基于单一maldi-tof ms平台同时检测血清代谢物和多肽标志物的技术方法以及能够将受检者划分为低、中、高三个风险等级的食管癌判别模型,用于食管癌的早期筛查和高危人群的分层管理,以克服现有技术中信息维度不足、缺乏风险分层、良性病变区分能力差等技术缺陷。
技术实现思路
1、有鉴于此,本发明要解决的技术问题在于提供标志物组合。
2、本发明提供了标志物组合,包括多肽组和/或代谢物组;
3、所述多肽组包括以下至少一种:质荷比为1207.1678的多肽、质荷比为1261.7113的多肽、质荷比为1588.3147的多肽、质荷比为1630.5943的多肽、质荷比为1639.0169的多肽、质荷比为1655.2586的多肽、质荷比为1660.2189的多肽、质荷比为1779.0734的多肽、质荷比为2010.6646的多肽、质荷比为2105.0986的多肽、质荷比为2272.2004的多肽、质荷比为2363.8626的多肽、质荷比为2876.9920的多肽、质荷比为3057.8379的多肽、质荷比为3364.4412的多肽、质荷比为3474.8535的多肽、质荷比为3586.6758的多肽或质荷比为4788.7358的多肽;
4、所述代谢物组包括以下至少一种:lpa 16:0、lpa 20:0、lpe 18:2、lpa 22:0、lpe20:4、sm 33:1;o2、pe p-38:3、shexcer 38:2;o3、shexcer 40:0;o3、shexcer 41:1;o3、shexcer 42:1;o3、shexcer 42:2;o4、fa 22:4、lpc 18:0、ce 16:1、pa 40:9、pg 36:4、taurine、thiodiacetic acid、p-cresol sulfate、o-methoxycatechol-o-sulphate、pyrogallol-1-o-sulphate、heptadecanoic acid (fa 17:0)、hawkinsin、5,8,11-eicosatrienoic acid (fa 20:3)、docosahexaenoic acid (fa 22:6)或adrenic acid(fa 22:4)。
5、上述标志物组合通过质谱鉴定获得,经实验验证,相较于现有技术中的肿瘤标志物,本发明所述标志物组合能够区分食管癌/癌前病变与炎症、良性增生及健康人群,显著提高了早期食管癌的检测性能。
6、作为可行性案例,所述标志物组合,包括多肽组和代谢物组;
7、所述多肽组包括:质荷比为1207.1678的多肽、质荷比为1261.7113的多肽、质荷比为1588.3147的多肽、质荷比为1630.5943的多肽、质荷比为1639.0169的多肽、质荷比为1655.2586的多肽、质荷比为1660.2189的多肽、质荷比为1779.0734的多肽、质荷比为2010.6646的多肽、质荷比为2105.0986的多肽、质荷比为2272.2004的多肽、质荷比为2363.8626的多肽、质荷比为2876.9920的多肽、质荷比为3057.8379的多肽、质荷比为3364.4412的多肽、质荷比为3474.8535的多肽、质荷比为3586.6758的多肽和质荷比为4788.7358的多肽;
8、所述代谢物组包括:lpa 16:0、lpa 20:0、lpe 18:2、lpa 22:0、lpe 20:4、sm 33:1;o2、pe p-38:3、shexcer 38:2;o3、shexcer 40:0;o3、shexcer 41:1;o3、shexcer 42:1;o3、shexcer 42:2;o4、fa 22:4、lpc 18:0、ce 16:1、pa 40:9、pg 36:4、taurine、thiodiacetic acid、p-cresol sulfate、o-methoxycatechol-o-sulphate、pyrogallol-1-o-sulphate、heptadecanoic acid (fa 17:0)、hawkinsin、5,8,11-eicosatrienoic acid(fa 20:3)、docosahexaenoic acid (fa 22:6)和adrenic acid (fa 22:4)。
9、一些实施例中,所述质荷比为1207.1678的多肽为小窝相关蛋白2(caveolae-associated protein 2)的片段,其氨基酸序列如seq id no:1所示;
10、所述质荷比为1261.7113的多肽为免疫球蛋白重链恒定区γ2(immunoglobulinheavy constant gamma 2)的片段,其氨基酸序列如seq id no:2所示;
11、所述质荷比为1588.3147的多肽为免疫球蛋白λ可变区3-10(immunoglobulinlambda variable 3-10)的片段,其氨基酸序列如seq id no:3所示;
12、所述质荷比为1630.5943的多肽为内质网氨肽酶2(endoplasmic reticulumaminopeptidase 2)的片段,其氨基酸序列如seq id no:4所示;
13、所述质荷比为1639.0169的多肽为载脂蛋白a-i(apolipoprotein a-i)的片段,其氨基酸序列如seq id no:5所示;
14、所述质荷比为1655.2586的多肽为免疫球蛋白κ可变区2-28(immunoglobulinkappa variable 2-28)的片段,其氨基酸序列如seq id no:6所示;
15、所述质荷比为1660.2189的多肽为载脂蛋白b-100(apolipoprotein b-100)的片段,其氨基酸序列如seq id no:7所示;
16、所述质荷比为1779.0734的多肽为大核糖体亚基蛋白ul22(large ribosomalsubunit protein ul22)的片段,其氨基酸序列如seq id no:8所示;
17、所述质荷比为2010.6646的多肽为凝血酶原(prothrombin)的片段,其氨基酸序列如seq id no:9所示;
18、所述质荷比为2105.0986的多肽为磷酸甘油酸激酶1(phosphoglycerate kinase1)的片段,其氨基酸序列如seq id no:10所示;
19、所述质荷比为2272.2004的多肽为补体c1q亚组分a(complement c1qsubcomponent subunit a)的片段,其氨基酸序列如seq id no:11所示;
20、所述质荷比为2363.8626的多肽为纤维蛋白原β链(fibrinogen beta chain)的片段,其氨基酸序列如seq id no:12所示;
21、所述质荷比为2876.9920的多肽为α-2-巨球蛋白(alpha-2-macroglobulin)的片段,其氨基酸序列如seq id no:13所示;
22、所述质荷比为3057.8379的多肽为果糖二磷酸醛缩酶a(fructose-bisphosphatealdolase a)的片段,其氨基酸序列如seq id no:14所示;
23、所述质荷比为3364.4412的多肽为载脂蛋白a-i(apolipoprotein a-i)的片段,其氨基酸序列如seq id no:15所示;
24、所述质荷比为3474.8535的多肽为异质核糖核蛋白f(heterogeneous nuclearribonucleoprotein f)的片段,其氨基酸序列如seq id no:16所示;
25、所述质荷比为3586.6758的多肽为血红蛋白α亚基(hemoglobin subunit alpha)的片段,其氨基酸序列如seq id no:17所示;
26、所述质荷比为4788.7358的多肽为α-1-抗胰蛋白酶(alpha-1-antitrypsin)的片段,其氨基酸序列如seq id no:18所示。
27、本发明还提供了如前所述的标志物组合的筛选方法,包括:
28、提取受试者血清中的多肽和/或代谢物,作为分析样本;所述受试者包括健康对照、食管癌、食管癌前病变、食管炎性/功能性疾病和食管增生性疾病/良性肿瘤患者;
29、通过质谱检测,获取所述分析样本的多肽组学数据和/或代谢组学数据;
30、对所述多肽组学数据和/或代谢组学数据进行预处理及峰注释;
31、对差异分析筛选出的显著差异多肽和显著差异代谢物进行boruta特征筛选后,通过序列浮动选择算法(sequential forward floating selection, sffs)确定标志物组合。
32、经实验验证,相较于现有技术中常用的单一特征选择方法,本发明采用"差异分析、boruta全局特征筛选、sffs逐步浮动选择"的筛选策略,能够在大样本队列中,从成百上千个质谱峰中精准筛选出最具判别力的标志物组合。该筛选方法在交叉验证中表现稳定,auc波动范围小,证明了筛选结果的稳健性和可重复性。
33、一些实施例中,所述质谱检测的条件包括:
34、所述质谱平台为maldi-tof ms质谱平台;
35、所述代谢组学的质谱检测模式为反射式正/负离子模式,质谱采集质荷比扫描区间为50~1000道尔顿,激光能量设置范围为55%~63%;
36、所述多肽组学的质谱检测模式为线性正离子模式,质谱采集质荷比扫描区间为600~20000道尔顿,激光能量设置范围为20%~40%。
37、经实验筛选获得,相较于其他的检测条件,本发明采用的条件能够在同一maldi-tof ms平台上高效获取高质量的多肽和代谢物质谱数据,且检测通量远高于lc-ms平台。
38、一些实施例中,所述预处理包括基线校正、归一化、峰识别或峰对齐。
39、一些实施例中,所述差异分析筛选的条件包括:差异倍数满足预设阈值和错误发现率(fdr)小于0.05。
40、一些具体实施例中,所述预设阈值为 fc>1.5,多重检验校正下的p<0.05。
41、本发明还提供了如前所述的标志物组合在制备食管癌相关疾病风险判别试剂,或在构建食管癌风险分层模型中的应用。
42、进一步的,本发明提供了食管癌风险分层模型的构建方法,包括:
43、基于分析样本的多肽组学数据和代谢组学数据,以及如前所述的标志物组合,构建多肽模型和代谢模型;
44、获取所述分析样本对应的多肽模型的食管癌预测概率值以及代谢模型的食管癌预测概率值;
45、将所述多肽模型的食管癌预测概率值和所述代谢模型的食管癌预测概率值进行融合计算,获得食管癌风险分层模型,所述食管癌风险分层模型输出食管癌风险评分。
46、一些实施例中,所述多肽模型和代谢模型为基于随机森林(rf)、lasso线性回归或xgboost算法构建的模型。经实验验证,与采用临床肿瘤标志物建立的模型相比,在相同建模算法下,基于本发明标志物组合构建的多肽模型和代谢模型的预测性能均显著优于基于上述临床肿瘤标志物构建的模型。此外,上述多肽模型与代谢模型均表现出良好的诊断效能,表明本发明筛选获得的标志物组合具有优异的稳定性和可靠性。
47、一些具体实施例中,lasso线性回归多肽模型的分类阈值为0.3534,代谢模型的分类阈值为0.3028。
48、一些具体实施例中,rf模型根据训练集交叉验证roc曲线计算youden指数,确定最佳分类阈值,所述阈值为0.2365。
49、一些具体实施例中,xgboost多肽模型的分类阈值为0.2252,代谢模型的分类阈值为0.3212。
50、优选的,所述多肽模型和代谢模型为基于随机森林(rf)算法构建的模型。通过比较不同算法模型的交叉验证结果,随机森林模型在auc和准确率方面表现最优,因此选择rf多肽模型和rf代谢模型构建食管癌风险分层模型。
51、一些实施例中,所述食管癌风险分层模型为stacking集成模型,其二级学习器采用逻辑回归算法,将所述多肽模型的食管癌预测概率值和所述代谢模型的食管癌预测概率值作为输入特征进行融合。
52、具体的,将所述rf多肽模型的食管癌预测概率值和所述rf代谢模型的食管癌预测概率值作为输入特征进行融合。
53、进一步的,本发明还提供了食管癌风险分层模型,包括:
54、数据获取模块,用于获取待测受试者样本的多肽组学数据和代谢组学数据,其包括如前所述的标志物组合对应的组学数据;
55、计算模块,包括多肽模型和代谢模型,用于获取待测受试者样本对应的多肽模型的食管癌预测概率值以及代谢模型的食管癌预测概率值;
56、输出模块,用于将所述多肽模型的食管癌预测概率值和所述代谢模型的食管癌预测概率值进行融合计算,获得食管癌风险评分,输出食管癌判别结果。
57、经实验验证,相较于单一组学模型或临床肿瘤标志物模型,本发明构建的食管癌风险分层模型(stacking集成模型),具有更高的诊断性能和准确率,显著提升了筛查效能。
58、一些实施例中,所述食管癌风险分层模型的计算公式包括:
59、logit(p)=w0+w1×代谢模型的食管癌预测概率值+w2×多肽模型的食管癌预测概率值(式i),
60、其中,p表示模型预测的食管癌风险概率;w0为-7.5~-6.0,表示模型截距项;w1为8.0~9.5,表示代谢模型的食管癌预测概率值对应的权重系数;w2为7.0~8.5,表示多肽模型的食管癌预测概率值对应的权重系数;
61、risk score =1/[1+exp(-logit(p))] (式ii),其中,risk score表示食管癌风险评分。
62、例如,所述w0为-7.5、-7.3、-7.0、-6.8、-6.5、-6.3或-6.0;所述w1为8.0、8.2、8.5、8.7、8.9、9.2或9.5;所述w2为7.0、7.2、7.5、7.8、8.0、8.2或8.5。具体的,所述w0为-6.774772,w1为8.701288,w2为7.640766。
63、作为可行性案例,所述食管癌风险分层模型的计算公式包括:
64、logit(p)= -6.774772 + 8.701288×代谢模型的食管癌预测概率值+ 7.640766×多肽模型的食管癌预测概率值(式i);
65、risk score =1/[1+exp(-(-6.774772 + 8.701288×代谢模型的食管癌预测概率值+ 7.640766×多肽模型的食管癌预测概率值)](式ii)。
66、一些实施例中,根据roc曲线、最大约登指数原则和预设阳性风险概率阈值确定所述模型的分界阈值,所述分界阈值包括低危与中危的分界阈值,以及中危与高危的分界阈值;
67、其中,食管癌风险评分低于低危与中危分界阈值,输出为低风险,食管癌风险评分介于两个阈值之间,输出为中风险,食管癌风险评分高于中危与高危分界阈值,输出为高风险。
68、可选的,设定0.2365为低危与中危的分界阈值,该阈值由roc曲线及最大约登指数原则确定;
69、设定0.6597为中危与高危的分界阈值,该阈值由预设阳性风险概率阈值所对应的模型风险评分确定;可选的,所述预设阳性风险概率阈值为70%;
70、食管癌风险评分低于0.2365,输出为低风险,食管癌风险评分为0.2365~0.6597,输出为中风险,食管癌风险评分高于0.6597,输出为高风险。
71、本发明设置的三类分子风险分层(低危、中危和高危),旨在指导内镜检查的优先级与紧急程度,但不是替代常规临床评估或指南规定的内镜指征。依据分子风险评分判定为低危的受试者,无需立即接受内镜检查,可继续常规临床随访;但若出现预警症状或存在其他公认临床指征,仍应行内镜检查。中危受试者建议按期完成诊断性内镜检查;高危受试者则优先安排加急内镜评估。
72、更进一步的,本发明提供了食管癌相关疾病风险判别试剂,包括如前所述的标志物组合的检测试剂。
73、一些实施例中,所述试剂包括用于检测血清样本中多肽标志物的试剂和/或用于检测血清样本中代谢物标志物的试剂。
74、一些实施例中,所述检测试剂包括:
75、(1)用于富集血清样本中多肽和/或代谢物的试剂;
76、(2)用于质谱检测的试剂;
77、(3)标准品或质控品。
78、一些实施例中,所述试剂还包括食管癌风险分层模型或使用说明,所述使用说明记载了将质谱检测获得的标志物组合的数据代入如前所述的食管癌风险分层模型,计算食管癌风险评分,并根据风险评分阈值输出风险等级的操作步骤。
79、更进一步的,本发明还提供了一种计算机程序产品,包括计算机可读指令,当所述计算机可读指令在电子设备上运行时,使得所述电子设备实现如前所述的标志物组合的筛选方法,输出标志物组合的筛选结果,或实现如前所述的食管癌风险分层模型的构建方法,输出食管癌风险评分。
80、更进一步的,本发明还提供了一种电子设备,包括至少一个处理器和与所述处理器连接的存储器,其中:
81、所述存储器用于存储计算机程序;
82、所述处理器用于执行所述计算机程序,以使所述电子设备能够实现如前所述的标志物组合的筛选方法,输出标志物组合的筛选结果,或实现如前所述的食管癌风险分层模型的构建方法,输出食管癌风险评分。
83、更进一步的,本发明还提供了一种计算机存储介质,所述存储介质承载有一个或多个计算机程序,当所述一个或多个计算机程序被电子设备执行时,能够使所述电子设备实现如前所述的标志物组合的筛选方法,输出标志物组合的筛选结果,或实现如前所述的食管癌风险分层模型的构建方法,输出食管癌风险评分。
84、更进一步的,本发明还提供了食管癌相关疾病的判别方法,包括:
85、采用如前所述的标志物组合、如前所述的食管癌风险分层模型、如前所述的试剂、如前所述的电子设备、计算机可读存储介质或计算机程序产品,对待测受试者进行食管癌相关疾病的判别。
86、一些实施例中,所述食管癌相关疾病包括食管癌、食管癌前病变、食管炎性/功能性疾病患者或食管增生性疾病/良性肿瘤患者。
87、本发明所述判别方法可以用于诊断目的,也可以用于非诊断目的。
88、所述判别方法用于诊断目的时,其针对的对象为疑似患有食管癌相关疾病的受试者,通过检测受试者血清样本中如前所述的标志物组合的质谱数据,并结合食管癌风险分层模型输出风险评分,辅助临床医生判断受试者是否患有食管癌相关疾病,或评估受试者罹患食管癌相关疾病的风险等级,为临床诊疗决策提供参考依据。
89、所述判别方法用于非诊断目的时,其可用于食管癌的大规模人群筛查、高危人群的风险分层管理、食管癌相关基础医学研究、药物研发过程中的生物标志物监测或食管癌发生发展机制研究中的样本分类。
90、与现有技术相比,本发明的有益效果如下:
91、1、检测信息维度丰富,诊断性能更高
92、通过代谢物和多肽双组学联合,获得互补性的疾病信息。代谢物反映肿瘤生长引起的全局代谢通路改变,多肽反映肿瘤特异性蛋白的表达和降解产物。二者联合,突破了单一组学在信息维度上的限制,显著提高了早期食管癌的检测性能。
93、2、风险分层输出模式更加适配临床需求,提升筛查效能并优化资源配置
94、相比于传统的“患癌/非患癌”的二元输出,建立了低、中、高三个风险等级,为临床实践提供了清晰的分层管理:高风险人群及时推荐内镜检查和病理活检;中风险人群建议定期随访复查,或结合其他辅助检测方式进一步确认;低风险人群则维持常规健康管理即可。这一设计精准契合了食管癌高危人群风险分层、精准防控的临床需求。
95、具体实施例中,在真实世界验证队列中,931名受试者均符合传统高危人群标准,若仅依据问卷及高危因素进行筛查,原则上均需进一步接受上消化道内镜检查。按照预设的模型指导分流策略,仅将中、高风险受试者转诊内镜,则需要接受内镜检查者可减少至75人,占总人群的8.1%,相当于潜在减少91.9%的内镜检查负担;与此同时,16例食管癌或癌前病变中有14例被划分至中、高风险组,检出灵敏度为87.5%。中、高风险人群中的食管癌或癌前病变检出率达到18.7%,明显高于不经分流直接实施内镜检查时的总体检出率1.7%,实现约10.9倍的阳性病例富集。上述结果表明,该食管癌风险分层模型(血清双组学风险分层模型)可作为传统高危问卷与内镜检查之间的精筛工具,在维持对临床显著食管病变较高识别能力的同时,将内镜资源优先配置于最可能获益的人群,从而有望显著减轻受检者和医疗机构的检查负担,并提高食管癌筛查效率。
96、3、高通量、低成本和操作简便
97、maldi-tof ms具有高通量检测性能,血清样本只需微量检测,无创或微创,适合大规模高危人群检测。
98、本发明涉及一种基于血清代谢、多肽标志物的食管癌判别方法及其应用。本发明筛选了用于食管癌判别的标志物组合,提供了一种基于单一maldi-tof ms平台同时检测血清代谢物和多肽标志物的技术方法,通过双组学信息融合和机器学习建模,构建能够将受检者划分为低、中、高三个风险等级的食管癌判别模型,用于食管癌的早期筛查和高危人群的分层管理,以克服现有技术中信息维度不足、缺乏风险分层、良性病变区分能力差等技术缺陷。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com