
基于大语言模型的记忆性种子短语生成方法及相关设备
本技术涉及自然语言处理,尤其涉及一种基于大语言模型的记忆性种子短语生成方法及相关设备。
背景技术:
1、脑钱包是加密货币安全领域的一种创新方案,其私钥通过用户记忆的短语密码或种子短语生成。这种创新方案让用户无需将私钥存储在可能存在安全隐患的设备上,而是直接保留在大脑中。
2、生成种子短语最常用的方法是bip-0039协议,bip-0039将熵转化为人类可读的助记符,该助记符通过pbkdf2算法处理,生成512位种子,它的精妙之处在于能将复杂的加密安全信息压缩成可读的文本格式。用户只需记住12到24个单词的口诀,就能轻松还原包含数千个地址和账户的完整钱包结构。
3、然而,脑钱包的核心缺陷在于其依赖人工生成的密码短语,这类密码往往熵值不足且极易遭受猜测攻击。从安全角度来看,标准化词表虽有助于兼容性,但意味着所有符合bip-0039标准的钱包均采用相同的2048个单词,从而为攻击者创造了已知的搜索空间。从可用性角度来看,尽管采用人类可读的格式,12-24个随机单词的序列仍难以可靠记忆,用户难以正确书写并安全存储看似随机的长序列词汇。
4、尽管已付出诸多努力,目前在种子短语设计中仍未成功平衡安全与可用性的权衡。研究主要聚焦于要么以牺牲可用性为代价提升安全性,要么以牺牲安全性为代价增强可用性,并且均未解决记忆性问题。
技术实现思路
1、本技术实施例的主要目的在于提出一种基于大语言模型的记忆性种子短语生成方法及相关设备,旨在为加密货币钱包创建并评估更具记忆性的种子短语,既能显著提升记忆效果,又无需牺牲安全性。
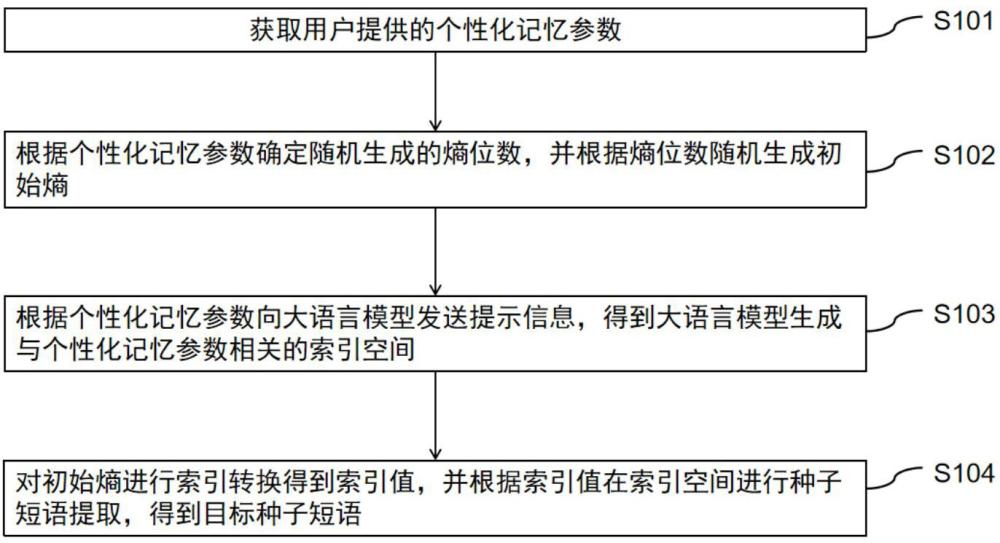
2、为实现上述目的,本技术实施例的一方面提出了一种基于大语言模型的记忆性种子短语生成方法,所述方法包括以下步骤:
3、获取用户提供的个性化记忆参数,其中,所述个性化记忆参数包括用户爱好、语言类型、叙事语境和参考书籍中至少一个;
4、根据所述个性化记忆参数确定随机生成的熵位数,并根据所述熵位数随机生成初始熵;
5、根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,其中,所述索引空间为候选词列表、叙述段落和编码化书籍中的一个;
6、对所述初始熵进行索引转换得到索引值,并根据所述索引值在所述索引空间进行种子短语提取,得到目标种子短语。
7、在一些实施例中,所述根据所述个性化记忆参数确定随机生成的熵位数,包括以下步骤:
8、根据所述个性化记忆参数的参数类型确定待生成的索引空间的空间容量,其中,当所述个性化记忆参数为所述用户爱好或所述用户爱好与所述语言类型的组合时,所述空间容量为第一容量,当所述个性化记忆参数为所述叙事语境或所述参考书籍时,所述空间容量为第二容量;
9、对所述空间容量进行二进制转换,得到二进制位数;
10、根据所述二进制位数和目标种子短语的预设目标词汇数量进行运算,确定随机数生成的熵位数。
11、在一些实施例中,当所述个性化记忆参数为所述用户爱好,所述根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,包括以下步骤:
12、将所述用户爱好作为主题约束提示词,并将所述第一容量作为内容约束提示词,构建第一提示语;
13、向大语言模型发送所述第一提示语,利用所述第一提示语指导所述大语言模型生成与所述第一容量对应的第一候选词;
14、对所述第一候选词进行后验证处理,得到未通过验证的无效候选词和无效数量;
15、根据所述无效数量更新所述第一提示语,并将所述无效候选词的失败原因作为补充约束提示词,构建第二提示语;
16、向所述大语言模型发送所述第二提示语,利用所述第二提示语指导所述大语言模型生成与所述无效数量对应的第二候选词;
17、整合所述第一候选词和所述第二候选词得到候选词列表。
18、在一些实施例中,当所述个性化记忆参数为所述用户爱好与所述语言类型的组合,所述根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,包括以下步骤:
19、将所述用户爱好作为主题约束提示词,将所述第一容量作为内容约束提示词,并将所述语言类型作为语言约束提示词,构建第三提示语;
20、向大语言模型发送所述第三提示语,利用所述第三提示语指导所述大语言模型生成以所述语言类型表示且与所述第一容量对应的第三候选词;
21、对所述第三候选词进行后验证处理,得到未通过验证的无效候选词和无效数量;
22、根据所述无效数量更新所述第三提示语,并将所述无效候选词的失败原因作为补充约束提示词,构建第四提示语;
23、向所述大语言模型发送所述第四提示语,利用所述第四提示语指导所述大语言模型生成以所述语言类型表示且与所述无效数量对应的第四候选词;
24、整合所述第三候选词和所述第四候选词得到候选词列表。
25、在一些实施例中,当所述个性化记忆参数为所述叙事语境,所述根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,包括以下步骤:
26、根据所述初始熵从标准bip39词表中选择与所述目标词汇数量对应的目标单词;
27、将所述叙事语境作为主题约束提示词,并将所述目标单词作为必要信息提示词,构建第五提示语;
28、向大语言模型发送所述第五提示语,利用所述第五提示语以包含全部所述目标单词为生成目标,指导所述大语言模型生成候选段落;
29、对所述候选段落进行后验证处理,若所述候选段落包含全部所述目标单词,则将所述候选段落作为叙述段落;若所述候选段落中未包含全部所述目标单词,则将所述候选段落的失败原因作为补充约束提示词,构建第六提示语对所述候选段落进行再生成,直至所述候选段落包含全部所述目标单词。
30、在一些实施例中,当所述个性化记忆参数为参考书籍,所述根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,包括以下步骤:
31、将所述参考书籍的文本内容作为解析对象提示词,并将预设的编码规则作为转换提示词,构建第七提示语;
32、向大语言模型发送所述第七提示语,利用所述第七提示语指导所述大语言模型生成编码化书籍。
33、为实现上述目的,本技术实施例的另一方面提出了一种基于大语言模型的记忆性种子短语生成系统,所述系统包括:
34、第一模块,用于获取用户提供的个性化记忆参数,其中,所述个性化记忆参数包括用户爱好、语言类型、叙事语境和参考书籍中至少一个;
35、第二模块,用于根据所述个性化记忆参数确定随机生成的熵位数,并根据所述熵位数随机生成初始熵;
36、第三模块,用于根据所述个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与所述个性化记忆参数相关的索引空间,其中,所述索引空间为候选词列表、叙述段落和编码化书籍中的一个;
37、第四模块,用于对所述初始熵进行索引转换得到索引值,并根据所述索引值在所述索引空间进行种子短语提取,得到目标种子短语。
38、为实现上述目的,本技术实施例的另一方面提出了一种电子设备,所述电子设备包括存储器和处理器,所述存储器存储有计算机程序,所述处理器执行所述计算机程序时实现上述的方法。
39、为实现上述目的,本技术实施例的另一方面提出了一种计算机可读存储介质,所述计算机可读存储介质存储有计算机程序,所述计算机程序被处理器执行时实现上述的方法。
40、为实现上述目的,本技术实施例的另一方面提出了一种计算机程序产品,包括计算机程序,所述计算机程序被处理器执行时实现上述的方法。
41、本技术实施例至少包括以下有益效果:本技术提供一种基于大语言模型的记忆性种子短语生成方法和相关设备,该方案通过获取用户提供的个性化记忆参数,其中,个性化记忆参数包括用户爱好、语言类型、叙事语境和参考书籍中至少一个;根据个性化记忆参数确定随机生成的熵位数,并根据熵位数随机生成初始熵;根据个性化记忆参数向大语言模型发送提示信息,得到大语言模型生成与个性化记忆参数相关的索引空间,索引空间为候选词列表、叙述段落和编码化书籍中的一个;对初始熵进行索引转换得到索引值,并根据索引值在索引空间进行种子短语提取,得到目标种子短语。该方案能够创建并评估更具记忆性的种子短语,既能显著提升记忆效果,又无需牺牲安全性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com