
一种面向碳中和目标的企业全周期碳管理调度方法与流程
本技术涉及碳排放管理,尤其涉及一种面向碳中和目标的企业全周期碳管理调度方法。
背景技术:
1、碳中和的提出,源于全球气候持续变暖以及人类可持续发展的现实需求。通过以能源低碳替代技术为根基,利用光伏、风电、水电、储能等可再生能源技术,逐步替代煤炭、石油等高碳化石能源,从源头上控制碳排放规模,同时借助各类低碳技术推动工业、建筑、交通等高耗能重点领域节能降碳,搭配碳移除相关技术消纳残余排放,最终达成全社会二氧化碳排放与吸收的动态平衡,为碳中和战略实施提供系统性技术支撑。
2、现有企业碳管理调度技术多采用静态架构,依托离线训练的固定参数预测模型,遵循“历史数据训练-既定规则匹配”的实施路径,搭配预设静态调度规则开展管控。然而,随着设备长期运行出现性能衰减、能效下滑,叠加产能结构调整、生产工艺迭代、供需工况实时波动,原有模型训练的基准数据、隐含的参数映射关系与生产实际逐步脱节,导致调度方案适配性持续下降,普遍存在数据时效性滞后、场景适配性弱、自主决策能力不足、长效管控机制缺失等缺陷,难以支撑企业全周期碳中和目标的常态化落地,无法满足低碳生产调度、碳资产管控的实际需求。
技术实现思路
1、本技术旨在至少在一定程度上解决上述技术中的技术问题之一。
2、为此,本技术的一个目的在于提出一种面向碳中和目标的企业全周期碳管理调度方法,能够通过传递熵算法量化各变量间的非线性因果依赖强度,构建包含时滞特征的动态因果拓扑结构与规则库,并基于上述因果规则对lstm模型的初步预测结果进行逻辑一致性校验与反馈校正,提搞了碳价与碳排放强度预测的可信度。
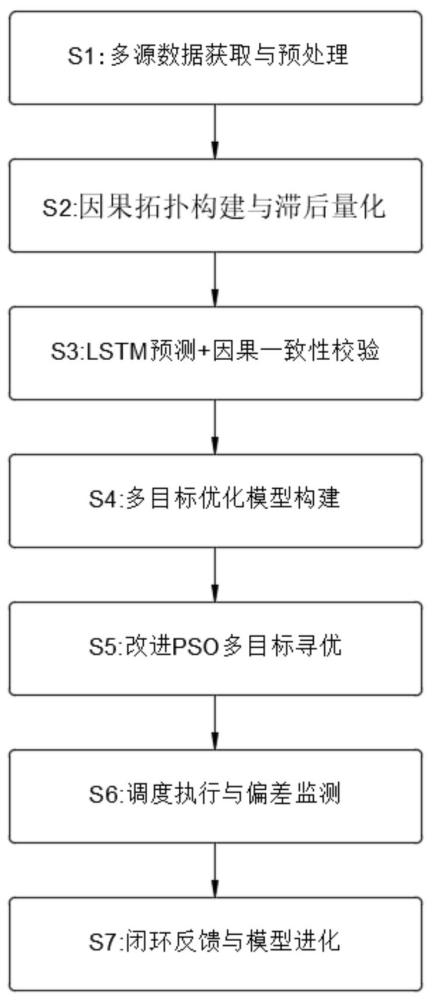
3、为达到上述目的,本技术第一方面提出了一种面向碳中和目标的企业全周期碳管理调度方法,包括:s1:采集企业内部运营数据及外部市场数据,并对所采集的数据进行清洗,包括去除噪声干扰、修正异常值和补充缺失值,对清洗后的数据进行归一化处理,构建标准化时序数据集;s2:基于所述标准化时序数据集,利用传递熵算法计算变量间的因果依赖强度,量化因果滞后阶数,生成包含时滞特征的因果拓扑结构,构建包含变量间因果关系的因果规则库;s3:将预处理后的数据输入lstm预测模型,对碳价及碳排放强度进行预测,并基于所述因果拓扑结构对预测结果进行逻辑纠偏,输出经因果对齐的修正预测序列;s4:基于所述修正预测序列,建立以最小化运营成本及最小化全生命周期碳排放量为目标的数学模型,明确模型决策变量,并结合企业设备运行约束、生产负荷约束、能源调度约束划定模型求解可行域;s5:采用粒子群优化算法对决策变量在可行域内进行迭代寻优,迭代收敛后输出多目标帕累托最优解集,根据低碳权重与经济权重进行自适应配比,筛选最优调度方案;s6:将所述最优调度方案解析为控制指令,下发至企业控制系统执行,将调度执行后的实际运行数据与修正预测序列进行比对,量化计算lstm模型预测残差与现场调度执行偏差;s7:基于所述预测残差与调度偏差,反向微调lstm模型网络参数,重新计算各变量的传递熵,迭代优化所述因果规则库中的因果权重与滞后阶数,完成企业全周期闭环碳管理智能调度。
4、另外,根据本技术上述提出的一种面向碳中和目标的企业全周期碳管理调度方法还可以具有如下附加的技术特征:
5、具体地,所述企业内部运营数据包括算力负载数据、设备能耗数据、生产工况数据、储能运行状态数据和碳排放时序数据,所述外部市场数据包括碳配额实时价格、ccer交易价格和分时电价数据。
6、具体地,所述s1步骤中,对所采集的数据进行清洗包括采用链式方程多重插补法填补缺失值,采用孤立森林算法识别并清洗异常值。
7、具体地,所述s2步骤具体包括:基于标准化时序数据集,采用滑动窗口机制计算各运行变量、市场变量与碳排放变量之间的传递熵值,量化变量间非线性因果依赖强度;通过滞后阶数寻优确定各因果关联对应的最优滞后阶数;以各变量为节点、因果关联为有向边,因果强度与时滞阶数为边属性,构建包含时滞特征的变量因果拓扑结构;将因果拓扑中的传导规则、阈值参数与滞后特征结构化存储,形成动态因果规则库。
8、具体地,所述s3步骤具体包括:将标准化时序数据集划分为训练集与测试集;利用训练集对lstm预测模型进行迭代训练,并将测试集输入训练完成的模型中,输出未来设定时段内的碳价波动序列与碳排放强度初步预测序列;基于所述因果拓扑结构及因果规则库,对所述初步预测序列进行逻辑一致性校验,检测预测序列的变量变化趋势、传导幅度与时滞关系是否符合因果传导规律;若判定存在违背因果逻辑的矛盾点,则计算因果残差并进行反馈校正,对异常预测值进行动态修正,输出经因果对齐的修正预测序列。
9、具体地,所述s4步骤中,所述决策变量包括明确可调控决策变量包括柔性生产负荷调节量、储能系统充放电功率和时序配比、算力任务错峰调度比例、分布式绿电就地消纳比例和外购碳抵消资源采购量。
10、具体地,所述s5步骤具体包括:采用实数编码的方式将所述决策变量映射为粒子位置向量,初始化粒子群的种群规模、速度上下边界、学习因子与最大迭代次数,在划定的可行域内完成粒子初始位置与初始速度的随机赋值;以最小化运营成本与最小化全生命周期碳排放量为双目标适应度函数,更新每个粒子的个体最优解与整个种群的全局最优解;在迭代寻优过程中,引入惯性权重衰减策略与非支配排序机制,对超出可行域范围的粒子位置进行边界截断修正;当迭代次数达到预设最大迭代次数或双目标适应度变化量连续多轮收敛至设定阈值时,终止迭代运算并输出多目标帕累托最优解集;根据当前实时碳价档位与企业碳排放履约缺口,动态自适应配比低碳目标权重与经济目标权重,基于加权综合评价函数从所述帕累托最优解集中筛选得到最优碳管理调度方案。
11、具体地,所述s6步骤具体包括:将筛选得到的最优碳管理调度方案解析为多类控制指令,包括生产侧柔性负荷调节指令、储能系统充放电控制指令、算力任务错峰转移指令和分布式新能源消纳调度指令;将控制指令通过工业通信协议对应下发至控制系统;同步采集调度执行后的实际运行数据,包括实际碳排放数据、实际能耗数据、实际产能数据与实际碳成本数据;将实际运行数据与修正预测序列进行时序对齐比对,计算碳价预测值的绝对百分比误差作为模型预测残差,计算计划碳排放量与实测碳排放量的差值作为现场调度执行偏差。
12、具体地,所述s7步骤中,基于所述预测残差与调度偏差,反向微调lstm模型网络参数,包括:当预测残差超过预设阈值时,采用梯度下降算法反向微调lstm预测模型的网络权重与偏置参数,修正模型时序预测精度。
13、具体地,所述s7步骤中,重新计算各变量的传递熵,迭代优化所述因果规则库,包括:基于更新后的最新时序数据集,重新执行传递熵算法,计算各变量间因果依赖强度的变化率;当检测到传递熵值变化率超过预设敏感度阈值,判定该因果传导路径发生结构性漂移,动态调整所述因果规则库中对应因果连接的权重系数,并更新因果滞后阶数的数值;当因果关联强度持续高于预设置信水平,则将其作为新节点补充至所述因果拓扑结构中,根据实际反馈情况对因果规则库进行动态调整。
14、与现有技术相比,本技术具有如下有益效果:本技术的一种面向碳中和目标的企业全周期碳管理调度方法,通过采用链式方程多重插补法对缺失样本进行填补,配合孤立森林算法识别并剔除由设备瞬变或环境扰动引发的异常噪声,经归一化处理后构建出高信噪比的标准化时序数据集,后续因果分析、模型预测与优化调度提供数据基础,同时,通过传递熵算法量化各变量间的非线性因果依赖强度,构建包含时滞特征的动态因果拓扑结构与规则库,并基于上述因果规则对lstm模型的初步预测结果进行逻辑一致性校验与反馈校正,提搞了碳价与碳排放强度预测的可信度。
15、本技术附加的方面和优点将在下面的描述中部分给出,部分将从下面的描述中变得明显,或通过本技术的实践了解到。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com