
一种虾夷扇贝高出肉柱率品种培育方法
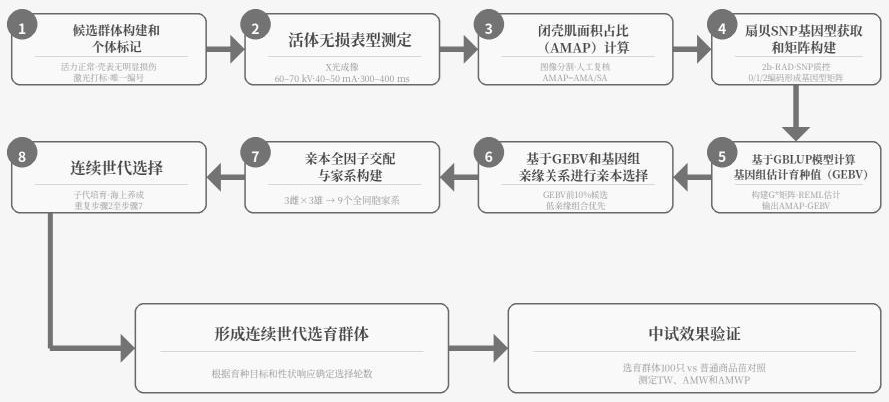
本发明涉及生物信息学和水产遗传育种,具体涉及一种虾夷扇贝高出肉柱率品种的培育方法及其应用。
背景技术:
1、虾夷扇贝(patinopecten yessoensis)是我国北方沿海主要的海水养殖贝类之一,具有极高的经济价值。其闭壳肌(俗称“肉柱”)是扇贝的主要食用部分和经济性状的核心。随着养殖产业的发展,良种选育成为提升产业效益的关键。目前,水产育种已从传统的群体选育、家系选育向全基因组选择育种迈进。
2、尽管全基因组选择技术在畜禽中已广泛应用,但在虾夷扇贝闭壳肌性状的选育上仍存在核心技术瓶颈,严重制约了高出肉柱率品种的培育,具体包括:
3、1)表型测定与留种的矛盾:闭壳肌位于贝壳内部,传统测量方法需撬开贝壳并剥离肌肉,导致被测个体无法继续作为亲本使用。因此,传统育种中常采用同胞测定等间接方式估计家系水平,难以同时获得候选个体的实际闭壳肌性状并保留其繁殖能力,限制了个体选择效率。
4、2)现有x光表型研究与育种流程衔接不足:已有研究能够利用x光对活体扇贝的闭壳肌投影面积、闭壳肌重量及其比例关系进行定量评价,但现有研究主要用于表型快速测定,尚未给出将图像分割辅助的amap提取、2b-rad基因分型、gblup育种值评估、亲缘控制及连续世代选择相衔接的完整培育流程。
5、3)基因组选择模型局限:传统基于系谱信息的blup育种方法主要利用亲缘关系矩阵(a矩阵)进行遗传评估,无法捕捉孟德尔采样偏差,且对家系内个体的遗传差异区分能力较弱。虽然全基因组选择可以解决这一问题,但目前在贝类中缺乏针对“高出肉柱率”这一性状的成熟应用流程,特别是在结合无损表型测定方面缺乏系统解决方案。
6、4)无损表型的批量处理效率仍需提高:在大规模育种应用中,x光图像仍需完成贝壳与闭壳肌轮廓的批量分割和质量控制;人工逐幅勾勒效率较低,难以满足大规模育种群体的批量测定需求。
7、有鉴于上述问题,有必要建立一种将活体无损表型、基因组育种值评估、亲缘控制和连续世代选择相结合的系统培育方法。
技术实现思路
1、为解决上述技术问题,本发明提供一种将“x光活体表型获取”和“gblup基因组选择”相结合的虾夷扇贝培育方法。该方法在统一成像条件下提取闭壳肌面积占比(amap),将amap作为与实际出肉柱率正相关的活体候选表型;同时利用2b-rad获得全基因组snp标记,构建基因组亲缘关系矩阵g并在必要时进行正则化校正,计算amap的基因组估计育种值(gebv),并结合亲缘控制开展亲本选配和连续世代繁育。
2、具体的,本发明提供如下技术方案:
3、本发明首先提供一种虾夷扇贝高出肉柱率品种的培育方法,包括如下步骤:
4、步骤1)候选群体构建和个体标记;
5、步骤2)活体无损表型测定;
6、步骤3)闭壳肌面积占比(amap)计算;
7、步骤4)扇贝snp基因型获取和矩阵构建;
8、步骤5)基于gblup模型计算基因组估计育种值(gebv);
9、步骤6)基于gebv和基因组亲缘关系进行亲本选择;
10、优选的,还包括如下步骤:
11、步骤7)亲本全因子交配与家系构建;
12、步骤8)连续世代选择。
13、进一步的,所述步骤1)的候选群体构建包括:挑选活力正常和壳表无明显损伤的虾夷扇贝用于候选群体构建,所述个体标记是基于激光打标;
14、进一步的,所述步骤2)的无损表型测定是基于x光进行活体无损表型测定;
15、一些方式中,步骤2)具体包括:利用x光照射活体扇贝壳体,获得x光图像;更优选的,所述x光照射参数为:60-70 kv,40-50 ma,300-400 ms。
16、优选的,所述步骤3)的amap计算是基于x光图像中贝壳轮廓和闭壳肌轮廓的图像分割结果进行;
17、一些方式中,所述步骤3)具体包括如下步骤:对x光图像中的贝壳外轮廓和闭壳肌轮廓进行分割并形成掩码,图像分割可通过人工勾勒完成,也可由经验证的实例分割模型辅助完成;当采用实例分割模型时,可利用诸如yolov8等实例分割框架提高批量处理效率。对自动分割结果进行人工复核和必要的轮廓校正,最终以经复核的贝壳掩码和闭壳肌掩码,按掩码的像素数计算闭壳肌投影面积(ama)和全壳投影面积(sa),据此计算闭壳肌面积占比amap:
18、所述amap = ama/sa。
19、进一步的,所述步骤4)的扇贝snp基因型获取是基于简化基因组测序获取snp基因型;
20、一些方式中,所述步骤4)具体包括:
21、a、初筛基因分型群体:将amap>0.15扇贝个体作为候选亲本,同时设置覆盖不同amap水平的参照个体;候选亲本和参照个体共同构成基因分型及gblup分析群体;
22、b、建库测序:剪取候选亲本和参照个体外套膜边缘组织,酶切构建2b-rad文库并完成测序,获得多个snp标记;
23、c、基因型矩阵构建:将snp位点按替代等位基因数量编码为0、1或2,形成行对应个体、列对应snp位点的基因型矩阵;
24、一些更具体方式中,所述步骤4)具体包括如下步骤:
25、初筛基因分型群体:保留amap>0.15的扇贝个体作为候选亲本,设置覆盖不同amap水平的参照个体,构建覆盖表型变异范围的分析群体;所述参照个体用于扩展分析群体的amap表型变异范围,不参与后续亲本候选排序;候选亲本和参照个体均完成激光编号、x光成像、amap表型提取和基因分型;
26、建库测序:剪取候选亲本和参照个体外套膜边缘组织5-10 mg,提取基因组dna,酶切构建2b-rad文库并完成测序,获得多个snp标记;
27、snp质控和基因型矩阵构建:删除个体基因型缺失率大于10%的样本、snp缺失率大于10%的位点以及最小等位基因频率小于0.01的位点,获得高质量snp位点;将高质量snp位点按替代等位基因数量编码为0、1或2,形成行对应个体、列对应snp位点的基因型矩阵。
28、进一步的,所述步骤5)的gblup模型的构建包括:以amap作为目标性状建立分析数据集;整理和中心化snp基因型;基于中心化snp基因型建立个体间基因组亲缘关系g矩阵;基于g矩阵构建gblup模型。
29、更进一步的,所述gblup模型具体为:
30、
y = x b + z u + e
31、其中,
y为amap观测值向量;
b为固定效应向量,包括总体均值以及有原始记录支持且与数据不完全混杂的来源群体、性别、养殖单元、养殖批次或测定批次效应;
x为固定效应设计矩阵;
u为与每只扇贝个体编号对应的加性遗传效应向量;
z为记录与个体之间的关联矩阵,每只个体仅有一条目标性状记录时
z为单位矩阵;
e为随机残差向量;
32、随机项的分布假设为:
33、;
34、其中σa2为加性遗传方差,σe2为残差方差,第i只扇贝的基因组估计育种值gebvᵢ为个体加性遗传效应预测值ûi;g*用于规定不同个体加性遗传效应之间的协方差,即var(u)=g*σa2;无需校正时g*=g,需要校正时g*=gc;
35、在e~n(0,iσe2)的条件下,gblup混合模型方程中,个体随机效应部分的系数矩阵包含z′z+λg*-1,其中λ=σe2/σa2;据此将个体表型信息与全基因组亲缘信息共同用于预测u;
36、采用限制性最大似然法估计σa2和σe2,并将g*-1作为个体随机效应的已知逆关系矩阵输入;模型收敛后获得个体随机效应的最佳线性无偏预测向量û;对于第i只扇贝:
37、gebvi=ûi
38、即,将随机效应结果中与个体编号i对应的预测值ûi作为所述个体amap性状的gebv,并按唯一编号与该个体的表型、基因型和性别记录对应。
39、一些方式中,所述以amap作为目标性状建立分析数据集包括:以amap作为目标性状,建立至少包括个体编号、来源群体、养殖或测定批次、ama、sa和amap的表型数据库;
40、一些方式中,所述整理和中心化snp基因型包括:对于第k个snp位点,将第i只扇贝携带的替代等位基因数记为mik,非缺失基因型的mik取0、1或2;仅利用该位点的非缺失基因型计算替代等位基因频率pk:
41、;
42、式中,nk为第k个snp位点具有非缺失基因型的扇贝数,n0k、n1k和n2k分别为该位点基因型编码为0、1和2的个体数,且nk= n0k + n1k + n2k;pk所对应的替代等位基因与mik编码时计数的等位基因一致;对保留位点的少量缺失基因型以期望剂量2pk填补,再进行中心化;
43、采用计算所得pk按照下式对第i只扇贝的基因型mik进行中心化:
44、wik = mik– 2 pk
45、式中,wik为中心化后的基因型值;
46、一些方式中,所述基于中心化snp基因型建立个体间基因组亲缘关系g矩阵包括:基于质控后保留的m个snp位点,采用vanraden方法计算个体间的基因组亲缘关系矩阵g:
47、;
48、式中,w为中心化基因型矩阵,w'为w的转置矩阵,g矩阵第i行、第j列元素表示第i只与第j只虾夷扇贝的基因组亲缘关系;对g矩阵进行正定性和条件数检验;当g矩阵接近奇异时,采用gc=(1-α)g+αi进行融合校正,其中α为0.01~0.05,i为单位矩阵;将实际输入gblup模型的矩阵统一记为g*,无需校正时g*=g,需要校正时g*=gc,并计算g*的逆矩阵。
49、进一步的,所述步骤6)基于gebv和基因组亲缘关系进行亲本选择包括:在同一世代、同一目标性状和同一模型的有效参评个体中按gebv由高到低排序,选取排序前10%的个体作为亲本候选(优选的,当雌贝或雄贝少于3只时,按gebv排序依次向后扩展至雌、雄各不少于3只);在亲本候选中,以模型实际采用的g*计算候选亲本中可行雌雄组合的平均交叉性别基因组亲缘关系,选择平均交叉性别基因组亲缘关系最低的组合作为亲本组合;存在两个或多个相同最低值的组合时,选择gebv总和最高的组合。
50、进一步的,所述步骤7)亲本全因子交配与家系构建包括:每个3×3全因子交配模块由3只雌贝和3只雄贝构成,并建立9个父母本明确的全同胞家系;亲本候选数多于6只时,构建一个或多个3×3全因子交配模块,并控制亲本重复使用和各亲本的家系贡献。
51、进一步的,所述步骤8)连续世代选择包括:将不同交配组合分别进行幼虫培育、附着、稚贝培育和海上养成;子代达到表型测定规格后重复步骤2)至步骤6),达到性成熟后重复步骤7);连续世代选择过程中记录并控制基因组亲缘关系、亲本贡献和家系贡献。
52、本发明还提供上述方法在虾夷扇贝高出肉柱率品种选育中的应用。
53、本发明效果方面的优势至少包括了如下几个方面:
54、1)本发明所建立的方法在中试养殖条件下,相比于对照,本发明选育群体的组水平出肉柱率由12.83%提高至15.26%,相对提高约20%,表明本发明具有实践应用的潜力。
55、2)本发明利用x光成像结合图像分割,建立了以闭壳肌面积占比(amap)为候选表型的无损选育流程;使得在不损伤候选个体的前提下筛选较高出肉柱率候选个体成为可能,从而有助于提高个体选择的可操作性。
56、3)本发明采用全基因组最佳线性无偏预测模型gblup进行遗传评估,该方法利用全基因组snp标记构建基因组亲缘关系矩阵(g矩阵),替代传统的系谱亲缘关系矩阵(a矩阵)。gblup模型能够综合利用标记信息评估加性遗传效应,并有助于降低系谱记录不全或错误对遗传评估的影响。
57、4)本发明建立了全流程高通量选育体系,结合激光标记技术、图像分割辅助并配合影像分析方法和2b-rad测序技术,构建了一套从群体标记、无损测定到基因型分析的标准程序,提高了育种工作通量和结果的可追溯性。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com