
一种基于时间序列信号处理的音频降噪方法及系统与流程
本发明涉及音频信号处理领域,尤其是涉及一种基于时间序列信号处理的音频降噪方法及系统。
背景技术:
1、目前,工业界广泛应用的最接近的现有技术是基于循环神经网络(rnn)结合经典数字信号处理(dsp)特征提取的混合音频降噪架构(典型代表为rnnoise开源框架及其衍生系统)。
2、在其实现过程中,现有系统通常以固定的时间窗口(如10毫秒)对连续的时域音频信号进行分帧截取。对于每一个音频帧,系统首先执行预处理和高点数(如960点)的前向快速傅里叶变换(fft),将信号从时域转换到频域 1。接着,系统执行计算密集的“基音分析(pitch analysis)”:在全局范围内计算相关性以寻找基音周期,从而构建梳状滤波器(comb filter),用于过滤存在于语音基音谐波之间的噪声 1。最终,提取出的频带能量和基音特征被送入gru网络,通过前向推理计算出理想的频域增益掩码(gain mask),掩码作用于原始频谱后,再通过逆向快速傅里叶变换(ifft)重建出纯净的时域语音。
3、然而,现有技术存在以下严重缺陷:
4、1.特征提取存在极高的时域计算冗余:人类语音的基音频率在极短时间(如连续的几十毫秒)内变化极其缓慢。现有技术对每一个10毫秒的音频帧都无差别地强制执行庞大的前向fft和全局基音周期搜索。仅仅这一前置特征提取步骤就消耗了单帧整体计算时间的50%至60%,导致严重的算力浪费。
5、2.rnn隐藏状态在纯净静音段发生灾难性衰减:在实际通信中,静音或纯底噪的占空比极高。现有技术若在无语音输入时依然维持全功率推理,会白白耗尽电池电量;而如果采用传统的硬性静音阈值切断推理,gru网络内部维持上下文记忆的隐藏状态(hiddenstate)矩阵会迅速归零。当用户重新开始讲话时,网络需要耗费数十毫秒来重新积累语音特征上下文,导致首个音节被生硬吞噬,产生破坏性的“软启动(soft start)”机器伪影。
6、3.现有的跳帧策略破坏时间序列连贯性:现有的网络推理层跳帧技术(inferenceskipping)一旦粗暴切断输入,会彻底撕裂时序数据的连贯性,导致特征序列出现断层,通常需要对神经网络进行复杂的二次重训练且收益甚微。
7、4.标量格式转换造成底层指令流水线拥堵:在音频处理流水线的末端,神经网络输出的32位浮点(f32)数据必须转换为硬件声卡所需的16位有符号整数(s16)。现有技术通常采用逐个样本的标量遍历计算,这在每秒处理数万个采样点时严重浪费了现代cpu的向量化计算潜能。
8、因此,亟需一种基于时间序列信号处理的音频降噪方法来解决上述缺陷。
技术实现思路
1、为了解决现有技术中特征提取计算冗余高、循环神经网络隐藏状态在静音段易衰减、跳帧策略破坏时间序列连贯性以及数据格式转换效率低的技术问题,本发明提供一种基于时间序列信号处理的音频降噪方法及系统。
2、在本发明的第一方面,提供了一种基于时间序列信号处理的音频降噪方法。该方法包括:
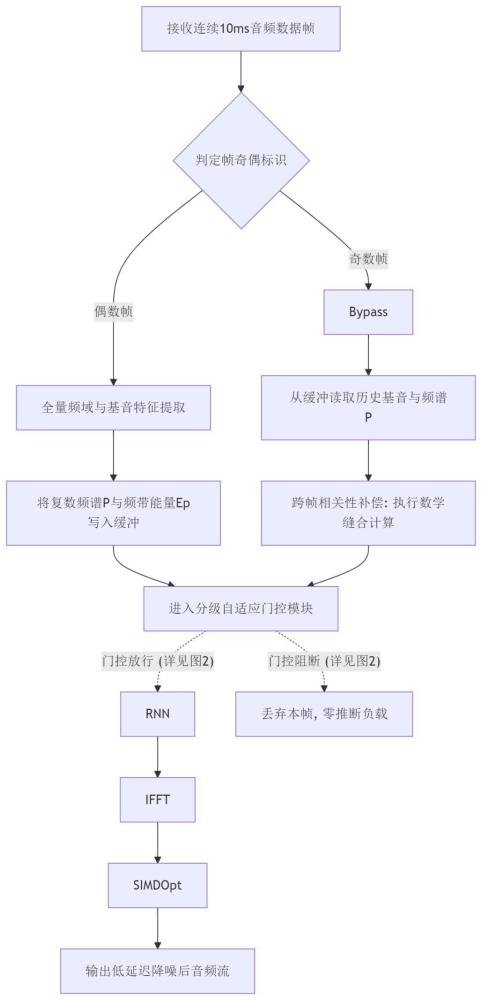
3、将连续输入的音频数据帧按时间序列划分为偶数帧和奇数帧,其中,系统冷启动后的首个有效音频数据帧被强制标记为偶数帧;
4、当当前帧为偶数帧时,对输入信号加窗后执行全量频域变换和基音分析,提取复数频谱、频带能量、基音索引、均方能量以及时域采样信号,并将复数频谱、频带能量、基音索引以及均方能量写入延迟缓冲寄存器;
5、当当前帧为奇数帧时,旁路全量频域变换和基音分析,直接从延迟缓冲寄存器内读取上一有效偶数帧的历史复数频谱、历史基音索引、历史均方能量、历史时域采样信号,并获取奇数帧的均方能量和时域采样信号,基于奇数帧的时域采样信号与历史复数频谱执行跨帧相关性数学补偿,融合生成奇数帧的复数频谱,将奇数帧的复数频谱映射到巴克频带上,计算奇数帧的频带能量,复用历史基音索引作为当前奇数帧的基音索引;
6、根据当前帧的频带能量、均方能量和基音索引构建特征向量,将当前帧的均方能量通过多级能量门控判定后送入循环神经网络进行增益推断,生成频域增益掩码;
7、将频域增益掩码作用于当前帧的复数频谱,通过逆向快速傅里叶变换重建时域信号波形;
8、在输出阶段,根据宿主中央处理器的硬件架构能力调用单指令多数据流向量化指令,将时域信号波形从浮点数据格式批量转换为定点数据格式。
9、可选的,所述偶数帧的均方能量的计算方法包括;
10、获取偶数帧的帧长、时域采样信号以及索引序号;
11、根据偶数帧的帧长、时域采样信号以及索引序号确定偶数帧的均方能量;
12、所述奇数帧的均方能量的计算方法包括:
13、获取奇数帧的帧长、时域采样信号以及索引序号;
14、根据奇数帧的帧长、时域采样信号以及索引序号确定奇数帧的均方能量;
15、所述偶数帧的均方能量的计算公式与奇数帧的均方能量的计算公式相同,均为:
16、
17、其中,为均方能量,为帧长,为索引序号,为时域采样信号。
18、可选的,所述跨帧相关性数学补偿包括:
19、提取奇数帧的均方能量作为幅度补偿的瞬态基准;
20、对历史复数频谱执行逆向快速傅里叶变换,重建历史时域采样信号,计算奇数帧的时域采样信号与历史时域采样信号之间的跨帧归一化互相关函数,通过局部搜索确定使跨帧归一化互相关函数取最大值的最优时间偏移量;
21、根据傅里叶变换的时移特性,对历史复数频谱施加对应最优时间偏移量的相位旋转因子,同时利用奇数帧的均方能量与历史均方能量比值进行幅度修正,合成奇数帧的复数频谱;
22、将合成后的复数频谱映射到巴克频带上,计算各频带能量。
23、可选的,所述跨帧归一化互相关函数的计算公式为:
24、
25、其中,为跨帧归一化互相关函数,为时间偏移量,为历史时域采样信号;
26、所述奇数帧的复数频谱的计算公式为:
27、
28、
29、其中,为奇数帧的均方能量与历史均方能量的比值,为奇数帧的均方能量,为历史均方能量,为奇数帧的复数频谱,为历史复数频谱,为频域离散频率点索引,为虚数单位,,为最大时间偏移量;
30、所述奇数帧的频带能量的计算公式为:
31、
32、其中,为奇数帧的频带能量,为频带索引,为终止频率点索引,即第b个粗粒度频带在离散频谱轴上对应的结束边界频率点位置,为起始频率点索引,即第b个粗粒度频带在离散频谱轴上对应的起始边界频率点位置。
33、可选的,所述多级能量门控包括l1级门控、l2级门控和l3门控,其中:
34、对于l1级门控的判定包括:
35、获取当前帧的均方能量;
36、判断当前帧的均方能量是否低于预设极端背景噪声阈值;
37、若是,则进入l3级门控静音保持判定;
38、若否,则判定存在有效声音输入,将静音保持倒计时计数器重置为满量程值,并进入l2门控的判定;其中,静音保持倒计时计数器的满量程值被配置为对应预设时长的音频帧数量;
39、对于l2级门控的判定包括:
40、判断当前帧的频带能量是否具有语音谐波特征;
41、若是,则将当前帧的特征向量送入循环神经网络;
42、若否,则将当前帧的特征向量送入循环神经网络但抑制频域增益掩码输出,维持网络隐藏状态的上下文记忆权重更新。
43、可选的,所述静音保持判定包括:
44、当l1级门控判定当前帧的均方能量低于预设极端背景噪声阈值时,阻断当前帧的特征向量向循环神经网络的传输;
45、检查静音保持倒计时计数器的当前数值;
46、若当前数值大于零,则将静音保持倒计时计数器的当前数值减一,并将当前帧的特征向量强制送入循环神经网络进行增益推断,以维持循环神经网络内部隐藏状态矩阵的上下文记忆权重;
47、若当前数值等于零,则阻断当前帧的特征向量向循环神经网络的传输并进入静默休眠状态。
48、可选的,所述循环神经网络采用门控循环单元架构,所述增益推断包括:
49、将输入特征向量与上一时间步保留的隐藏状态矩阵进行乘加计算;
50、利用门控循环单元架构内部的更新门和重置门分析语音的时间连贯性;
51、通过sigmoid激活函数输出取值在0.0到1.0之间的频域增益掩码,所述频域增益掩码定义当前帧各个特定频带中语音成分的保留比例。
52、可选的,所述通过逆向快速傅里叶变换重建时域信号波形,包括:
53、将频域增益掩码点乘到当前帧的复数频谱上,实现频域滤波;
54、利用逆向快速傅里叶变换将滤波后的复数频谱还原为时域采样点序列;
55、将当前帧的时域采样点序列与相邻帧的时域采样点序列按照预设帧重叠率进行重叠相加,生成连续的降噪后数字音频波形。
56、可选的,所述根据宿主中央处理器的硬件架构能力调用单指令多数据流向量化指令,具体包括:
57、嗅探宿主中央处理器的硬件架构能力,识别支持的向量化指令集类型,向量化指令集类型包括x86_64架构的avx2指令集或sse2指令集,以及arm架构的neon指令集;
58、根据识别结果调用对应的宽型硬件寄存器,在单条中央处理器指令内一次性将多个浮点样本直接截断限幅并转换为定点数据格式;
59、采用双倍循环展开策略,实现内存总线的高速数据冲刷。
60、本发明的第二天方面,提供了一种基于时间序列信号处理的音频降噪系统。该系统包括:
61、帧划分模块,用于将连续输入的音频数据帧按时间序列划分为偶数帧和奇数帧,其中,系统冷启动后的首个有效音频数据帧被强制标记为偶数帧;
62、偶数帧处理模块,用于当当前帧为偶数帧时,对输入信号加窗后执行全量频域变换和基音分析,提取复数频谱、频带能量、基音索引、均方能量以及时域采样信号,并将复数频谱、频带能量、基音索引以及均方能量写入延迟缓冲寄存器;
63、奇数帧处理模块,用于当当前帧为奇数帧时,旁路全量频域变换和基音分析,直接从延迟缓冲寄存器内读取上一有效偶数帧的历史复数频谱、历史基音索引、历史均方能量、历史时域采样信号,并获取奇数帧的均方能量和时域采样信号,基于奇数帧的时域采样信号与历史复数频谱执行跨帧相关性数学补偿,融合生成奇数帧的复数频谱,将奇数帧的复数频谱映射到巴克频带上,计算奇数帧的频带能量,复用历史基音索引作为当前奇数帧的基音索引;
64、门控推理模块,用于根据当前帧的频带能量、均方能量和基音索引构建特征向量,将当前帧的均方能量通过多级能量门控判定后送入循环神经网络进行增益推断,生成频域增益掩码;
65、逆变换重建模块,用于将频域增益掩码作用于当前帧的复数频谱,通过逆向快速傅里叶变换重建时域信号波形;
66、向量化输出模块,用于在输出阶段,根据宿主中央处理器的硬件架构能力调用单指令多数据流向量化指令,将时域信号波形从浮点数据格式批量转换为定点数据格式。
67、综上所述,本发明包括以下至少一种有益技术效果:
68、1.突破单帧处理延迟的算力下限:通过引入交错帧时序解耦与跨帧特征缝合机制,系统在不改变物理音频采样长度的前提下,从数学维度直接抹除了50%的庞大前向fft与基音搜索计算量,释放了宝贵的cpu中断响应时间;
69、2.彻底根除唤醒初期的“软启动”音质伪影并实现极限节能:通过引入绑定物理倒计时器的高阶保护门控,在200毫秒的强行热机延迟内完美填充语音词汇间的短暂停顿气口,确保当用户恢复讲话时,循环神经网络无需重新累积数个音频帧的特征就能立刻以最高精度输出准确的增益掩码,在实现长静音期零推理算力消耗的同时,保持了主观听觉对突发语音首音节的零损伤保留;
70、3.在极限算力削减下保持降噪网络精度的高保真度:通过创造性的当前时域特征与历史频域底座的融合运算,奇数帧送入神经网络的特征分布未出现死板的停滞或相位断裂,在削减近半数前端算力的条件下,仅造成低于人类听觉可感知阈值(约0.3 db)的降噪深度损失;
71、4.基于指令集级并行的极限吞吐量跃升:通过在出站阶段结合simd指令集优化,系统将最耗时的浮点转定点操作彻底向量化,并结合双倍循环展开技术消除了内存处理阻塞,使系统单核算力吞吐量大幅提升,同时单帧全局处理延迟显著缩减。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com