
一种基于深度学习的O-连接聚糖完整结构解析方法及系统
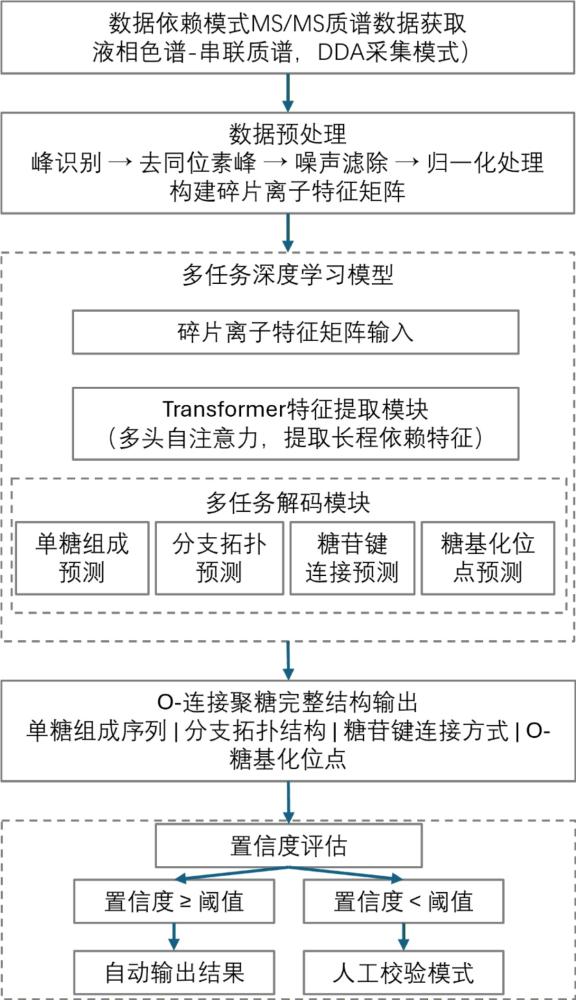
本发明涉及生物信息学、糖蛋白质组学和深度学习交叉,具体涉及一种基于深度学习的o-连接聚糖完整结构解析方法及系统,适用于从数据依赖模式采集的串联质谱数据中自动化解析完整o-糖肽的多肽氨基酸序列、o-糖基化位点以及o-连接聚糖的单糖组成、分支结构和糖苷键连接方式。
背景技术:
1、糖基化是最常见且最复杂的蛋白质翻译后修饰之一,哺乳动物中超过一半的蛋白质存在糖基化修饰。o-连接糖基化(o-linked glycosylation)发生在蛋白质的丝氨酸(ser)或苏氨酸(thr)残基上,以n-乙酰半乳糖胺(galnac)为起始残基。o-连接聚糖在免疫防御、细胞生长、细胞间粘附、炎症反应、信号转导等生物学过程中发挥关键作用,其异常修饰与肿瘤增殖、侵袭和转移密切相关。
2、然而,o-糖肽的质谱解析远比n-糖肽困难,主要表现在以下几个方面:
3、(1)o-糖基化缺乏如n-糖基化“n-x-s/t”那样的共有序列子,且相邻o-糖基化位点往往更为密集,使得位点预测极为困难;
4、(2)o-糖肽在质谱检测中化学计量低、离子化效率差,导致质谱信号较弱;
5、(3)o-聚糖具有多达八种核心结构(核心1至核心8),分支结构复杂,存在大量结构异构体;
6、(4)o-连接聚糖具有非线性的树状分支结构,单糖之间的连接方式(1→2、1→3、1→4、1→6等)和α/β构型多样,使得完整结构解析极具挑战性。
7、目前,o-连接聚糖的结构解析主要依赖数据库搜索方法和专家人工判读。现有技术存在以下不足:
8、第一,数据库搜索方法受限于已有数据库的覆盖范围。 目前常用的glycanfinder等技术需要依赖预定义的规则库和已知聚糖结构数据库。由于o-连接聚糖的结构多样性极高,大量新型聚糖结构未被数据库收录,数据库搜索方法无法识别未知结构。
9、第二,现有的深度学习方法主要聚焦于谱图预测而非完整结构解析。 如cn116825200b公开了一种基于深度学习的糖肽质谱图预测装置,将糖肽分为肽段和糖链分别编码后预测质谱图。该方法虽然能够预测糖肽的质谱图,但并未解决从质谱图反向推导聚糖完整结构这一核心问题。
10、第三,现有的聚糖结构预测模型主要针对n-连接聚糖或游离聚糖。 如candycrunch采用扩张残差神经网络从lc-ms/ms数据预测聚糖结构;glycobert和glycobart采用transformer架构进行聚糖结构预测;ms2glycan采用深度学习方法迭代生成聚糖结构。但这些模型主要针对n-连接聚糖或游离聚糖,对o-连接聚糖的处理能力有限,且未能同时解析o-糖基化位点。
11、第四,缺乏对o-连接聚糖分支结构的有效建模。 o-连接聚糖的非线性分支结构难以用传统的序列表示方法描述,现有的线性序列模型无法准确捕捉分支拓扑信息。
12、第五,现有方法无法实现多任务联合解析。 o-糖肽的完整解析需要同时确定肽段序列、糖基化位点和聚糖结构三个层面的信息,而现有技术通常仅针对单一任务,无法实现端到端的完整解析。
13、综上所述,目前亟需一种能够从数据依赖模式采集的o-糖肽串联质谱数据中,自动化、高精度地完整解析o-连接聚糖结构(包括单糖组成、分支拓扑、糖苷键连接方式)并同时确定o-糖基化位点的方法和系统。
技术实现思路
1、(一)发明目的
2、本发明针对现有o-连接聚糖结构解析技术中存在的数据库依赖性强、无法处理未知结构、对分支结构建模能力不足、无法实现多任务联合解析等问题,提供一种基于深度学习的o-连接聚糖完整结构解析方法及系统。
3、(二)技术方案
4、为实现上述发明目的,本发明提供如下技术方案:
5、1. 总体技术思路
6、本发明采用“图建模-特征提取-多任务解码”的技术架构。首先,将o-连接聚糖的非线性分支结构编码为图结构表示,利用图神经网络(graph neural network, gnn)捕捉分支拓扑信息;其次,利用transformer架构的强大特征提取能力,从ms/ms碎片离子谱图中提取长程依赖特征;最后,通过多任务解码模块同时输出o-连接聚糖的单糖组成、分支结构、糖苷键连接方式以及o-糖基化位点,实现端到端的完整结构解析。
7、2. 方法步骤
8、步骤s1:质谱数据获取
9、获取待解析o-糖肽样本在数据依赖模式采集模式下获得的串联质谱(ms/ms)数据。所述样本经液相色谱分离后,由质谱仪进行数据依赖模式采集,获得 precursor离子列表及对应的ms/ms碎片谱图。
10、步骤s2:数据预处理
11、对步骤s1获取的ms/ms谱图数据进行预处理,具体包括:
12、· 峰识别:识别谱图中的有效信号峰;
13、· 去同位素峰:去除同位素峰干扰;
14、· 噪声滤除:基于信噪比阈值滤除噪声信号;
15、· 归一化处理:将碎片离子强度归一化至统一量纲。
16、经预处理后,提取各碎片离子的质荷比(m/z)和强度信息,构建碎片离子特征矩阵。
17、步骤s3:深度学习模型解析
18、将预处理后的碎片离子特征矩阵输入预训练的多任务深度学习模型。所述模型包含三个核心模块:
19、(1)图神经网络编码模块
20、该模块将o-连接聚糖编码为有向无环图结构g=(v, e),其中:
21、· 节点集合v表示单糖单元,每个节点的特征向量包含单糖类型信息(如hexnac、hex、fuc、neuac、neugc等);
22、· 边集合e表示糖苷键连接,每条边的属性包含连接位置(如1→2、1→3、1→4、1→6等)和α/β构型信息;
23、· 图神经网络通过消息传递机制,迭代更新节点和边的特征表示,捕捉聚糖的分支拓扑信息。
24、(2)transformer特征提取模块
25、该模块采用多头自注意力机制,从碎片离子特征矩阵中提取长程依赖特征。具体而言:
26、· 将碎片离子的m/z和强度作为序列输入;
27、· 通过位置编码注入碎片离子的序列位置信息;
28、· 多层transformer编码器通过自注意力机制捕捉不同碎片离子之间的关联关系;
29、· 输出高维特征表示,供解码模块使用。
30、(3)多任务解码模块
31、该模块采用多任务学习架构,共享底层特征表示,通过多个任务特定的解码头同时输出:
32、· 任务一:单糖组成预测——输出o-连接聚糖所含单糖的种类和数量;
33、· 任务二:分支拓扑预测——输出聚糖的分支结构,包括核心类型和分支延伸模式;
34、· 任务三:糖苷键连接方式预测——输出各糖苷键的连接位置和α/β构型;
35、· 任务四:o-糖基化位点预测——输出o-连接聚糖在肽段上的具体连接位点(ser/thr位置)。
36、解码过程中采用集束搜索(beam search)算法生成候选o-连接聚糖结构,并基于碎片离子匹配度对候选结构进行排序和筛选。
37、步骤s4:结果输出
38、多任务解码模块输出o-连接聚糖的完整结构信息,包括:
39、· 单糖组成及序列;
40、· 分支拓扑结构(以图结构或树结构表示);
41、· 各糖苷键的α/β构型及连接位置;
42、· o-连接聚糖在肽段上的连接位点。
43、步骤s5:置信度评估
44、对步骤s4的输出结果进行置信度评估,为各结构预测输出置信度分数。当置信度分数低于预设阈值时,启动人工校验模式,将候选结构及对应的ms/ms谱图推送至用户界面供人工审核确认。
45、3. 模型训练
46、所述多任务深度学习模型的训练数据集包含不少于100,000张经实验验证并标注完整o-连接聚糖结构的ms/ms谱图。标注信息包括:
47、· 单糖组成(各单糖的种类和数量);
48、· 分支结构(核心类型、分支数目和延伸模式);
49、· 糖苷键连接方式(连接位置和α/β构型);
50、· o-糖基化位点(肽段上的具体ser/thr位置)。
51、训练采用多任务联合损失函数:
52、l_total = α·l_composition + β·l_topology + γ·l_linkage + δ·l_site
53、其中,l_composition、l_topology、l_linkage和l_site分别为四个预测任务的损失函数,α、β、γ、δ为各任务的权重系数。
54、4. 系统组成
55、本发明还提供一种基于深度学习的o-连接聚糖完整结构解析系统,包括:
56、· 数据获取模块:用于获取待解析o-糖肽样本的串联质谱数据;
57、· 数据预处理模块:用于对质谱数据进行峰识别、去同位素峰、噪声滤除和归一化处理;
58、· 图神经网络编码模块:用于将o-连接聚糖的非线性分支结构编码为图结构表示;
59、· transformer特征提取模块:用于提取碎片离子谱图中的长程依赖特征;
60、· 多任务解码模块:用于同时输出o-连接聚糖的单糖组成序列、分支拓扑结构、糖苷键连接方式以及o-糖基化位点;
61、· 置信度评估模块:用于对输出结果进行置信度评估;
62、· 输出模块:用于输出o-连接聚糖的完整结构信息及对应的置信度分数。
63、上述各模块采用端到端的联合训练方式,共享底层特征表示。
64、(三)有益效果
65、与现有技术相比,本发明具有以下有益效果:
66、1. 实现o-连接聚糖完整结构的端到端解析。 本发明首次将图神经网络、transformer和多任务学习相结合,实现了从原始ms/ms谱图到o-连接聚糖完整结构(单糖组成、分支拓扑、糖苷键连接方式)及o-糖基化位点的端到端自动化解析,克服了现有技术只能处理单一任务的局限。
67、2. 有效建模o-连接聚糖的非线性分支结构。 本发明采用图神经网络将o-连接聚糖编码为有向无环图结构,能够准确捕捉聚糖的分支拓扑信息,克服了传统线性序列模型无法处理分支结构的缺陷。
68、3. 不依赖数据库,可发现未知结构。 本发明采用生成式的深度学习方法,不依赖于已有的聚糖结构数据库,能够预测训练数据中未出现的新型o-连接聚糖结构,具有良好的泛化能力和未知结构发现能力。
69、4. 充分利用ms/ms谱图中的长程依赖信息。 本发明采用transformer架构提取碎片离子谱图中的长程依赖特征,能够捕捉不同碎片离子之间的关联关系,提高结构预测的准确性。
70、5. 实现多任务联合优化。 本发明采用多任务学习架构,四个预测任务共享底层特征表示,通过联合训练实现相互促进,提高各任务的预测精度。
71、6. 提供置信度评估和人工校验机制。 本发明对预测结果进行置信度评估,对低置信度结果启动人工校验模式,兼顾了解析的自动化程度和结果的可靠性。
72、参考文献
73、1. suideng qin, zhixin tian* (本发明的发明人). deep structure-leveln-glycan identification using feature-induced structure diagnosis integratedwith a deep learning model. analytical and bioanalytical chemistry, 2024,417, 1001–1014
74、2. 向梦辉; 田志新(本发明的发明人)。一种基于质谱的完整o-糖肽相对定量分析方法。中国专利, 申请号cn202410864029.8,申请日2024年6月30日。
75、3. zihan zhang, hua xu* and zhixin tian* (本发明的发明人).exploration of quantitative site-specific serum o-glycoproteomics withisobaric labelling for the discovery of putative o-glycoprotein biomarkers.proteomics-clinical applications, 2022, e2100095
76、4. james urban, chunsheng jin, kristina a. thomsson, niclas g.karlsson, callum m. ives, elisa fadda, daniel bojar. predicting glycanstructure from tandem mass spectrometry via deep learning. biorxiv, 2023,10.1101/2023.06.13.544793.
77、5. ejas althaf abtheen, arun singh, shyam sriram, changyou chen,sriram neelamegham, rudiyanto gunawan. transformer-based deep learning forglycan structure inference from tandem mass spectrometry. biorxiv, 2025,10.1101/2025.07.02.662857.
78、6. 杨奕; 方群. 一种基于深度学习的糖肽质谱图预测装置. 中国专利, 申请号cn202310828711.7, 申请日期2023年7月7日。
79、7. defeng li, zizheng nie, yanmin liu, xiaojun cai, yong zhang,xuefeng cui. iterative glycan structure generation by component localizationand classification from mass spectra. ieee international conference onbioinformatics and biomedicine (bibm), lisbon, 2024, 10.1109/bibm62325.2024.10821861.
80、8. james urban, roman joeres, luc thomès, kristina a. thomsson,daniel bojar. navigating the maze of mass spectra: a machine-learning guideto identifying diagnostic ions in o-glycan analysis. analytical andbioanalytical chemistry, 2025, 417, 931-943.
81、9. yu zong, yuxin wang, liang qiao. deep learning prediction ofintact n-/o-glycopeptide tandem mass spectra enhances glycoproteomics.biorxiv, 2025, 10.1101/2025.07.20.665808.
82、10. yu zong, yuxin wang, liang qiao. deep learning prediction of o-glycopeptide tandem mass spectra enhances o-glycoproteomics. advancedscience, 2026, 10.1002/advs.76760
83、11. shotaro kumozaki, kengo sato, and yasubumi sakakibara. a machinelearning based approach to de novo sequencing of glycans from tandem massspectrometry spectrum. ieee-acm transactions of computational biology andbioinformatics, 2015, 12, 1267-1274.
84、12. weiping sun, qianqiu zhang, xiyue zhang, ngoc hieu tran, m. ziaurrahman, zheng chen, chao peng, jun ma, ming li, lei xin & baozhen shan.glycopeptide database search and de novo sequencing with peaks glycanfinderenable highly sensitive glycoproteomics. nature communications, 2023, 14,4046.
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com