
一种食源α-淀粉酶抑制肽及其筛选方法和应用
本发明属于活性肽筛选,具体涉及一种食源α-淀粉酶抑制肽及其筛选方法和应用。
背景技术:
1、2型糖尿病是一种以血糖水平异常升高为主要特征的慢性代谢性疾病,已成为全球范围内重要的公共卫生问题。α-淀粉酶(α-amylase)能够催化膳食淀粉水解生成可吸收性糖类,在餐后血糖升高过程中发挥重要作用。因此,通过抑制α-淀粉酶活性降低淀粉消化速率,是调节餐后血糖水平的重要途径之一。目前,阿卡波糖、伏格列波糖和米格列醇等化学合成α-淀粉酶抑制剂已被广泛应用,但长期使用可能伴随胃肠道不适等不良反应,并存在一定的安全性风险。相比之下,来源于天然食物蛋白的α-淀粉酶抑制肽具有来源广泛、安全性较高等特点,近年来逐渐成为食品功能因子开发领域的研究方向。
2、南瓜籽(
cucurbita moschata duch.)是我国传统食品,富含优质蛋白质,其蛋白含量可达30%以上,且氨基酸组成均衡,是开发功能性活性肽的重要植物蛋白来源。有研究表明,南瓜籽蛋白经酶解后可产生具有α-淀粉酶抑制活性的蛋白水解产物,但停留于蛋白水解产物或粗分离组分的活性评价,对于其中发挥关键作用的活性肽段缺乏深入鉴定,尤其是具有明确氨基酸序列、高抑制活性及潜在应用价值的α-淀粉酶抑制肽仍有待进一步挖掘。因此,从南瓜籽蛋白中筛选并鉴定有α-淀粉酶抑制活性的特定多肽序列,对于丰富食源性功能肽资源、提高南瓜籽蛋白利用价值具有重要意义。
3、目前,食源性活性肽的发现通常依赖蛋白酶解、分离纯化、质谱鉴定以及活性验证等技术路线,但由于蛋白水解产物组成复杂,候选肽数量众多,导致活性肽的精准筛选仍存在一定困难。因此亟需一种方法能从复杂蛋白资源中发现潜在功能肽,为功能肽的筛选提供新的研究思路。
技术实现思路
1、本发明的目的在于提供一种食源α-淀粉酶抑制肽及其筛选方法和应用,利用本发明所述筛选方法获得的α-淀粉酶抑制肽具有来源天然、结构明确和较好的环境稳定性的特点,为植物蛋白来源α-淀粉酶抑制肽的高效筛选与开发提供了一种新的技术途径。
2、本发明提供了一种食源α-淀粉酶抑制肽的筛选方法,包括以下步骤:
3、(1)将待筛选多肽的氨基酸序列信息转化为autopeptideml平台可读的特征向量后,输入autopeptideml检测模型,得到autopeptideml检测结果;选择autopeptideml预测概率值>0.8的待筛选多肽为潜在活性肽;
4、所述autopeptideml检测模型采用径向基函数核,惩罚系数c为24.6767,类别权重设置为balanced,最大迭代次数为1000,开启概率预测功能,收敛容差参数tol为0.001;
5、(2)对所述潜在活性肽进行盲分子对接,筛选符合盲分子对接标准的潜在活性肽为初筛多肽;
6、所述盲分子对接标准包括:能够结合定位至α-淀粉酶的活性口袋区域,对接评分<-8.0;
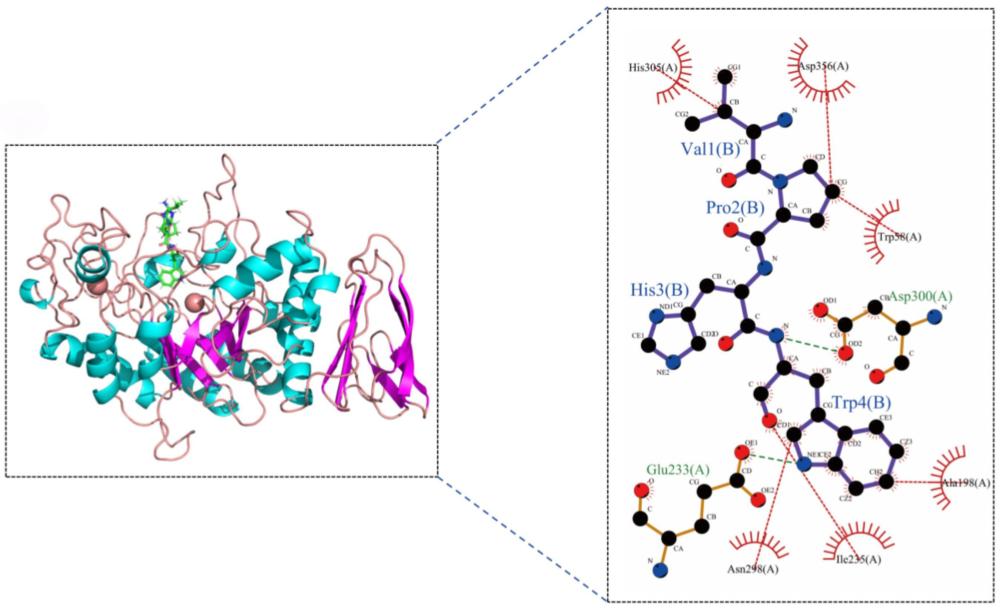
7、(3)利用haddock3平台,将α-淀粉酶催化活性区域相关残基asp197、glu233和asp300设置为约束区域,对所述初筛多肽进行精细化分子对接,筛选符合精细化分子对接标准的初筛多肽,得到食源α-淀粉酶抑制肽;
8、所述精细化分子对接标准包括:haddock score≤-80,prodigy δg≤-6 kcal/mol,与所述约束区域中的至少一个形成非共价相互作用。
9、作为一种优选方案,所述待筛选多肽的氨基酸残基长度为2~20。
10、作为一种优选方案,进行所述盲分子对接和精细化分子对接前,去除α-淀粉酶三维晶体结构中的水分子、原配体和杂原子。
11、作为一种优选方案,所述进行盲分子对接的平台包括autodock vina v1.2.7平台。
12、作为一种优选方案,所述待筛选多肽包括南瓜籽蛋白多肽。
13、作为一种优选方案,所述南瓜籽蛋白多肽的制备方法包括如下步骤:南瓜籽分离蛋白经体外模拟胃肠道消化获得消化产物,将所述消化产物经超滤分离和序列鉴定,获得所述南瓜籽蛋白多肽。
14、作为一种优选方案,所述转化的方法包括如下步骤:将所述氨基酸序列信息通过扩展连接指纹完成多肽结构特征编码,得到autopeptideml平台可读的特征向量。
15、本发明还提供了利用如上所述筛选方法得到的食源α-淀粉酶抑制肽。
16、作为一种优选方案,所述食源α-淀粉酶抑制肽的氨基酸序列如seq id no:15或seq id no:24所示。
17、本发明还提供了利用如上所述筛选方法得到的食源α-淀粉酶抑制肽或所述的食源α-淀粉酶抑制肽在以下至少一种中的应用:
18、(1)制备改善血糖的产品;
19、(2)制备改善血脂的产品;
20、(3)制备治疗2型糖尿病的药物;
21、(4)制备α-淀粉酶抑制剂。
22、有益效果:本发明提供了一种食源α-淀粉酶抑制肽的筛选方法,包括以下步骤:(1)将待筛选多肽的氨基酸序列信息转化为autopeptideml平台可读的特征向量后,输入autopeptideml检测模型,得到autopeptideml检测结果;选择autopeptideml预测概率值>0.8的待筛选多肽为潜在活性肽;所述autopeptideml检测模型采用径向基函数核,惩罚系数c为24.6767,类别权重设置为balanced,最大迭代次数为1000,开启概率预测功能,收敛容差参数tol为0.001;(2)对所述潜在活性肽进行盲分子对接,筛选符合盲分子对接标准的潜在活性肽为初筛多肽;所述盲分子对接标准包括:能够结合定位至α-淀粉酶的活性口袋区域,对接评分<-8.0;(3)利用haddock3平台,将α-淀粉酶催化活性区域相关残基asp197、glu233和asp300设置为约束区域,对所述初筛多肽进行精细化分子对接,筛选符合精细化分子对接标准的初筛多肽,得到食源α-淀粉酶抑制肽;所述精细化分子对接标准包括:haddock score≤-80,prodigy δg≤-6 kcal/mol,与所述约束区域中的至少一个形成非共价相互作用。利用本发明所述筛选方法获得氨基酸序列如seq id no:15和seq id no:24所示的南瓜籽蛋白来源α-淀粉酶抑制肽,通过生物信息学方法对所述南瓜籽蛋白来源α-淀粉酶抑制肽进行安全性预测,结果显示两种肽均未表现出明显毒性及潜在致敏风险。体外α-淀粉酶抑制活性实验结果表明,seq id no:15和seq id no:24均具有较好的α-淀粉酶抑制作用,其半数抑制浓度(ic50)分别为1.76±0.05 mmol/l和2.12±0.08 mmol/l。进一步的分子动力学模拟结果表明,两种多肽能够与α-淀粉酶形成稳定结合复合物。将本发明获得的两条肽序列在biopep-uwm数据库中进行检索,并与数据库中已知的α-淀粉酶抑制肽进行比对,结果显示,在数据库中均未见报道,因此,这两条多肽是尚未被公开报道的新型α-淀粉酶抑制肽。本发明提供的南瓜籽来源α-淀粉酶抑制肽具有来源天然、结构明确和较好的环境稳定性的特点,可作为功能性食品及相关产品开发中的候选活性组分。本发明为植物蛋白来源α-淀粉酶抑制肽的高效筛选与开发提供了一种新的技术途径。
23、与传统依赖大量实验逐一筛选活性多肽的方法相比,本发明通过机器学习预测与分子模拟相结合的计算辅助筛选策略,实现了对大量候选多肽的快速筛选,提高了功能活性肽发现的针对性和筛选效率。同时本发明实现了南瓜籽蛋白资源的高值化利用,并提供了一种基于机器学习和分子模拟辅助筛选南瓜籽蛋白来源α-淀粉酶抑制肽的方法,为功能食品活性肽的开发提供了新的技术途径。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com