
一种基于多示例学习的不确定性感知的单细胞数据表型相关细胞状态识别系统和方法
本技术涉及生物信息,特别涉及一种基于多示例学习的不确定性感知的单细胞数据表型相关细胞状态识别系统和方法。
背景技术:
1、与传统的混杂样本测序(将来自被测组织的所有细胞的读数混合在一起)相比,单细胞测序方法可以揭示单个细胞成分的特定作用。以单细胞rna测序(scrna-seq)为例,自2009年首次出现单细胞全转录组测序以来,技术发展迅速,包括全转录组扩增、自动细胞分离和多路复用。这些改进,尤其是基于液滴的方法的改进,使scrna-seq得到广泛应用甚至商业化。常见的scrna-seq方案仍面临某些挑战,例如需要新鲜组织的单细胞悬浮液,而单核测序可以作为处理冷冻或存档样本的替代方案。随着这些发展,测序细胞的数量在过去十年中呈指数级增长,目前的研究积累了数百万个细胞。如此大量的细胞使我们能够发现以前未知的稀有细胞类型、阐明细胞组成和表征复杂组织中的细胞相互作用,并且已经为健康和疾病人体组织建立了越来越多的单细胞图谱。因此,基于单细胞组学的国际计划应运而生,以人类细胞图谱(human cellatlas,hca)为突出代表,旨在分析所有人类细胞以构建全面的参考图谱。自首次推出以来,hca已经编制了前所未有的单细胞图谱,为疾病研究提供了新的策略。另一项计划“人类肿瘤图谱网络”(human tumor atlas network,htan)设定了一个雄心勃勃的目标,即描绘人类癌症的动态、多方面特征,从癌前病变开始,涵盖癌症发展和治疗的历史。总体而言,单细胞测序的出现彻底改变了癌症基因组学领域,为以前难以解决的问题提供了新策略并建立了新的研究范式。
2、单细胞组学推动了对肿瘤异质性的理解发生了深刻的范式转变。我们现在不仅可以在单细胞水平上探测癌细胞的特征,还可以全面解析其他肿瘤微环境细胞成分的功能表型,包括免疫细胞、成纤维细胞和其他基质细胞。事实上,单细胞研究已经揭示了多种肿瘤富集细胞类型,其中一些可能具有抗肿瘤功能,而另一些可能具有促肿瘤作用。然而,一个关键的挑战在于识别复杂细胞群中与特定表型相关的细胞状态,成功区分这些亚群可以增强表型特异性信号检测并改善下游分析。
3、传统上,人们采用基于聚类的方法来识别实验条件下细胞组成的变化。虽然在某些情况下这些方法很有效,但在响应亚群定义不明确或细胞过程连续(如细胞周期或发育轨迹)的情况下,这些方法往往无法发挥作用。为了解决这些限制,milo、meld、cna和daseq等不基于聚类方法利用更精细的单位来,例如细胞相似网络中的邻域,识别表型相关亚群。此外,ren等人引入了pencil,这是一种使用拒绝学习策略直接从流形中检测高置信度表型相关亚群的方法。尽管取得了这些进展,但现有方法依赖于监督框架,其中仅在患者级别可用的表型标签必须与细胞级别数据相关联。这种固有的弱监督设置限制了它们的有效性。
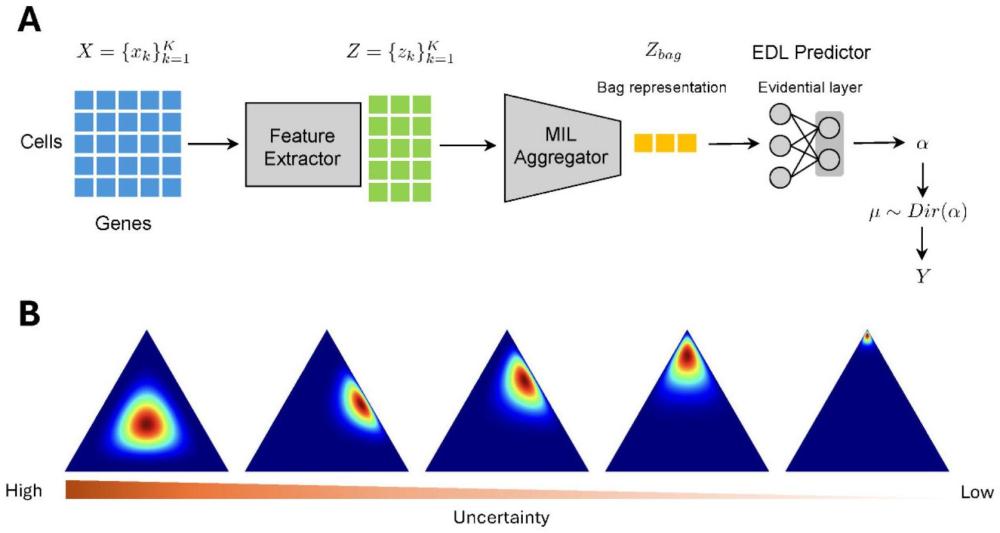
4、为了解决这些问题,提出了scmilua(multiple instance learning model withuncertainty awareness for phenotypic cell states identification from singlecell data),其是一种具有不确定性感知的多示例学习方法和系统,用于表型细胞状态识别。scmilua集成了来自样本级决策空间的权重共享示例估计器,并模拟二阶概率分布以估计样本和细胞级别的不确定性。
技术实现思路
1、本技术的目的在于提供一种基于多示例学习的不确定性感知的单细胞数据表型相关细胞状态识别系统和方法,该系统和方法通过不确定性感知的多示例学习,具有共享的基于证据深度学习的预测器,既可以输出样本水平的表型预测又可以输出细胞水平的表型预测。
2、本技术提供了一种用于表型相关细胞状态识别的系统,包括:特征提取器、训练好的基于注意力机制的多实例学习聚合器、训练好的基于证据深度学习的预测器、以及计算模块;
3、其中,在进行样本水平的预测时,所述特征提取器用于分别对多个样本的单细胞基因表达矩阵进行降维,从而获得每个样本的低维细胞级嵌入;
4、所述多实例学习聚合器被配置为分别对从所述特征提取器接收的每个样本的所述低维细胞级嵌入进行加权聚合,从而获得每个样本的样本级嵌入;
5、所述预测器被配置为基于所述多实例学习聚合器输出的所述每个样本的样本级嵌入,对每个样本进行表型预测,进而输出每个样本的样本水平的证据向量e,然后通过证据向量e获得dirichlet分布的参数α,其中e=(e1,e2,......,ek),α=(α1,α2,......,αk),k为表型类别数,所述证据向量e中第k个ek证据与dirichlet分布的参数αk的关系为αk=ek+1;
6、所述计算模块被配置为基于所述参数α计算得到每个样本的预测的表型标签。
7、在另一优选例中,表型的类别可以包括疾病与正常、响应与不响应、扰动前后等。
8、在另一优选例中,每个样本的预测的表型标签的期望通过以下公式获得:
9、
10、在另一优选例中,每个样本的低维细胞级嵌入即为每个样本的低维潜在表示。
11、在另一优选例中,每个样本具有一个单细胞基因表达矩阵。
12、在另一优选例中,假设样本独热编码标签y(即预测的表型标签)有k种情况服从categorical分布其中1(·)为指示函数,参数μk≥0且∑kμk=1,根据贝叶斯定理,其共轭先验分布为dirichlet分布:
13、
14、其中,μ∈δk-1,γ(·)是伽马函数,α0一般被称为dirichlet强度。dir(μ|α)表示了参数μ的概率分布,所以dir(μ|α)是样本标签分布的分布。根据dempster-shafer证据理论对主观概率的表示,输出的样本水平的证据向量中第k个ek证据与dir(μ|α)的参数αk的关系为αk=ek+1。
15、在另一优选例中,在对所述基于注意力机制的多实例聚合器进行训练时,所述多实例学习聚合器的输入特征为每个样本的真实表型标签和每个样本的低维细胞级嵌入,所述聚合器的输出特征为每个样本的样本级嵌入。
16、在另一优选例中,在对所述基于证据深度学习的预测器进行训练时,所述预测器的输入特征为从所述聚合器输出的每个样本的样本级嵌入以及每个样本的真实表型标签,所述预测器的输出特征为证据向量e。
17、在另一优选例中,在对所述特征提取器、基于注意力机制的多实例聚合器以及证据深度学习的预测器进行训练时,是端到端的训练。
18、在另一优选例中,所述基于证据深度学习的预测器通过损失函数进行训练,所述损失函数是基于输入的所述每个样本的真实表型标签和dirichlet分布的参数α设计得到的。
19、在另一优选例中,所述损失函数包括均方误差项、不确定性感知的正则化项以及散度损失。
20、在另一优选例中,所述预测器的输出层为激活函数层,所述激活函数为relu、指数函数、指数线性函数、或softplus中的一种。
21、优选地,所述激活函数为指数函数。
22、在另一优选例中,所述系统还能够输出细胞水平的表型预测,在进行细胞水平预测时,所述特征提取器被配置为将单细胞的基因表达向量进行降维,从而获得该细胞的低维潜在表示,所述训练好的基于证据深度学习的预测器还可被配置为基于从所述特征提取器输出的该细胞的低维潜在表示,并对该细胞进行表型预测,从而输出每个样本的细胞水平的证据向量。
23、在另一优选例中,所述计算模块还可被配置为基于参数α获得不确定性量化指标,所述不确定性量化指标包括总体不确定性、数据不确定性、以及模型不确定性。
24、在另一优选例中,所述总体不确定性通过dirichlet分布的期望的最大概率或熵计算;所述数据不确定性:通过预期熵计算;所述模型不确定性通过互信息计算。
25、在另一优选例中,所述特征提取器采用以下任一种方法获得所述低维细胞级嵌入:
26、(i)对所述单细胞基因表达矩阵进行标准化;
27、(ii)使用scvi模型生成的隐变量;
28、(iii)通过细胞图谱映射生成的隐变量;
29、(iv)基于geneformer模型的细胞嵌入。
30、优选地,所述特征提取器采用基于scvi模型生成的隐变量的方法进行特征提取,即获得所述低维细胞级嵌入。
31、本技术还提供了一种基于单细胞数据进行表型相关细胞状态识别的方法,包括以下步骤:
32、(a)获得待识别的样本的单细胞基因表达矩阵或单细胞的基因表达向量;
33、(b)将所述待识别的样本的单细胞基因表达矩阵或单细胞的基因表达向量输入至上述的系统中的特征提取器中,从而所述系统的训练好的基于证据深度学习的预测器输出所述待识别的样本的样本水平的证据向量e或所述待识别的样本的细胞水平的证据向量e,然后通过所述证据向量e获得dirichlet分布的参数α,其中e=(e1,e2,......,ek),α=(α1,α2,......,αk),k为表型类别数,所述证据向量e中第k个ek证据与dirichlet分布的参数αk的关系为αk=ek+1;
34、(c)通过所述系统的计算模块,基于所述参数α计算所述待识别的样本的样本的预测表型标签或所述待识别的样本的细胞的预测表型标签。
35、本技术的第三方面提供了一种电子设备,包括:
36、存储器,用于存储计算机可执行指令;以及,
37、处理器,与所述存储器耦合,用于在执行所述计算机可执行指令时实现如权利要求8所述的方法中的步骤。
38、本技术的第四方面提供了一种计算机可读存储介质,所述计算机可读存储介质中存储有计算机可执行指令,所述计算机可执行指令被处理器执行时实现如权利要求8所述的方法中的步骤。
39、本技术的第五方面提供了一种计算机程序产品,包括计算机可执行指令,其特征在于,该计算机可执行指令被处理器执行时实现上述方法中的步骤。
40、应理解,在本发明范围内中,本发明的上述各技术特征和在下文(如实施例)中具体描述的各技术特征之间都可以互相组合,从而构成新的或优选的技术方案。限于篇幅,在此不再一一累述。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com