
一种儿童癫痫风险分层评估系统
本发明涉及生物医药与临床体外诊断,尤其涉及一种儿童癫痫风险分层评估系统。
背景技术:
1、癫痫是儿童期最常见且严重影响神经发育的神经系统疾病之一。目前,临床上对儿童癫痫的诊断以及严重程度的分层,主要依赖于脑电图(eeg)监测和临床发作症状学观察。在分子机制探索方面,现有研究表明癫痫发作会引发大脑急性能量危机,并触发嘌呤代谢网络的改变;然而,这些证据绝大多数来源于动物模型,或者仅仅是对单一体液代谢物(如单独测定血液中的尿酸或腺苷水平)的零散测定。存在以下不足:
2、(1)缺乏底层的分子预警指标:现有的常规临床分层手段(如eeg和症状学分类)主要反映表象,具有一定的滞后性,无法真实反映驱动疾病进展的底层分子与代谢过程。因此,临床上难以在疾病早期客观、准确地预测哪些患儿未来具有极高的癫痫持续状态(se)发作风险。
3、(2)单一代谢物检测的局限性:现有的单一代谢标志物检测缺乏系统性,难以全面反映癫痫状态下的能量代谢网络全貌。
4、(3)忽视了群体的代谢异质性:现有的临床评估方法忽略了癫痫患儿群体内部存在的巨大代谢异质性。
5、本团队早期的研究成果专利cn119291105a一种用于诊断或预后评估癫痫患儿的标志物及其检测方法和应用,公开了报告了癫痫患儿与健康对照在血/尿嘌呤代谢物浓度的差异,且构建基于血/尿液嘌呤各指标差异的疾病预测模型,建立综合评分算法,便于检测结果解读,为儿童癫痫发作的诊断和预后评估提供临床依据。但这个研究成果只能用于癫痫定性诊断,无法区分患儿病情轻重、预判癫痫持续状态与药物难治风险,也未结合完整嘌呤代谢网络开展分型评估,难以满足临床精细化分层诊疗的需求,目前临床还急需一套能够基于全身嘌呤代谢网络状态进行客观分层,从而指导精准医疗的组合型生物标志物及配套评估工具。
技术实现思路
1、本发明要解决的技术问题是目前针对评估癫痫患儿的嘌呤代谢物只能用于癫痫定性诊断,无法区分患儿病情轻重、预判癫痫持续状态与药物难治风险,也未结合完整嘌呤代谢网络开展分型评估,在儿童癫痫早期精准分层和重症预警方面存在的局限性,难以满足临床精细化分层诊疗的需求。
2、为解决上述问题,本发明提供了一种儿童癫痫风险分层评估系统,首次根据一组特定的系统性嘌呤代谢生物标志物组合(包括三磷酸腺苷、二磷酸腺苷、一磷酸腺苷、腺苷、腺嘌呤、次黄嘌呤、黄嘌呤和尿酸共8种核心物质),通过联合监测上游能量代谢物储备的消耗与下游降解产物的过度积聚,精准量化并识别出处于“高分解代谢状态”的特定患儿亚群,更敏锐、全面地捕捉癫痫引发的全身性代谢级联反应与氧化应激状态,能够在病情恶化前,提前识别出具有更高抗癫痫药物治疗负担以及具有显著较高癫痫持续状态并发风险的高危人群,提供了一种客观的代谢内型分层手段,从而为儿科临床制定个性化、靶向性的干预策略提供坚实的分子依据。
3、为达到上述目的,本发明主要通过以下技术手段实现:一种儿童癫痫风险分层评估系统(可搭载于计算机或云端服务器),通过以下步骤实现患儿的代谢内型自动分层及重症预警:
4、(1)数据获取与绝对定量:将受试患儿的空腹血清样本经前处理后,经检测得到8种嘌呤代谢物的绝对浓度;所述8种嘌呤代谢物为磷酸腺苷(atp)、二磷酸腺苷(adp)、一磷酸腺苷(amp)、腺苷(adenosine)、腺嘌呤(adenine)、次黄嘌呤(hypoxanthine)、黄嘌呤(xanthine)以及尿酸(uric acid);
5、(2)特征向量标准化:
6、由于不同代谢物的浓度跨度较大,数据处理模块首先接收8种代谢物的绝对浓度数据,对其进行z-score 标准化(归一化)处理,以确保各代谢物特征在后续计算中具有相同的权重,生成标准化特征向量;
7、其中,z-score 标准化(归一化)处理的参数如下:
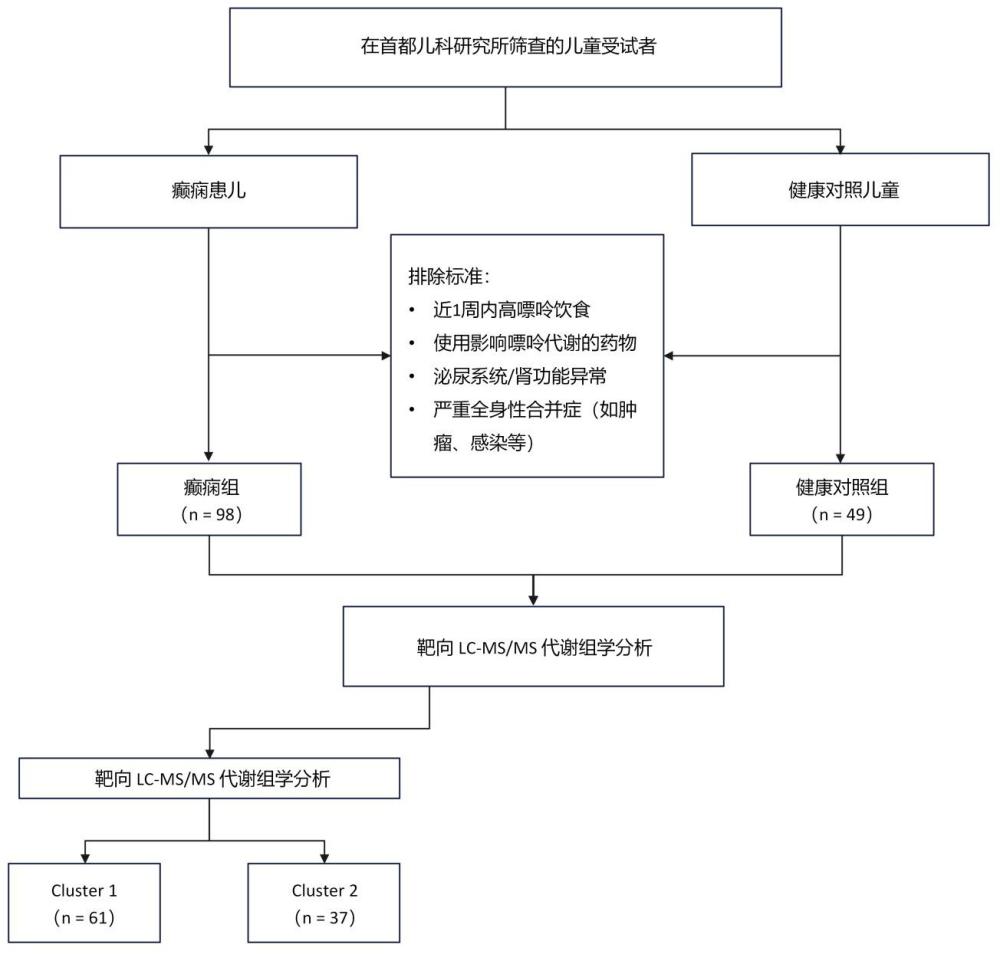
8、标准化对象:仅纳入 98 例癫痫患儿,不包括 49 例健康对照;
9、标准化方式:r 的 scale(epi_matrix),即对每一种代谢物按列进行 z-score 标准化;
10、均值:该代谢物在 98 例癫痫患儿中的算术平均值;
11、标准差:该代谢物在 98 例癫痫患儿中的样本标准差,分母为 n1=97;
12、后续 k-means 聚类使用的就是这 8 个标准化后的变量。
13、对应公式为:
14、其中:
15、xij表示第i名患儿第j种嘌呤代谢物的原始绝对浓度,μj和sj分别表示该代谢物在建模队列中的均值和样本标准差。
16、(3)无监督机器学习聚类判读:
17、将步骤(2)生成的特征向量输入预设的无监督 k-means 聚类模型;该模型基于预先设定的聚类中心(k=2),计算当前输入样本的欧式距离,将受试者自动归入以下两种代谢内型之一:
18、低嘌呤代谢负荷型cluster 1:对于待评估患儿,其由atp、adp、amp、腺苷、腺嘌呤、次黄嘌呤、黄嘌呤和尿酸构成的8维标准化特征向量,与低嘌呤代谢负荷型聚类中心之间的欧氏距离小于其与高嘌呤代谢负荷型聚类中心之间的欧氏距离,则判定为低嘌呤代谢负荷型cluster 1。所述低嘌呤代谢负荷型聚类中心的8项标准化代谢物特征值平均值低于高嘌呤代谢负荷型聚类中心,反映其整体嘌呤代谢负荷相对较低。
19、高嘌呤代谢负荷型cluster 2:对于待评估患儿,其标准化特征向量与高嘌呤代谢负荷型聚类中心之间的欧氏距离小于其与低嘌呤代谢负荷型聚类中心之间的欧氏距离,则判定为高嘌呤代谢负荷型cluster 2。
20、atp、adp和黄嘌呤与上述代谢物共同构成8项嘌呤代谢物的联合特征。atp和adp用于反映上游腺嘌呤核苷酸池及能量代谢状态,黄嘌呤用于反映次黄嘌呤向尿酸转化过程中的中间代谢环节。经z-score标准化后,所述8项代谢物以相同权重参与k-means聚类及欧氏距离计算;各代谢物对具体患儿分型的实际影响,取决于其标准化数值与两个聚类中心相应特征值之间的差异。
21、其中,atp、adp、黄嘌呤这三个指标:用于维持完整代谢通路信息和提高多维特征判别稳定性的辅助特征变量,而不是必须单独显著异常的风险指标。如下表1所示:
22、表1:atp、adp、黄嘌呤的作用
23、
24、在两类代谢内型的区分中,amp、腺苷、腺嘌呤、次黄嘌呤和尿酸的差异更为明显,是反映组间代谢特征差异的主要指标;atp、adp 和黄嘌呤则与上述指标共同构成 8 项嘌呤代谢物的联合特征,用于保留上游能量代谢及下游分解过程的整体信息,并提高个体分型的可靠性。
25、其中具体判定标准如下:
26、在模型建立阶段,采用 k-means 聚类算法将儿童癫痫建模队列划分为两个聚类。分别计算两个聚类中心中 8 项标准化嘌呤代谢物特征值的平均值;平均值较低的聚类中心定义为低嘌呤代谢负荷型聚类中心,平均值较高的聚类中心定义为高嘌呤代谢负荷型聚类中心。(具体公式:先对两个聚类中心分别计算:,其中ckj是第k个聚类中心中第j个代谢物的z-score。然后:qk更低的聚类中心,命名为“低嘌呤代谢负荷型”;qk更高的聚类中心,命名为“高嘌呤代谢负荷型”。这一步只是一个给两个训练集聚类中心命名的规则,不是针对每位患儿的分型规则。其中,qk表示该聚类中心8项标准化嘌呤代谢物特征值的平均水平。由于各代谢物均已进行z-score标准化,其中z-score为0表示与建模队列总体平均水平相当,正值表示高于建模队列总体平均水平,负值表示低于建模队列总体平均水平。因此,qk较低表示该聚类中心的8项嘌呤代谢物标准化特征整体处于相对较低水平,即总体嘌呤代谢负荷相对较低;qk较高表示该聚类中心的8项嘌呤代谢物标准化特征整体处于相对较高水平,即总体嘌呤代谢负荷相对较高。
27、在模型应用阶段,对于待评估患儿,计算其8维标准化特征向量分别与低嘌呤代谢负荷型聚类中心及高嘌呤代谢负荷型聚类中心之间的欧氏距离。当所述待评估患儿与低嘌呤代谢负荷型聚类中心之间的欧氏距离小于其与高嘌呤代谢负荷型聚类中心之间的欧氏距离时,将其判定为低嘌呤代谢负荷型(cluster 1);反之,将其判定为高嘌呤代谢负荷型(cluster 2)。(具体公式:模型建立完成后,两个中心已固定,即clow:已命名的低嘌呤代谢负荷型中心;chigh:已命名的高嘌呤代谢负荷型中心。对于新患儿,只需计算其与两个固定中心的距离:,其中,zj表示待评估患儿第j项嘌呤代谢物经z-score标准化后得到的标准化特征值,j=1,2,……,8,依次对应atp、adp、amp、腺苷、腺嘌呤、次黄嘌呤、黄嘌呤和尿酸。clow,j和chigh,j分别为低嘌呤代谢负荷型和高嘌呤代谢负荷型聚类中心的第j项坐标值。若dlow 28、严格来说,k-means模型没有预先设定或自动学习得到的代谢物权重。在 z-score标准化后,8个指标均以相同权重进入欧氏距离计算。对于任一待测患儿,与某一聚类中心的距离为:;其中第j项代谢物对该距离的样本特异性贡献为:。也就是说:各代谢物在算法层面的基础权重相同;某个代谢物对某一患儿归类的实际贡献,取决于该患儿该指标与两个聚类中心的偏离程度;两个cluster的总体分离程度,可用两个聚类中心在该指标上的绝对差值衡量:,δj越大,说明该指标对区分两种代谢内型的贡献越大。 29、第一层模型分型:k-means 聚类本身不依赖 p 值。个体归类只取决于其距离两个聚类中心的远近。 30、第二层组间代谢物差异验证:整体嘌呤代谢负荷升高,应以 cluster 1与cluster 2间的统计检验为依据。对cluster 1和cluster 2中各代谢物浓度进行双侧组间比较。正态分布且方差齐的数据采用独立样本t检验;不满足正态分布或方差齐性的数据采用mann–whitney u检验。以双侧 (p<0.05) 作为差异具有统计学意义的判定标准。 31、当cluster 2中某代谢物的浓度低于cluster 1,且 (p<0.05) 时,判定该代谢物在cluster 2中显著降低;当cluster 2中某代谢物的浓度高于cluster 1,且 (p<0.05)时,判定该代谢物在 cluster 2中显著升高。 32、在本发明中,对cluster 1与cluster 2间各代谢物的原始浓度进行组间比较,并以双侧 (p<0.05) 作为差异具有统计学意义的判定标准。amp、腺苷、腺嘌呤、次黄嘌呤和尿酸为两种代谢内型间差异较为明显的主要特征代谢物。atp、adp 和黄嘌呤即使未达到统计学显著性,仍作为联合特征向量的一部分参与代谢内型判定,以保留完整嘌呤代谢通路的信息。 33、(4)风险等级输出与可视化预警: 34、若模型判定受试者属于 cluster 1,系统输出“常规风险”报告。 35、若模型判定受试者属于 cluster 2高嘌呤代谢负荷型,系统自动触发预警机制,输出“高危风险”报告;报告提示该患儿当前具有更严重的全身性能量失衡与氧化应激,临床预后提示其具有显著更高的抗癫痫药物治疗负荷,即易发展为药物难治,以及更高的癫痫持续状态发作并发风险;同时,系统ui界面同步生成该患儿嘌呤代谢物的雷达图或热图对比,辅助临床医生直观识读代谢网络异常节点。 36、进一步的,步骤(1)将受试患儿的空腹血清样本经前处理后,输入液相色谱-串联质谱(lc-ms/ms)系统;在正离子电喷雾(esi+)模式下通过多反应监测(mrm)获取色谱峰面积;系统根据标准曲线及内标比值,自动计算得出8种嘌呤代谢物的绝对浓度。 37、其中,所述液相色谱-串联质谱系统包括waters i-class液相色谱系统及sciexqtrap 4500质谱仪,每份样本的进样体积为5μl,采用hss t3色谱柱进行色谱分离;所述色谱柱规格为100 × 2.1 mm,填料粒径为1.8μm,柱温为30℃;采用正离子电喷雾模式和多反应监测模式对atp、adp、amp、腺苷、腺嘌呤、次黄嘌呤、黄嘌呤及尿酸进行定量检测。 38、其中,尿酸根据其与尿酸-1,3-¹5n2内标物的峰面积比进行定量校正;atp、adp、amp、腺苷、腺嘌呤、次黄嘌呤及黄嘌呤根据其与肌酐甲基-d3内标物的峰面积比进行定量校正。结合由各代谢物对应标准品建立的标准曲线,计算各待测嘌呤代谢物的绝对浓度。 39、进一步的,步骤(1)的前处理方式为经检测试剂盒前处理,所述检测试剂盒其组成包含: 40、同位素内标液:包含用于校正基质效应和提取回收率的稳定同位素标记物,具体包括尿酸-1,3-¹5n2(用于尿酸校正)以及肌酐-d3(用于其余嘌呤代谢物校正); 41、样本前处理试剂:包含针对靶向质谱优化的用于蛋白沉淀的含有上述内标液的乙腈溶液,以及用于干式复溶的0.75%氨水溶液; 42、校准标准品:包含已知绝对浓度的8种核心嘌呤代谢物的纯品混合物,用于构建标准曲线。 43、进一步的,使用所述检测试剂盒用于对血清样本进行前处理及定量检测,步骤如下:使用所述检测试剂盒时,将同位素内标液加入乙腈沉淀液中形成含内标的蛋白沉淀试剂;所述含内标的蛋白沉淀试剂用于血清样本中蛋白质沉淀,并在样本前处理过程中加入稳定同位素内标物;经蛋白沉淀、离心、真空干燥和氨水复溶后,所得待测样本进行液相色谱-串联质谱检测;校准标准品用于建立8种核心嘌呤代谢物的标准曲线。 44、具体地,使用所述检测试剂盒进行前处理的过程如下: 45、取经自然解冻后的空腹血清样本50μl,加入160μl含稳定同位素内标物的乙腈沉淀液,所述乙腈沉淀液中包含浓度为50μg/ml的尿酸-1,3-¹5n2和浓度为100 μg/m的肌酐甲基-d3。涡旋混匀30秒后,于4℃孵育10分钟,以沉淀血清蛋白。 46、随后,将混合液于10,000 ×g条件下离心10分钟,吸取120μl上清液,并采用真空离心方式完全干燥。向干燥后的残留物中加入50μl浓度为0.75%的氨水溶液进行复溶,涡旋混匀30秒后,再于相对离心力10,000 ×g条件下离心10分钟。其中×g表示离心加速度相对于标准重力加速度g的倍数,10,000 ×g即离心加速度为标准重力加速度的10,000倍。 47、收集离心后的澄清上清液,并取40μl转移至自动进样瓶中,获得待测样本。将所述待测样本输入液相色谱-串联质谱系统进行检测。 48、本发明的有益效果在于: 49、(1)系统性与多维度的精准评估(对应核心标志物组合):突破了既往单一生物标志物的局限性。本方案将8种嘌呤代谢物作为完整的组合,能够敏锐捕捉从上游能量底物(如amp)消耗到下游降解产物(腺苷、腺嘌呤、次黄嘌呤、尿酸等)过度积聚的级联反应。这种组合模式全面反映了癫痫诱发的全身性能量失衡与氧化应激状态,大幅提升了检测的灵敏度和疾病病理反映的准确性。 50、(2)客观的数据分层(对应系统的数据处理逻辑):克服了传统脑电图和临床症状学分类的主观性和滞后性。通过标准化的lc-ms/ms绝对定量结合无监督k-means 聚类算法,首次在分子层面实现了癫痫患儿的“代谢内型”客观划定,避免了人为判断的偏差。 51、(3)高临床转化价值的直观预警(对应风险等级输出及ui):能够提前识别处于“高分解代谢状态(cluster 2)”的高危患儿,精准预测其后续面临的极高抗癫痫药物治疗负荷及并发癫痫持续状态的风险。此外,系统输出端采用了去除冗余数值标签的精简堆叠条形图,以极其干净、直观的可视化方式呈现核心代谢负荷的分布差异,为临床医生提供清晰无干扰的决策辅助,为调整靶向干预方案争取了黄金时间。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com