
基于视觉感知动态提示的声源定位方法
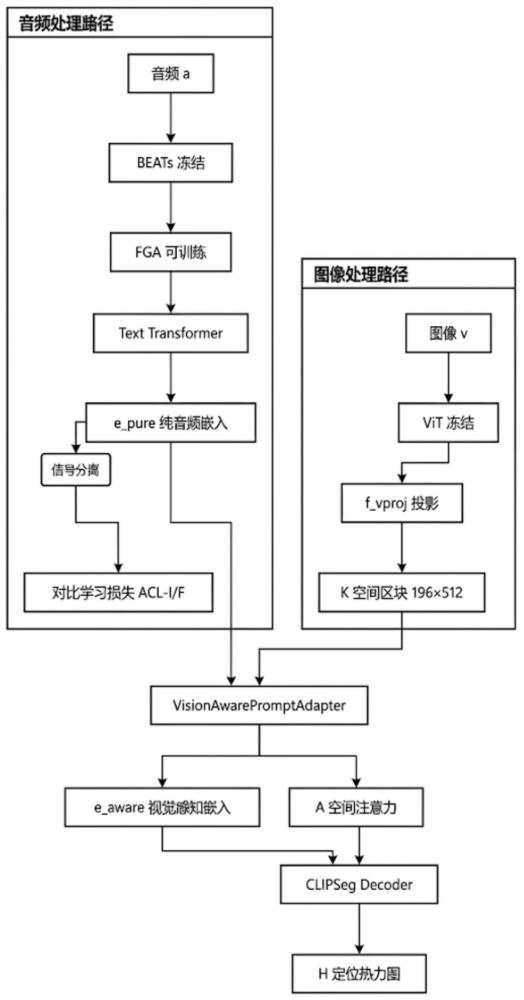
本发明属于计算机视觉与听觉交叉,涉及深度学习、多模态表示学习、图像分割、自监督学习和对比学习等子领域。
背景技术:
1、声源定位(sound source localization)旨在根据输入的音频信号和对应的图像,在图像中定位出发出该声音的物体或区域。比如,智能安防监控中的异常声源定位与追踪、视频会议系统中发言人的自动定位与画面切换、自动驾驶车辆中紧急车辆(如救护车、警车)鸣笛声的方位感知、增强现实和虚拟现实中基于声音的交互定位、机器人听觉导航与循声定位、多媒体内容分析与检索中的音视频关联定位等。给定一批音视频对,声源定位的任务目标是生成热力图,使其高亮区域与音频在图像中的声源位置重合。
2、近年来,基于自监督对比学习的声源定位方法取得了显著进展,其核心思想是利用自然同步的音视频对进行训练,通过对比学习框架将音频表征与对应图像区域的视觉表征进行对齐,无需使用位置标注即可实现声源定位。
3、现有的代表性方案主要为基于音频引导的对比学习(audio-groundedcontrastive learning,简称 acl)框架,可以发现其在条件信号的生成机制上存在一个明显的结构性缺陷:进入定位解码器作为搜索引导的条件信号,完全由音频处理路径独立产生。
4、该条件信号的生成过程仅依赖于输入的音频样本和固定的文本提示模板,与当前对应的输入图像的具体视觉内容没有任何直接的数据关联。换言之,解码器在执行定位任务时,仅仅凭借单纯的音频语义特征,在图像的多层视觉特征中进行“盲找”以匹配声音对应的区域。这种“纯音频驱动”的设计导致了以下两个核心局限:
5、(1)存在严重的视觉空间信息传递瓶颈。 在现有机制下,视觉空间信息必须通过对比学习损失的梯度反向传播,以一种间接且低效的长链条路径,隐式地“压缩”进音频投影层的参数中。这种方式导致模型传递视觉先验信息的能力极差,解码器接收到的条件引导信号本质上仅仅是音频的单变量特征,严重缺乏关于当前图像空间布局的前置先验知识。
6、(2)缺乏对特定视觉场景的动态适应能力。 由于条件信号仅依赖于音频内容的输入,这意味着对于同一段给定的声音(例如一段特定旋律的吉他声),无论与之对应的图像场景发生何种变化(例如吉他手在画面左侧或是右侧,图像背景复杂或是简单),模型输入给解码器的条件信号始终是固定不变的。模型无法根据当前图像的具体视觉内容去动态调整这个引导信号。而在理想情形下,解码器应当接收一个融合了音视频双模态特征的动态引导信号,该信号不仅需要指示“这是什么声音”的语义属性,还应当结合当前画面前置性地包含“在这幅特定图像中,声音大概来源于哪个候选位置”的空间先验提示。
技术实现思路
1、具体而言,本发明涉及一种声源定位(sound source localization)方法及系统,其核心在于:在预训练的视觉-语言联合语义空间中,利用免参数的跨模态注意力机制,从图像的视觉空间特征中检索与音频语义相关的空间先验信息,并以门控残差方式将该空间先验动态注入音频表征,从而使解码器获得视觉空间引导——即"声音大概在图像中哪个位置"的提示信息。
2、与本发明最相关的底层技术包括:(1)基于 transformer 的视觉编码器(visiontransformer, vit)和音频编码器,用于从图像和音频中提取语义特征;(2)视觉-语言联合语义空间(如 clip 预训练模型),用于实现跨模态语义对齐;(3)基于对比学习的自监督训练框架(如 infonce 损失),用于在无位置标注的条件下驱动模型学习音频与视觉特征之间的对应关系;(4)轻量级的条件解码器(如 clipseg),用于根据条件嵌入信号生成像素级定位热力图。
3、本发明的方法和系统可广泛应用于以下技术场景:智能安防监控中的异常声源定位与追踪、视频会议系统中发言人的自动定位与画面切换、自动驾驶车辆中紧急车辆(如救护车、警车)鸣笛声的方位感知、增强现实和虚拟现实中基于声音的交互定位、机器人听觉导航与循声定位、多媒体内容分析与检索中的音视频关联定位等。
4、本发明采用的技术方案为:一种基于视觉感知动态提示的声源定位方法,设整个vadp模型由以下组件构成:冻结的音频编码器faudio、可训练的音频投影层fproj、冻结的文本变换器ftext、冻结的视觉编码器fvision、冻结的视觉投影层fvproj、冻结的解码器fdec,以及本发明新增的核心组件——视觉感知提示适配器fadapter。适配器新增的可学习参数记为θadapter。
5、该方法包括以下步骤:
6、s1、将输入的音频信号通过音频编码器和音频投影层,得到音频嵌入,将所述音频嵌入通过文本变换器映射到联合语义空间,得到纯音频驱动嵌入;
7、;
8、;
9、;
10、其中,b为批次大小,d为联合语义空间维度。epure为纯音频驱动嵌入,表示经由所述音频编码器提取得到的音频时序隐藏状态特征,表示经线性投影后得到的音频嵌入;
11、s2、将输入的图像通过视觉编码器提取隐藏状态,将所述隐藏状态通过视觉投影层映射到所述联合语义空间,并去除全局类别标记,得到视觉空间区块嵌入;
12、;
13、其中,n=h/p×w/p为空间区块数量,+1为全局类别标记,记为[cls]token;为视觉特征维度;随后通过视觉投影层映射到联合语义空间,并丢弃[cls]token:
14、;
15、其中,k为视觉空间区块嵌入矩阵,其中每一个行向量k[b,n,:]对应图像b中第n个空间区块在联合语义空间中的表示;
16、s3、将所述纯音频驱动嵌入作为查询向量,将所述视觉空间区块嵌入同时作为键向量和值向量,在所述联合语义空间中执行免参数跨模态注意力检索,得到空间注意力分布和视觉提示向量;
17、将纯音频驱动嵌入epure和视觉空间区块嵌入k送入视觉感知提示适配器:
18、;
19、其中:
20、为视觉感知增强嵌入,供解码器使用;
21、a∈r^{b×1×n}为空间注意力分布图,表征了音频语义与图像各空间区域的相关性;
22、所述视觉感知提示适配器,由免参数语义注意力模块、前馈精炼网络和可学习门控参数模块构成;
23、s3.1、免参数语义注意力模块的构建,该模块利用clip联合语义空间中已有的跨模态对齐知识,在不引入任何可学习q、k、v投影矩阵的前提下,完成从音频到视觉空间的注意力检索:
24、s3.1.1、将音频嵌入的query和视觉空间区块嵌入的key/valu在特征维度上进行l2归一化,转换为单位超球面上的向量:
25、;
26、;
27、
28、其中表示沿最后一维的l2范数;经归一化后,
29、,。
30、s3.1.2、query和key两者的内积等于余弦相似度:
31、;
32、其中×表示批次矩阵乘法;展开到单个样本:
33、;
34、该值表征了第b个样本的音频嵌入与图像中第n个空间区块在联合语义空间中的语义相似度;
35、s3.1.3 引入温度系数τ对相似度进行缩放:
36、;
37、温度系数τ的作用是调控softmax分布的锐度;当τ增大时,分布更集中;当τ减小时,分布更平滑;
38、s3.1.4、softmax归一化得到空间注意力分布:
39、;
40、展开到单个样本的单个空间位置:
41、;
42、a满足,构成一个概率分布;a[b,0,n]越大,表示第n个空间区块与当前音频在语义上越相关;
43、s3.1.5、注意力加权检索视觉提示向量:
44、;
45、展开到单个样本:
46、;
47、p是视觉空间区块嵌入的注意力加权和;
48、s4、对所述视觉提示向量进行前馈网络精炼和可学习门控残差注入,得到视觉感知增强嵌入;
49、s4.1、注意力加权检索得到的视觉提示向量p是一个粗糙的线性组合,通过前馈网络对其进行非线性变换和精炼:
50、;
51、;
52、其中w1∈r4d×d,b1∈r4d,w2∈rd×4d,b2∈rd;
53、gelu激活函数定义为:
54、;
55、其中φ(·)为标准正态分布的累积分布函数;
56、dropout层以概率p=0.1随机置零部分神经元的输出,其表达为:
57、;
58、s4.2、可学习门控残参数:
59、精炼后的视觉提示以残差门控方式注入原始音频嵌入:
60、;
61、其中γ∈r1为可学习的标量门控参数;
62、γ0=1×10⁻⁴的选择具有深刻的训练动力学意义。在训练初期(epoch0),视觉提示的贡献为γ0·prefined≈10-4·prefined≈0,此时:
63、;可学习的标量门控参数
64、随着训练进行,音频嵌入epure在对比学习损失的驱动下质量逐步提升,注意力检索的精度自然提高,视觉提示向量p的语义质量改善。由于eaware的质量提升(更好的定位→更低的解码器损失)会通过链式法则向γ传递梯度:
65、;
66、当prefined的语义质量较高时,∂l/∂γ的期望值更可能为负(即增大γ有利于降低损失),γ在梯度下降中自然增大;当prefined质量不高时,增大γ反而可能增大损失,γ的增长受限。这种自适应的梯度动力学使得模型能够自主决定引入视觉引导的时机和程度,实现了自然的渐进式学习,无需人工设计复杂的多阶段学习率或权重调度。
67、适配器使音频嵌入从仅为音频的函数变为同时依赖音频和图像的函数:
68、;
69、s5、将所述视觉感知增强嵌入作为条件信号送入解码器,生成声源定位结果:
70、;
71、eaware作为解码器的条件嵌入信号。
72、本发明的一个关键设计是训练和推理的信号分离策略。设lcontrastive为对比学习损失,ldecoder为解码器定位损失。信号分离策略可形式化表示为:
73、对比学习路径(使用纯音频嵌入):
74、;
75、解码器路径(使用视觉感知增强嵌入):
76、;
77、其中vi和vf分别为图像级和特征级视觉嵌入。
78、该设计的梯度流分析如下。对比学习损失的梯度仅影响音频编码路径:
79、;
80、即视觉感知提示适配器的参数θadapter不接收来自对比学习损失的直接梯度信号。这确保了:
81、(1)对比学习的优化目标保持纯净——不受视觉信息注入的干扰,始终专注于音频-视觉语义对齐;
82、(2)适配器的参数仅通过解码器定位损失ldecoder进行优化,其学习目标明确为"提升定位精度"。
83、从信息论角度,信号分离可理解为将联合优化问题分解为两个正交的子问题:
84、;
85、;
86、两个子问题共享音频投影层参数θa,但适配器参数θadapter仅在第二个子问题中更新。
87、本发明的有益效果为:(1)充分利用预训练联合语义空间,有效抑制过拟合。 本发明充分利用了大规模视觉-语言联合语义空间中已有的跨模态对齐先验知识(即匹配的图文特征在语义空间中天然具有较高的几何相似度)。在进行跨模态注意力检索时,本发明无需引入并学习额外的查询、键、值投影矩阵,而是直接在同一语义空间中计算特征的相似度。这种免参数的检索设计极大地缩减了模型所需的参数量,有效避免了在小规模声源定位数据集上训练时容易引发的过拟合问题。
88、(2)极低的额外参数开销与高计算效率。 本发明所提出的视觉感知提示适配器中,其核心的跨模态注意力计算模块实现了零参数开销。整个适配器仅在前馈网络精炼模块和残差门控模块引入了少量用于降噪、映射和调控的可学习参数。相较于主干模型的总参数量,本发明引入的额外参数占比极低,能够在不显著增加硬件显存占用和推理延迟的前提下,大幅提升定位性能,具有极高的工程实用价值。
89、(3)具备自适应的渐进式学习能力。 本发明通过在视觉提示信息注入环节引入可学习的标量门控参数,并允许其在反向传播中自然接收解码器定位损失的梯度。这种设计赋予了模型一种自适应的训练动力学特性:在训练初期,模型自发地等价于纯音频驱动方案,专注于音频基础特征的提取与对齐;随着训练推进,当音频语义表征质量提升后,门控参数的权重在梯度驱动下自动增大,模型开始平滑地引入视觉空间先验。整个过程自主达到动态平衡,完全无需人工设计复杂的多阶段学习率调度策略。
90、(4)卓越的类别无关与零样本泛化能力。 本发明中的视觉空间引导信息检索完全基于跨模态语义特征之间的几何度量(相似度计算),而不依赖于任何预定义的类别标签或分类器网络。只要输入的音频信号在联合语义空间中具有合理的表征,无论该类型声音在训练阶段是否出现过,适配器均能有效检索到相匹配的视觉上下文。这赋予了本发明极强的类别无关特性和零样本(zero-shot)泛化能力,能够轻松应对开放场景下的未知声源。
91、(5)优异的模型决策可解释性。 相较于传统深度学习模型中难以洞察的“黑盒”注意力机制,本发明在免参数跨模态检索阶段生成的空间注意力分布,可以直接映射并可视化为与输入图像尺寸对应的二维空间注意力热力图。该热力图直观、透明地展示了模型在生成条件引导信号时,其底层决策所依赖的视觉空间依据,为模型的故障调试、可信度评估以及在实际业务(如自动驾驶、安防)中的安全部署提供了极高的应用价值。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com