
视频编解码系统中编解码模式选择的方法和装置与流程
本发明涉及视频编解码系统。特别地,本发明涉及依据边界匹配成本重新排序模式候选,以增进编解码效率。
背景技术:
1、通用视频编码(vvc)是由itu-t视频编码专家组(vceg)的联合视频专家组(jvet)和iso/iec运动图像专家组(mpeg)共同制定的最新国际视频编解码标准。该标准已作为iso 标准发布:iso/iec 23090-3:2021,信息技术-沉浸式媒体的编码表示 - 第 3 部分:通用视频编码,2021 年 2 月发布。vvc 是在其前身 hevc(high efficiency videocoding)基础上,通过添加更多的编解码工具来提高编解码效率,还可以处理各种类型的视频源,包括 3 维(3d)视频信号。
2、图1a说明了包含循环处理的示例性自适应帧间/帧内视频编码系统。对于帧内预测110,预测数据是根据当前图片中先前编码的视频数据导出的。对于帧间预测112,在编码器侧执行运动估计(me)并且基于me的结果执行运动补偿(mc)以提供从其他画面和运动数据导出的预测数据。开关114选择帧内预测110或帧间预测112并且所选择的预测数据被提供给加法器116以形成预测误差,也称为残差。预测误差然后由变换(t) 118和随后的量化(q) 120处理。变换和量化的残差然后由熵编码器122编码以包括在对应于压缩视频数据的视频比特流中。与变换系数相关联的比特流然后与辅助信息(例如与帧内预测和帧间预测相关联的运动和编码模式)以及其他信息(例如与应用于底层图像区域的环路滤波器相关联的参数)一起打包。与帧内预测110、帧间预测112和环内滤波器130相关联的辅助信息被提供给熵编码器122,如图1a所示。当使用帧间预测模式时,也必须在编码器端重建一个或多个参考图片。因此,经变换和量化的残差由逆量化(iq)124和逆变换(it)126处理以恢复残差。然后在重建(rec)128处将残差加回到预测数据136以重建视频数据。重建的视频数据可以存储在参考图片缓冲器134中并用于预测其他帧。
3、如图1a 所示,输入的视频数据在编码系统中经过一系列处理。 由于一系列处理,来自rec128的重建视频数据可能会受到各种损害。 因此,环路滤波器130经常在重构视频数据被存储在参考图片缓冲器134中之前应用于重构视频数据以提高视频质量。例如,可以使用去块滤波器(df)、样本自适应偏移(sao)和自适应环路滤波器(alf)。 可能需要将环路滤波器信息合并到比特流中,以便解码器可以正确地恢复所需的信息。因此,环路滤波器信息也被提供给熵编码器122以合并到比特流中。在图1a中,环路滤波器130在重构样本被存储在参考图片缓冲器134中之前被应用于重构视频。图1a中的系统旨在说明典型视频编码器的示例性结构。它可能对应于高效视频编码 (hevc) 系统、vp8、vp9、h.264 或 vvc。
4、如图1b所示,解码器可以使用与编码器相似或相同的功能块,除了变换 118 和量化 120 之外,因为解码器只需要逆量化 124 和逆变换 126。代替熵编码器122,解码器使用熵解码器140将视频比特流解码为量化的变换系数和所需的编码信息(例如ilpf信息、帧内预测信息和帧间预测信息)。解码器侧的帧内预测150不需要执行模式搜索。相反,解码器仅需要根据从熵解码器140接收的帧内预测信息生成帧内预测。此外,对于帧间预测,解码器仅需要根据从熵解码器140接收的帧间预测信息执行运动补偿(mc 152)而无需运动估计。
5、根据 vvc,类似于 hevc,输入图片被划分为称为 ctu (编码树单元)的非重迭方形块区域。每个 ctu 都可以划分为一个或多个较小尺寸的编码单元 (cu)。生成的 cu 分区可以是正方形或矩形。 此外,vvc 将 ctu 划分为预测单元 (pu),作为应用预测过程的单元,例如帧间预测、帧内预测等。
6、vvc标准合并了各种新的编码工具以进一步提高超过hevc标准的编码效率。在各种新的编码工具中,与本发明相关的一些编码工具综述如下。
7、帧间预测概述
8、根据 jvet-t2002 第 3.4 节,(jianle chen 等人,“通用视频编码和测试模型11 (vtm 11) 的算法描述”,itu-t sg 16 wp 3 和 iso/iec jtc 1/sc 29 的联合视频专家组 (jvet) , 第20次会议,电话会议,2020年10月7–16日,档案: jvet-t2002), 针对每一帧间预测cu,运动参数包含运动向量、参考图片索引以及参考图片列表使用标识,以及需要的额外信息 vvc 的新编码功能用于帧间预测样本生成。 可以以显式或隐式方式用信号通知运动参数。当 cu 以跳过(skip)模式编码时,cu 与一个 pu相关联并且没有显着的残差系数,没有编码的运动向量增量或参考图片索引。指定合并模式,当前 cu 的运动参数是从相邻 cu 获得的,包括空间和时间候选,以及 vvc 中引入的附加调度。合并模式可以应用于任何帧间预测的 cu,而不仅仅是跳过模式。合并模式的替代方案是运动参数的显式传输,其中运动向量、每个参考图片列表的相应参考图片索引和参考图片列表使用标识以及其他所需信息按每个 cu 显式发送。
9、除了 hevc 中的帧间编码功能外,vvc 还包括许多新的和改进的帧间预测编码工具,如下所列:
10、– 扩展合并预测(extended merge prediction)
11、– 与 mvd (mmvd) 的合并模式(merge mode with mvd (mmvd))
12、– 对称 mvd (smvd) 信令(symmetric mvd (smvd) signalling)
13、– 仿射运动补偿预测(affine motion compensated prediction)
14、– 基于子块的时间运动向量预测 (sbtmvp)(subblock-based temporal motionvector prediction (sbtmvp))
15、– 自适应运动向量分辨率 (amvr)(adaptive motion vector resolution(amvr))
16、– 运动场存储:1/16 亮度样本 mv 存储和 8x8 运动场压缩
17、– cu级权重双向预测(bcw)(bi-prediction with cu-level weight (bcw))
18、– 双向光流 (bdof)(bi-directional optical flow (bdof))
19、– 解码器侧运动向量细化 (dmvr)(decoder side motion vector refinement(dmvr))
20、– 几何分区模式 (gpm) geometric partitioning mode (gpm)
21、– 组合帧间和帧内预测 (ciip)(combined inter and intra prediction(ciip))
22、下面的描述提供了在 vvc 中指定的那些帧间预测方法的细节。
23、扩展合并预测
24、在vvc中,合并候选列表是通过依次包括以下五类候选来构建的:
25、1) 来自空间相邻 cu 的空间 mvp
26、2) 来自并置 cu 的时间 mvp
27、3) 来自 fifo 表的基于历史的 mvp
28、4) 成对平均 mvp
29、5)零mv。
30、合并列表的大小在序列参数集(sps)报头中用信号通知并且合并列表的最大允许大小是6。对于在合并模式中编码的每个cu,使用截断一元二值化对最佳合并候选的索引进行编码 (tu)。 合并索引的第一个二进制字符串(以下简称为bin)使用上下文编码,旁路编码用于其余 bin。
31、本环节提供了每个类别的合并候选的推导过程。 与在 hevc 中所做的一样,vvc还支持为一定大小的区域内的所有 cu 并行推导合并候选列表(或称为合并候选列表)。
32、空间候选推导
33、除了交换前两个合并候选的位置之外,vvc中空间合并候选的导出与hevc中的相同。 在位于图2所示位置的候选中选择当前cu 210的最多四个合并候选(b0、a0、b1和a1)。导出的顺序是b0、a0、b1、a1和b2。位置 b2仅在位置 b0、a0、b1、a1的一个或多个相邻 cu 不可用(例如,属于另一个切片或瓦片)或被帧内编码时才被考虑。添加位置a1的候选后,对剩余候选的添加进行冗余校验,保证具有相同运动信息的候选被排除在列表之外,从而提高编码效率。为了降低计算复杂度,在提到的冗余检查中并未考虑所有可能的候选对。相反,仅考虑图3中用箭头链接的对,并且仅当用于冗余检查的相应候选不具有相同运动信息时才将候选添加到列表中。
34、时间候选推导
35、在该步骤中,仅将一个候选添加到列表中。具体地,在针对当前cu 410的该时间合并候选的推导中,基于属于如图4所示的并置参考图片(collocated reference picture)的并置cu 420推导缩放运动向量(scaled motion vector)。用于推导并置 cu的参考图片列表(reference picture list)和参考图片的索引(reference index)在切片标头中明确以信号发送。如图4中的虚线所示,获得时间合并候选的缩放运动向量 430,其使用 poc(图片顺序计数,picture order count)距离 tb 和 td 从并置 cu 的运动向量 440 缩放 ,其中tb定义为当前图片的参考图片与当前图片的poc差,td定义为并置(co-located)图片的参考图片与并置图片的poc差。时间合并候选的参考图片索引设置为等于零。
36、时间候选的位置在候选 c0 和 c1 之间选择,如图5 所示。如果位置 c0 的 cu不可用、被帧内编码或在当前 ctu 行之外,则使用位置 c1 。否则,位置 c0 用于推导时间合并候选。
37、基于历史的合并候选推导
38、基于历史的mvp(hmvp)合并候选被添加到空间mvp和tmvp之后的合并列表。在该方法中,先前编码块的运动信息存储在表中并用作当前cu的mvp。在编码/解码过程中维护具有多个 hmvp 候选的表。当遇到新的 ctu 行时,该表将被重置(清空)。每当存在非子块帧间编码 cu 时,相关联的运动信息将作为新的 hmvp 候选添加到表的最后一个条目。
39、hmvp表大小s被设置为6,这指示最多5个基于历史的mvp(hmvp)候选可以被添加到表中。当向表中插入新的运动候选时,使用受约束的先进先出(fifo)规则,其中首先应用冗余检查以查找表中是否存在相同的hmvp。如果找到,相同的hmvp被从表中移除并且之后的所有hmvp候选被向前移动,并且相同的hmvp被插入到表的最后条目。
40、hmvp候选可以用于合并候选列表构建过程。依次检查表中最新的几个hmvp候选,并在tmvp候选之后插入到候选列表中。冗余检查应用于 hmvp 候选至空间或时间合并候选。
41、为了减少冗余校验操作的数量,引入以下简化:
42、1. 表中的最后两个条目分别针对 a1 和 b1 空间候选进行冗余检查。
43、2.一旦可用合并候选的总数达到最大允许合并候选的数量-1,hmvp的合并候选列表构造过程终止。
44、成对平均合并候选推导
45、通过使用前两个合并候选对现有合并候选列表中的预定义候选对进行平均来生成成对平均候选。第一个合并候选定义为 p0cand,第二个合并候选可以分别定义为p1cand。 根据p0cand和p1cand的运动向量的可用性分别针对每个参考列表计算平均运动向量。 如果两个运动向量在一个列表中都可用,则即使这两个运动向量指向不同的参考图片,也对其进行平均,并将其参考图片设置为 p0c 和 p0c 之一; 如果只有一个运动向量可用,则直接使用一个; 如果没有可用的运动向量,则保持此列表无效。此外,如果 p0cand和 p1cand 的半像素插值滤波器索引不同,则将其设置为 0。
46、当添加成对平均合并候选后合并列表未满时,将零个mvp插入最后直到遇到最大合并候选数。
47、合并估计区域
48、合并估计区域(mer)允许独立推导同一合并估计区域(mer)中的cu的合并候选列表。 在当前cu的合并候选列表的生成中不包括与当前cu在相同mer内的候选块。 此外,仅当 (xcb + cbwidth)>>log2parmrglevel 大于 xcb>>log2parmrglevel 和 ( ycb +cbheight )>>log2parmrglevel 大于 ( ycb>>log2parmrglevel ),其中 ( xcb, ycb )是图片中当前 cu 的左上角亮度样本位置, ( cbwidth, cbheight ) 是 cu 大小。 mer大小在编码器端选择,并在序列参数集 (sps) 中作为 log2_parallel_merge_level_minus2 发出信号。
49、具有mvd的合并模式(mmvd)
50、除了其中隐式导出的运动信息被直接用于当前cu的预测样本生成的合并模式之外,在vvc中引入了具有运动向量差(mmvd)的合并模式。在发送常规合并标识后立即发出mmvd 标识,以指定 mmvd 模式是否用于 cu。
51、在mmvd中,在选择了合并候选(本发明中被称为基本合并候选)之后,通过用信号发送的mvd信息对其进行进一步细化。进一步的信息包括合并候选标识、用于指定运动幅度的索引和用于指示运动方向的索引。在 mmvd 模式下,合并列表中的前两个候选中的一个被选择用作 mv 基础。 发出 mmvd 候选标识以指定在第一和第二合并候选之间使用哪一个。
52、距离索引指定运动幅度信息并且指示从l0参考块610和l1参考块620的起点(612和622)的预定义偏移。如图6所示,偏移被添加到 起始 mv的水平分量或垂直分量,其中不同样式的小圆圈对应于距中心的不同偏移量。距离索引和预定义偏移量的关系在表 1 中指定。
53、表 1 – 距离索引与预定义偏移量的关系
54、
55、方向指数表示 mvd 相对于起始点的方向。方向索引可以表示如表2所示的四个方向。需要注意的是,mvd符号的含义可以根据起始mv的信息而变化。当起始 mv 是非预测 mv或双预测 mv,两个列表都指向当前图片的同一侧(即两个参考的 poc 均大于当前图片的poc,或均小于当前图片的 poc),表 2 中的符号指定添加到起始 mv 的 mv 偏移量的符号。 当起始 mv 是双向预测 mv,两个 mv 指向当前图片的不同侧(即一个参考的 poc 大于当前图片的 poc,另一个参考的 poc 小于当前图片的 poc),并且列表0(可简称为list0或l0)中poc的差异大于列表1(可简称为list 1或l1)中的poc,表2中的符号指定添加到起始mv的列表0的mv分量的mv偏移量的符号和列表1的mv的符号有相反的值。否则,如果列表1中的poc之差大于列表0,则表2中的符号指定添加到起始mv的列表1 mv分量的mv偏移量的符号与列表0mv的符号具有相反的值。
56、mvd是根据每个方向上的poc的差异来缩放的。 如果两个列表中 poc 的差异相同,则不需要缩放。 否则,如果列表 0 中的 poc 差异大于列表 1 中的差异,则通过将 l0的 poc 差异定义为 td 并将 l1 的 poc 差异定义为 tb 来缩放列表 1 的 mvd,如图5所示。如果 l1 的 poc 差异大于 l0,则列表 0 的 mvd 以相同的方式缩放。如果起始 mv 是单向预测的,则将 mvd 添加到可用 mv。
57、表 2 – 方向索引指定的 mv 偏移符号
58、
59、仿射运动补偿预测
60、在hevc中,仅平移运动模型被应用于运动补偿预测(mcp)。 而在现实世界中,有很多种运动,例如 放大/缩小、旋转、透视运动和其他不规则运动。在 vvc 中,应用基于块的仿射变换运动补偿预测。如图所示。在图7a-b中,块710的仿射运动域由图7a中的两个控制点(4参数)的运动信息或图7b中的三个控制点运动向量(6参数)描述。
61、对于4参数仿射运动模型,块中样本位置(x,y)处的运动向量被导出为:
62、。(1)
63、对于6参数仿射运动模型,块中样本位置(x,y)处的运动向量被导出为:
64、。(2)
65、其中(mv0x,mv0y)为左上角控制点的运动向量,(mv1x,mv1y)为右上角控制点的运动向量,(mv2x,mv2y)为底部-左角控制点的运动向量。
66、为了简化运动补偿预测,应用基于块的仿射变换预测。为了导出每个 4×4 亮度子块的运动向量,每个子块的中心样本的运动向量,如图8所示,根据上述等式计算,并四舍五入到 1/16 分数精度。 然后,应用运动补偿插值滤波器以生成具有导出的运动向量的每个子块的预测。色度分量的子块大小也设置为 4×4。4×4 色度子块的 mv 计算为并置8x8 亮度区域中左上角和右下角亮度子块的 mv 的平均值。
67、对于平移运动帧间预测,也有两种仿射运动帧间预测模式:仿射合并模式和仿射amvp模式。
68、仿射合并预测(af_merge)
69、af_merge模式可以应用于宽度和高度都大于或等于8的cu。在该模式下,基于空间相邻cu的运动信息生成当前cu的cpmv(控制点mv)。最多可以有五个 cpmvp(cpmv 预测)候选,并且用信号发送一个索引以指示要用于当前 cu 的那个。下面三种类型的cpvm候选被用来构成仿射合并候选列表:
70、– 从相邻 cu 的 cpmv 推断出的继承仿射合并候选
71、– 使用相邻 cu 的平移 mv 派生的构造仿射合并候选 cpmvp
72、– 零mv
73、在vvc中,最多有两个继承的仿射候选,它们来自相邻块的仿射运动模型,一个来自左相邻cu,一个来自上方相邻cu。候选块与图2所示相同。对于左预测子,扫描顺序为a0->a1,对于上预测子,扫描顺序为b0->b1->b2。仅选择每一方的第一个继承候选。 在两个继承的候选之间不执行修剪检查(pruning check)。识别相邻的仿射 cu 时,其控制点运动向量用于导出当前 cu 的仿射合并列表中的 cpmvp 候选。如图9所示,如果当前块910的左下相邻块a以仿射模式编码,则获得cu 920的左上角、右上角和包含块 a的左下角的运动向量v2、v3和v4。当块a采用4参数仿射模型编码时,根据v2、v3计算当前cu的两个cpmv(即v0和v1)。在块a采用6参数仿射模型编码的情况下,根据v2、v3、v4计算当前cu的三个cpmv。
74、构造仿射候选是指通过结合每个控制点的相邻平移运动信息来构造候选。如图10所示,控制点的运动信息是从当前块 1010 的指定空间邻居和时间邻居导出的。cpmvk(k=1、2、3、4)表示第 k 个控制点。对于 cpmv1,检查 b2->b3->a2 块并使用第一个可用块的mv。对于 cpmv2,检查 b1->b0 块,对于 cpmv3,检查 a1->a0 块。如果 tmvp 可用,则将其用作 cpmv4。
75、在获得四个控制点的 mv 后,基于运动信息构建仿射合并候选。 以下控制点mv的组合用于按顺序构建:
76、{cpmv1, cpmv2, cpmv3}, {cpmv1, cpmv2, cpmv4}, {cpmv1, cpmv3, cpmv4},
77、{cpmv2, cpmv3, cpmv4}, { cpmv1, cpmv2}, { cpmv1, cpmv3}
78、3个cpmv的组合构造了6参数仿射合并候选并且2个cpmv的组合构造了4参数仿射合并候选。为了避免运动缩放过程,如果控制点的参考索引不同,则丢弃控制点mv的相关组合。
79、检查继承的仿射合并候选和构造的仿射合并候选后,如果列表仍未满,则将零个mv插入到列表的末尾。
80、仿射amvp预测
81、仿射 amvp 模式可以应用于宽度和高度都大于或等于 16 的 cu。cu 级的仿射标识在比特流中用信号发送以指示是否使用仿射 amvp 模式,然后另一个标识用信号发送以指示是使用 4 参数仿射还是 6 参数仿射。在这种模式下,当前 cu 的 cpmv 与其预测变量 cpmvp 的差异在比特流中用信号表示。 仿射avmp候选列表大小为2,由以下四种cpvm候选依次生成:
82、– 从相邻 cu 的 cpmv 推断出的继承仿射 amvp 候选
83、– 构建的仿射 amvp 候选 cpmvp 使用相邻 cu 的平移 mv 导出
84、– 来自相邻 cu 的平移 mv
85、– 零mv
86、继承仿射amvp候选的检查顺序与继承仿射合并候选的检查顺序相同。唯一的区别是,对于 avmp 候选,仅考虑与当前块具有相同参考图片的仿射 cu。 将继承的仿射运动预测插入候选列表时,不应用裁剪过程。
87、构造的 amvp 候选是从图10中所示的指定空间邻居导出的。使用与仿射合并候选构造中相同的检查顺序 此外,还检查相邻块的参考图片索引。在检查顺序中,使用帧间编码并具有与当前 cu 中相同的参考图片的第一个块。当当前cu使用4参数仿射模式编码,并且和都可用时,将它们作为一个候选添加到仿射amvp列表中。当当前 cu 使用 6参数仿射模式编码,并且所有三个 cpmv 都可用时,它们将作为一个候选添加到仿射 amvp列表中。否则,将构建的 amvp 候选设置为不可用。
88、如果插入有效继承的仿射amvp候选和构造的amvp候选后,仿射amvp候选列表的数量仍然小于2,则会添加,与作为平移mv以便在可用时预测当前 cu 的所有控制点 mv。最后,如果仿射 amvp 列表仍未满,则使用零 mv 来填充它。
89、仿射运动信息存储
90、在 vvc 中,仿射 cu 的 cpmv 存储在单独的缓冲区中。存储的 cpmv 仅用于在仿射合并模式和仿射 amvp 模式下为最近编码的 cu 生成继承的 cpmvp。 从 cpmv 导出的子块 mv 用于运动补偿、平移 mv 的合并/ amvp 列表的 mv 导出和去块。
91、为了避免额外的 cpmv 的图片行缓冲区,从上述 ctu 的 cu 继承的仿射运动数据被区别对待,以从正常的相邻 cu 继承。如果用于仿射运动数据继承的候选 cu 在上述ctu 行中,则行缓冲区中的左下和右下子块 mv 而不是 cpmv 用于仿射 mvp 推导。这样,cpmv 仅存储在本地缓冲区中。 如果候选 cu 是 6 参数仿射编码,则仿射模型退化为 4参数模型。如图11所示,沿着顶部 ctu 边界,cu 的左下和右下子块运动向量用于底部 ctu中 cu 的仿射继承。 在图11中,第1110行和第1112行表示原点(0,0)在左上角的图片的x和y坐标。图例1120显示了各种运动向量的含义,其中箭头1122表示局部缓冲区中用于仿射继承的cpmv,箭头1124表示用于局部缓冲区中的mc/合并/跳过mvp/去块/tmvp和仿射的子块向量行缓冲器中的继承,箭头1126代表mc/合并/跳过mvp/去块/tmvp的子块向量。
92、自适应运动向量分辨率 (amvr)
93、在 hevc 中,当切片标头中的 use_integer_mv_flag 等于 0 时,(cu 的运动向量和预测运动向量之间的)运动向量差(mvd)以四分之一亮度样本为单位用信号发送。在vvc中,引入了cu级自适应运动向量分辨率(amvr)方案。amvr 允许 cu 的 mvd 以不同的精度进行编码。根据当前 cu 的模式(普通 amvp 模式或仿射 avmp 模式),当前 cu 的 mvd可以自适应地选择如下:
94、– 正常 amvp 模式:四分之一亮度样本、半亮度样本、整数亮度样本或四亮度样本。
95、– 仿射 amvp 模式:四分之一亮度样本、整数亮度样本或 1/16 亮度样本。
96、如果当前cu具有至少一个非零mvd分量,则有条件地用信号通知cu级mvd分辨率指示。如果所有 mvd 分量(即,参考列表 l0 和参考列表 l1 的水平和垂直 mvd)均为零,则推断出四分之一亮度样本 mvd 分辨率。
97、对于具有至少一个非零mvd分量的cu,用信号发送第一标识以指示四分之一亮度样本mvd精度是否用于cu。如果第一个标识为 0,则不需要进一步的信号传输,并且四分之一亮度样本 mvd 精度用于当前 cu。 否则,发出第二个标识以指示将半亮度样本或其他mvd 精度(整数或四亮度样本)用于正常的 amvp cu。 在半亮度样本的情况下,半亮度样本位置使用 6 抽头插值滤波器而不是默认的 8 抽头插值滤波器。否则,用信号发送第三个标识以指示是将整数亮度样本还是四亮度样本 mvd 精度用于正常 amvp cu。在仿射 amvpcu 的情况下,第二个标识用于指示是否使用整数亮度样本或 1/16 亮度样本 mvd 精度。为了确保重建的 mv 具有预期的精度(四分之一亮度样本、半亮度样本、整数亮度样本或四亮度样本),cu 的运动向量预测因子将四舍五入为相同的、与 mvd 相加之前的 mvd 精度。运动向量预测值向零舍入(即,负运动向量预测值向正无穷大舍入,正运动向量预测值向负无穷大舍入)。
98、编码器使用rd检查确定当前cu的运动向量分辨率。为了避免总是对每个 mvd 分辨率执行四次 cu 级 rd 检查,除四分之一亮度样本之外的 mvd 精度的 rd 检查仅在vtm11 中有条件地调用。 对于正常的 avmp 模式,首先计算四分之一亮度样本 mvd 精度和整数亮度样本 mv 精度的 rd 成本。然后,将整数亮度样本mvd精度的rd成本与四分之一亮度样本mvd精度的rd成本进行比较,以决定是否有必要进一步检查四亮度样本mvd精度的rd成本。 当四分之一亮度样本 mvd 精度的 rd 成本远小于整数亮度样本 mvd 精度的 rd成本时,将跳过四亮度样本 mvd 精度的 rd 检查。然后,如果整数亮度样本 mvd 精度的rd 成本明显大于先前测试的 mvd 精度的最佳 rd 成本,则跳过半亮度样本 mvd 精度的检查。对于仿射amvp模式,如果在检查仿射合并/跳过模式、合并/跳过模式、四分之一亮度样本mvd精度正常的amvp模式和四分之一亮度样本mvd精度的率失真成本后未选择仿射帧间模式、仿射 amvp 模式,则不检查 1/16 亮度样本 mv 精度和 1 像素 mv 精度仿射帧间模式。此外,在四分之一亮度样本mv精度仿射帧间模式中获得的仿射参数被用作1/16亮度样本和四分之一亮度样本mv精度仿射帧间模式的起始搜索点。
99、具有 cu 级权重的双向预测 (bcw)
100、在hevc中,双预测信号是通过对从两个不同参考图片和/或使用两个不同运动向量获得的两个预测信号与进行平均而生成的。在 vvc 中,双预测模式被扩展到简单的平均之外,以允许对两个预测信号进行加权平均。
101、
102、加权平均双向预测允许五个权重,w∈{-2,3,4,5,10}。对于每个双向预测的 cu,权重 w 由以下两种方式之一确定:1)对于非合并 cu,权重索引在运动向量差异之后发出信号; 2)对于合并cu,权重索引是根据合并候选索引从相邻块中推断出来的。 bcw 仅适用于具有 256 个或更多亮度样本的 cu(即,cu 宽度乘以 cu 高度大于或等于 256)。对于低延迟图片,使用所有 5 个权重。对于非低延迟图片,仅使用 3 个权重 (w ∈{3,4,5})。在编码器处,应用快速搜索算法来查找权重索引,而不会显着增加编码器的复杂性。 这些算法总结如下。详细信息在 vtm软体和文件 jvet-l0646 中公开(yu-chi su 等人,“ce4 相关:广义双向预测改进结合了 jvet-l0197 和 jvet-l0296”,联合视频专家组( jvet) ofitu-t sg 16 wp 3 与 iso/iec jtc 1/sc 29, 第十二次会议:中国澳门,2018年10月3-12,档案: jvet-l0646)。
103、当与 amvr 结合时,如果当前图片是低延迟图片,则仅针对 1 像素和 4 像素运动向量精度有条件地检查不等权重。
104、当与仿射相结合时,当且仅当选择仿射模式作为当前最佳模式时,才会对不等权重执行仿射 me。
105、当双向预测中的两个参考图片相同时,仅有条件地检查不相等的权重。
106、当满足某些条件时不搜索不等权重,这取决于当前图片与其参考图片之间的 poc距离、编码 qp 和时间级别。
107、bcw 权重索引使用一个上下文编码的bin和旁路编码的bin进行编码。第一个上下文编码的bin指示是否使用相等的权重; 如果使用了不等权重,则使用旁路编码向附加箱(box)信号,以指示使用了哪个不等权重。
108、权重预测 (wp) 是一种受 h.264/avc 和 hevc 标准支持的编码工具,可有效地对具有衰落的视频内容进行编码。 对 wp 的支持也被添加到 vvc 标准中。wp允许为每个参考图片列表 l0 和 l1 中的每个参考图片发送权重参数(权重和偏移)。然后,在运动补偿期间,应用相应参考图片的权重和偏移。 wp 和 bcw 专为不同类型的视频内容而设计。为了避免 wp 和 bcw 之间的交互,这会使 vvc 解码器设计复杂化,如果 cu 使用 wp,则不通知 bcw 权重索引,并且权重 w 被推断为 4(即应用相等的权重)。对于合并 cu,权重索引是根据合并候选索引从相邻块中推断出来的。这可以应用于普通合并模式和继承仿射合并模式。对于构造的仿射合并模式,仿射运动信息是基于最多3个块的运动信息构造的。使用构造的仿射合并模式的 cu 的 bcw 索引被简单地设置为等于第一个控制点 mv 的bcw 索引。
109、在 vvc 中,ciip 和 bcw 不能联合申请一个 cu。当一个cu使用ciip模式编码时,当前cu的bcw索引设置为2,即对于相等权重w=4。相等权重暗示 bcw 指数的默认值。
110、组合帧间和帧内预测 (ciip)
111、在vvc中,当cu以合并模式编码时,如果cu包含至少64个亮度(luma)样本(即cu宽度乘以cu高度等于或大于64),并且如果cu宽度和cu高度都小于 128 个亮度样本,一个额外的标识被发送以指示组合帧间/帧内预测 (ciip) 模式是否应用于当前 cu。 正如其名称所示,ciip 预测将帧间预测信号与帧内预测信号组合在一起。 ciip 模式中的帧间预测信号是使用应用于常规合并模式的相同帧间预测过程导出的;并且帧内预测信号是在具有平面模式的常规帧内预测过程之后导出的。然后,使用权重平均组合帧内和帧间预测信号,其中权重值wt根据当前cu 1210的顶部和左侧相邻块(如图12所示)的编码模式计算如下:
112、如果顶部邻居可用且帧内编码,则将 isintratop 设置为 1,否则将 isintratop设置为 0;
113、如果左邻居可用且帧内编码,则将isintraleft设置为1,否则将isintraleft设置为0;
114、如果(isintraleft + isintratop)等于2,则wt设置为3;
115、否则,如果 (isintraleft + isintratop) 等于 1,则 wt设置为 2;
116、否则,将 wt设置为 1。
117、ciip预测形成如下:
118、。(4)
119、cclm(跨组件线性模型)
120、cclm 模式(有时缩写为 lm 模式)背后的主要思想是彩色图片的颜色分量(例如y/cb/cr、yuv 和 rgb)之间通常存在某种相关性。这些颜色在本公开中可以称为第一颜色、第二颜色和第三颜色。 cclm 技术通过线性模型从并置的重建亮度样本预测块的色度分量来利用相关性,线性模型的参数源自与块相邻的已重建亮度和色度样本。
121、在 vvc 中,cclm 模式通过从重建的亮度样本中预测色度样本来利用通道间依赖性。 该预测是使用以下形式的线性模型进行的
122、。(5)
123、这里,表示 cu 中的预测色度样本,而表示同一 cu 的重建亮度样本,这些样本针对非 4:4:4 彩色格式 的情况进行了下采样。 模型参数 a 和 b 是基于编码器和解码器端重建的相邻亮度和色度样本导出的,没有显式信令。
124、vvc 中指定了三种 cclm 模式,即 cclm_lt、cclm_l 和 cclm_t。 这三种模式在用于模型参数推导的参考样本的位置方面有所不同。仅来自顶部边界的样本涉及 cclm_t模式,仅来自左边界的样本涉及 cclm_l 模式。在 cclm_lt 模式下,使用来自顶部边界和左侧边界的样本。
125、总体而言,cclm模式的预测过程包括三个步骤:
126、1) 亮度块及其相邻重建样本的下采样以匹配相应色度块的大小,
127、2)基于重建的相邻样本的模型参数推导,以及
128、3)应用模型方程(1)生成色度帧内预测样本。
129、亮度分量的下采样:为了匹配 4:2:0 或 4:2:2 彩色格式视频序列的色度样本位置,可以对亮度样本应用两种类型的下采样滤波器,它们都具有水平和垂直方向上的 2 比1 下采样率。这两个滤波器分别对应于“类型-0(type-0)”和“类型-2(type-2)”4:2:0 色度格式内容,分别由
130、。(6)
131、基于 sps 级标识信息,二维 6 阶(即 f2)或 5 阶(即 f1)滤波器应用于当前块内的亮度样本及其相邻亮度样本。sps-级指的是序列参数集级别(sequence parameterset level)。如果当前块的上方行是 ctu 边界,则会发生异常。在这种情况下,一维滤波器应用于上述相邻亮度样本,以避免在 ctu 边界上方使用多个亮度队列。
132、
模型参数推导过程:来自等式 (5) 的模型参数a和b 基于编码器和解码器端重建的相邻亮度和色度样本导出,以避免需要任何信令开销。在最初采用的 cclm 模式版本中,线性最小均方误差 (lmmse) 估计器用于参数的推导。然而,在最终设计中,只涉及四个样本以降低计算复杂度。图13显示了 m×n 色度块 1310、相应的 2m×2n 亮度块 1320 及其“类型 0”内容的相邻样本(显示为实心圆和三角形)的相对样本位置。
133、在图13的示例中,显示了在 cclm_lt 模式中使用的四个样本,它们用三角形标记。它们位于上边界m/4和m3/4的位置,以及左边界n/4和n3/4的位置。在cclm_t和cclm_l模式下,上边界和左边界被扩展到(m+n)个样本的大小,用于模型参数推导的四个样本位于(m+n)/8、(m+ n)3/8、(m+n)5/8 和 (m + n)7/8。
134、一旦选择了四个样本,就使用四个比较操作来确定其中两个最小和两个最大的亮度样本值。 令表示两个最大亮度样本值的平均值,令表示两个最小亮度样本值的平均值。类似地,让和表示相应色度样本值的平均值。然后,根据以下等式获得线性模型参数:
135、;
136、。(7)
137、在这个等式中,计算参数 a 的除法运算是通过查找表实现的。 为了减少存储该表所需的内存,diff值,即最大值和最小值之间的差值,以及参数a用指数表示法表示。这里,diff的值用 4 位有效部分和指数近似。因此,diff 的表仅包含 16 个元素。这样做的好处是既降低了计算的复杂性,又减少了存储表所需的内存大小。
138、mmlm概览
139、顾名思义,原始的 cclm 模式采用一个线性模型来预测整个 cu 的亮度样本的色度样本,而在 mmlm(多模型 cclm)中,可以有两个模型。在mmlm中,将当前块的相邻亮度样本和相邻色度样本分为两组,每组作为训练集推导线性模型(即针对特定组推导特定的α和β)。此外,当前亮度块的样本也基于与相邻亮度样本的分类相同的规则进行分类。
140、阈值(threshold)为相邻重建亮度样本的平均值。 rec′l[x,y]<= threshold 的相邻样本被分类为第 1 组;而rec′l[x,y]>threshold的相邻样本被分类为第 2 组。
141、相应地,色度的预测是使用线性模型获得的:
142、。
143、色度帧内模式编码
144、对于色度帧内模式编码,总共允许8种帧内模式用于色度帧内模式编码。这些模式包括五种传统帧内模式和三种跨组件线性模型模式(cclm、lm_a 和 lm_l)。色度模式信令和推导过程如表 3 所示。色度模式编码直接取决于相应亮度块的帧内预测模式。由于在i切片中启用了用于亮度和色度分量的单独块划分结构,所以一个色度块可以对应于多个亮度块。因此,对于色度(chroma)导出 (dm,derived mode)模式,直接继承覆盖当前色度块中心位置的对应亮度块的帧内预测模式。
145、表 3. 启用 cclm 时从亮度模式推导色度预测模式
146、
147、如表4所示,无论sps_cclm_enabled_flag的值如何,都使用单个二值化表。
148、表 4. 色度预测模式统一二值化表
149、
150、第一个 bin 表示它是常规模式(即 0)还是 lm 模式(即 1)。 如果它是 lm 模式,则下一个 bin 指示它是 lm_chroma(即 0)还是不是(即 1)。如果不是 lm_chroma,则下一个 bin 指示它是 lm_l(即 0)还是 lm_a(即 1)。对于这种情况,当 sps_cclm_enabled_flag 为 0 时,可以在熵编码之前忽略对应 intra_chroma_pred_mode 的二值化表的第一个 bin。 或者,换句话说,第一个 bin 被推断为 0,因此未被编码。此单个二值化表用于 sps_cclm_enabled_flag 等于 0 和 1 的情况。前两个 bin 使用其自己的上下文模型进行上下文编码,其余 bin 进行旁路编码。
151、多假设预测 (mhp)
152、在多假设帧间预测模式 (jvet-m0425) 中,除了传统的双预测信号之外,还发出一个或多个附加运动补偿预测信号。最终的整体预测信号是通过样本权重迭加获得的。利用双预测信号和第一附加帧间预测信号/假设,得到的结果预测信号如下:
153、。(8)
154、根据以下映射(表 5),权重因子 α 由新语法元素 add_hyp_weight_idx 指定:
155、表 5. 将 α 映射到 add_hyp_weight_idx
156、
157、与上文类似,可以使用一个以上的附加预测信号。得到的整体预测信号与每个附加预测信号一起迭代累积。
158、。(9)
159、作为最后的(即,具有最大索引n的)获得所得的整体预测信号。 例如,最多可以使用两个额外的预测信号(即,n 限制为 2)。
160、每个附加预测假设的运动参数可以通过指定参考索引、运动向量预测值索引和运动向量差来显式地用信号发送,或者通过指定合并索引来隐式地用信号发送。一个单独的多假设合并标识区分这两种信号模式。
161、对于帧间 amvp 模式,只有在双向预测模式下选择 bcw 中的非等权重时才应用mhp。vvc 的 mhp 的详细信息可以在 jvet-w2025 中找到(muhammed coban 等人,“增强压缩模型 2(ecm 2)的算法描述”,itu-t sg 16 wp 3 的联合视频专家组(jvet) 和 iso/iecjtc 1/sc 29,第 23 次会议,电话会议,2021 年 7 月 7-16 日,文件:jvet-w2025)。
162、mhp 和 bdof 的组合是可能的,但是 bdof 仅应用于预测信号的双预测信号部分(即,普通的前两个假设)。
技术实现思路
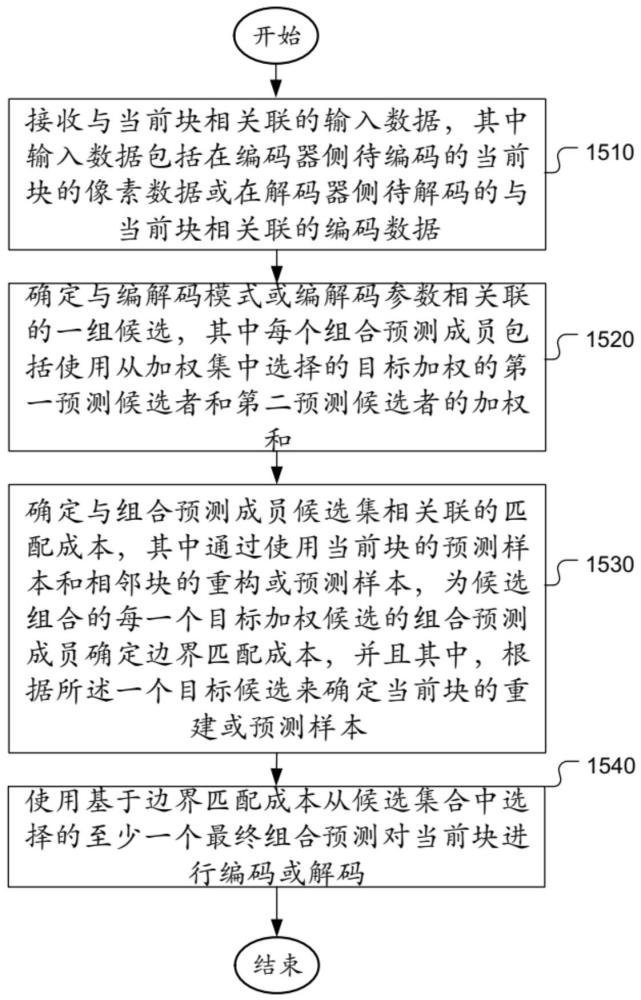
1、公开了一种用于视频编解码的方法和设备。根据该方法,接收与当前块相关联的输入数据,其中,输入数据包括编码器侧待编码的当前块的像素数据或解码器侧与当前待解码块相关联的编码数据;确定与编解码模式或编解码参数相关联的候选集合;确定与候选集合相关联的边界匹配成本,其中通过使用该当前块的重建或预测样本和该当前块的相邻重建或预测样本,为该候选集合的每一个目标候选确定边界匹配成本,其中,该当前块的重建或预测样本是根据所述一个目标候选确定的,并且其中该边界匹配成本包含上边界匹配成本与左边界匹配成本中的至少一个,该上边界匹配成本是在该当前块的上边界执行边界匹配而计算的,该左边界匹配成本是在该当前块的左边界执行边界匹配而计算的;以及基于该边界匹配成本,从候选集合中选择对应的最终候选,使用该最终候选对该当前块进行编码或解码。
2、在一个实施例中,该当前块的上边界的第一数量的行与该左边界的第二数量的列用于计算边界匹配成本。在一个实施例中,该第一数量与该第二数量是预定的。该第一数量与该第二数量取决于来自cu/cb、pu/pb、tu/tb、ctu/ctb、切片级别、图片级别、序列参数集(sps)级别和/或图片参数集(pps)级别的语法的信令/解析。在一个实施例中,当该当前块位于ctu行的顶部边界,不执行该上边界匹配并且仅执行该左边界匹配。当该当前块位于ctu行的左边界,不执行该左边界匹配并且仅执行该上边界匹配。在一个实施例中,当该当前块的高度大于该当前块的宽度时,仅执行左边界匹配。当该当前块的宽度大于该当前块的高度时,仅执行上边界匹配。
3、在一个实施例中,候选集合对应于与不同颜色分量之间的lm预测相关联的一组lm(线性模型)候选。在一个实施例中,lm候选集包括来自包括左上lm、仅上lm、仅左lm和mm(多模型)lm的组的至少两个lm候选。在一个实施例中,lm 索引被分配给 lm 候选集,并且目标lm 索引被分配给目标 lm 候选的最小索引值,从而导致最小的边界匹配成本。在另一个实施例中,导致最小边界匹配成本的目标 lm 候选被隐式地选择为最终候选。
4、在一个实施例中,该组候选对应于一组mmvd(merge mode with mvd)候选,其中每个mmvd候选包括距基础合并候选的偏移方向和偏移距离的组合。在一个实施例中,mmvd索引被分配给mmvd候选集合,并且目标mmvd索引被分配用于目标mmvd候选的最小索引值,导致最小边界匹配成本。在另一个实施例中,导致最小边界匹配成本的目标mmvd候选被隐含地选择为最终候选。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com