
视频编解码中用于合并模式下运动向量细化和候选列表重新排序的自适应成本函数选择方法和装置与流程
本发明涉及使用合并候选的视频编解码系统。具体而言,本发明涉及用于运动向量细化或合并候选重新排序的成本函数选择。
背景技术:
1、多功能视频编解码(versatile video coding,简称 vvc)是由国际电讯联盟-电信标准化部门(international telecommunication union telecommunicationstandardization sector,简称itu-t)视频编解码专家组(video coding experts group,简称 vceg)和国际标准化组织/国际电工委员会(international organization forstandardization/international electrotechnical commission,简称iso/iec)动态图片专家组(moving picture experts group,简称 mpeg)的联合视频专家组(joint videoexperts team,简称 jvet)开发的最新国际视频编解码标准。该标准已作为 iso 标准于2021 年 2 月发布:iso/iec 23090-3:2021,信息技术 - 沉浸式媒体的编解码表示 - 第3部分:多功能视频编解码。vvc 是在其前身高效率视频编解码(high efficiency videocoding,简称hevc)的基础上开发的,通过添加更多的编解码工具来提高编解码效率,以及处理包含三维(three dimensional,简称3d)视频信号在内的各种类型的视频源。
2、图1a示出包含环路处理的示例性适应性帧间/帧内视频编码系统。对于帧内预测,预测数据基于当前图片中先前编解码的图片视频数据导出。对于帧间预测112,运动估计(motion estimation,me)在编码器端进行,以及基于me的结果进行运动补偿(motioncompensation,mc),以提供从其他图片和运动数据导出的预测数据。开关114选择帧内预测110或帧间预测112,并将选择的预测数据提供给加法器116以形成预测误差,也称为残差。然后对预测误差进行变换(transform,简称t)118处理,随后是量化(quantization,简称q)120。变换和量化的残差随后由熵编码器122编码,以包含在对应于压缩视频数据的视频比特流中。与变换系数相关的比特流随后与次要信息(与帧内预测和帧间预测相关的运动和编解码模式等)以及与应用于底层影像区域的环路滤波器相关的参数等其他信息一起打包。如图1a所示,与帧内预测110、帧间预测112和环路滤波器130相关的次要信息,被提供给熵编码器122。当帧间预测模式被使用时,一个或多个参考图片也必须在编码器端重构。因此,变换和量化的残差由逆量化(inverse quantization,简称iq)124和逆变换(inversetransformation,简称it)126处理以恢复残差。然后残差被添加回预测数据136,在重构(reconstruction,简称rec)128处重构视频数据。重构的视频数据可以存储在参考图片缓冲器134中,并用于其他帧的预测。
3、如图1a所示,传入的视频数据在编码系统中经历一系列处理。来自 rec 128 的重构视频数据可能会因一系列处理而受到各种损害。因此,在将重构的视频数据存储在参考图片缓冲器134中之前,通常会对重构的视频数据应用环路滤波器130,以提高视频质量。例如,可以使用去块效应滤波器(deblocking filter,df)、样本适应性偏移(sampleadaptive offset,sao)和适应性环路滤波器(adaptive loop filter,alf)。可能需要将环路滤波器信息纳入比特流,以便解码器能够正确恢复所需信息。因此,环路滤波器信息也提供给熵编码器122,以纳入比特流。在图1a中,环路滤波器130应用于重构的视频,然后将重构的样本存储在参考图片缓冲器134中。图1a中的系统旨在示出典型视频编码器的示例性结构。它可以对应于高效率视频编解码(high efficiency video coding,简称hevc)系统、vp8、vp9、h.264或vvc。
4、如图1b所示,除了变换118和量化120之外,解码器可以使用与编码器相同或部分相同的功能块,因为解码器只需要逆量化124和逆变换126。解码器使用熵解码器140代替熵编码器122,将视频比特流解码为量化变换系数和所需的编解码信息(例如 ilpf 信息、帧内预测信息和帧间预测信息)。解码器端的帧内预测150不需要进行模式搜索。相反,解码器只需要根据从熵解码器140接收的帧内预测信息生成帧内预测。此外,对于帧间预测,解码器只需要根据从熵解码器140接收的帧间预测信息进行运动补偿(mc 152),而不需要运动估计。
5、根据vvc,输入图片被划分为非重迭的方块区域,称为ctu(编解码树单元),类似于hevc。每个ctu可以划分为一个或多个较小尺寸的编解码单元(coding unit,简称cu)。得到的cu分区可以是正方形或矩形。此外,vvc将ctu划分为预测单元(prediction unit,简称pu),作为一个单元来应用预测过程,例如帧间预测、帧内预测等。
6、vvc标准引入了各种新的编解码工具,以进一步提高hevc标准的编解码效率。在各种新的编解码工具中,下面回顾一些与本发明相关的编解码工具。
7、1.多遍次解码器侧运动向量细化(multi-pass decoder-side motion vectorrefinement,简称mp-dmvr)
8、应用多遍次解码器侧运动向量细化。在第一遍次中,双边匹配 (bilateralmatching,简称bm)应用于编解码块。在第二遍次中,bm应用于编解码块内的每个16x16子块。在第三遍次中,每个8x8子块中的mv通过应用双向光流(bi-directional opticalflow,简称bdof)细化。细化的mv被存储以用于空间和时间运动向量预测。
9、第一遍次-基于块的双边匹配mv细化
10、在第一遍次中,细化的mv通过将bm应用于编解码块来导出。与解码器侧运动向量细化(decoder-side motion vector refinement,简称dmvr)类似,在双向预测操作中,在参考图片列表l0和l1中的两个初始mv(即mv0和mv1)周围搜索细化的mv。基于l0和l1中两个参考块之间的最小双边匹配成本,在初始mv周围导出细化的mv(即mv0_pass1和mv1_pass1)。
11、bm进行局部搜索,得到整数样本精度intdeltamv。局部搜索采用3×3的方形搜索模式,在水平方向上循环搜索范围[-shor,shor],在垂直方向上循环搜索范围[-sver,sver],其中shor和sver的值由块维度决定,shor和sver的最大值均为8。
12、双边匹配成本计算公式为:bilcost=mvdistancecost+sadcost。当块大小cbw*cbh大于64时,mrsad成本函数被应用以消除参考块间失真的dc效应。当3×3搜索模式中心点的bilcost具有最小成本时,intdeltamv局部搜索被终止。否则,当前最小成本搜索点成为3×3搜索模式的新中心点,继续搜索最小成本,直至到达搜索范围的末端。
13、进一步应用现有的分数样本细化来导出最终的deltamv。然后第一遍次之后的细化mv被导出如下:
14、mv0_pass1 = mv0 + deltamv
15、mv1_pass1 = mv1 – deltamv
16、第二遍次-基于子块的双边匹配mv细化
17、在第二遍次中,细化的mv通过将bm应用于16×16网格子块来导出。对于每个子块,在参考图片列表l0和l1中围绕第一遍次期间获得的两个mv(例如mv0_pass1和mv1_pass1)搜索细化的mv。细化的mv(即 mv0_pass2(sbidx2) 和 mv1_pass2(sbidx2))基于l0和l1中两个参考子块之间的最小双边匹配成本导出。
18、对于每个子块,bm进行全搜索,得到整数样本精度intdeltamv。全搜索在水平方向上的搜索范围为[-shor,shor],在垂直方向上的搜索范围为[-sver,sver],其中shor和sver的取值由块维度决定,shor和sver的最大值均为8。
19、双边匹配成本通过将成本因子应用于两个参考子块之间的 satd 成本来计算,如下所示:bilcost = satdcost * costfactor。搜索区域(2*shor + 1) *(2*sver + 1) 被划分为最多5个菱形搜索区域,如图2所示,其中5个搜索区域以5种不同的色调显示。每个搜索区域分配一个costfactor,该costfactor由每个搜索点与起始mv之间的距离(intdeltamv)决定,以及每个菱形区域按从搜索区域中心开始的顺序进行处理。在每个区域中,搜索点按光栅扫描顺序进行处理,从左上角开始到区域的右下角。当当前搜索区域内的最小bilcost小于等于sbw*sbh的阈值时,像素全搜索被终止;否则,像素全搜索继续到下一个搜索区域,直到检查完所有搜索点。此外,如果迭代中先前的最小成本和当前最小成本之间的差值小于等于块面积的阈值,则搜索过程被终止。
20、现有的vvc dmvr分数样本细化被进一步应用以导出最终的 deltamv(sbidx2)。然后第二遍次的细化mv导出如下:
21、mv0_pass2(sbidx2) = mv0_pass1 + deltamv(sbidx2)
22、mv1_pass2(sbidx2) = mv1_pass1 – deltamv(sbidx2)
23、第三遍次-基于子块的双向光流mv细化
24、在第三遍次中,细化的mv通过将bdof应用于8×8网格子块来导出。对于每个8×8子块,bdof细化被应用以从第二遍次的父子块的细化的mv开始导出缩放的vx和vy,而无需进行裁剪。导出的biomv(vx, vy)被四舍五入为1/16样本精度,以及裁剪在-32和32之间。
25、第三遍次的细化mv(例如mv0_pass3(sbidx3)和mv1_pass3(sbidx3))推导如下:
26、mv0_pass3(sbidx3) = mv0_pass2(sbidx2) + biomv
27、mv1_pass3(sbidx3) = mv0_pass2(sbidx2) – biomv
28、第四遍次-基于适应性子块的双向光流mv细化
29、在第四遍次中,细化的mv通过将bdof应用于4x4或8x8或16x16网格子块来导出。当块小于1024像素时,4x4网格子块被使用。否则,8x8网格子块被使用。每个子块的mv以与第三遍次中相同的方式进行细化。
30、在所有上述子条款中,当环绕运动补偿被启用时,应在考虑环绕偏移的情况下对运动向量进行修剪。需要注意的是,在ecm中,dmvr扩展到不相等poc距离的情况,以及均值去除方程被用来推导bdof mv细化参数,如下所示:
31、(σgx·gx+r1) * vx + σgx·gy * vy = σdi · gx
32、(σgx·gx+r1) * vx + σgx·gy * vy = σdi · gx - dm · σgx
33、σgx·gy * vx + (σgy·gy+r1) * vy= σdi · gy
34、σgx·gy * vx + (σgy·gy+r1) * vy = σdi · gy - dm · σgy
35、2.适应性解码器侧运动向量细化
36、适应性解码器侧运动向量细化方法是多遍次dmvr的扩展,其由两种新的合并模式组成,用于仅在满足dmvr条件的合并候选的双向预测的一个方向(l0或l1)上细化mv。多遍次dmvr处理应用于选定的合并候选以细化运动向量,然而在第一遍次(即pu级别)dmvr中,mvd0或mvd1被设置为零。
37、新合并模式的合并候选源自空间相邻编解码块、tmvp、非相邻块、hmvp、成对候选,与常规合并模式类似。不同之处在于,只有满足dmvr条件的候选才会添加到候选列表中。两种新合并模式使用相同的合并候选列表。如果bm候选列表包含继承的bcw权重,则dmvr处理保持不变,除非使用mrsad或mrsatd计算失真(如果权重不相等以及双向预测使用bcw权重加权)。合并索引的编解码方式与常规合并模式相同。
38、3.基于样本的bdof
39、在基于样本的bdof中,不是基于块来导出运动细化(vx,vy),而是对每个样本导出运动细化(vx,vy)。
40、编解码块被划分为8×8子块。对于每个子块,是否应用bdof通过检查两个参考子块之间的sad是否与阈值相符来决定。如果决定将bdof应用于子块,则对于子块中的每个样本,使用滑动5×5窗口,以及对每个滑动窗口应用现有的bdof处理以导出vx和vy。导出的运动细化(vx,vy)被用来调整窗口中心样本的双向预测样本值。
41、4. 带有模板匹配的合并候选的适应性重新排序(adaptive reordering ofmerge candidates with template matching,简称armc-tm)
42、合并候选根据使用模板匹配(teamplate matching,简称tm)评估的成本适应性地重新排序。重新排序方法可应用于常规合并模式、模板匹配(tm)合并模式和仿射合并模式(不包括sbtmvp候选)。对于tm合并模式,在细化处理之前重新排序合并候选。
43、首先根据给定的检查顺序构建初始合并候选列表,例如空间、tmvp、非相邻、hmvp、成对和虚拟合并候选。然后,将初始列表中的候选划分为多个子组。对于模板匹配(tm)合并模式、适应性dmvr模式,首先使用tm/多遍次dmvr细化初始列表中的每个合并候选。对每个子组中的合并候选进行重新排序以生成重新排序的合并候选列表,以及重新排序根据基于模板匹配的成本值进行。重新排序的合并候选列表中的选定合并候选的索引被发送给解码器。为简化起见,最后一个子组中的合并候选(但不是第一个子组中的合并候选)未重新排序。在构建合并运动向量候选列表期间,排除来自armc重新排序处理的所有零候选。对于常规合并模式和tm合并模式,子组大小设置为5。对于仿射合并模式,子组大小设置为3。
44、成本计算
45、合并候选在重新排序处理中的模板匹配成本根据当前块的模板那样本与其对应的参考样本之间的sad来衡量。模板包括与当前块相邻的一组重构样本。模板的参考样本通过合并候选的运动信息来定位。当合并候选使用双向预测时,合并候选的模板的参考样本也通过双向预测生成,如图3所示。在图3中,块312对应于当前图片310中的当前块,块322和332分别对应于列表0和列表1中的参考图片320和330中的参考块。模板314和316用于当前块312,模板324和326用于参考块322,而模板334和336用于参考块 332。运动向量340、342和344 是列表0中的合并候选,而运动向量360、362和364是列表1中的合并候选。
46、初始合并候选列表的细化
47、当使用多遍次dmvr来导出初始合并候选列表的细化运动时,仅将多遍次dmvr的第一遍次(即pu级别)应用于重新排序。当模板匹配被用来导出细化运动时,模板大小设置为1。当块宽且块宽度大于高度的2倍时,或块高度窄且块高度大于宽度的2倍时,在tm的运动细化期间仅使用上方或左侧模板。tm被扩展以执行1/16像素mvd精度。在tm合并模式下,前四个合并候选使用细化运动重新排序。
48、对于子块大小等于wsub×hsub的基于子块的合并候选,上方模板包含若干个大小为wsub×1的子模板,左侧模板包含若干个大小为1×hsub的子模板。如图4所示,当前块第一行第一列的子块的运动信息用于导出每个子模板的参考样本。图4中,块412对应于当前图片410中的当前块,块422对应于参考图片420中的同位块。
49、重新排序标准
50、在重新排序处理中,如果候选与其前任者之间的成本差值小于lambda值,例如|d1-d2|<λ,则认为该候选是多余的,其中d1和d2是在第一次armc排序期间获得的成本,而λ是在编解码端的rd标准中使用的拉格朗日参数。
51、armc-tm算法被定义如下:
52、决定列表中所有候选中候选与其前任者之间的最小成本差值:
53、• 如果最小成本差值大于或等于λ,则认为列表足够多样化,以及停止重新排序。
54、• 如果此最小成本差值小于λ,则认为候选是多余的,以及将其移动到列表中的另一个位置。这个另一个位置是候选与其前任者相比具有足够多样性的第一个位置。
55、算法在有限次数的迭代后停止(如果最小成本差值不小于λ)。
56、该算法适用于常规、tm、bm和仿射(affine)合并模式。类似的算法适用于合并mmvd和符号mvd预测方法,这些方法也使用armc进行重新排序。
57、对于低延迟配置,λ的值被设置为等于用于在编解码端选择最佳合并候选的速率失真标准的λ,对于随机访问配置,λ的值被设置为等于与qp相对应的值λ。在sps中或在片段标头(slice header)中对sps中不存在的qp偏移提供与每个发送的qp偏移相对应的一组λ值。
58、扩展至amvp模式
59、armc设计也适用于amvp模式,其中amvp候选根据tm成本重新排序。对于高级运动向量预测(template matching for advanced motion vector prediction,简称tm-amvp)模式的模板匹配,初始amvp候选列表被构建,然后从tm进行细化以构建细化的amvp候选列表。此外,跳过tm成本大于阈值(等于第一mvp候选成本的五倍)的mvp候选。
60、注意,当环绕运动补偿被启用时,应在考虑环绕偏移的情况下对mv候选进行剪裁。
61、5.基于mv候选类型的armc
62、单一候选类型(例如tmvp或非相邻 mvp (na-mvp))的合并候选基于armc tm成本值进行重新排序。然后重新排序的候选被添加到合并候选列表中。tmvp候选类型添加具有更多时间位置和不同帧间预测方向的更多tmvp候选以执行重新排序和选择。此外,na-mvp候选类型进一步扩展为具有更多空间非相邻位置。tmvp 候选的目标参考图片可以根据缩放因子从列表中的任意一个参考图片中选择。所选参考图片是缩放因子最接近1的图片。
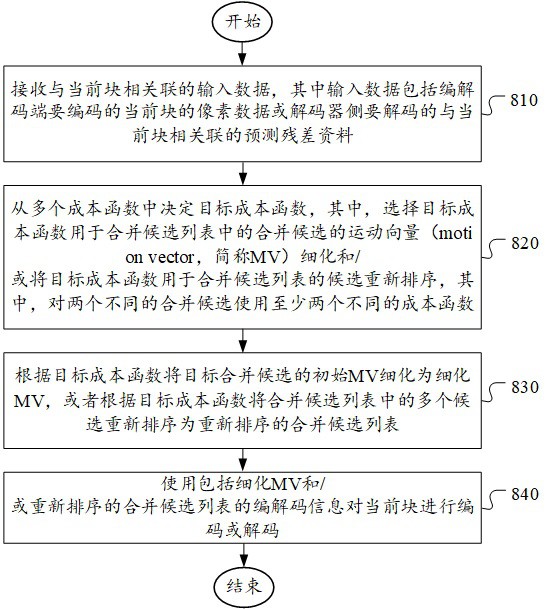
63、在本发明中,适应性地选择成本函数以进行mv细化和/或合并候选的候选重新排序的方案被公开。
技术实现思路
1、一种使用适应性选择成本函数进行mv细化和/或合并候选的候选重新排序的视频编解码方法和装置被公开。根据该方法,与当前块相关联的输入数据被接收,其中,输入数据包括要在编解码端编码的当前块的像素数据或要在解码器侧解码的与当前块相关联的编解码数据。目标成本函数从多个成本函数中决定,其中,目标成本函数被选择用于合并候选列表中的合并候选的运动向量(motion vector,简称mv)细化和/或目标成本函数被用于合并候选列表的候选重新排序,以及其中,至少两个不同的成本函数用于两个不同的合并候选。目标合并候选的初始mv根据目标成本函数被细化为细化mv,或者合并候选列表中的多个候选根据目标成本函数被重新排序为重新排序的合并候选列表。当前块使用包括细化mv和/或重新排序的合并候选列表的编码信息进行编码或解码。
2、在一个实施例中,目标成本函数从多个成本函数中隐式地选择。在一个实施例中,根据与当前块相关联的编码参数从多个成本函数中选择目标成本函数。在一个实施例中,编解码参数包括与当前块相关联的块大小、宽高比、时间id、帧类型、方差、合并索引或其组合。在一个实施例中,当编解码参数包括块大小时,对当前块的不同大小决定定当前块的编解码工具的不同开启/关闭设置。在一个实施例中,当编解码工具包括双向光流(bi-directional optical flow,简称bdof)时,如果当前块的宽度和高度大于或等于第一阈值,或者通过将宽度除以高度计算出的宽高比大于第二阈值,则对当前块启用bdof;否则,禁用bdof。
3、在一个实施例中,当当前块的宽度和高度大于第一阈值或者宽度除以高度计算出的宽高比大于第二阈值时,使用加权的绝对差值和(sum of absolute difference,简称sad)作为目标成本函数;否则,sad被用作为目标成本函数。
4、在一个实施例中,目标成本函数通过显式发送从多个成本函数中选择。例如,用于选择特定合并模式的特定成本函数的一个索引被显式发送或解析,其中,特定成本函数用于执行特定合并模式的合并候选的自适应性重新排序(adaptive reordering of mergecandidates,简称armc)中的第一阶段和第二阶段候选重新排序。在另一个示例中,用于选择特定合并模式的第一特定成本函数和第二特定成本函数的两个索引被显式发送或解析,以及第一特定成本函数用于执行armc中的第一阶段候选重新排序,第二特定成本函数用于执行特定合并模式的armc中的第二阶段候选重新排序。
5、在又一示例中,三个索引被显式地发送或解析以选择特定合并模式或所有合并模式的第一特定成本函数、第二特定成本函数和第三特定成本函数,以及第一特定成本函数和第二特定成本函数用于执行armc中的第一阶段候选重新排序(以及第三特定成本函数用于执行特定合并模式的armc中的第二阶段候选重新排序)。在这种情况下,第一特定成本函数用于对合并候选列表中的合并候选进行排序以形成第一排序的合并候选列表,以及然后第二特定成本函数用于对第一排序的合并候选列表的子列表进行排序,以及其中,第一排序的合并候选列表的子列表对应于在对第一排序的合并候选列表中的合并候选的合并索引应用模数运算后具有相同余数的一个或多个目标候选的模数集。此外,第三特定成本函数用于对由第一排序的合并候选列表形成的第二排序的候选与由第二特定成本函数排序的第一排序的合并候选列表的子列表进行排序。
6、在一个实施例中,用于从多个成本函数中选择目标成本函数的语法用于每个合并候选或由多个合并候选共享。在一个实施例中,显式发送处于序列级别、帧级别、ctu 级别、cu 级别或其组合。
7、在一个实施例中,在目标候选重新排序之前,对第一合并候选列表中的第一合并候选的第一mv细化决定第一目标成本函数,以及在目标候选重新排序之后,对第二合并候选列表中的第二合并候选的第二mv细化决定第二目标成本函数。在一个实施例中,第一目标成本函数与第二目标成本函数相同。在一个实施例中,第一目标成本函数与第二目标成本函数不同。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com