
一种加速器跨架构矩阵乘法分层分块优化方法及系统
本发明属于高性能计算与异构并行计算,尤其涉及一种加速器跨架构矩阵乘法分层分块优化方法及系统。
背景技术:
1、本部分的陈述仅仅是提供了与本发明相关的背景技术信息,不必然构成在先技术。
2、大规模矩阵乘法(gemm)是科学计算与人工智能领域最核心的计算负载之一。在实空间密度泛函理论(dft)等第一性原理计算中,基于chebyshev过滤子空间迭代的特征值求解过程在单次自洽场迭代内调用gemm数千至数万次,累计执行时间占比超过百分之五十。当此类计算任务从传统cpu集群迁移至国产dcu加速器时,gemm性能直接决定了端到端应用软件的实际可用性。
3、然而,现有的国产dcu加速器存在显著的代际硬件差异,这一差异在现有优化方案中尚未得到系统性解决。以dcu z100为代表的早期部署主力,仅具备标量fma(融合乘加)指令,每条指令在一个时钟周期内仅完成一次乘加运算,不包含任何硬件矩阵乘累加单元。而dcu k100(gfx908)及z200(gfx90a)等后续产品则集成了matrix core(mfma)硬件矩阵乘累加单元,单条指令即可完成32×32×8规模的矩阵乘累加运算。这一代际差异的直接后果是:一套仅面向matrix core编写的gemm方案在z100上无法获得有效加速,而为每一代dcu分别编写和调优kernel的工程成本极高。此外,目前被广泛视为gpu gemm优化基准的nvidia cutlass/cute方法论,其对国产dcu的移植障碍不仅是api层面的语法差异,现有api级迁移方案通过hip工具链将cuda代码进行api语法转换(cudamalloc→hipmalloc),只能改变函数名称,难以解决线程模型、内存模型和指令集三个层面的差异。
4、现有技术围绕上述问题的尝试存在三方面不足。其一,共享内存双缓冲方案的分块参数依赖大量手工调试,从目标硬件参数到最优配置缺少系统化推导方法;其二,直接调用matrix core的方案在z100等早期架构上无法适用;其三,提供的面向amd gpu的通用ldsbank冲突消除方案(如ck-tile框架的xor swizzle),但参数配置面向通用场景,针对dcu64线程wavefront和双精度元素跨bank访问模式的适配尚不充分。这三个方向的共同盲区在于将“底层计算指令”与“上层数据组织”绑定,导致底层指令一变、上层结构即须重写。
技术实现思路
1、为克服上述现有技术的不足,本发明提供了一种加速器跨架构矩阵乘法分层分块优化方法及系统,旨在解决同一套gemm优化框架在仅具备标量fma的早期dcu与配备matrixcore的后续dcu之间无法通用的问题,进而实现上层逻辑与底层指令解耦的跨代际优化。
2、为实现上述目的,本发明的一个或多个实施例提供了如下技术方案:
3、本发明第一方面提供了一种加速器跨架构矩阵乘法分层分块优化方法;
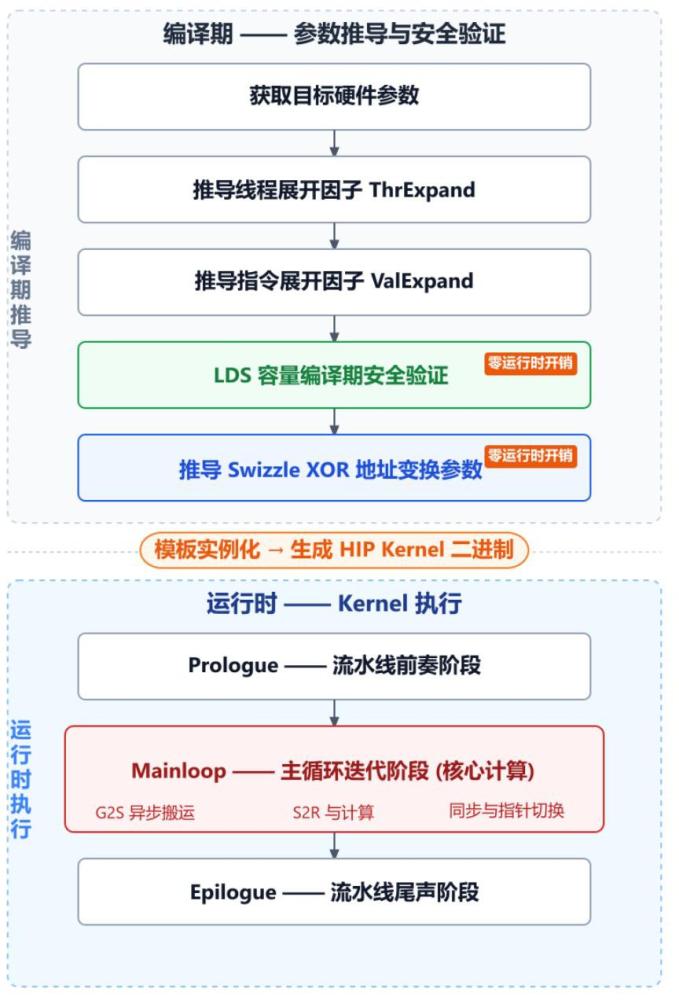
4、一种加速器跨架构矩阵乘法分层分块优化方法,包括编译期参数推导步骤和运行时kernel执行步骤;
5、其中编译期参数推导步骤包括:获取目标加速器的硬件参数;
6、根据所述硬件参数,通过线程-数据映射完整性约束和block覆盖完整性约束自动推导线程展开因子和指令展开因子;
7、根据所述线程展开因子、指令展开因子及分块参数计算局部数据共享存储器占用量,并通过编译期断言验证所述占用量不超过所述局部数据共享存储器容量;
8、根据所述硬件参数推导xor swizzle地址变换参数;
9、运行时kernel执行步骤包括:按照prologue-mainloop-epilogue三阶段协议执行矩阵乘法kernel;在prologue阶段,将首个k-tile从全局内存加载至局部数据共享存储器的第一缓冲区;
10、在mainloop阶段,沿k维度循环执行双缓冲流水线,对于当前k-tile,将下一k-tile加载至交替缓冲区的同时,从当前缓冲区读取数据至向量通用寄存器并通过计算原语执行矩阵乘累加,经同步后交换读写缓冲区索引;
11、在epilogue阶段,将累加器结果写回全局内存。
12、作为进一步的技术方案,所述硬件参数包括wavefront大小、局部数据共享存储器容量、存储体数量、存储体宽度及数据类型字节数。
13、作为进一步的技术方案,所述线程-数据映射完整性约束为:
14、
15、其中,为沿矩阵m方向的线程展开因子,即沿m方向复制的基本计算单元数量;为沿矩阵n方向的线程展开因子;为沿矩阵k方向的线程展开因子;为单个计算原语(mma atom)对应的参与线程数;为目标加速器的wavefront大小;
16、所述block覆盖完整性约束为:
17、
18、其中,、、分别为block沿m、n、k方向的分块大小;、、分别为沿m、n、k方向的指令展开因子,即每个线程在对应方向执行的mma指令条数;、、分别为单个计算原语(mma atom)沿m、n、k方向的输出形状大小。
19、作为进一步的技术方案,根据所述线程展开因子、指令展开因子及分块参数计算局部数据共享存储器占用量,并通过编译期断言验证所述占用量不超过所述局部数据共享存储器容量,包括:
20、在 c++ 模板中嵌入编译期断言机制,验证lds容量安全约束:
21、
22、其中,为局部数据共享存储器的实际占用量(字节);为待计算矩阵乘法的数据类型字节数,单精度取4、双精度取8;为流水线级数,即lds中维护的独立缓冲区数量,典型取2(双缓冲);为目标加速器单计算单元的lds总容量。
23、作为进一步的技术方案,根据所述硬件参数推导xor swizzle地址变换参数,如下所示:
24、swizzle xor 地址变换:
25、
26、
27、其中,为经过xor swizzle变换后的物理存储体列坐标;为变换前的逻辑列坐标;为逻辑行坐标;为xor掩码,由参与swizzle的行位宽决定;为xor位移量;为变换后的lds物理地址;为lds中该矩阵的行跨度,即每行所占的元素数量;
28、xor掩码与位移量推导:
29、
30、其中,为目标加速器lds的存储体(bank)数量;为单bank宽度,dcu为4字节;为数据类型字节数,单精度取4、双精度取8;为沿n方向的线程展开因子;为沿n方向的指令展开因子;为单个计算原语沿n方向的输出形状大小。
31、作为进一步的技术方案,所述mainloop阶段中,当前k-tile的g2s加载与s2r读取及计算原语的矩阵乘累加在wavefront调度层面并发执行;所述g2s加载为全局内存到局部数据共享存储器的数据加载操作,所述s2r读取为局部数据共享存储器到向量通用寄存器的数据加载操作。
32、本发明第二方面提供了一种加速器跨架构矩阵乘法分层分块优化系统。
33、一种加速器跨架构矩阵乘法分层分块优化系统,包括:
34、编译期模板配置层,包括:mma atom定义模块,用于将标量fma指令或matrix core硬件矩阵乘指令封装为统一的c++模板接口;tiledmma配置模块,用于通过线程-数据映射完整性约束和block覆盖完整性约束自动推导线程展开因子和指令展开因子;kernelspec模板模块,用于执行局部数据共享存储器容量的编译期静态验证和swizzle xor地址变换参数推导;
35、运行时kernel执行层,包括:l1 global→block并行调度单元,用于将输出矩阵按block网格分配至不同计算单元;l2 g2s双缓冲加载单元,用于将k-tile从全局内存加载至局部数据共享存储器的双缓冲区并执行swizzle地址变换;l3 s2r寄存器加载与计算单元,用于从局部数据共享存储器读取数据至向量通用寄存器并通过所述mma atom执行矩阵乘累加;epilogue写回单元,用于将累加器结果写回全局内存。
36、本发明第三方面提供了一种计算机可读存储介质,其上存储有程序,该程序被处理器执行时实现如本发明第一方面所述的一种加速器跨架构矩阵乘法分层分块优化方法中的步骤。
37、本发明第四方面提供了一种电子设备,包括存储器、处理器及存储在存储器上并可在处理器上运行的程序,所述处理器执行所述程序时实现如本发明第一方面所述的一种加速器跨架构矩阵乘法分层分块优化方法中的步骤。
38、本发明第五方面提供了一种计算机程序产品,包括计算机程序/指令,该计算机程序/指令被处理器执行时实现本发明第一方面所述的一种加速器跨架构矩阵乘法分层分块优化方法中的步骤。
39、以上一个或多个技术方案存在以下有益效果:
40、(1)本发明通过mma atom可插拔抽象,将标量fma指令与matrix core硬件指令封装为统一的模板接口,使得同一套上层tiledmma配置、lds双缓冲协议和swizzle参数推导模块无需任何改动,即可在仅具备标量fma的dcu z100与配备matrix core的dcu k100/z200之间通用切换。从z100迁移至k100时仅需修改atom类型模板参数,上层代码完全复用,避免了为每一代dcu单独编写和调优kernel的巨大工程开销。
41、(2)本发明在c++模板kernelspec中嵌入编译期断言机制,在模板实例化阶段即完成lds容量的精确计算与上限比较,若配置超出目标硬件容量则编译直接失败并输出具体溢出量,而非部署到硬件运行后才暴露问题。该机制将安全性检查前置至编译阶段,有效缩短了kernel调优迭代周期,降低了开发调试成本。
42、(3)本发明支持根据矩阵形状和计算精度自适应调整分块参数:当矩阵维度不均衡时采用矩形分块并独立推导各维度展开因子;当k值较小时降低双缓冲级数以释放lds空间容纳更大分块;当双精度计算导致访存压力增大时增加流水线深度。上述调整均通过编译期模板参数修改完成,无需重写运行时流水线控制代码,实现了一处编写、多场景适配。
43、本发明附加方面的优点将在下面的描述中部分给出,部分将从下面的描述中变得明显,或通过本发明的实践了解到。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com