
用于包括多个矢量-矩阵乘法阵列的堆叠的接口电路的制作方法
公开了一种用于包括三维集成电路的人工神经网络的接口电路的许多示例。
背景技术:
1、人工神经网络模拟生物神经网络(动物的中枢神经系统,特别是大脑),并且用于估计或近似可取决于大量输入并且通常未知的函数。人工神经网络通常包括彼此交换消息的互连“神经元”层。
2、图1例示了人工神经网络,其中圆圈表示神经元的输入或层。连接部(称为突触)用箭头表示并且具有可基于经验进行调谐的数值权重。这使得神经网络适应于输入并且能够学习。通常,神经网络包括多个输入的层。通常存在神经元的一个或多个中间层,以及提供神经网络的输出的神经元的输出层。处于每一级别的神经元分别地或共同地基于从突触接收的数据作出决定。
3、在开发用于高性能信息处理的人工神经网络方面的主要挑战中的一个挑战是缺乏足够的硬件技术。实际上,实际神经网络依赖于大量的突触,从而实现神经元之间的高连通性,即非常高的计算并行性。原则上,这种复杂性可通过数字超级计算机或专用图形处理单元集群来实现。然而,相比于生物网络,这些方法除了高成本之外,能量效率也很普通,生物网络主要由于其执行低精度的模拟计算而消耗更少的能量。cmos模拟电路已被用于人工神经网络,但由于给定大量的神经元和突触,大多数cmos实现的突触都过于庞大。
4、申请人先前在美国专利申请公开2017/0337466a1中公开了一种利用一个或多个非易失性存储器阵列作为突触的人工(模拟)神经网络,该专利申请公开以引用方式并入本文。非易失性存储器阵列作为模拟神经存储器操作,并且包括按行和列布置的非易失性存储器单元。神经网络包括被配置为接收第一多个输入并且从其生成第一多个输出的第一多个突触,以及被配置为接收第一多个输出的第一多个神经元。第一多个突触包括多个存储器单元,其中存储器单元中的每个存储器单元包括:形成于半导体衬底中的间隔开的源极区和漏极区,其中沟道区在源极区和漏极区之间延伸;设置在沟道区的第一部分上方并且与第一部分绝缘的浮栅;以及设置在沟道区的第二部分上方并且与第二部分绝缘的非浮栅。多个存储器单元中的每个存储器单元存储与浮栅上的电子数量相对应的权重值。多个存储器单元将第一多个输入乘以所存储的权重值以生成第一多个输出。
5、非易失性存储器单元
6、非易失性存储器是众所周知的。例如,美国专利5,029,130(“该’130专利”),其以引用方式并入本文,公开了分裂栅非易失性存储器单元的阵列,它是一种闪存存储器单元。在图2中示出此类存储器单元210。每个存储器单元210包括在半导体衬底12中形成的源极区14和漏极区16,该源极区与该漏极区之间具有沟道区18。浮栅20形成在沟道区18的第一部分上方并且与其绝缘(并且控制其电导率),并且形成在源极区14的一部分上方。字线端子22(其通常被耦合到字线)具有设置在沟道区18的第二部分上方并且与其绝缘(并且控制其电导率)的第一部分,以及向上延伸并且位于浮栅20上方的第二部分。浮栅20和字线端子22通过栅极氧化物与衬底12绝缘。位线24耦合到漏极区16。
7、通过将高的正电压置于字线端子22上来对存储器单元210进行擦除(其中电子从浮栅被移除),这使浮栅20上的电子经由福勒-诺德海姆(fowler-nordheim,fn)隧穿从浮栅20到字线端子22隧穿通过中间绝缘体。
8、通过将正电压置于字线端子22上并且将正电压置于源极区14上,利用热电子(其中电子被置于浮栅上)通过源极侧注入(ssi)对存储器单元210进行编程。电子电流将从漏极区16流向源极区14。当电子到达字线端子22和浮栅20之间的间隙时,电子将加速并且变热。由于来自浮栅20的静电引力,一些加热的电子将通过栅极氧化物被注入到浮栅20上。
9、通过将正读取电压置于漏极区16和字线端子22上(这导通沟道区18的在字线端子下方的部分)来读取存储器单元210。如果浮栅20带正电(即,电子被擦除),则沟道区18的在浮栅20下方的部分也被导通,并且电流将流过沟道区18,该沟道区被感测为擦除状态或“1”状态。如果浮栅20带负电(即,通过电子进行了编程),则沟道区的在浮栅20下方的部分被大部分或完全关断,并且电流将不会(或者有很少的电流)流过沟道区18,该沟道区被感测为编程状态或“0”状态。
10、表1描绘了可施加到存储器单元210的端子以用于执行读取操作、擦除操作和编程操作的典型电压和电流范围:
11、表1:图2的闪存存储器单元210的操作
12、
13、作为其他类型的闪存存储器单元的其他分裂栅存储器单元配置是已知的。例如,图3描绘了四栅存储器单元310,该四栅存储器单元包括源极区14、漏极区16、在沟道区18的第一部分上方的浮栅20、在沟道区18的第二部分上方的(通常耦合到字线wl的)选择栅22、在浮栅20上方的控制栅28以及在源极区14上方的擦除栅30。此配置在美国专利6,747,310中有所描述,该美国专利以引用方式并入本文以用于所有目的。此处,除了浮栅20之外,所有的栅极均为非浮栅,这意味着它们电连接到或能够电连接到电压源。编程由来自沟道区18的将自身注入到浮栅20的热电子执行。擦除通过从浮栅20隧穿到擦除栅30的电子来执行。
14、表2描绘了可施加到存储器单元310的端子以用于执行读取操作、擦除操作和编程操作的典型电压和电流范围:
15、表2:图3的闪存存储器单元310的操作
16、
17、图4描绘了三栅存储器单元410,该三栅存储器单元为另一种类型的闪存存储器单元。存储器单元410与图3的存储器单元310相同,不同之处在于存储器单元410不具有单独控制栅。除了没有施加控制栅偏置,擦除操作(由此通过使用擦除栅进行擦除)和读取操作与图3的操作类似。在没有控制栅偏置的情况下,也完成编程操作,并且因此,在编程操作期间在源极线上施加更高的电压,以补偿控制栅偏置的缺乏。
18、表3描绘了可施加到存储器单元410的端子以用于执行读取操作、擦除操作和编程操作的典型电压和电流范围:
19、表3:图4的闪存存储器单元410的操作
20、
21、图5描绘了堆叠栅存储器单元510,其为另一种类型的闪存存储器单元。除了浮栅20在整个沟道区18上方延伸并且控制栅22(其在此处将耦合到字线)在浮栅20上方延伸、由绝缘层(未示出)分开之外,存储器单元510与图2的存储器单元210类似。通过电子从fg到衬底的fn隧穿来进行擦除,通过在沟道18与漏极区16之间的区处的沟道热电子(che)注入、通过电子从源极区14朝向漏极区16流动以及与用于具有较高控制栅电压的存储器单元210的读取操作类似的读取操作来进行编程。
22、表4描绘了可施加到存储器单元510和衬底12的端子以用于执行读取操作、擦除操作和编程操作的典型电压范围:
23、表4:图5的闪存存储器单元510的操作
24、
25、本文所描述的方法和装置可应用于其他非易失性存储器技术,诸如但不限于finfet分裂栅闪存或堆叠栅闪存存储器、nand闪存、sonos(硅-氧化物-氮化物-氧化物-硅,电荷捕获在氮化物中)、monos(金属-氧化物-氮化物-氧化物-硅,金属电荷捕获在氮化物中)、reram(电阻式随机存取存储器)、pcm(相变存储器)、mram(磁性ram)、feram(铁电ram)、ct(电荷捕获)存储器、cn(碳管)存储器、otp(双电平或多电平一次可编程)和ceram(关联电子ram)等。
26、为了在人工神经网络中利用包括上述类型的非易失性存储器单元之一的存储器阵列,进行了两个修改。首先,对线进行配置,使得每个存储器单元可被单独编程、擦除和读取,而不会不利地影响阵列中的其他存储器单元的存储器状态,如下文进一步解释。其次,提供存储器单元的连续(模拟)编程。
27、具体地,阵列中的每个存储器单元的存储器状态(即,浮栅上的电荷)可以在独立地并且对其他存储器单元的干扰最小的情况下连续地从完全擦除状态变为完全编程状态,反之亦然。这意味着单元存储装置实际上是模拟的,或者至少可存储许多离散值(诸如16或64个不同的值)中的一个离散值,这允许对存储器阵列中的所有存储器单元进行非常精确且单独的调谐,并且这使得存储器阵列对于存储和对神经网络的突触权重进行精细调谐调整是理想的。
28、采用非易失性存储器单元阵列的神经网络
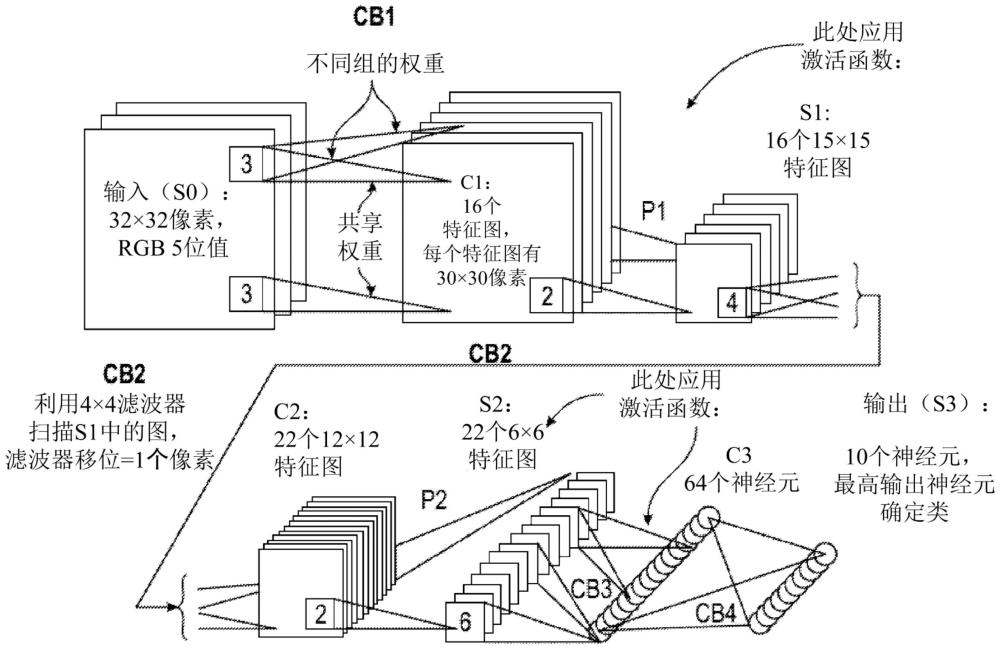
29、图6概念性地例示了本示例的利用非易失性存储器阵列的神经网络的非限制性示例。该示例将非易失性存储器阵列神经网络用于面部识别应用,但任何其他适当的应用也可使用基于非易失性存储器阵列的神经网络来实现。
30、对于该示例,s0为输入层,其为具有5位精度的32x32像素rgb图像(即,三个32x32像素阵列,分别用于每个颜色r、g和b,每个像素为5位精度)。从输入层s0到层c1的突触cb1在一些情况下应用不同组的权重,并且在其他情况下应用共享权重,并且用3x3像素重叠滤波器(内核)扫描输入图像,从而将滤波器移位1个像素(或如模型所指示,多于1个像素)。具体地,将图像的3x3部分中的9个像素的值(即,称为滤波器或内核)提供给突触cb1,其中将这9个输入值乘以适当的权重,并且在对该乘法的输出求和之后,由cb1的第一突触确定并提供单个输出值以用于生成层c1的特征图中的一者的像素。然后将3x3滤波器在输入层s0内向右移位一个像素(即,添加右侧的三个像素的列,并释放左侧的三个像素的列),由此将该新定位的滤波器中的9个像素值提供给突触cb1,其中将它们乘以相同的权重并且由相关联的突触确定第二单个输出值。继续该过程,直到3x3滤波器在输入层s0的整个32x32像素图像上扫描所有三种颜色和所有位(精度值)。然后使用不同组的权重重复该过程以生成层c1的不同特征图,直到计算出层c1的所有特征图。
31、在层c1处,在本示例中,存在16个特征图,每个特征图具有30x30像素。每个像素是从输入和内核的乘积中提取的新特征像素,并且因此每个特征图是二维阵列,并且因此在该示例中,层c1由16层的二维阵列构成(记住本文所引用的层和阵列是逻辑关系,该逻辑关系可对应于或可不对应于物理关系—即,阵列可不定向在物理二维阵列中)。在层c1中的16个特征图中的每个特征图均由应用于滤波器扫描的十六个不同组的突触权重中的一组生成。c1特征图可全部涉及相同图像特征的不同方面,诸如边界标识。例如,第一图(使用第一权重组生成,针对用于生成该第一图的所有扫描而共享)可标识圆形边缘,第二图(使用与第一权重组不同的第二权重组生成)可标识矩形边缘,或某些特征的纵横比,以此类推。
32、在从层c1转到层s1之前,应用激活函数p1(池化),该激活函数将来自每个特征图中连续的非重叠2x2区域的值进行池化。池化函数p1的目的是对邻近位置求均值(或者也可使用max函数),以例如减少边缘位置的依赖性,并在进入下一阶段之前减小数据大小。在层s1处,存在16个15x15特征图(即,十六个不同的阵列,每个阵列具有15x15像素)。从层s1到层c2的突触cb2利用4x4滤波器扫描层s1中的图,其中滤波器移位1个像素。在层c2处,存在22个12x12特征图。在从层c2转到层s2之前,应用激活函数p2(池化),该激活函数将来自每个特征图中连续的非重叠2x2区域的值进行池化。在层s2处,存在22个6x6特征图。将激活函数(池化)应用于从层s2到层c3的突触cb3,其中层c3中的每个神经元经由cb3的相应突触连接至层s2中的每个图。在层c3处,存在64个神经元。从层c3到输出层s3的突触cb4完全将c3连接至s3,即层c3中的每个神经元都连接到层s3中的每个神经元。s3处的输出包括10个神经元,其中最高输出神经元确定类。例如,该输出可指示对原始图像的内容的标识或分类。
33、使用非易失性存储器单元的阵列或阵列的一部分来实现每层的突触。
34、图7为可用于该目的的阵列的框图。矢量-矩阵乘法(vmm)阵列32包括非易失性存储器单元,并且用作一层与下一层之间的突触(诸如图6中的cb1、cb2、cb3和cb4)。具体地,vmm阵列32包括非易失性存储器单元的阵列33、擦除栅和字线栅解码器34、控制栅解码器35、位线解码器36和源极线解码器37,这些解码器对非易失性存储器单元阵列33的相应输入进行解码。对vmm阵列32的输入可来自擦除栅和字线栅解码器34或来自控制栅解码器35。在该示例中,源极线解码器37还对非易失性存储器单元阵列33的输出进行解码。另选地,位线解码器36可对非易失性存储器单元阵列33的输出进行解码。
35、非易失性存储器单元阵列33用于两个目的。首先,它存储将由vmm阵列32使用的权重。其次,非易失性存储器单元阵列33有效地将输入与存储在非易失性存储器单元阵列33中的权重相乘并且每个输出线(源极线或位线)将它们相加以产生输出,该输出将作为下一层的输入或最终层的输入。通过执行乘法和加法函数,非易失性存储器单元阵列33消除了对单独的乘法和加法逻辑电路的需要,并且由于其原位存储器计算其也是高功效的。
36、将非易失性存储器单元阵列33的输出提供至差分求和器(诸如求和运算放大器或求和电流镜)38,该差分求和器对非易失性存储器单元阵列33的输出进行求和,以为该卷积创建单个值。差分求和器38被布置用于执行正权重和负权重的求和。
37、然后将差分求和器38的求和后输出值提供至激活函数块39,该激活函数块对输出进行修正。激活函数块39可提供sigmoid、tanh或relu函数。激活函数块39的已修正的输出值成为作为下一层(例如,图6中的层c1)的特征图的元素,然后被应用于下一个突触以产生下一个特征图层或最终层。因此,在该示例中,非易失性存储器单元阵列33构成多个突触(其从现有神经元层或从输入层诸如图像数据库接收它们的输入),并且求和运算放大器38和激活函数块39构成多个神经元。
38、图7中对vmm阵列32的输入(wlx、egx、cgx以及可选的blx和slx)可以是模拟电平、二进制电平或数字位(在这种情况下,提供dac以将数字位转换成适当的输入模拟电平),并且输出可以是模拟电平、二进制电平或数字位(在这种情况下,提供输出adc以将输出模拟电平转换成数字位)。
39、图8为描绘此处标记为vmm阵列32a、32b、32c、32d和32e的多层vmm阵列32的使用的框图。如图8所示,通过数模转换器31将输入(表示为inputx)从数字转换成模拟,并且将其提供至输入vmm阵列32a。转换的模拟输入可以是电压或电流。第一层的输入d/a转换可通过使用将输入inputx映射到输入vmm阵列32a的矩阵乘法器的适当模拟电平的函数或lut(查找表)来完成。输入转换也可以由模拟至模拟(a/a)转换器完成,以将外部模拟输入转换成到输入vmm阵列32a的映射模拟输入。
40、由输入vmm阵列32a生成的输出被作为到下一个vmm阵列(隐藏级别1)32b的输入提供,该输入继而生成作为下一vmm阵列(隐藏级别2)32c的输入而提供的输出,以此类推。vmm阵列32的各种层用作卷积神经网络(cnn)的突触和神经元的不同层。每个vmm阵列32a、32b、32c、32d和32e可以是独立的物理非易失性存储器阵列、或者多个vmm阵列可以利用相同物理非易失性存储器阵列的不同部分、或者多个vmm阵列可以利用相同物理非易失性存储器阵列的重叠部分。图8所示的示例包含五个层(32a,32b,32c,32d,32e):一个输入层(32a)、两个隐藏层(32b,32c)和两个全连接层(32d,32e)。本领域的普通技术人员将了解,这仅是示例,并且相反,系统可以包括两个以上的隐藏层和两个以上的全连接层。
41、矢量-矩阵乘法(vmm)阵列
42、图9描绘了神经元vmm阵列900,该神经元vmm阵列特别适用于图3所示的存储器单元310,并且用作输入层与下一层之间的突触和部分神经元。vmm阵列900包括非易失性存储器单元的存储器阵列901和非易失性参考存储器单元的参考阵列902(在阵列的顶部)。另选地,可将另一个参考阵列置于底部。
43、在vmm阵列900中,控制栅线(诸如控制栅线903)在竖直方向上延伸(因此参考阵列902在行方向上与控制栅线903正交),并且擦除栅线(诸如擦除栅线904)在水平方向上延伸。此处,到vmm阵列900的输入设置在控制栅线(cg0, cg1, cg2, cg3)上,并且vmm阵列900的输出出现在源极线(sl0, sl1)上。在一个示例中,仅使用偶数行,并且在另一个示例中,仅使用奇数行。置于各源极线(分别为sl0、sl1)上的电流执行来自连接到该特定源极线的存储器单元的所有电流的求和函数。
44、如本文针对神经网络所描述,vmm阵列900的非易失性存储器单元(即vmm阵列900的存储器单元310)可被配置为在阈值以下区域中操作。
45、在弱反转(阈值以下区域)中偏置本文所描述的非易失性参考存储器单元和非易失性存储器单元:
46、ids = io e (vg- vth)/nvt = w io e (vg)/nvt,
47、其中w = e (- vth)/nvt
48、其中ids为漏极到源极电流;vg为存储器单元上的栅极电压;vth是存储器单元的阈值电压;vt是热电压=kt/q,其中k是玻尔兹曼常数,t是以开尔文为单位的温度,并且q是电子电荷;n是斜率因子=1+(cdep/cox),其中cdep=耗尽层的电容,并且cox是栅极氧化物层的电容;io是等于阈值电压的栅极电压下的存储器单元电流,io与(wt/l) u cox (n-1) vt2成比例,其中u是载流子迁移率,并且wt和l分别是存储器单元的宽度和长度。
49、对于使用存储器单元(诸如参考存储器单元或外围存储器单元)或晶体管将输入电流转换成输入电压的i到v对数转换器:
50、vg= nvtlog [ids/wpio]
51、其中,wp为参考存储器单元或外围存储器单元的w。
52、对于用作带有电流输入的矢量矩阵乘法器vmm阵列的存储器阵列,输出电流为:
53、iout = wa io e (vg)/nvt,即
54、iout = (wa/wp) iin = w iin
55、w = e (vthp - vtha)/nvt
56、此处,wa =存储器阵列中的每个存储器单元的w。
57、vthp是外围存储器单元的有效阈值电压,并且vtha是主要(数据)存储器单元的有效阈值电压。注意,晶体管的阈值电压是衬底主体偏置电压的函数,并且可以对表示为vsb的衬底主体偏置电压进行调制以补偿在这种温度下的各种条件。阈值电压vth可以表示为:
58、vth = vth0 + γ (sqrt |vsb - 2f) - sqrt |2 f |)
59、其中vth0是具有零衬底偏置的阈值电压,f是表面电位,并且γ是主体效应参数。
60、字线或控制栅可用作输入电压的存储器单元的输入。
61、另选地,本文所描述的vmm阵列的闪存存储器单元可被配置为在线性区域中操作:
62、ids = β (vgs-vth)vds;β = ucoxwt/l
63、w = α (vgs-vth)
64、意指线性区域中的权重w与(vgs-vth)成比例
65、字线或控制栅或位线或源极线可以用作在线性区域中操作的存储器单元的输入。位线或源极线可用作存储器单元的输出。
66、对于i-v线性转换器,在线性区域工作的存储器单元(诸如参考存储器单元或外围存储器单元)或晶体管可以用来将输入/输出电流线性转换成输入/输出电压。
67、另选地,本文所描述的vmm阵列的存储器单元可被配置为在饱和区域中操作:
68、ids = ½ β (vgs-vth)2;β=ucoxwt/l
69、wα (vgs-vth)2,意指权重w与(vgs-vth)2成比例
70、字线、控制栅或擦除栅可以用作在饱和区域中操作的存储器单元的输入。位线或源极线可用作输出神经元的输出。
71、另选地,本文所描述的vmm阵列的存储器单元可用于神经网络的每个层或多个层的所有区域或其组合(阈值以下、线性或饱和区域)。
72、美国专利第10,748,630号中描述了图7的vmm阵列32的其他示例,该专利以引用方式并入本文。如该申请中所描述。源极线或位线可用作神经元输出(电流求和输出)。
73、图10描绘了神经元vmm阵列1000,该神经元vmm阵列特别适用于图2所示的存储器单元210,并且用作输入层与下一层之间的突触。vmm阵列1000包括非易失性存储器单元的存储器阵列1003、第一非易失性参考存储器单元的参考阵列1001和第二非易失性参考存储器单元的参考阵列1002。在阵列的列方向上布置的参考阵列1001和1002用于将流入端子blr0、blr1、blr2和blr3的电流输入转换成电压输入wl0、wl1、wl2和wl3。实际上,第一非易失性参考存储器单元和第二非易失性参考存储器单元通过多路复用器1014(部分描绘)以二极管式连接,其中电流输入流入其中。参考单元被调谐(例如,编程)为目标参考电平。目标参考电平由参考微阵列矩阵(未示出)提供。
74、存储器阵列1003用于两个目的。首先,它将vmm阵列1000将使用的权重存储在其相应的存储器单元上。其次,存储器阵列1003有效地将输入(即,在端子blr0、blr1、blr2和blr3中提供的电流输入,参考阵列1001和参考阵列1002将这些电流输入转换为输入电压以供应到字线wl0、wl1、wl2和wl3)乘以存储在存储器阵列1003中的权重,并且然后将所有结果(存储器单元电流)相加,以在相应位线(bl0至bln)上产生输出,该输出将为到下一层的输入或到最终层的输入。通过执行乘法和加法函数,存储器阵列1003消除了对单独的乘法逻辑电路和加法逻辑电路的需要,并且也是高功效的。此处,电压输入在字线wl0、wl1、wl2和wl3上提供,并且输出在读取(推断)操作期间出现在相应位线bl0至bln上。置于位线bl0至bln中的每个位线上的电流执行来自连接到该特定位线的所有非易失性存储器单元的电流的求和函数。
75、表5描绘了用于vmm阵列1000的操作电压和电流。表中的列指示置于用于选定单元的字线、用于未选单元的字线、用于选定单元的位线、用于未选单元的位线、用于选定单元的源极线和用于未选单元的源极线上的电压。行指示读取、擦除和编程操作。
76、表5:图10的vmm阵列1000的操作:
77、
78、图11描绘了神经元vmm阵列1100,该神经元vmm阵列特别适用于图2所示的存储器单元210,并且用作输入层与下一层之间的突触和部分神经元。vmm阵列1100包括非易失性存储器单元的存储器阵列1103、第一非易失性参考存储器单元的参考阵列1101和第二非易失性参考存储器单元的参考阵列1102。参考阵列1101和1102在vmm阵列1100的行方向上延伸。vmm阵列与vmm 1000类似,不同之处在于在vmm阵列1100中,字线在竖直方向上延伸。此处,输入设置在字线(wla0, wlb0, wla1, wlb2, wla2, wlb2, wla3, wlb3)上,并且输出在读取操作期间出现在源极线(sl0, sl1)上。置于各源极线上的电流执行来自连接到该特定源极线的存储器单元的所有电流的求和函数。
79、表6描绘了用于vmm阵列1100的操作电压和电流。表中的列指示置于用于选定单元的字线、用于未选单元的字线、用于选定单元的位线、用于未选单元的位线、用于选定单元的源极线和用于未选单元的源极线上的电压。行指示读取、擦除和编程操作。
80、表6:图11的vmm阵列1100的操作
81、
82、图12描绘了神经元vmm阵列1200,该神经元vmm阵列特别适用于图3所示的存储器单元310,并且用作输入层与下一层之间的突触和部分神经元。vmm阵列1200包括非易失性存储器单元的存储器阵列1203、第一非易失性参考存储器单元的参考阵列1201和第二非易失性参考存储器单元的参考阵列1202。参考阵列1201和1202用于将流入端子blr0、blr1、blr2和blr3的电流输入转换成电压输入cg0、cg1、cg2和cg3。实际上,第一非易失性参考存储器单元和第二非易失性参考存储器单元通过多路复用器1212(部分示出)以二极管式连接,其中电流输入通过blr0、blr1、blr2和blr3流入其中。多路复用器1212各自包括相应的多路复用器1205和共源共栅晶体管1204,以确保在读取操作期间第一非易失性参考存储器单元和第二非易失性参考存储器单元中的每一者的位线(诸如blr0)上的电压恒定。将参考单元调谐至目标参考电平。
83、存储器阵列1203用于两个目的。首先,它存储将由vmm阵列1200使用的权重。其次,存储器阵列1203有效地将输入(提供到端子blr0、blr1、blr2和blr3的电流输入,参考阵列1201和1202将这些电流输入转换成输入电压,以供应到控制栅(cg0, cg1, cg2和cg3))乘以存储在存储器阵列中的权重,并且然后将所有结果(单元电流)相加以产生输出,该输出出现在bl0至bln上并且将是到下一层的输入或到最终层的输入。通过执行乘法和加法函数,存储器阵列消除了对单独的乘法和加法逻辑电路的需要,并且也是高功效的。此处,输入在控制栅线(cg0, cg1, cg2和cg3)上提供,并且输出在读取操作期间出现在位线(bl0-bln)上。置于各位线上的电流执行来自连接到该特定位线的存储器单元的所有电流的求和函数。
84、vmm阵列1200对存储器阵列1203中的非易失性存储器单元实现单向调谐。也就是说,每个非易失性存储器单元被擦除,然后被部分编程,直到达到浮栅上的所需电荷。如果在浮栅上放置过多电荷(使得错误的值存储在单元中),则单元被擦除,并且部分编程操作的序列重新开始。如图所示,共享同一擦除栅(诸如eg0或eg1)的两行被一起擦除(其被称为页面擦除),并且此后,每个单元被部分编程,直到达到浮栅上的所需电荷。
85、表7描绘了用于vmm阵列1200的操作电压和电流。表中的列指示置于用于选定单元的字线、用于未选单元的字线、用于选定单元的位线、用于未选单元的位线、用于选定单元的控制栅、用于与选定单元相同扇区中的未选单元的控制栅、用于与选定单元不同扇区中的未选单元的控制栅、用于选定单元的擦除栅、用于未选单元的擦除栅、用于选定单元的源极线和用于未选单元的源极线上的电压。行指示读取、擦除和编程操作。
86、表7:图12的vmm阵列1200的操作
87、
88、图13描绘了神经元vmm阵列1300,该神经元vmm阵列特别适用于如图3所示的存储器单元310,并且用作输入层与下一层之间的突触和部分神经元。vmm阵列1300包括非易失性存储器单元的存储器阵列1303、第一非易失性参考存储器单元的参考阵列1301和第二非易失性参考存储器单元的参考阵列1302。eg线egr0、eg0、eg1和egr1竖直延伸,而cg线cg0、cg1、cg2和cg3以及sl线wl0、wl1、wl2和wl3水平延伸。vmm阵列1300与vmm阵列1400类似,不同之处在于vmm阵列1300实现双向调谐,其中由于使用单独的eg线,每个单独的单元可根据需要被完全擦除、部分编程和部分擦除,以在浮栅上达到期望的电荷量。如图所示,参考阵列1301和1302将端子blr0、blr1、blr2和blr3中的输入电流转换成要在行方向上施加到存储器单元的控制栅电压cg0、cg1、cg2和cg3(通过经由多路复用器1314的二极管式连接的参考单元的动作)。电流输出(神经元)在位线bl0-bln中,其中每个位线对来自连接到该特定位线的非易失性存储器单元的所有电流求和。
89、表8描绘了用于vmm阵列1300的操作电压和电流。表中的列指示置于用于选定单元的字线、用于未选单元的字线、用于选定单元的位线、用于未选单元的位线、用于选定单元的控制栅、用于与选定单元相同扇区中的未选单元的控制栅、用于与选定单元不同扇区中的未选单元的控制栅、用于选定单元的擦除栅、用于未选单元的擦除栅、用于选定单元的源极线和用于未选单元的源极线上的电压。行指示读取、擦除和编程操作。
90、表8:图13的vmm阵列1300的操作
91、
92、图22描绘了神经元vmm阵列2200,该神经元vmm阵列特别适用于图2所示的存储器单元210,并且用作输入层与下一层之间的突触和部分神经元。在vmm阵列2200中,输入input0、……、inputn分别在位线bl0、……、bln上被接收,并且输出output1、output2、output3和output4分别在源极线sl0、sl1、sl2和sl3上生成。
93、图23描绘了神经元vmm阵列2300,该神经元vmm阵列特别适用于图2所示的存储器单元210,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、input1、input2和input3分别在源极线sl0、sl1、sl2和sl3上被接收,并且输出output0、……、outputn在位线bl0、……、bln上生成。
94、图24描绘了神经元vmm阵列2400,该神经元vmm阵列特别适用于如图2所示的存储器单元210,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputm分别在字线wl0、……、wlm上被接收,并且输出output0、……、outputn在位线bl0、……、bln上生成。
95、图25描绘了神经元vmm阵列2500,该神经元vmm阵列特别适用于如图3所示的存储器单元310,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputm分别在字线wl0、……、wlm上被接收,并且输出output0、……、outputn在位线bl0、……、bln上生成。
96、图26描绘了神经元vmm阵列2600,该神经元vmm阵列特别适用于如图4所示的存储器单元410,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputn分别在竖直控制栅线cg0、……、cgn上被接收,并且输出output1和output2在源极线sl0和sl1上生成。
97、图27描绘了神经元vmm阵列2700,该神经元vmm阵列特别适用于图4所示的存储器单元410,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputn分别在位线控制栅2701-1、2701-2、……、2701-(n-1)和2701-n的栅极上被接收,这些栅极分别耦合到位线bl0、……、bln。示例输出output1和output2在源极线sl0和sl1上生成。
98、图28描绘了神经元vmm阵列2800,该神经元vmm阵列特别适用于如图3所示的存储器单元310、如图5所示的存储器单元510和如图7所示的存储器单元710,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputm在字线wl0、……、wlm上被接收,并且输出output0、……、outputn分别在位线bl0、……、bln上生成。
99、图29描绘了神经元vmm阵列2900,该神经元vmm阵列特别适用于如图3所示的存储器单元310、如图5所示的存储器单元510和如图7所示的存储器单元710,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputm在控制栅线cg0、……、cgm上被接收。输出output0、……、outputn分别在竖直源极线sl0、……、sln上生成,其中每个源极线sli耦合到列i中的所有存储器单元的源极线。
100、图30描绘了神经元vmm阵列3000,该神经元vmm阵列特别适用于如图3所示的存储器单元310、如图5所示的存储器单元510和如图7所示的存储器单元710,并且用作输入层与下一层之间的突触和部分神经元。在该示例中,输入input0、……、inputm在控制栅线cg0、……、cgm上被接收。输出output0、……、outputn分别在竖直位线bl0、……、bln上生成,其中每个位线bli耦合到列i中的所有存储器单元的位线。
101、长短期记忆
102、现有技术包括被称为长短期记忆(lstm)的概念。lstm单元通常用于神经网络中。lstm允许神经网络在预定的任意时间间隔内记住信息并在后续操作中使用该信息。常规的lstm单元包括单元、输入栅、输出栅和忘记栅。三个栅调控进出单元的信息流以及信息在lstm中被记住的时间间隔。vmm尤其可用于lstm单元中。
103、图14描绘了示例lstm 1400。该示例中的lstm 1400包括单元1401、1402、1403和1404。单元1401接收输入矢量x0并且生成输出矢量h0和单元状态矢量c0。单元1402接收输入矢量x1、来自单元1401,的输出矢量(隐藏状态)h0和来自单元1401的单元状态c0,并且生成输出矢量h1和单元状态矢量c1。单元1403接收输入矢量x2、来自单元1402的输出矢量(隐藏状态)h1和来自单元1402的单元状态c1,并且生成输出矢量h2和单元状态矢量c2。单元1404接收输入矢量x3、来自单元1403的输出矢量(隐藏状态)h2和来自单元1403的单元状态c2,并且生成输出矢量h3。可以使用另外的单元,并且具有四个单元的lstm仅仅是示例。
104、图15描绘了可用于图14中的单元1401、1402、1403和1404的lstm单元1500的示例具体实施。lstm单元1500接收输入矢量x(t)、来自前一单元的单元状态矢量c(t-1)和来自前一单元的输出矢量h(t-1),并且生成单元状态矢量c(t)和输出矢量h(t)。
105、lstm单元1500包括sigmoid函数设备1501、1502和1503,每个sigmoid函数设备应用0与1之间的数字来控制允许输入矢量中的每个分量有多少通过到达输出矢量。lstm单元1500还包括用于将双曲线正切函数应用于输入矢量的tanh设备1504和1505、用于将两个矢量相乘在一起的乘法器设备1506、1507和1508以及用于将两个矢量相加在一起的加法设备1509。输出矢量h(t)可被提供给系统中的下一个lstm单元,或者其可被访问用于其他目的。
106、图16描绘了lstm单元1600,该lstm单元为lstm单元1500的具体实施的示例。为了方便读者,在lstm单元1600中使用与lstm单元1500相同的编号。sigmoid函数设备1501、1502和1503以及tanh设备1504各自包括多个vmm阵列1601和激活函数块1602。因此,可以看出,vmm阵列在某些神经网络系统中使用的lstm单元中特别有用。乘法器设备1506、1507和1508以及加法设备1509以数字方式或模拟方式实现。激活函数块1602可以数字方式或模拟方式实现。
107、lstm单元1600的替代形式(以及lstm单元1500的具体实施的另一示例)在图17中示出。在图17中,sigmoid函数设备1501、1502和1503以及tanh设备1504以时分复用方式共享相同的物理硬件(vmm阵列1701和激活函数块1702)。lstm单元1700还包括用于将两个矢量相乘在一起的乘法器设备1703,用于将两个矢量相加在一起的加法设备1708,tanh设备1505(其包括激活函数块1702),用于当从sigmoid函数块1702输出值i(t)时存储该值i(t)的寄存器1707,用于当值f(t) c(t-1)通过多路复用器1710从乘法器设备1703输出时存储该值的寄存器1704,用于当值i(t) u(t)通过多路复用器1710从乘法器设备1703输出时存储该值的寄存器1705,以及用于当值o(t) c~(t)通过多路复用器1710从乘法器设备1703输出时存储该值的寄存器1706,以及多路复用器1709。
108、lstm单元1600包含多组vmm阵列1601和相应的激活函数块1602,而lstm单元1700包含一组vmm阵列1701和激活函数块1702,它们用于表示lstm单元1700的示例中的多个层。lstm单元1700将需要比lstm 1600少的空间,因为与lstm单元1600相比,lstm单元1700将需要其1/4的空间用于vmm和激活函数块。
109、还可理解,lstm单元通常将包括多个vmm阵列,每个vmm阵列使用由vmm阵列之外的某些电路区块(诸如求和器和激活函数块以及高电压生成块)提供的功能。为每个vmm阵列提供单独的电路区块将需要半导体设备内的大量空间,并且将在一定程度上是低效的。因此,下文所描述的示例减小vmm阵列本身之外存在的电路。
110、栅控递归单元
111、模拟vmm具体实施可用于栅控递归单元(gru)系统。gru是递归神经网络中的栅控机构。gru类似于lstm,不同之处在于gru单元一般包含比lstm单元少的组件。
112、图18描绘了示例gru 1800。该示例中的gru 1800包括单元1801、1802、1803和1804。单元1801接收输入矢量x0并且生成输出矢量h0。单元1802接收输入矢量x1、来自单元1801的输出矢量h0,并且生成输出矢量h1。单元1803接收输入矢量x2和来自单元1802的输出矢量(隐藏状态)h1并且生成输出矢量h2。单元1804接收输入矢量x3和来自单元1803的输出矢量(隐藏状态)h2,并且生成输出矢量h3。可以使用另外的单元,并且具有四个单元的gru仅仅是示例。
113、图19描绘了可用于图18的单元1801、1802、1803和1804的gru单元1900的示例具体实施。gru单元1900接收输入矢量x(t)和来自前一gru单元的输出矢量h(t-1),并且生成输出矢量h(t)。gru单元1900包括sigmoid函数设备1901和1902,每个sigmoid函数设备将0与1之间的数字应用于来自输出矢量h(t-1)和输入矢量x(t)的分量。gru单元1900还包括用于将双曲线正切函数应用于输入矢量的tanh设备1903,用于将两个矢量相乘在一起的多个乘法器设备1904、1905和1906,用于将两个矢量相加在一起的加法设备1907,以及用于从1中减去输入以生成输出的互补设备1908。
114、图20描绘了gru单元2000,该gru单元为gru单元1900的具体实施的示例。为了方便读者,在gru单元2000中使用与gru单元1900相同的编号。如图20中可见,sigmoid函数设备1901和1902以及tanh设备1903各自包括多个vmm阵列2001和激活函数块2002。因此,可以看出,vmm阵列在某些神经网络系统中使用的gru单元中特别有用。乘法器设备1904、1905和1906、加法设备1907以及互补设备1908以数字方式或模拟方式实现。激活函数块2002可以数字方式或模拟方式实现。
115、gru单元2000的替代形式(以及gru单元1900的具体实施的另一示例)在图21中示出。在图21中,gru单元2100利用vmm阵列2101和激活函数块2102,该激活函数块在被配置为sigmoid函数时应用0与1之间的数字来控制允许输入矢量中的每个分量有多少通过到达输出矢量。在图21中,sigmoid函数设备1901和1902以及tanh设备1903以时分复用方式共享相同的物理硬件(vmm阵列2101和激活函数块2102)。gru单元2100还包括用于将两个矢量相乘在一起的乘法器设备2103、用于将两个矢量相加在一起的加法设备2105、用于从1减去输入以生成输出的互补设备2109、多路复用器2104、用于当值h(t-1) r(t)通过多路复用器2104从乘法器设备2103输出时保持该值的寄存器2106、用于当值h(t-1) z(t)通过多路复用器2104从乘法器设备2103输出时保持该值的寄存器2107,以及用于当值h^(t) (1-z(t))通过多路复用器2104从乘法器设备2103输出时保持该值的寄存器2108。
116、gru单元2000包含多组vmm阵列2001和激活函数块2002,而gru单元2100包含一组vmm阵列2101和激活函数块2102,它们用于表示gru单元2100的示例中的多个层。gru单元2100将需要比gru单元2000少的空间,因为与gru单元2000相比,gru单元2100将需要其1/3的空间用于vmm和激活函数块。
117、还可以理解的是,gru系统通常将包括多个vmm阵列,每个vmm阵列使用由vmm阵列之外的某些电路区块(诸如求和器和激活函数块以及高电压生成块)提供的功能。为每个vmm阵列提供单独的电路区块将需要半导体设备内的大量空间,并且将在一定程度上是低效的。因此,下文所描述的示例减小vmm阵列本身之外存在的电路。
118、变换器
119、现有技术包括被称为变换器神经网络的概念,该变换器神经网络是神经网络的另一种架构。图63描绘了变换器神经网络6300的示例。在ashish vaswani等人的“attentionis all you need”中讨论了变换器神经网络。变换器通过注意力函数来连接编码器和解码器。注意力函数的示例是:
120、注意力(q,k,v) = softmax (qkt/)v
121、值得注意的是,变换器神经网络可使用vmm来实现。具体地,vmm可用于执行乘法(q kt) v,其中q是表示查询的矩阵,k是键矩阵,v是值矩阵,其中每个值与k中的键形成键值对。可选地,vmm是动态矩阵乘法器。
122、其他架构方面
123、vmm阵列的输入可以是模拟电平、二进制电平、脉冲、时间调制脉冲或数字位(在这种情况下,使用dac来将数字位转换为适当的输入模拟电平),并且输出可以是模拟电平、二进制电平、定时脉冲、脉冲或数字位(在这种情况下,使用输出adc来将输出模拟电平转换为数字位)。
124、一般来讲,对于vmm阵列中的每个存储器单元,每个权重w可由单个存储器单元或由差分单元或由两个混合存储器单元(2个单元的平均值)来实现。在差分单元的情况下,使用两个存储器单元来实现权重w作为差分权重(w = w+ - w-)。在两个混合存储器单元中,使用两个存储器单元来实现权重w作为两个单元的平均值。
125、图31描绘了vmm系统3100。在一些示例中,存储在vmm阵列中的权重w被存储为差分对w+(正权重)和w-(负权重),其中w = (w+) - (w-)。在vmm系统3100中,位线的一半被指定为w+线,即连接到将存储正权重w+的存储器单元的位线,并且位线的另一半被指定为w-线,即连接到实现负权重w-的存储器单元的位线。w-线以交替方式散布在w+线之间。减法操作由求和电路(诸如求和电路3101和求和电路3102)执行,该求和电路从w+线和w-线接收电流。w+线的输出和w-的输出组合在一起,以对于所有(w+、w-)线对的每个(w+、w-)单元对有效地给出w = w+ - w-。虽然上文已关于以交替方式散布于w+线之间的w-线进行描述,但在其他示例中,w+线和w-线可任意位于阵列中的任何地方。
126、图32描绘了另一示例。在vmm系统3210中,在第一阵列3211中实现正权重w+,并且在第二阵列3212中实现负权重w-,第二阵列3212与第一阵列分开,并且所得权重通过求和电路3213适当地组合在一起。
127、图33描绘了vmm系统3300。存储在vmm阵列中的权重w被存储为差分对w+(正权重)和w-(负权重),其中w = (w+) - (w-)。vmm系统3300包括阵列3301和阵列3302。阵列3301和阵列3302中的每个阵列中的位线的一半被指定为w+线,即连接到将存储正权重w+的存储器单元的位线,并且阵列3301和阵列3302中的每个阵列中的位线的另一半被指定为w-线,即连接到实现负权重w-的存储器单元的位线。w-线以交替方式散布在w+线之间。减法操作由求和电路(诸如求和电路3303、3304、3305和3306)执行,该求和电路从w+线和w-线接收电流。来自每个阵列3301、3302的w+线的输出和w-的输出分别组合在一起,以对于所有(w+、w-)线对的每个(w+、w-)单元对有效地给出w = w+ - w-。此外,来自每个阵列3301和阵列3302的w值可通过求和电路3307和求和电路3308进一步组合,使得每个w值是来自阵列3301的w值减去来自阵列3302的w值的结果,这意味着来自求和电路3307和求和电路3308的最终结果是两个差值的差值。
128、人工神经网络通常对大量数据进行操作,并且执行涉及矢量-矩阵乘法的大量计算。需要在相对小的空间中提供用于矢量-矩阵乘法的许多阵列。申请人先前于2022年6月23日提交了名称为“artificial neural network comprising a three-dimensionalintegrated circuit(包括三维集成电路的人工神经网络)”的美国专利申请第17/848,371号,该美国专利申请以引用方式并入本文。本技术描述了可用于实现人工神经网络的三维集成电路的各方面。这里将重复这些方面中的一些方面。
129、图34描绘了vmm系统3400的框图。vmm系统3400包括vmm阵列3401、行解码器3402、高电压解码器3403、列解码器3404、位线驱动器3405、输入电路3406、输出电路3407、控制逻辑3408和偏置发生器3409。vmm系统3400进一步包括高电压生成块3410,该高电压生成块包括电荷泵3411、电荷泵调节器3412和高电压模拟精密电平发生器3413。vmm系统3400进一步包括(编程/擦除,或权重调谐)算法控制器3414、模拟电路3415、控制引擎3416(其可包括诸如算术函数、激活函数、嵌入式微控制器逻辑等函数,但不限于此)和测试控制逻辑3417。
130、输入电路3406可包括电路,诸如dac(数模转换器)、dpc(数字-脉冲转换器、数字-时间调制脉冲转换器)、aac(模拟-模拟转换器,诸如电流-电压转换器、对数转换器)、pac(脉冲-模拟电平转换器)或任何其他类型的转换器。输入电路3406可实现归一化、线性或非线性上/下缩放函数或算术函数中的一者或多者。输入电路3406可实现针对输入电平的温度补偿函数。输入电路3406可实现激活函数,诸如relu或sigmoid。
131、输出电路3407可包括电路,诸如adc(模数转换器,用于将神经元模拟输出转换成数字位)、aac(模拟到模拟转换器,诸如电流到电压转换器、对数转换器)、apc(模拟到脉冲转换器、模拟到时间调制脉冲转换器)或任何其他类型的转换器。输出电路3407可实现激活函数,诸如已修正的线性激活函数(relu)或sigmoid。输出电路3407可实现针对神经元输出的统计归一化、正则化、上/下缩放/增益函数、统计舍入或算术函数(例如,加法、减法、除法、乘法、移位、对数)中的一者或多者。输出电路3407可实现针对神经元输出或阵列输出(诸如位线输出)的温度补偿函数,以便保持阵列的功率消耗大致恒定,或诸如通过使iv斜率保持大致相同来提高阵列(神经元)输出的精度。
132、3d vmm系统架构
133、图35描绘了3d vmm系统3500,其包括多个裸片,诸如裸片3501、3502、3503、3504、3505和3506,这些裸片竖直堆叠在封装3522内以形成封装集成电路。3d vmm系统3500包括某些功能块,这些功能块功能上类似于包含在图34中的vmm系统3400中的块,但这些块可位于不同的裸片上。此处,包含在裸片3501和3502中的组件共享包含在裸片3503、3504、3505和3506中的组件。
134、在该示例中,裸片3501包含相应vmm阵列3507(功能上类似于图34中的vmm 3401)、相应输入多路复用器3509、相应行缓冲器3523(其可例如向阵列输入提供采样保持缓冲电压)、相应高电压解码器3508(功能上类似于图34中的高电压解码器3403)和相应神经元电路3510(其可例如执行阵列输出电流的缩放函数、最小/最大极限函数、差分输出转换、缓冲,但不限于此)。输入多路复用器3509接收模拟输入信号并且将其施加到vmm阵列3507,并且神经元电路3510接收表示来自vmm阵列3507的神经元输出的模拟输出信号。输出信号可被传送到3d vmm系统3500内的其他块。
135、裸片3502还包含相应vmm阵列3507、相应输入多路复用器3509、相应行缓冲器3522、相应高电压解码器3508和相应神经元电路3510。
136、在该示例中,两个裸片(裸片3501和3502)包含相应vmm阵列3507,但应当理解,可包括包含相应vmm阵列的附加裸片。
137、裸片3503包含高电压发生器3511(功能上类似于图34中的高电压生成块3410)、模拟电路3512(功能上类似于图34中的模拟电路3415)和温度补偿电路3513。3d vmm系统3500可具有2d vmm系统3400不具有的热挑战。由于裸片3501、3502、3503、3504、3505和3506以竖直配置堆叠并且包含不同类型的电路,因此每一裸片在操作期间可经历不同的热操作条件。例如,某个裸片将变得比其他裸片热,并且温度增加的速率可在裸片之间变化。这引入了由于热变化而导致不准确的可能性。温度补偿电路3513补偿在各个裸片之间经历的温度变化。可选地,一个或多个热传感器位于每个相应裸片上以向温度补偿电路3513提供温度数据。温度补偿电路3513然后改变微调或配置设置以补偿温度的任何变化。温度补偿电路3513还补偿每个裸片的温度变化,例如以补偿单元电流随温度的变化,诸如使得所得位线(神经元)电流随温度大致相同。温度补偿电路3513还用于神经元电路3510、dac和adc电路,以便使得操作动态范围(例如,dac的输出范围、adc的输入范围、神经元电路3510的输出范围)随温度大致相同。
138、裸片3504包含输入电路3514(功能上类似于输入电路3406),其包括地址解码电路3524、行寄存器3525(保持阵列行的激活输入值)和数模转换器(dac)3515。dac 3515从行寄存器3525接收数字信号并且将其转换成模拟信号。
139、裸片3505包含模数转换器(adc)3516。adc 3516接收模拟信号并且将其转换成数字信号。
140、裸片3506包含数字电路3517、静态随机存取存储器(sram)3518、寄存器3519、物理i/o连接部3520、数字加速器3531和片上网络(noc)3715。裸片3506为其他裸片提供控制功能。数字电路3517可包括数字逻辑、微控制器、simd(单指令多数据)处理器和处理器。sram3518和寄存器3519可用于存储由数字电路3517或其他电路或3d vmm系统3500中的块使用的系统信息和配置信息。物理i/o连接部3520向vmm系统3500之外的设备(诸如外部处理单元)或另一封装3522提供io接口。数字加速器3531用于可能需要附加处理的某些神经网络或神经网络内的某些层,诸如当存在小的激活大小时,其中存储在单元中的权重是动态的而非固定的,其中需要执行mac操作,但不限于此。_.noc 3715例如通过生成控制信号以使信号从一个块路由到另一个块来提供3d vmm系统3500内的网络路由功能。
141、多个裸片中的相应裸片通过竖直接口3521连接到多个裸片内的一个或多个其他裸片,该竖直接口3521分别将两个或更多个裸片连接在一起。在一个示例中,竖直接口3521被实现为穿硅通孔(tsv)。
142、在3d vmm系统3500的读取操作期间,由输入电路3514接收数字输入。数字输入启用行寄存器3525,其存储激活输入并且响应于数字输入而将选定激活输入施加到dac3515,该dac将来自行寄存器3525的数字输出转换成相应模拟信号。由dac 3515产生的模拟信号由输入电路3514通过一个或多个竖直接口3521提供给裸片3501、3502中的一者或多者上的输入多路复用器3509和行缓冲器3523,该行缓冲器然后将信号施加到相应vmm阵列3507中的一个或多个行,从而导致由vmm阵列3507生成输出。来自相应vmm阵列3507的输出由相应神经元电路3510接收,该相应神经元电路提供缓冲功能以驱动其连接到的一个或多个竖直接口3521的寄生电容。神经元电路3510通过一个或多个竖直接口3521向裸片3505上的adc 3516提供模拟信号,该adc 3516将模拟信号转换成数字信号。另选地,模拟信号可绕过adc 3516并且保持模拟形式。adc 3516的输出通过物理i/o 3520被提供给3d vmm系统3500外部的设备(诸如处理单元或图形处理单元),或者作为输入被施加到相应vmm阵列3507(表示人工神经网络中的另一层)。另选地,来自神经元电路3510的模拟信号可绕过adc3516并且保持模拟形式并且作为输入被施加到相应vmm阵列3507。
143、图36描绘了包括封装3622的3d vmm系统3600。3d vmm系统3600类似于3d vmm系统3500,并且包含许多相同组件,除了组件和某些附加组件的布置方面的一些差异。与图35中相同的项目包含与图36中相同的项目编号。此处,包含在裸片3601和3602中的组件共享包含在裸片3603、3604、3605和3606中的组件。
144、3d vmm系统3600包括多个裸片,诸如裸片3601、3602、3603、3604、3605和3606,这些裸片竖直堆叠在公共封装3522内以形成封装集成电路。
145、在该示例中,裸片3601包含相应vmm阵列3507、相应输入多路复用器3509、相应寄存器3524(保持阵列行的激活输入值)、相应行缓冲器3523、相应高电压多路复用器3608和相应列多路复用器3610。
146、裸片3602还包含相应vmm阵列3507、相应输入多路复用器3509、相应寄存器3524、相应行缓冲器3523、相应高电压多路复用器3608和列多路复用器3610。
147、在该示例中,两个裸片(裸片3601和3602)包含相应vmm阵列3507,但应当理解,可包括包含vmm阵列的附加裸片。
148、裸片3603包含高电压发生器3511、模拟电路3512、温度补偿电路3513和高电压多路复用器3608。
149、裸片3604包含输入电路3614,其包括地址解码3524和dac 3515。
150、裸片3605包含神经元电路3510和adc 3516。
151、裸片3606包含数字电路3517、sram 3518、寄存器3519和物理i/o连接部3520。
152、多个裸片中的相应裸片通过相应竖直接口3521连接到多个裸片内的一个或多个其他裸片。
153、在3d vmm系统3600的读取操作期间,由输入电路3614接收输入并且接收地址。地址解码器3524对地址进行解码,并且通过一个或多个竖直接口3521向对应于解码地址的相应行寄存器3525提供输入。相应行寄存器3525的输出通过一个或多个竖直接口3521耦合到dac 3515,该dac将从行寄存器3525接收的数字输出位转换成模拟信号,并且通过一个或多个竖直接口3521向相应输入多路复用器3509和行缓冲器3523提供模拟信号。行缓冲器3523将缓冲的模拟信号施加到选定行的相应vmm阵列3507的行输入(诸如阵列控制栅或字线)。来自相应vmm阵列3507(诸如来自阵列位线)的输出由相应列多路复用器3610接收,并且相应列多路复用器3610的输出通过一个或多个竖直接口3521向裸片3605上的adc 3516提供信号,该adc将模拟信号转换成数字信号。另选地,信号可绕过adc 3516并且保持模拟形式。adc 3516的输出通过一个或多个竖直接口3521被提供给裸片3606上的数字电路3517(其可执行激活函数、池化函数或其他网络函数),并且数字电路3517的输出可通过裸片3606上的物理i/o 3520被提供给3d vmm系统3600外部的设备(诸如处理单元或图形处理单元),或者通过相应竖直接口3521被提供给裸片3604上的输入电路3614作为到另一相应vmm阵列3507(表示人工神经网络中的另一层)的输入。
154、图37a描绘了3d vmm系统3700,其包括两个或更多个竖直堆叠中的多个裸片。在该示例中,第一竖直堆叠包括裸片3701、3702、3703、3704、3705和3706,并且第二竖直堆叠包括裸片3707、3708、3709、3710、3711和3712,这些裸片中的所有裸片包含在公共封装3522中以形成单个封装集成电路。在一个示例中,第一竖直堆叠中的裸片为与第二竖直堆叠中的裸片物理分离的裸片。在另一示例中,第一竖直堆叠中的裸片和第二竖直堆叠中的裸片为相同的物理裸片(意味着例如裸片3701和3707为相同的裸片)。此处,包含在裸片3701和3702中的组件共享包含在裸片3703、3704、3705和3706中的组件,并且包含在裸片3707和3708中的组件共享包含在裸片3709、3710、3711和3712中的组件。
155、在所示的示例中,裸片3701和裸片3707各自包含相应vmm阵列3507、相应阵列输入3729(其包括相应输入多路复用器3509、相应地址解码器3713、相应行寄存器3525和相应行缓冲器3523)、相应高电压多路复用器3608和相应神经元电路3510。
156、裸片3702和裸片3708还各自包含相应vmm阵列3507、相应阵列输入3729(其包括相应输入多路复用器3509、相应地址解码器3713、相应行寄存器3525和相应行缓冲器3523)、相应高电压多路复用器3608和相应神经元电路3510。
157、在该示例中,四个裸片(裸片3701、3702、3707和3708)包含相应vmm阵列3507,但应当理解,可包括包含vmm阵列的附加裸片。
158、裸片3703和裸片3709各自包含相应高电压解码器3714、相应高电压发生器3511、相应模拟电路3512和相应温度补偿电路3513。
159、裸片3704和裸片3710各自包含相应输入电路3514,其包括相应dac 3515。
160、裸片3705和裸片3711各自包含相应adc 3516。
161、裸片3706和裸片3712各自包含相应数字电路3517、相应sram 3518、相应寄存器3519、相应物理i/o连接部3520和相应noc(片上网络)连接部3715。
162、多个裸片中的相应裸片通过一个或多个竖直接口3521或水平接口3716连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口分别将两个或更多个裸片连接在一起。在一个示例中,竖直接口3521相应地为穿硅通孔(tsv)。在一个示例中,水平接口3716相应地为重新分布层(rdl)连接部。
163、在3d vmm系统3700的读取操作期间,数字输入由相应输入电路3514接收,该相应输入电路经由其相应dac 3515将数字输入转换成模拟信号,并且相应dac 3515的输出经由相应竖直接口3521和/或水平接口3716耦合到相应阵列输入3729的行寄存器3525。相应阵列输入3729的行寄存器3525的输出被提供给输入多路复用器3509和行缓冲器3523,该行缓冲器然后将信号施加到vmm阵列3507中的一个或多个行。来自相应vmm阵列3507的输出由相应神经元电路3510接收,该神经元电路3510提供缓冲功能以驱动其连接到的一个或多个竖直接口3521或水平接口3716的寄生电容。神经元电路3510通过一个或多个竖直接口3521或水平接口3716向相应adc 3516提供缓冲的模拟信号,该adc将模拟信号转换成数字信号。adc 3516的输出被提供给相应数字电路3517(其执行激活函数、池化函数或网络函数),并且相应数字电路3517的输出可通过相应物理i/o 3520被提供给3d vmm系统3700外部的设备(诸如处理单元或图形处理单元)或者被提供给相应输入电路3514以由相应dac 3515转换,并且相应输入电路3514的输出耦合到另一vmm阵列3507(表示人工神经网络中的另一层)或者通过相应物理i/o 3520耦合到另一封装3522。=
164、图37b描绘了3d vmm系统3750,其类似于3d vmm系统3750,不同之处在于其具有在裸片3758上示出为vmm阵列3557的另一类型的vmm阵列,该vmm阵列3557包括静态ram单元或动态ram单元。
165、图38描绘了3d vmm系统3800,其包括两个竖直堆叠中的多个裸片。可以具有多于两个堆叠。在该示例中,第一竖直堆叠包括裸片3801、3802、3803、3804、3805和3806,并且第二竖直堆叠包括裸片3807、3808、3809、3810、3811和3812,这些裸片中的所有裸片包含在公共封装3522中以形成单个封装集成电路。在一个示例中,第一竖直堆叠中的裸片为与第二竖直堆叠中的裸片物理分离的裸片。在另一示例中,第一竖直堆叠中的裸片和第二竖直堆叠中的裸片为相同的物理裸片(意味着例如裸片3801和3807为相同的裸片)。此处,包含在裸片3801和3802中的组件共享包含在裸片3803、3804、3805和3806中的组件,并且包含在裸片3807和3808中的组件共享包含在裸片3809、3810、3811和3812中的组件。
166、在所示的示例中,裸片3801、3802、3807和裸片3808各自包含相应vmm阵列3507、相应阵列输入3729、相应高电压多路复用器3608、相应列多路复用器3610和相应阵列输入电路3729。相应阵列输入3729包括输入多路复用器3509、地址解码器3713、行寄存器3524和行缓冲器3523。
167、在该示例中,四个裸片(裸片3801、3802、3807和3808)包含vmm阵列,但应当理解,可包括包含vmm阵列的附加裸片。
168、裸片3803和裸片3809分别包含高电压解码器3714、高电压发生器3511、模拟电路3512和温度补偿电路3513。
169、裸片3804和裸片3810分别包含包括dac 3515的输入电路3514。
170、裸片3805和裸片3811分别包含adc 3516和神经元电路3510。
171、裸片3806和裸片3812分别包含数字电路3517、sram 3518、寄存器3519、物理i/o连接部3520和noc连接部3715。
172、多个裸片通过一个或多个竖直接口3521或水平接口3716分别连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口分别将两个或更多个裸片连接在一起。在一个示例中,相应竖直接口3521被实现为穿硅通孔(tsv)。在一个示例中,相应水平接口3716被实现为重新分布层(rdl)连接部。
173、在3d vmm系统3800的读取操作期间,数字输入由输入电路3514接收,该输入电路使用dac 3515来将数字输入转换成模拟形式并且经由相应竖直接口3521和/或水平接口3716向相应阵列输入电路3729提供模拟信号。阵列输入电路3729从输入电路接收模拟信号和地址,并且然后响应于地址而将模拟信号施加到vmm阵列3507中的选定行。来自vmm阵列3507的输出由列多路复用器3610接收,该列多路复用器通过一个或多个竖直接口3521或水平接口3716向adc 3516提供模拟信号,该adc将模拟信号转换成数字信号。另选地,模拟信号可绕过adc 3516并且保持模拟形式。adc 3516的输出通过一个或多个竖直接口3521或水平接口3716被提供给数字电路3517(其可执行激活函数、池化函数或其他网络函数),并且数字电路3517的输出可通过物理i/o 3520被提供给3d vmm系统3800外部的设备(诸如处理单元或图形处理单元),或者被提供给其他vmm阵列3507(表示人工神经网络中的另一层)的输入电路3514,或者通过物理i/o 3520被提供给另一封装3522。
174、图39a描绘了3d vmm系统3900,其包括两个竖直堆叠中的多个裸片。在该示例中,第一竖直堆叠包括裸片3901、3902、3903和3904,并且第二竖直堆叠包括裸片3905、3906、3907和3908,这些裸片中的所有裸片包含于公共封装3522中以形成单个封装集成电路。在一个示例中,第一竖直堆叠中的裸片为与第二竖直堆叠中的裸片物理分离的裸片。在另一示例中,第一竖直堆叠中的裸片和第二竖直堆叠中的裸片为相同的物理裸片(意味着例如裸片3901和3905为相同的裸片)。此处,包含在裸片3901和3902中的组件共享包含在裸片3903和3904中的组件,并且包含在裸片3905和3906中的组件共享包含在裸片3907和3908中的组件。
175、在所示的示例中,裸片3901、3902、3905和裸片3906分别包含vmm阵列3507、阵列输入3729、高电压多路复用器3608和列多路复用器3610。
176、在该示例中,四个裸片(裸片3901、3902、3903和3904)包含vmm阵列,但应当理解,可包括包含vmm阵列的附加裸片。
177、裸片3903和裸片3907分别包含高电压解码器3714、高电压发生器3511、模拟电路3512、温度补偿电路3513、包括dac 3515的输入电路3514、神经元电路3510和adc 3516。
178、裸片3904和裸片3908分别包含数字电路3517、sram 3518、寄存器3519、物理i/o连接部3520和noc连接部3715。
179、多个裸片通过一个或多个竖直接口3521或水平接口3716分别连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口分别将两个或更多个裸片连接在一起。
180、在3d vmm系统3900的读取操作期间,数字输入由输入电路3514接收,该输入电路3514使用dac 3515来将数字输入转换成模拟形式并且经由相应竖直接口3521和/或水平接口3716向相应阵列输入电路3729提供模拟信号。阵列输入电路3729从输入电路接收模拟信号和地址,并且响应于所接收的地址而将模拟信号施加到vmm阵列3507中的选定行。来自vmm阵列3507的输出由列多路复用器3610接收,该列多路复用器通过一个或多个竖直接口3521或水平接口3716向adc 3516提供模拟信号,该adc将模拟信号转换成数字信号。另选地,模拟信号可绕过adc 3516并且保持模拟形式。adc 3516的输出经由相应竖直接口3521和/或水平接口3716被提供给数字电路3517,并且然后通过物理i/o 3520被提供给3d vmm系统3900外部的设备(诸如处理单元或图形处理单元)或者被提供给输入电路3514以作为输入被施加到vmm阵列3507(表示人工神经网络中的另一层)或者通过物理i/o 3520被提供给另一封装3522。
181、图39b描绘了类似于图39a的3d vmm系统3950,不同之处在于裸片3951、3952、3955和3956现在具有输入电路3514和阵列输入3729两者。3d vmm系统3950包括封装3522和裸片3951、3952、3953、3954、3955、3956、3957和3958。多个裸片通过一个或多个竖直接口3521或水平接口3716分别连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口分别将两个或更多个裸片连接在一起。
182、图39c描绘了3d vmm系统3980,其包括两个竖直堆叠中的多个裸片。在该示例中,第一竖直堆叠包括裸片3981、3982、3983,并且第二竖直堆叠包括裸片3984、3985和3986,这些裸片中的所有裸片包含在公共封装3522中以形成单个封装集成电路。在一个示例中,第一竖直堆叠中的裸片为与第二竖直堆叠中的裸片物理分离的裸片。在另一示例中,第一竖直堆叠中的裸片和第二竖直堆叠中的裸片为相同的物理裸片(意味着例如裸片3981和3984为相同的裸片)。此处,包含在裸片3981和3982中的组件共享包含在裸片3983中的组件,并且包含在裸片3984和3985中的组件共享包含在裸片3986中的组件。
183、在所示的示例中,裸片3981、3982、3984和裸片3985分别包含vmm阵列3507、高电压块3991、输入块3990、输出块3992和模拟块3993。输入块3990可包括输入电路3514、dac3515、阵列输入电路3729。高电压块3991可包括高电压多路复用器3608和高电压解码器3714。输出块3992可包括列多路复用器3610、神经元电路3510和adc 3516。模拟块3993可包括高电压发生器3511、模拟电路3512和温度补偿电路3513。
184、裸片3983和裸片3986各自包含数字电路3517、sram 3518、寄存器3519、物理i/o连接部3520、数字加速器3521(以数字方式用于多重和累积(mac)功能)和noc连接部3715。
185、多个裸片通过一个或多个竖直接口3521或水平接口3716分别连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口中的每一者分别将两个或更多个裸片连接在一起。
186、图40描绘了3d vmm系统4000,其包括两个竖直堆叠中的多个裸片。在该示例中,第一竖直堆叠包括裸片4001、4002、4003和4004,并且第二竖直堆叠包括裸片4005、4006、4007和4008,这些裸片中的所有裸片包含于公共封装3522中以形成单个封装集成电路。在一个示例中,第一竖直堆叠中的裸片为与第二竖直堆叠中的裸片物理分离的裸片。在另一示例中,第一竖直堆叠中的裸片和第二竖直堆叠中的裸片为相同的物理裸片(意味着例如裸片4001和4005为相同的裸片)。此处,包含在裸片4001和4002中的组件共享包含在裸片4003和4004中的组件,并且包含在裸片4005和4006中的组件共享包含在裸片4007和4008中的组件。
187、在所示的示例中,裸片4001、4002、4005和4006分别包含vmm阵列3507、阵列输入4029(其包括输入多路复用器3509和/或解码器3713——未示出)、高电压多路复用器3608和列多路复用器3610。
188、在该示例中,四个裸片(裸片4001、4002、4003和4004)包含vmm阵列,但应当理解,可包括包含vmm阵列的附加裸片。
189、裸片4003和裸片4007分别包含高电压解码器3714、高电压发生器3511、模拟电路3512、温度补偿电路3513和神经元电路3510。
190、裸片4004和裸片4008分别包含数字电路3517、sram 3518、寄存器3519、物理i/o连接部3520和noc连接部3715。
191、与vmm系统3900不同,vmm系统4000不包含dac 3515和adc 3516,因为输入和输出保持为模拟形式并且不在模拟形式与数字形式之间转换。
192、多个裸片通过一个或多个竖直接口3521或水平接口3716分别连接到多个裸片内的一个或多个其他裸片,该一个或多个竖直接口或水平接口分别将两个或更多个裸片连接在一起。
193、在3d vmm系统4000的读取操作期间,模拟输入(诸如电压、电流或基于定时的实体,诸如脉冲序列)由相应阵列输入4029接收,该阵列输入然后将信号施加到相应vmm阵列3507中的一个或多个行。来自相应vmm阵列3507的输出由列多路复用器3610接收,该列多路复用器通过一个或多个竖直接口3521或水平接口3716向相应神经元电路3510提供模拟信号(诸如电压、电流或基于定时的实体),该神经元电路3510通过物理i/o 3520向3d vmm系统4000外部的设备(诸如处理单元或图形处理单元)或另一封装3522或者向其他vmm阵列3507(表示人工神经网络中的另一层)的阵列输入4029提供缓冲信号。
194、图41至图44描绘了关于vmm阵列3507的示例配置的附加细节。图41至图44分别描绘了3d vmm系统4100、4200、4300和4400。3dd vmm系统4100、4200、4300和4400中的每一者包括公共封装(未示出)中的第一裸片上的vmm阵列3507-1和第二裸片上的vmm阵列3507-2。vmm阵列3507-1和3507-2分别包含按m+1行和n+1列布置的非易失性存储器单元的阵列。相应行耦合到标记为cg0、……、cgm的控制栅线中的一者,并且相应列耦合到标记为bl0、……、bln的位线中的一者。单元位于位线与控制栅线的交汇处。例如,单元4101mn位于行m和列n中并且耦合到vmm阵列3507-1中的cgm和bln,并且单元4102mn位于行m和列n中并且耦合到vmm阵列3507-2中的cgm和bln。由于vmm阵列3507-1和3507-2位于不同的裸片上,因此它们可选地可使用不同的半导体工艺来制造。不管使用相同还是不同的半导体工艺来制造vmm阵列3507-1和3507-2,vmm阵列3507-1中的单元可存储与vmm阵列3507-2中的单元不同数量的位。例如,vmm阵列3507-1中的单元(诸如单元4101mn)可存储i个位,而vmm阵列3507-2中的单元(诸如单元4102mn)可存储j个位,其中i和j是不同值的整数。例如,i可以是3(意味着vmm阵列3507-1中的单元相应地存储3位值),并且j可以是5(意味着vmm阵列3507-2中的单元相应地存储5位值)。
195、在图41中,通过控制栅线分别向vmm阵列3507-1和3507-2提供输入,并且在位线上分别获得输出。图41描绘了示例单元4101mn和4102mn。可选地,如果需要,可在其他地方组合输出,诸如通过使用adc 3516(如在先前附图中所示)来将它们转换成数字形式,并且使用数字电路3517(如在先前附图中所示)来将它们相加在一起。
196、在图42中,通过控制栅线分别向vmm阵列3507-1和3507-2提供输入。在第一组位线上获得vmm阵列3507-1的输出,并且在第二组位线上获得vmm阵列3507-2的输出,其中第一组位线通过相应竖直接口3521耦合到第二组位线,这有效地将输出信号以模拟形式相加在一起。可选地,如果需要,可在其他地方数字化组合的模拟输出,诸如通过使用adc 3516(如在先前附图中所示)来将它们转换成数字形式。
197、在图43中,通过第一组控制栅线向vmm阵列3507-1提供输入,并且通过第二组控制栅线向vmm阵列3507-2提供输入,其中第一组控制栅线通过相应竖直接口3521耦合到第二组控制栅线,并且在位线上分别获得输出。可选地,如果需要,可在其他地方组合输出,诸如通过使用adc 3516(如在先前附图中所示)来将它们转换成数字形式,并且使用数字电路3517(如在先前附图中所示)来将它们相加在一起。
198、在图44中,通过控制栅线、通过竖直接口3521共同向vmm阵列3507-1和3507-2提供输入。在位线上获得输出,这些输出通过竖直接口3521组合在一起,这有效地将信号以模拟形式相加在一起。可选地,如果需要,可在其他地方数字化组合的模拟输出,诸如通过使用adc 3516(如在先前附图中所示)来将它们转换成数字形式。
199、图45至图48描绘了裸片、竖直接口和水平接口的结构布局选项的示例。
200、图45描绘了3d vmm系统4500,其包括以竖直配置布置并且通过竖直接口3521连接的第一组裸片(裸片4501、4502、4503和4504)以及以竖直配置布置并且通过竖直接口3521连接的第二组裸片(裸片4505、4506、4507和4508)。此处,一个裸片可通过竖直接口3521中的相应竖直接口连接到两个其他裸片。
201、图46描绘了3d vmm系统4600,其包括以竖直交错配置布置的四个层级的裸片,其中第一层级包括裸片4601和4602,第二层级包括裸片4603、4604和4605,第三层级包括裸片4606和4607,并且第四层级包括裸片4608、4609和4610。不同层级中的裸片通过相应竖直接口3521连接到上方层级中的裸片和下方层级中的裸片。此处,一个裸片可通过竖直接口3521中的相应竖直接口连接到四个其他裸片。
202、图47描绘了3d vmm系统4700,其包括以竖直交错配置布置的四个层级的裸片,其中第一层级包括裸片4701和4702,第二层级包括裸片4703、4704和4705,第三层级包括裸片4706和4707,并且第四层级包括裸片4708、4709和4710。不同层级中的裸片通过相应竖直接口3521连接,并且相同层级中的裸片通过相应水平接口3716连接。此处,一个裸片可通过竖直接口3521中的相应竖直接口并且通过水平接口3716中的相应水平接口连接到六个其他裸片。
203、图48描绘了3d vmm系统4800的物理布局的示例,其中示出了连接器4801。连接器4801位于裸片中并且连接到一个或多个竖直接口3521和水平接口3716。如可见的,裸片和接口可被布置成使得连接器4801以竖直交错配置定位。
204、随着三维集成电路变得越来越大以满足人工神经网络的计算需求,需要一种新的接口电路来实现三维结构中的各个裸片之间以及裸片与三维结构外部的设备(诸如服务器或处理器)之间的高效通信。
技术实现思路
1、公开了一种用于包括三维集成电路的人工神经网络的接口电路的许多示例。
2、在一个示例中,一种系统包括:第一设备;第一接口,该第一接口耦合到该第一设备并且包括一个或多个设备控制线以标识多个设备内的旨在针对其进行通信的第二设备,该多个设备分别包含矢量-矩阵乘法阵列;和堆叠,该堆叠包括耦合到该第一接口、该多个设备和包括符合传统标准的线的第二接口的接口电路,该第二接口耦合在该接口电路与该多个设备之间。
3、在另一示例中,一种方法包括:由接口电路通过第一接口从第一设备接收第一通信,该第一接口包括一个或多个设备控制线以标识多个设备内的旨在针对其进行通信的第二设备,该多个设备分别包含矢量-矩阵乘法阵列;由该接口电路将该第一通信转换成第二通信;以及由该接口电路通过包括符合传统标准的线的第二接口将该第二通信传送到该多个设备中的一个或多个设备。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com