
一种面向星载操作系统的Rust容器状态管理方法及系统与流程
本发明涉及容器资源管理领域,尤其是涉及一种面向星载操作系统的rust容器状态管理方法及系统。
背景技术:
1、随着国产化cpu和gpu等硬件资源的快速发展,国产操作系统在各行各业的应用逐渐广泛。国产化硬件搭载国产星载操作系统成为航天技术发展的重要方向。
2、星载操作系统受空间资源的严格限制,在采用容器技术搭配gpu卡部署大模型、构建通用计算容器集群时,无法像地面系统一样进行图形化管理容器镜像和实时调控设备资源。资源调度策略不合理会导致容器资源分配失衡,部分容器资源过剩,而核心业务容器资源匮乏,不仅会降低系统的整体性能,还会导致应用程序运行不稳定,甚至影响其它非容器类业务的正常运行。
3、因此,如何在星载场景下实现容器资源的精细化、动态化管控,确保核心业务容器的资源保障,并避免单容器故障影响整个系统运行,成为亟待解决的技术问题。
技术实现思路
1、为了解决现有技术中星载场景下容器资源管控困难、调度策略不合理导致系统性能下降及稳定性不足的问题,本发明提供一种面向星载操作系统的rust容器状态管理方法及系统,通过基于rust语言开发的核心守护进程,结合cgroups v2特性实现容器资源的精准采集、动态调度与故障自动化处理。
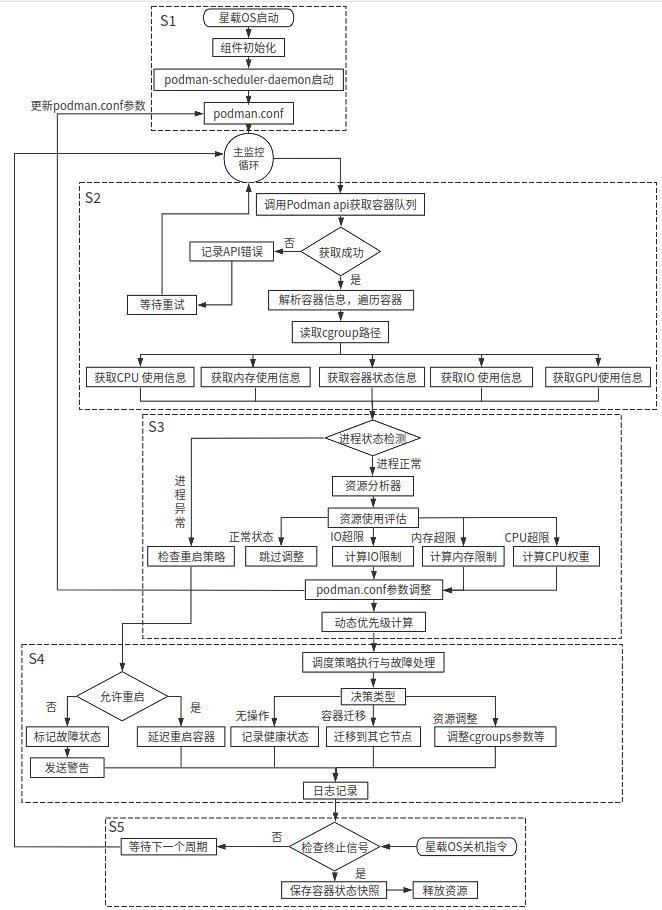
2、在本发明的第一方面,提供了一种面向星载操作系统的rust容器状态管理方法。该方法包括:
3、步骤s1、系统初始化:星载操作系统启动后,内核启用cgroups v2特性并挂载cgroup控制器;读取podman.conf配置文件获取资源监控参数;启动基于rust语言开发的podman-scheduler-daemon守护进程,初始化各资源采集单元;
4、步骤s2、podman容器资源获取:调用podman api获取容器元数据并提取cgroupsv2路径,读取cgroups v2内核文件获取容器cpu、内存、i/o、gpu全维度资源使用情况;
5、步骤s3、资源分析与调度策略生成:基于资源使用情况进行进程状态判断,对进程正常的容器进行资源使用阈值评估,将资源使用率与podman.conf中的预设阈值对比,针对不同超限类型计算新的资源限制参数,并执行动态优先级计算生成调度策略;
6、步骤s4、决策执行与故障处理:根据所述调度策略和容器状态,执行资源调整或故障处理,包括进程异常处理、资源超限处理、内存泄漏处理、i/o异常处理及gpu故障处理;
7、步骤s5、资源清理:容器终止后释放所占用的cpu、内存、i/o、gpu资源,返回监控状态等待下一监控周期。
8、通过采用上述技术方案,本发明利用rust语言的内存安全特性保障守护进程在高并发调度场景下的稳定运行,通过cgroups v2内核接口实现全维度资源精准采集,结合星载定制化配置与遥测技术,实现了星载场景下容器资源的动态、智能调度,确保核心业务容器的资源保障,避免单容器故障影响整个系统运行。
9、可选的,所述步骤s2包括:
10、获取容器队列及运行状态:调用podman api获取容器元数据,解析元数据中的cgrouppath字段并提取各容器的cgroups v2绝对路径,验证容器实际运行状态并过滤非运行态容器;
11、获取cpu使用率:读取容器cgroups v2目录下cpu.stat文件,通过两次采样获取cpu时间增量,结合cpu核数计算cpu使用率;
12、获取内存使用率:读取容器cgroup v2目录下的memory.current和memory.max,计算内存使用率;
13、获取i/o使用率:读取容器cgroup v2目录下的io.stat文件,通过两次采样差值计算单位时间i/o速率,结合io.max中的读写带宽上限计算i/o使用率;
14、获取容器基础状态信息:读取容器cgroup v2目录下的cgroups.procs文件获取容器内所有进程id,结合/proc/[pid]/cmdline和/proc/[pid]/status获取进程状态信息;
15、获取gpu资源使用情况:通过cgroups v2 gpu子系统内核文件读取gpu卡使用数量、显存实际使用量、显存限制、gpu算力负载及gpu共享权重,计算gpu显存使用率和gpu算力使用率。
16、通过采用上述技术方案,实现了对容器全维度资源使用情况的精准采集,为后续资源分析与调度策略生成提供可靠的数据基础。
17、可选的,所述调用podman api获取容器元数据之后,还包括:
18、判断容器元数据是否完整;
19、若是,则解析容器元数据;
20、若否,则记录api错误,并等待重试。
21、通过采用上述技术方案,提高了容器状态采集的鲁棒性,避免因api瞬时异常导致的数据缺失。
22、可选的,所述cpu使用率的计算公式为:
23、cpu使用率=(cpu时间增量/(采样间隔cpu核数))100%;
24、所述内存使用率的计算公式为:
25、内存使用率=(memory.current/memory.max)100%;
26、所述i/o使用率的计算公式为:
27、读速率=(read2-read1)/采样时间间隔;
28、写速率=(write2-write1)/采样时间间隔;
29、容器读使用率=(读速率/读带宽上限)100%;
30、容器写使用率=(写速率/写带宽上限)100%;
31、其中,read1 和write1为第一次采样值,read2 和write2为第二次采样值;
32、所述gpu显存使用率的计算公式为:
33、gpu显存使用率的计算公式为:
34、gpu显存使用率=(显存实际使用量/显存限制)100%;
35、gpu算力使用率计算公式为:
36、gpu算力使用率=(实际gpu算力负载/预设gpu最大负载上限)100%。
37、通过采用上述技术方案,为资源使用阈值评估提供了量化的计算依据,确保资源使用率的准确计算。
38、可选的,所述步骤s3包括:
39、检测容器进程状态,若进程异常则直接触发故障处理流程;若进程正常则进入资源使用阈值评估环节;
40、将获取的cpu、内存、i/o、gpu资源使用率与podman.conf中的预设阈值进行对比,针对不同超限类型计算并生成新的资源限制参数;
41、结合资源超限计算结果执行动态优先级计算,生成容器调度优先级参数;
42、按照星载任务优先级排序容器,计算全维度资源缺口,核心任务优先分配资源,释放低优先级容器冗余资源,调用podman cgroup接口更新cpu、内存、i/o、gpu全维度资源限制。
43、通过采用上述技术方案,实现了容器资源的动态优先级调度和全维度资源优化配置,优先保障核心业务容器的资源供给,提升系统整体资源利用率。
44、可选的,所述步骤s4包括:
45、进程异常场景:判断容器是否满足重启条件,不满足则标记故障状态并发送遥测警告;满足则执行延迟重启,若为gpu进程异常,重启前先释放该容器占用的gpu设备和显存资源;
46、资源超限场景:根据所述调度策略执行差异化操作,包括记录健康状态、容器迁移、容器重启或资源调整;
47、gpu故障场景:针对gpu显存溢出、负载过高、硬件过热、设备故障执行自动化参数调整和业务迁移,所有操作均通过星载遥测实现。
48、通过采用上述技术方案,针对星载场景下的各类常见故障提供了自动化应急调节机制,实现单个容器故障不影响系统整体运行的可靠性目标。
49、可选的,所述gpu故障场景的处理包括:
50、gpu显存溢出:检测到容器gpu显存使用超过预设显存限制阈值时触发显存回收,关闭容器非核心算力进程并降低显存使用上限,若为共享模式gpu容器则暂停其gpu使用权限;
51、gpu负载过高或硬件过热:检测到容器gpu负载超过预设算力负载上限或星载gpu硬件温度超过预设gpu温度阈值时,降低gpu算力负载上限并将部分算力资源迁移至空闲gpu卡,若为单gpu卡则暂停低优先级gpu容器的算力使用;
52、gpu卡设备故障:检测到容器挂载的gpu卡出现硬件故障时,将容器的gpu相关业务迁移至正常gpu卡并标记故障gpu卡为不可用状态,若无备用gpu卡则将该容器切换至cpu算力降低运行模式,同时发送遥测故障警告。
53、通过采用上述技术方案,实现了gpu资源在显存溢出、负载过高及硬件故障场景下的自动化保护与业务连续性保障。
54、可选的,所述podman-scheduler-daemon基于rust语言的内存所有权和借用机制开发,以实现对podman api的高效调用,并利用rust借用检查器在编译阶段保证多线程环境下的调度稳定性。
55、通过采用上述技术方案,从根本上避免了内存泄漏、空指针及多线程数据冲突问题,保障星载环境下长时间运行的稳定性。
56、可选的,所述podman-scheduler-daemon启动后开启毫秒级循环监控,结合crc校验和数据重传技术,以解决星载环境辐射导致的数据错误问题。
57、通过采用上述技术方案,保障了星载强辐射环境下监控数据的实时性、准确性和传输可靠性。
58、在本发明的第二方面,提供了一种面向星载操作系统的rust容器状态管理系统。该系统包括硬件层、文件系统层、容器层,其中:
59、硬件层包含星载系统的硬盘、cpu、gpu硬件设备;
60、文件系统层由linux内核和星载嵌入式文件系统组成,所述内核启用cgroups v2特性提供资源隔离能力,所述星载嵌入式文件系统实现轻量化存储管理;
61、容器层包括容器启停模块和容器资源与调度模块,所述容器启停模块由podman和podman-compose组成,所述容器资源与调度模块由podman-scheduler-daemon实现,包含容器状态采集模块、资源分析器、优先级队列及决策执行器。
62、通过采用上述技术方案,通过硬件层-文件系统层-容器层的三层架构设计,适配星载操作系统的轻量化、高可靠需求,实现容器资源的端对端全流程管控。
63、综上所述,本发明包括以下至少一种有益技术效果:
64、1.基于rust语言内存安全特性,从根本上避免了内存泄漏和多线程数据冲突,保障星载环境下守护进程长期稳定运行;
65、2.通过cgroups v2内核接口直接读取与podman api调用相结合的方式,实现cpu、内存、i/o、gpu全维度资源的精准采集与动态调整;
66、3.针对星载场景定制化的配置文件与毫秒级监控机制,结合crc校验与数据重传技术,有效应对空间辐射导致的数据错误,满足星载系统高实时性与高可靠性需求;
67、4.建立涵盖内存泄漏、i/o异常、gpu显存溢出、gpu负载过高及gpu设备故障的自动化应急调节规则,实现单容器故障隔离,避免影响系统整体运行;
68、5.结合星载遥测技术支持远程状态调整与故障告警推送,适配星载系统的远程运维与无人值守需求。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com