
一种基于GPU状态感知的通用移动操作系统动态渲染控制方法及系统与流程
本发明属于操作系统图形处理,尤其涉及一种基于gpu状态感知的通用移动操作系统动态渲染控制方法及系统。
背景技术:
1、在现代图形处理中,gpu承担繁重的图形渲染任务,随着应用程序对图形质量要求的不断提高,gpu的负载也日益增加,而现有的图形渲染技术往往难以在性能与功耗之间取得良好的平衡,在高负载情况下,gpu的利用率和温度会迅速上升,这可能导致gpu性能瓶颈,进而影响图形渲染效率和帧率,出现画面卡顿、掉帧等问题,严重降低用户体验。
2、目前,针对gpu性能优化的方法有如下缺陷:(1)固定帧率机制缺陷:传统方案采用固定帧率渲染策略,在gpu过载时易导致帧率波动,造成卡顿或设备过热;(2)全局降帧策略粗放:现有降帧方案未区分渲染节点优先级,导致关键交互元素降帧影响用户体验;(3)状态感知滞后:缺乏细粒度gpu状态监控,无法实时响应瞬态负载波动。
3、基于固定且全局的策略无法根据gpu实时的利用率和温度动态并精细的调整渲染策略。而移动端操作系统作为一种直接面向用户的操作系统,其图形子系统需要更智能、高效的gpu性能优化方案,以满足多样化的应用场景和用户需求。
4、现有技术通过对cpu使用率、内存占用率和gpu使用率的加权计算,并根据策略对结果连续比较,判断如果渲染存在卡顿现象,则直接结束渲染任务。此方案虽然通过资源情况对渲染进行干预控制,但并未进行主动降帧处理,仍需要gpu参与渲染,同时未对渲染节点进行优先级区分,无法在gpu高负载下稳定、有效的运行,并保证用户体验。
5、现有技术存在以下技术问题:(1)渲染帧率调整的局限性:现有的渲染技术大多依赖于固定的阈值或简单的策略,无法根据gpu的实际状态实时的进行灵活调整,造成视觉体验严重下降;(2)全局节点控制粒度粗放:现有方案普遍采用全局节点统一降帧策略,无法区分渲染节点的优先级,这种粗粒度的调控导致关键交互节点(如视频播放)与非关键节点(如状态栏、背景特效)同等降级,无法在资源瓶颈时提升关键节点的用户体验;(3)控制策略单一化:当前策略仅依赖于gpu利用率和温度其中之一作为触发条件,维度单一,无法准确预估当前整个系统的运行状态,容易产生策略误判;(4)资源状态感知滞后:在渲染过程中触发是否存在瓶颈并启用策略,感知滞后同时无法在渲染前决定渲染策略,导致仍然持续占用已出现瓶颈状态的gpu资源。
技术实现思路
1、针对现有技术中存在的技术问题,本发明提供一种基于gpu状态感知的通用移动操作系统动态渲染控制方法及系统,除针对openharmony操作系统的图形子系统外,也适用于其他移动端操作系统及物联网设备的图形渲染优化。
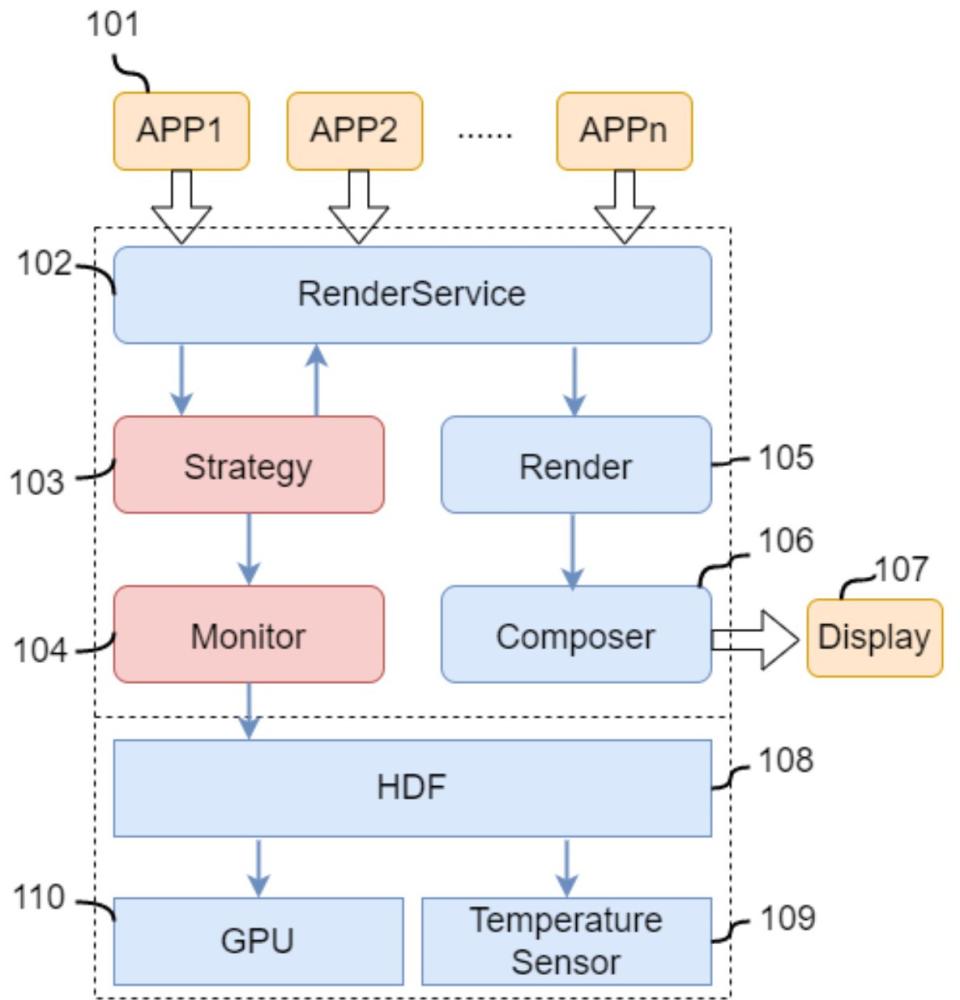
2、本发明第一方面公开一种动态渲染控制系统,所述动态渲染控制系统包括图形子系统和驱动硬件;其中:
3、图形子系统包括:
4、图形渲染框架renderservice,用于为操作系统提供2d和3d绘制功能以及动画和显示效果;
5、策略决策模块strategy,用于记录应用或surfacenode的优先级,根据monitor当前资源情况确定是否执行动态降帧以及确定需要降帧的应用或surfacenode;
6、显示资源监控模块monitor,用于按照固定频率调用hdf接口实时获取gpu的利用率和温度,并决策是否将当前信息更新到strategy,如果资源状态与上次报送区别保持一致,则不更新,否则更新strategy中的正常、预警和紧急状态值;
7、渲染组件render,用于提供api以及执行渲染处理;
8、图层合成模块composer,用于将多个图层合并为一个整体,以及对元素的透明度、色彩、位置进行调整,以实现无缝融合和过渡;
9、驱动硬件包括:
10、硬件设备框架hdf,用于实现硬件设备与操作系统之间的通信和交互;
11、处理器gpu,用于并行处理数据,包括图形渲染、并行计算和机器学习;
12、温度传感器temperaturesensor,用于实时监测设备内部各元件的温度变化,使得设备在正常的工作温度范围内运行;
13、其中,由安装在设备上的多个应用app请求渲染任务,合成后的图形图像由显示器display进行显示。
14、本发明第二方面公开一种基于gpu状态感知的通用移动操作系统动态渲染控制方法,所述方法利用如权利要去1所述的一种动态渲染控制系统来实现基于gpu状态感知的通用移动操作系统动态渲染控制;
15、所述方法具体包括:
16、步骤1:app设置自身优先级;
17、步骤2:显示资源监控模块monitor实时获取gpu的利用率和温度,并决策是否将当前信息更新到strategy;
18、步骤3:策略决策模块strategy根据monitor当前资源情况确定是否执行动态降帧以及确定需要降帧的应用或surfacenode;
19、步骤4:渲染组件render依据节点类型调整动态渲染策略并执行渲染处理。
20、在步骤1中:在rosen::rssurfacenodeconfig中扩展prioritytype属性;在创建rssurfacenode时传入rssurfacenodeconfig,并在rssurfacenode中扩展属性prioritytype;其中,提供setrenderpriority接口动态调整prioritytype优先级参数,提供getrenderpriority允许strategy获取当前节点prioritytype优先级。
21、在步骤2中:在renderservice服务启动时初始化资源实时监控线程,该线程按照固定的频率通过hdf获取gpu的当前利用率和温度,线程中分别记录利用率和温度的上一次状态;配置资源负载等级,包括正常状态、预警状态、紧急状态,预警状态下进行降帧处理。
22、在步骤3中:当负载取值为正常时,关键节点、次关键节点和非关键节点都按照原帧率渲染;当负载取值为预警时,资源处于较饱和状态,关键节点、次关键节点不变,非关键节点降帧,释放部分资源供关键和次关键节点使用;当负载取值为紧急时,资源出现瓶颈,次关键节点和非关键节点降帧,留出资源给关键节点使用。
23、在步骤3中,帧率控制包括:通过计数器确定渲染频率,在render_load_critical紧急状态时,所有关键节点渲染每一帧,次关键节点每2帧渲染一帧,非关键节点每4帧渲染一帧。
24、在步骤3中,帧率控制包括:对每种节点类型按照当前资源状态决策的帧率均速发送令牌,待渲染节点拿到令牌才进入渲染阶段,否则丢弃渲染任务;在render_load_critical紧急状态时,对于关键节点以60个/秒生产令牌,关键节点拿到令牌后进行后续渲染,帧率控制在60fps;对于次关键节点以30个/秒生产令牌,次关键节点只有拿到令牌后才进行渲染任务,控制帧率在30fps。
25、在步骤4中:在renderservice启动时,strategy载入降帧、阈值策略配置,同时启动monitor;monitor持续感知gpu的利用率和温度信息,并与之前信息进行对比,如检测到区间变化,则更新strategy当前负载等级,strategy动态调整渲染策略;app启动创建surfacenode并设置类型;app提交渲染任务,renderservice向strategy获取当前负载等级,如果负载等级为正常,则继续提交渲染任务、合成和显示;如负载等级为预警或紧急,则根据当前等级、策略、帧率控制方式对任务进行限流。
26、本发明第三方面公开一种计算机可读存储介质,其上存储有计算机程序,该程序被处理器执行时实现本发明第二方面所述的方法。
27、本发明第四方面公开一种电子设备,包括存储器、处理器及存储在存储器上并可在处理器上运行的计算机程序,所述处理器执行所述程序时实现本发明第二方面所述的方法。
28、综上,本发明通过实时监测gpu的利用率和温度,动态调整渲染帧率,当gpu利用率和温度升高时,根据特定策略,自动降低部分节点的渲染,同时在资源恢复时,自动恢复各节点的渲染,以实现系统的稳定运行并提高用户体验。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com