
一种面向直接法求解稀疏线性方程组的近存计算装置
本发明涉及计算机体系结构领域,具体来说涉及集成电路领域,更具体地说,涉及一种面向直接法求解稀疏线性方程组的近存计算装置。
背景技术:
1、求解稀疏线性方程组是科学计算和机器学习中的基础性工作负载,但其性能严重受限于内存带宽。近存计算(processing-near-memory, pnm)利用位于存储阵列附近的逻辑单元,在存储芯片内部实现高精度计算,从而缓解带宽瓶颈问题。因此,该技术在稀疏线性代数领域展现出巨大潜力。当前的研究中,大量的近存计算架构设计工作集中于稀疏矩阵乘法领域,如面向稀疏矩阵-稠密向量乘法(sparse matrix-dense vectormultiplications,spmv),稀疏矩阵-稠密矩阵乘法(sparse matrix-dense matrixmultiplications,spmm)以及稀疏矩阵-稀疏矩阵乘法(sparse matrix-sparse matrixmultiplications,spmspm)。这些稀疏矩阵乘法算子具有数据流简单,易于并行的特点。面向这些算子设计的近存计算加速架构均在对应算子上取得了良好的加速效果。
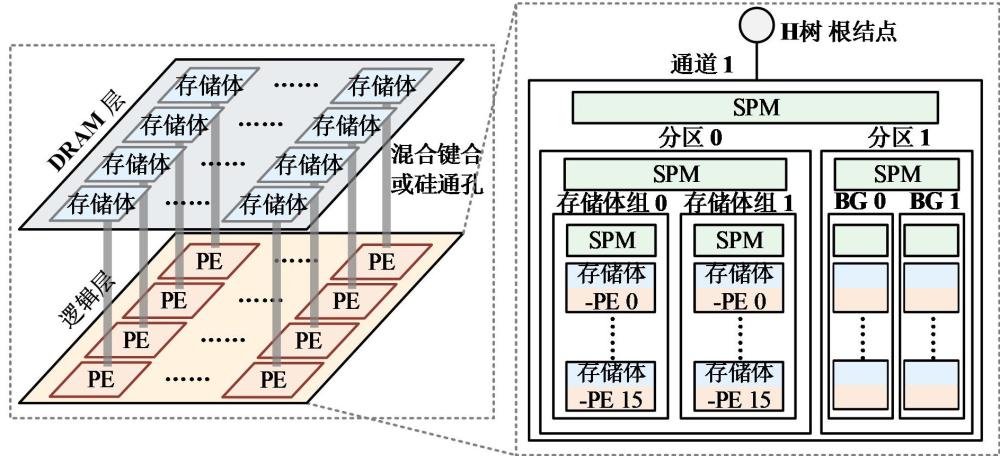
2、当前的近存计算工作尚不能支持直接法求解稀疏线性方程组。当前基于高带宽内存(high-bandwidth memory,hbm)以及基于其他方式实现的3d近存计算架构一般包括逻辑层和dram层,其中逻辑层集成了具备计算功能的处理单元(processing element,pe),通过硅通孔或者混合键合方式与dram层传输数据。在数据流简单,高度并行的各类稀疏矩阵乘法场景下,各个pe可以利用较高的内部存储带宽从dram层快速获取数据并执行并行计算,从而实现加速。
3、然而,在直接法求解(如lu分解)场景下,现有架构主要存在以下两个技术缺陷:
4、第一,复杂的任务依赖导致严重的计算停顿。直接法求解过程中的数据存在强耦合的依赖关系。这种特性导致现有的简单并行方案无法高效执行。大量pe会因为等待其他单元的计算结果而陷入停顿,无法充分发挥硬件的计算能力。这体现了现有架构在流水线设计上的不足。
5、第二,跨单元(pe)数据传输抵消了近存计算的优势,导致跨单元数据重用效率低。直接法求解要求pe之间频繁共享和传输中间计算结果。现有架构缺乏针对直接法求解中片上数据重用和局部通信的优化。大量的跨处理单元数据搬运不仅成为新的性能瓶颈,其产生的巨大通信开销也完全掩盖了近存计算带来的高带宽收益。
6、需要说明的是:本背景技术仅用于介绍本发明的相关信息,以便于帮助理解本发明的技术方案,但并不意味着相关信息必然是现有技术。相关信息与本发明方案一同提交和公开,在没有证据表明相关信息已在本发明的申请日以前公开的情况下,相关信息不应被视为现有技术。
技术实现思路
1、因此,本发明的目的在于克服上述现有技术的缺陷,提供一种面向直接法求解稀疏线性方程组的近存计算装置。
2、本发明的目的是通过以下技术方案实现的:
3、根据本发明的第一方面,提供一种近存计算装置,包括通过堆叠集成的逻辑层和存储层,所述存储层与逻辑层之间通过互连结构连接以传输数据,所述存储层包括分层组织的多个存储体;所述逻辑层包括多个处理单元,每个处理单元设有对应的存储体并通过互连结构与其耦合;各所述处理单元配置为异步执行独立的指令序列,每个指令序列对应以至少一行为粒度划分并存储于各自对应存储体中的稀疏矩阵局部数据,处理单元在局部数据计算所依赖的外部数据就绪时,以异步方式对所述局部数据进行计算;各处理单元之间通过逻辑层的互联网络进行数据传输,各存储体之间通过该互连网络进行间接数据交互,所述互联网络中,对应分层组织的存储体部署有层次化便签式存储器,用于在跨处理单元数据传输路径的各层级上缓存数据以支持就近复用。该方案至少能够实现以下有益技术效果:通过将存储体间的数据交互限制在逻辑层互联网络内,简化了存储层设计复杂度,无需破坏存储层成熟结构;各处理单元采用异步执行方式,充分考虑到稀疏数据局部性差异,大幅缩短全局同步带来的等待时间;层次化便签式存储器将重复的远程数据请求就近拦截并利用其缓存数据实现更快访问,显著降低平均访问延迟和全局带宽压力。
4、可选的,该装置被配置为:将稀疏矩阵按行划分至多个存储体;在计算过程中,每个处理单元以异步方式独立推进其本地指令序列,负责处理其对应的存储体分配到的稀疏矩阵行,其中:在当前处理单元在相应稀疏矩阵行计算过程中遇到数据依赖时,向远端存储体对应的远端处理单元发起远程数据请求,以获取所需依赖行的更新数据,若依赖行的更新数据已就绪,当前处理单元获取所述更新数据并继续推进该稀疏矩阵行的计算流程,若依赖行的更新数据未就绪,当前处理单元对该稀疏矩阵行进入等待状态直至所述更新数据到达,并在所述更新数据经由所述互联网络传输至本地后,继续推进该稀疏矩阵行的计算流程。该方案至少能够实现以下有益技术效果:按行划分后可解除全局同步屏障,允许各处理单元按照其本地数据和指令序列独立执行,最大化并行执行时间,提高直接法求解的总体计算效率;通过事件驱动的局部依赖等待机制,将计算停顿严格限制在数据真正缺失的局部处理单元内,避免了整体同步带来的资源闲置与低效率运行;依靠等待机制保证数据依赖正确性,进而保障计算结果的正确性。
5、可选的,各处理单元被配置为执行基于三阶段流水线的操作,每个处理单元能通过该流水线重叠执行多个局部数据相关的操作,其中,三阶段中,将依赖行的更新数据的远程获取、等待及接收合并为可变延迟的传输阶段,将索引匹配操作配置为查找阶段,将乘累加和除法运算配置为计算阶段。该方案至少能够实现以下有益技术效果:通过流水线掩盖可变远程访问延迟,提升单个处理单元的指令发射率、计算和索引匹配资源的利用率;传输阶段、查找阶段和计算阶段的重叠执行,使得处理单元内多个操作能够并行推进,尽可能保持本地部件处于忙碌状态,从而提升单节点吞吐和整体性能。
6、可选的,所述装置被配置为:在当前处理单元执行远程读操作以获取其依赖行的更新数据时,所述更新数据在经由所述互联网络从远端处理单元传输至当前处理单元的下行路径中,逐级写入并缓存于所述互联网络各层级节点上的便签式存储器中;其中,所述下行路径为从所述互联网络的最高层级节点到当前处理单元的路径;当任一处理单元对同一数据发起读请求时,沿上行路径从最近层级的便签式存储器中查找并返回该数据。该方案至少能够实现以下有益技术效果:将跨处理单元的数据传输复用化,大幅减少对远端存储体的重复访问次数;降低互联网络中高层链路的拥塞和功耗,使大多数数据传输被限制在低层节点内部;显著降低系统整体数据传输量,从而提升架构在直接法求解稀疏线性方程组时的整体性能和能效。
7、可选的,所述分层组织的多个存储体的层次结构包括:通道、分区、存储体组和存储体,多个存储体分为多个通道,每个通道包含多个分区,每个分区包括多个存储体组,每个存储体组包含若干存储体;存储体之间不在存储体层设互连结构,存储体之间通过逻辑层的处理单元及互联网络实现数据交互。该方案至少能够实现以下有益技术效果:将数据传输限制在逻辑层内,简化了存储层设计复杂度,无需破坏存储层成熟结构;实现垂直访问本地存储体与水平向其他存储体索要数据的解耦,两个过程可同时进行;仅存在逻辑层互连确保异步工作正确性并为数据复用奠定基础。
8、可选的,所述互联网络为h树结构,所述处理单元作为所述h树结构的叶子节点,多个所述叶子节点汇集形成存储体组层节点,多个所述存储体组层节点汇集形成分区层节点,多个所述分区层节点汇集形成通道层节点,多个所述通道层节点汇集形成根节点;其中,所述h树结构的各分层中间节点上部署有所述便签式存储器。该方案至少能够实现以下有益技术效果:h树结构提供确定性的低延迟传输路径;便签式存储器构成层次化数据缓存,将重复的远程数据请求就近拦截在低层节点,显著降低平均访问延迟和全局带宽压力;使得多个处理单元可以高效并行,避免根节点通信拥塞。
9、可选的,存储体组层节点、分区层节点和通道层节点分别设有对应的便签式存储器。该方案至少能够实现以下有益技术效果:在各级分支节点为后续的读请求提供数据复用机会,将绝大部分跨处理单元的数据交互限制在底层网络分支内;有效避免互联网络拓扑中极易出现的根节点通信拥塞,大幅降低了全局数据搬运开销。
10、可选的,所述处理单元包括:近存计算核、本地spm、索引内容寻址存储器、直接内存访问单元和传输单元,其中:近存计算核包括用于执行浮点运算的多个浮点计算单元;本地spm用于暂存来自远端处理单元的数据;索引内容寻址存储器用于存储稀疏数据的索引并执行索引搜索匹配;直接内存访问单元用于所述近存计算核和所述内容寻址存储器访问其对应存储体中的数据;传输单元与互联网络连接,用于所述处理单元与其他处理单元进行数据交互。该方案至少能够实现以下有益技术效果:处理单元集成了索引匹配、数据传输、存储访问和本地缓存单元,充分保证了其独立性,为其异步计算方式提供基础;索引匹配单元加速稀疏数据寻址过程,本地缓存单元加速数据传输过程,从而加速单处理单元上的稀疏计算任务。
11、根据本发明的第二方面,提供一种采用如第一方面所述的近存计算装置执行的稀疏线性方程组直接求解方法,所述方法包括:将待求解的稀疏矩阵按行划分至多个存储体,每个处理单元负责处理其对应存储体中的稀疏矩阵行;各处理单元以异步方式独立推进其本地指令序列,在计算过程中遇到数据依赖时,向远端处理单元发起远程数据请求以获取所需依赖行的更新数据,并根据所述更新数据的就绪状态执行以下操作:若所述更新数据已就绪,获取所述更新数据并继续该稀疏矩阵行的计算流程,若所述更新数据未就绪,对该稀疏矩阵行进入等待状态直至所述更新数据经由所述互联网络传输至本地后,继续推进该稀疏矩阵行的计算流程;在各处理单元内部,将依赖行数据的远程获取、等待及接收合并为可变延迟的数据传输阶段,将索引匹配操作配置为查找阶段,将乘累加和除法运算配置为计算阶段,所述数据传输阶段、所述查找阶段和所述计算阶段构成三阶段细粒度流水线,以重叠执行多个操作。该方案至少能够实现以下有益技术效果:解除全局同步屏障,允许各处理单元按照其本地数据和指令序列独立执行,最大化并行执行时间;通过流水线掩盖可变远程访问延迟,提升单处理单元吞吐;依靠等待机制保证数据依赖正确性,确保计算结果无误;兼顾复杂数据依赖处理和不规则通信优化,显著提升直接法求解稀疏线性方程组的整体性能。
12、可选的,所述方法包括:所述更新数据在经由所述互联网络从远端处理单元传输至当前处理单元的下行路径中,逐级写入并缓存于所述互联网络各层级节点上的便签式存储器中,并且各层级节点上的便签式存储器的替换策略设为:当存储空间已满时,自动驱逐其中最久未被访问的数据行;当任一处理单元对同一数据发起读请求时,沿上行路径从最近层级的便签式存储器中查找并返回该数据。该方案至少能够实现以下有益技术效果:将跨处理单元的数据传输复用化,大幅减少对远端存储体的重复访问次数;降低互联网络中高层链路的拥塞和功耗;通过硬件自动管理的层次化便签式存储器替换策略,确保缓存空间高效利用,无需引入复杂的全局缓存一致性开销,从而进一步提升架构整体性能和能效。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com