
一种面向大语言模型API调用的自动恢复方法及系统与流程
本发明涉及人工智能,具体涉及一种面向大语言模型api调用的自动恢复方法及系统。
背景技术:
1、随着大语言模型(llm)技术的迅猛发展,基于llm的智能体(agent)在自动化办公、智能客服及复杂任务规划等领域得到了广泛应用。然而,受限于算力成本与服务器负载,主流llm服务提供商(如openai、anthropic及国内大模型厂商)普遍采用严格的api调用限额(rate limit)机制,通常以每分钟(tpm)或每小时(tpm)的请求数/token数为单位进行计费与限流。
2、现有技术在一定程度上缓解了api调用失败的问题,但在面对llm agent复杂的长程任务时,仍存在以下显著缺陷:
3、缺乏模型降级与重试的联动机制:现有方案在处理限流时,往往仅针对单一模型进行反复重试或简单切换。在多供应商、多模型并存的场景下,各模型配额独立且消耗速率不同。现有技术未能建立有效的多级降级链路,导致一旦主模型限流,即使备选模型仍有充足配额,系统也无法智能调用,造成整体资源利用率低下。
4、无法实现跨时段的自动恢复:llm api的限流配额通常以小时为周期进行重置(如每小时60次)。现有方案大多在同一小时内进行密集重试,一旦超过上限即宣告失败或要求用户手动重试,无法智能识别“下一配额窗口”,导致任务中断,用户体验极差。
5、内存状态持久化机制缺失:llm agent在执行任务时依赖多轮对话上下文(memory/context)及工具调用状态。现有方案在任务暂停时,若仅记录任务id而未保存完整的内存快照,恢复执行时必须从头重构上下文,导致高昂的token消耗和时间浪费,甚至因上下文长度限制导致任务无法继续。
6、用户交互体验差:限流发生后,用户往往处于“黑盒”状态,无法获知任务进度、限流原因及预计恢复时间,只能被动等待或频繁手动刷新,极易引发焦虑和操作失误。
技术实现思路
1、针对上述问题,本发明的目的是提供一种面向大语言模型api调用的自动恢复方法及系统,显著提升api可用率、保障任务连续性、降低资源消耗大幅、提高恢复精度、优化用户体验。
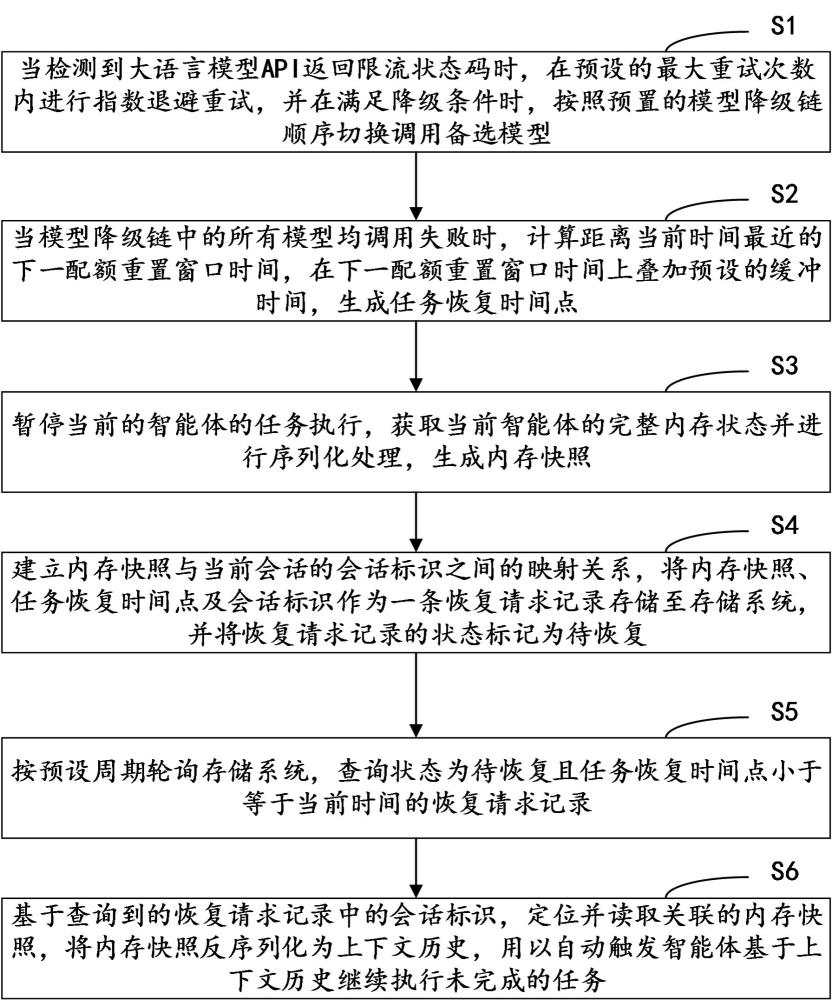
2、本发明提供了一种面向大语言模型api调用的自动恢复方法,包括:
3、步骤s1,当检测到大语言模型api返回限流状态码时,在预设的最大重试次数内进行指数退避重试,并在满足降级条件时,按照预置的模型降级链顺序切换调用备选模型;
4、步骤s2,当所述模型降级链中的所有模型均调用失败时,计算距离当前时间最近的下一配额重置窗口时间,在所述下一配额重置窗口时间上叠加预设的缓冲时间,生成任务恢复时间点;
5、步骤s3,暂停当前的智能体的任务执行,获取当前智能体的完整内存状态并进行序列化处理,生成内存快照;
6、步骤s4,建立所述内存快照与当前会话的会话标识之间的映射关系,将所述内存快照、所述任务恢复时间点及所述会话标识作为一条恢复请求记录存储至存储系统,并将所述恢复请求记录的状态标记为待恢复;
7、步骤s5,按预设周期轮询所述存储系统,查询状态为待恢复且任务恢复时间点小于等于当前时间的恢复请求记录;
8、步骤s6,基于查询到的恢复请求记录中的会话标识,定位并读取关联的内存快照,将所述内存快照反序列化为上下文历史,用以自动触发智能体基于所述上下文历史继续执行未完成的任务。
9、在一种可能的实现方式中,所述模型降级链包括:qwen3.7-plus、qwen3.6-plus、qwen3.5-plus、glm-5、kimi-k2.5。
10、在一种可能的实现方式中,所述在满足降级条件时,按照预置的模型降级链顺序切换调用备选模型包括:
11、当当前模型连续重试失败次数达到预设次数,且所述模型降级链中存在尚未调用的备选模型时,按照预置的模型降级链顺序切换调用备选模型。
12、在一种可能的实现方式中,所述计算距离当前时间最近的下一配额重置窗口时间,并在其上叠加预设的缓冲时间包括:
13、获取距离当前时间最近的下一个整点时刻;
14、在所述整点时刻基础上增加预设缓冲时长得到任务恢复时间点。
15、在一种可能的实现方式中,所述存储系统包括以下任意一种:关系型数据库、消息队列中间件、或内存数据库;
16、当存储系统为消息队列中间件时,所述恢复请求记录以消息形式入队,所述按预设周期轮询所述存储系统为对消息队列的消费或订阅。
17、在一种可能的实现方式中,在步骤s4之后还包括:
18、向前端客户端推送限流通知事件;所述限流通知事件包括格式化后的任务恢复时间点,用于向用户展示预计恢复时间。
19、在一种可能的实现方式中,所述计算距离当前时间最近的下一配额重置窗口时间还包括:
20、采集历史限流发生时间与配额重置规律,通过机器学习模型预测距离当前时间最近的下一配额重置窗口时间。
21、在一种可能的实现方式中,当机器学习模型预测得到的下一配额重置窗口时间与当前时间的间隔小于预设缓冲时长时,以当前时间叠加预设缓冲时长作为任务恢复时间点。
22、在一种可能的实现方式中,在步骤s6之后还包括:
23、若任务恢复执行成功,则将所述恢复请求记录的状态更新为已应答;
24、若恢复执行时再次检测到限流状态码,则在原有的任务恢复时间点上增加预设时长,以更新所述恢复请求记录的任务恢复时间点,保持待恢复状态以等待下一轮扫描。
25、本发明还提供了一种面向大语言模型api调用的自动恢复系统,执行任一上述的方法,包括:
26、多级重试与模型降级模块,用于当检测到大语言模型api返回限流状态码时,在预设的最大重试次数内进行指数退避重试,并在满足降级条件时,按照预置的模型降级链顺序切换调用备选模型;
27、生成任务恢复时间点模块,用于当所述模型降级链中的所有模型均调用失败时,计算距离当前时间最近的下一配额重置窗口时间,在所述下一配额重置窗口时间上叠加预设的缓冲时间,生成任务恢复时间点;
28、生成内存快照模块,用于暂停当前的智能体的任务执行,获取当前智能体的完整内存状态并进行序列化处理,生成内存快照;
29、生成恢复请求记录模块,用于建立所述内存快照与当前会话的会话标识之间的映射关系,将所述内存快照、所述任务恢复时间点及所述会话标识作为一条恢复请求记录存储至存储系统,并将所述恢复请求记录的状态标记为待恢复;
30、定期查询模块,用于按预设周期轮询所述存储系统,查询状态为待恢复且任务恢复时间点小于等于当前时间的恢复请求记录;
31、继续执行模块,用于基于查询到的恢复请求记录中的会话标识,定位并读取关联的内存快照,将所述内存快照反序列化为上下文历史,用以自动触发智能体基于所述上下文历史继续执行未完成的任务。
32、本发明提供的面向大语言模型api调用的自动恢复方法及系统,能够显著提升api可用率、保障任务连续性、降低资源消耗大幅、提高恢复精度、优化用户体验。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com