
GPU中的共享内存访问方法及其系统与流程
本发明涉及gpu及并行计算,具体地,涉及gpu中的共享内存访问方法及其系统。
背景技术:
1、随着人工智能(ai)、深度学习和大模型时代的到来,图形处理器(gpu)已成为高性能计算的核心加速器。现代ai模型参数规模已从数十亿跃升至万亿级别,训练与推理阶段对计算吞吐量和存储带宽的需求呈指数级增长。模型推理和训练过程中,大量算子对中间数据的频繁读写,使片上存储带宽逐渐成为性能瓶颈之一。在gpu片上存储体系中,寄存器文件(register file)、共享内存(shared memory,简称shm)和全局内存(global memory)构成了关键的存储层次。其中,共享内存作为线程块(thread block)内部线程间进行高速数据交换的片上静态随机存取存储器(sram),具有极低的访问延迟和较高的访问带宽。具体而言,在不存在存储体冲突的理想情况下,一次共享内存访问通常可在单个访存周期内完成,而该访存周期在物理实现上对应一个或少数几个时钟周期。因此,共享内存成为优化内存密集型计算内核(包括但不限于矩阵乘法、卷积运算以及transformer模型中的自注意力机制)的关键硬件资源。其中,访存周期是指线程束在执行一次共享内存访问指令时,由该指令触发并完成一次共享内存读写操作所占用的逻辑访问时间窗口,在该时间窗口内,线程束内的多个线程并行发起共享内存访问请求。时钟周期是指由处理器或存储子系统的全局时钟信号所定义的最小时间单位,用于度量硬件逻辑电路中一次同步运算或状态更新所需的时间长度。
2、在实际硬件实现中,为了提高芯片良率并降低制造成本,大容量sram通常并非整体实现,而是由多个小容量sram单元拼接构成。然而,共享内存的实际性能常常受限于sram的存储体(bank)冲突问题。共享内存通常由32个或更多独立的小容量sram模块(称为存储体,bank)拼接而成,每个存储体通常仅配置有限数量的读写端口,典型情况下为单端口或等效单端口结构,从而使得每个存储体在每一时钟周期内仅能支持一次32位或64位的数据访问。当同一个线程束(warp)内的多个线程同时访问同一bank的不同地址时,由于该bank在一个时钟周期内无法同时服务多个不同地址请求,硬件必须将这些访问串行化执行,导致单条共享内存指令的实际访存周期数成倍增加,即单条simt(single instruction,multiple thread)指令需要经历多个sram访存周期才能完成所有线程的数据读取。这种冲突在ai大模型计算中尤为突出,因为矩阵乘法(gemm)、自注意力机制等典型计算模式需要在共享内存中反复加载和重用数据块(tile),任何多余的访存周期都会被反复放大,成为主要的性能瓶颈。
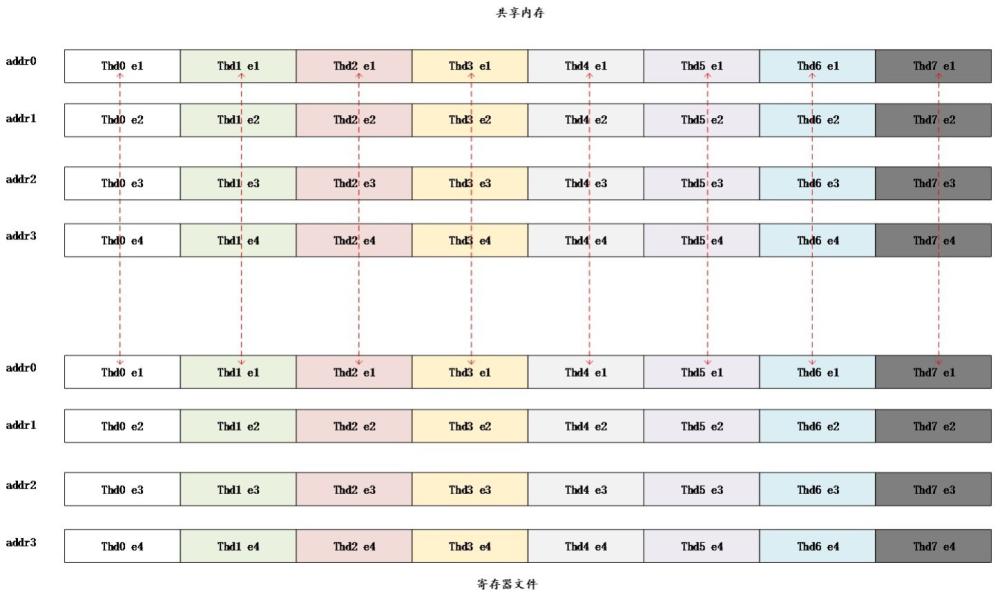
3、造成这一问题的根本原因在于共享内存与寄存器文件之间长期存在的数据布局失配。如图1所示,在传统设计中,共享内存继承了早期burst传输协议的“横向紧密排列”布局。图1展示了在线程束内每个线程需要在寄存器文件与共享内存之间搬运4个数据元素的场景下的数据元素摆放布局。在该模式下,每个线程一次性加载4个连续的32位数据元素(e1至e4)。由于共享内存采用横向连续紧密排列的传统布局,同一线程的e1、e2、e3、e4在地址空间上依次连续存放,例如线程0的e1~e4依次占用连续地址,线程1紧随其后。图中不同颜色代表不同线程的数据元素(thd0、thd1等),addr0-3表示共享内存的地址。每一列对应一个sram存储体(bank)。当线程束内多个线程同时读取具有相同元素序号的数据元素时,这些数据元素在共享内存中实际上分布在同一列上,地址低位变化规律决定了它们集中于少数bank,导致存储体冲突。
4、而寄存器文件为了支持simt并行计算,采用完全不同的“纵向排列”布局,如图2所示。warp内所有线程的具有相同元素序号的数据元素被存放在同一寄存器行或同一组寄存器地址中,这样算术逻辑单元(alu)才能在一个时钟周期内同时读取整个warp的对应元素,完成向量化的计算。
5、正是这种布局上的根本差异,导致从共享内存向寄存器加载数据时,硬件必须多次读取共享内存、然后在内部缓冲区中进行重组,才能最终把数据正确写入寄存器文件的对应行。如图3所示,在传统共享内存布局下,thd0 e1、thd2 e1、thd4 e1、thd6 e1四个数据元素位于同一存储体(bank)的不同地址,却需要同时写入寄存器文件的同一行位置。由于每个bank每时钟周期仅支持一次访问,硬件必须分4个时钟周期依次从该bank读取这四个元素(其他线程同元素序号的数据元素类似)。即使在完全没有其他并发访存冲突的情况下,这种由布局失配带来的固定多时钟周期开销也是不可避免的。反过来,从寄存器向共享内存写入数据时也面临同样的“转置”代价。这种由共享内存 bank 冲突引入的访存周期级额外开销,在ai大模型计算中被极度放大,因为共享内存往往是数据局部性最强、复用率最高的部分,任何访存延迟的增加都会直接制约整体计算效率。
6、现有技术中,业界在软件和硬件层面已尝试多种缓解共享内存bank冲突的手段,例如通过在共享内存中插入padding改变地址映射规律、在软件层面手动转置或重排数据、针对tensor core的矩阵布局和broadcast优化等。如wo2022253075a1(一种编译方法及相关装置)通过编译器在中间表示层面静态分析warp与共享内存访问关系,并调整映射顺序以降低bank冲突;us20210124582a1(techniques for efficiently transferring datato a processor)通过数据重排至不同bank并结合融合加载指令优化共享内存访问;us8108625b1(shared memory with parallel access and access conflict resolutionmechanism)通过硬件冲突检测与序列化机制动态化解冲突,无需修改数据布局。这些方法在特定场景下能够带来性能提升,但通常通用性有限,且部分方法需要程序员干预,代码复杂度较高。更重要的是,这些方案未能从体系结构层面解决共享内存与寄存器布局的根本不一致问题。如果直接在硬件层面统一所有存储层次的布局,虽然理论上可彻底消除冲突,但会严重破坏现有统一计算设备架构(cuda)生态的兼容性——全球数以亿计的已有内核代码都假设共享内存采用传统横向紧密排列方式,一旦底层布局改变,现有代码可能需重新编译、调试甚至重写,几乎不可行。
7、因此,亟需一种能够在保持现有软件兼容性的前提下,从源头优化共享内存访问的方法,以减少或消除bank冲突,缩短单条指令完成共享内存访问所需的访存周期数,提升gpu片上数据搬运效率。
技术实现思路
1、本发明提供了一种gpu中的共享内存访问方法及其系统,通过在硬件层面引入地址映射规则,在不修改现有软件代码的前提下,使共享内存读取后的数据元素在逻辑上与寄存器文件中的排列顺序一致,从而消除共享内存到寄存器文件搬运过程中由于存储体冲突和布局失配所引入的天然多时钟周期串行化开销,实现近乎无冲突的访存行为,同时最大限度保持软件兼容性。
2、具体地,本发明在硬件访存路径中引入一个专用的共享内存地址转换单元。软件仍按传统方式发出共享内存访问指令(读取/写入指令,即ld/st指令保持不变),硬件在指令到达共享内存之前或之后,对原始读取地址进行快速变换,使得warp内具有相同元素序号的数据元素对应的访问地址映射至共享内存的不同存储体。经过地址转换,warp内所有线程的同一元素序号的数据元素在逻辑上形成与寄存器文件一致的布局,从而实现从共享内存到寄存器文件的一次性完整搬运,而不再需要跨多个时钟周期对数据进行分批读取和内部重组。
3、本发明并不限定具体的地址映射规则,只要能够实现等效的布局统一效果即可,例如采用加法、位移和常量乘法等轻量运算,这些操作均可在现有地址生成流水线中以极低延迟完成,几乎不引入额外关键路径延迟。
4、在实际运行中,当线程束内32个线程全部有效时,新布局的收益最大;若部分线程无效(例如由于分支导致的inactive线程),硬件可动态回退到传统布局,按照原始读取地址进行数据元素读取或写入,避免空间浪费。为了进一步提升性能,本发明还提出访存指令合并优化策略:在共享内存访问单元为每个线程束额外缓存1~2条待执行的访问指令,当检测到相邻指令可以拼接成完整的32线程访问时,再统一应用地址转换和布局统一机制,从而最大限度利用新机制带来的带宽优势。
5、第一方面,本发明提供了一种gpu中的共享内存访问方法,其特征在于,所述方法包括:
6、接收多个线程发出的共享内存读取指令,其中,所述读取指令中的原始读取地址按第一布局进行读取,所述第一布局为同一线程对应的多个数据元素在原始读取地址上连续排列;
7、响应于所述共享内存读取指令,根据预定的地址映射规则,对各线程对应的原始读取地址进行转换为访问地址,使得同一线程对应的多个数据元素的访问地址不连续,其中,所述地址映射规则被配置为将各线程中具有相同元素序号的数据元素对应的访问地址映射至共享内存中不同的存储体,其中所述共享内存中数据的排列方式为不同线程中具有相同元素序号的数据元素分别存储在不同的存储体中;
8、根据所述访问地址,从共享内存的多个存储体并行读取所述具有相同元素序号的数据元素;
9、将读取的数据元素写入所述目标寄存器文件地址空间,其中,具有相同元素序号的多个线程对应的数据元素,被写入所述目标寄存器文件地址空间中对应的同一地址。
10、第二方面,本发明还提供了一种gpu中的共享内存访问系统,其特征在于,所述系统包括共享内存、目标寄存器文件、接收装置、地址转换单元、读取装置和写入装置;
11、所述接收装置用于接收多个线程发出的共享内存读取指令,其中,所述读取指令中的原始读取地址按第一布局进行读取,所述第一布局为同一线程对应的多个数据元素在原始读取地址上连续排列;
12、所述地址转换单元用于响应于所述共享内存读取指令,根据预定的地址映射规则,对各线程对应的原始读取地址进行转换为访问地址,使得同一线程对应的多个数据元素的访问地址不连续,其中,所述地址映射规则被配置为将各线程中具有相同元素序号的数据元素对应的访问地址映射至共享内存中不同的存储体,其中所述共享内存中数据的排列方式为不同线程中具有相同元素序号的数据元素分别存储在不同的存储体中;
13、所述读取装置用于根据所述访问地址,从共享内存的多个存储体并行读取所述具有相同元素序号的数据元素;
14、所述写入装置用于将读取的数据元素写入所述目标寄存器文件地址空间,其中,具有相同元素序号的多个线程对应的数据元素,被写入所述目标寄存器文件地址空间中对应的同一地址。
15、与现有技术相比,具有以下有益效果:
16、第一,通过预定的地址映射规则对原始读取地址进行转换,使线程束内具有相同元素序号的多个线程的访问地址映射至共享内存的不同存储体,从而实现同一访存周期内的并行读取,避免了传统布局下多线程访问同一存储体导致的串行化延迟,其中,所述访存周期是指线程束在执行一条共享内存访问指令时,由该指令触发的一次逻辑共享内存访问时间窗口。即使在没有其他并发访存冲突的情况下,也能消除由布局失配带来的固定多时钟周期开销,共享内存有效带宽得到大幅提升。在线程束内每个线程需要在寄存器文件与共享内存之间搬运 4 个 32 位数据元素的场景下,由于寄存器文件与共享内存之间的数据通路一次仅支持“同一元素序号”的线程束并行搬运(即每次只搬运 e1 或 e2 或 e3 或e4),因此一次完整的 数据搬运需要由多个共享内存访问过程组成。在传统布局方案中,由于同一元素序号的多线程访问容易产生存储体冲突,每一次共享内存访问在物理实现上通常需要约 4 个连续的时钟周期才能完成。因此,完成 4 个数据元素的全部搬运大约需要:4(元素序号次数) ×4(每次访问的冲突展开周期)= 16 个时钟周期。而在本发明的地址映射与布局统一机制下,具有相同元素序号的数据元素被映射到不同存储体,实现无冲突并行访问,使一次共享内存访问在物理上接近于单一时钟周期完成。因此完成数据搬运仅需:4(元素序号次数)× 1(无冲突访问周期)=4个时钟周期。由此可见,在相同的数据搬运任务下,所需时钟周期数由约16个降低至约4个,减少约12 个时钟周期,对应访存时间降低约75%,共享内存到寄存器文件的数据搬运效率显著提升。
17、第二,转换后的数据元素在逻辑上与寄存器文件排列顺序一致,具有相同元素序号的多个线程元素数据可直接写入寄存器文件的同一行位置,省去了传统方案中多次读取共享内存并在内部缓冲区重组的过程,使从共享内存到寄存器文件的单次数据搬运所占用的连续时钟周期数由传统方案中的多个时钟周期减少至接近单一时钟周期完成,大幅降低访存延迟,提高整体计算效率。在写入方向上也可获得对称的性能收益,从而同时加速读取与写入两类共享内存访问操作。
18、第三,地址映射规则在硬件地址转换单元中实现,软件发出的ld/st指令无需修改,现有cuda内核代码可直接运行,无需重新编译或重写。该方法在不破坏现有生态的前提下,从源头优化共享内存访问,适用于大规模部署的ai训练和推理任务。在真实的 ai 计算内核中,例如 fp16 gemm、attention 等操作,共享内存访问相关指令通常占据内核总执行时钟周期数的30%~60%,因此在上述场景下,整体计算性能预期可提升约15%~40%,具体提升幅度取决于内核的内存访问模式及共享内存使用强度。
19、第四,当线程束内有效线程数量未达到满线程数量时,可通过缓存相邻访存指令并判断是否可拼接为完整线程束活跃集,动态决定是否应用地址映射规则,避免传统方案中线程和存储位置强绑定导致的共享内存空间浪费,提高实际场景下的资源利用效率。该机制使本发明不仅适用于规则化的满线程束计算模式,也能够在 transformer 等模型中频繁出现的转置、归一化、softmax等不规则访存场景下保持较高的加速效果。
20、第五,地址转换单元仅基于加法、位移等简单运算实现,延迟极低,几乎不引入额外关键路径开销,可无缝集成到现有gpu访存路径中,具有良好的可实施性和工程落地价值。其硬件开销仅限于一个小型地址变换模块,相较于增加 bank 数量、增加端口或扩大sram 容量等方式,所需芯片面积与功耗代价显著更低。
21、综上所述,本发明在保持软件兼容性的前提下,从体系结构层面解决了共享内存与寄存器文件布局失配的根本问题,显著提升了gpu片上数据搬运效率和整体计算性能,可广泛应用于云端训练、边缘推理及科学计算等对片上带宽高度敏感的应用场景。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com