
一种单个环形通信路径的通信系统的制作方法
本发明涉及芯片设计,特别是涉及一种单个环形通信路径的通信系统。
背景技术:
1、在多gpu的深度学习训练中,经常需要将数据在不同gpu卡之间进行传输和复制。例如,在模型并行训练中,不同的gpu负责处理模型的不同部分,需要将中间结果从一个gpu卡复制到另一个gpu卡,以便进行后续的计算。同样,在科学计算、图形渲染等高性能计算领域,多个gpu卡协同工作时,也需要进行d2d跨卡显存复制;例如,在大规模的流体模拟、光线追踪等计算中,不同gpu卡可能负责不同区域或阶段的计算,需要将数据在卡之间进行传递和共享。gpu在面对显存复制时,可以直接进行数据传输,无需通过主机内存中转,例如如在多gpu系统中,一张gpu卡上的显存数据可借助rdma直接复制到另一张gpu卡的显存中,大大提高了数据传输效率,减少了cpu参与和数据传输的延迟。
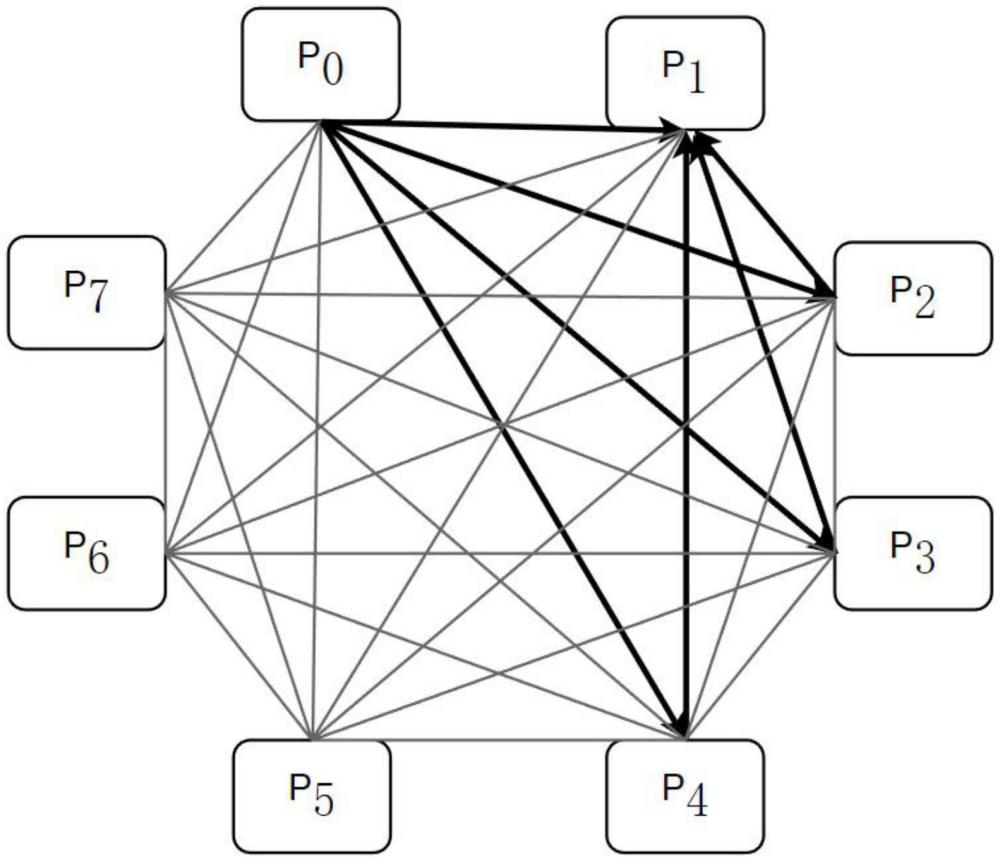
2、对于n个加速器互连拓扑来说,当互连拓扑中的n个加速器为点对点直接互连时,则每个加速器具有一条直达路径和最多n-1条通过一个中转加速器进行中转的中转路径。然而,若每个加速器都使用n-1条中转路径进行中转,则必然会导致资源资源竞争。也即多条路径共用同一条高速互连链路,不仅导致每条中转路径的带宽降低,同时还会导致吞吐量下降,以及延迟增加等问题。
技术实现思路
1、针对上述技术问题,本发明采用的技术方案为:一种单个环形通信路径的通信系统,所述系统包括:
2、n个加速器,每个所述加速器通过高速互连链路分别与其他n-1个加速器直接连接,形成点对点互连拓扑。
3、一个环形通信路径,包括首尾依次连接的n组网络拓扑路径gr,其中gr={gr0,gr1,…,grj,…,grn-1},grj为第j组网络拓扑路径,j的取值范围为0到n-1;grj包括从所述环形通信路径的第j个加速器pj到所述环形通信路径的第q加速器pq的一条直达路径drj和m条中转路径tr;其中,当0≤j<n-1时,q=j+1;当j=n-1时,q=0;m<n。
4、其中,所述drj为通过高速互连链路直接连接pj和pq形成的路径。
5、其中,所述tr={trj,1,trj,2,…,trj,t,…,trj,m-1},trj,t为通过高速互连链路依次连接的pj、第t个中转加速器和pq形成的grj的第t条中转路径,t的取值范围为1到m-1;所述第t个中转加速器为所述环形通信路径的第r个加速器pr,当j+t+1<n时,r=j+t+1;否则,r=(j+t+1)mod n;其中,所述m-1满足:m-1=(n-2)/2。
6、本发明至少具有以下有益效果:
7、本发明实施例提供的一种单环形通信路径的通信系统,该系统包括n个加速器和一个环形通信路径,该环形通信路径中每个加速器具有m-1=(n-2)/2条中转路径,每条中转路径的中转加速器pr满足:当j+t+1<n时,r=j+t+1;否则,r=(j+t+1)mod n。该通信系统中每条路径均独立占用一条高速互连链路,相比较现有技术,本发明实施例二提供的通信系统的带宽提高了m倍。
1.一种单个环形通信路径的通信系统,其特征在于,所述系统包括:
2.根据权利要求1所述的系统,其特征在于,所述加速器的显存包括m个缓冲区,每个缓冲区绑定一条直达路径或一条中转路径。
3.根据权利要求2所述的系统,其特征在于,当缓冲区绑定中转路径时,将所述缓冲区拆分为多个缓存块。
4.根据权利要求1所述的系统,其特征在于,所述通信系统中还包括交换机,所述交换机与所述通信系统中的每个加速器均互连,每个加速器的中转路径还包括以所述交换机为中转节点的中转路径。
5.根据权利要求1所述的系统,其特征在于,n=4或8。
6.根据权利要求1所述的系统,其特征在于,当n=4时:
7.根据权利要求1所述的系统,其特征在于,当n=8时:
8.根据权利要求1所述的系统,其特征在于,所述高速互连链路为使用符合metaxlink、nvlink、infinity fabric或者ucie标准的总线。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com