
基于大语言模型的航运货代单证智能审核方法及智能体
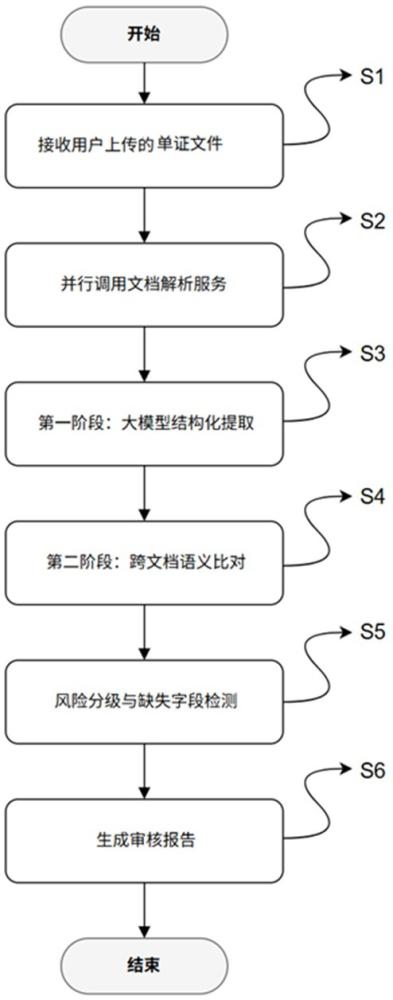
本发明属于航运物流与人工智能交叉,具体涉及一种基于大语言模型两阶段处理的航运货代单证智能审核方法及智能体,尤其适用于国际贸易物流链中货运合同与多类运输单证间的自动化一致性校核与风险审核场景。
背景技术:
1、在国际贸易物流链中,航运货代单证(单证)审核是保障货物顺利出运的关键环节。中国作为全球最大的贸易国之一,进出口贸易额持续保持在约6万亿美元/年的规模,货代企业数量超过10万家。一次标准的进出口货运审核通常涉及5至8份单证,包括货运合同、托单、提单、商业发票、装箱单、产地证、保险单等,每份单证平均包含20至50个关键字段需要核对。单证差错率在行业平均达到3%至5%,这意味着每年可能有数百万票货物因单证问题产生额外成本或延误。
2、货代企业需在装船前核对客户提交的货运合同与托单、提单、商业发票、装箱单等单证之间的一致性,以确保单证合规、准确。然而,传统的人工审核模式面临诸多挑战:
3、(1)效率瓶颈明显:一名熟练审核员每天最多处理30至40票货物,在业务高峰期难以应对大量积压订单;
4、(2)审核标准因人而异:不同人员的经验与判断差异导致审核结果不稳定,容易漏检中转港变更、柜型错配等隐蔽不符点;
5、(3)人力成本攀升:培养合格审核员周期长,通常需要6至12个月的专业培训,大批量审核需要大量人力投入,人力成本占运营成本的30%以上;
6、(4)错误风险难以根除:人工疲劳易产生疏漏,一旦关键不符点在出运后发现,可能引发银行拒付、海关扣货、延误罚款、额外费用甚至法律纠纷,单票损失可达数千至数万美元;
7、(5)审核过程缺乏透明度和可追踪性:难以实时掌握审核进度与质量状况,无法有效进行绩效管理和风险预警。
8、现有技术方案多采用简单ocr比对或固定规则引擎,但均存在明显局限:
9、(1)ocr比对方案的局限:只能识别文字图像而无法理解语义内涵。例如,提单上的"prepaid"和合同中的"运费预付"实为同一语义,但ocr无法识别这种语义等价性;又如,发票上的货值"usd500,000.00"与合同金额表述形式不同,ocr只能做字符串比对而无法进行语义归一化。
10、(2)规则引擎的局限:每新增一种单证模板需要人工编写对应的提取规则和比对规则,维护成本随单证种类数量线性增长。当涉及不同国家/地区的单证格式差异时,规则数量呈指数级膨胀,规则之间的冲突和优先级管理变得极其复杂。传统字符串精确匹配方法无法处理同义表述,例如"prepaid"与"运费预付",也无法处理格式变体,例如"toorderofshipper"与"toorderoftheshipper",导致映射覆盖率仅为47.2%。
11、(3)单次大语言模型调用的技术局限:直接将多份单证同时输入大语言模型进行比对时,存在以下技术问题:a)上下文窗口溢出问题:当多份单证同时输入时,文档总长度往往超过大语言模型的上下文窗口限制,例如部分大语言模型存在上下文窗口长度限制(如部分开源模型的4096tokens窗口),当多文档总长度超过该限制时会导致尾部文档内容被截断,字段提取不完整;b)注意力衰减问题:在长文档处理中,大语言模型的注意力机制存在衰减现象,导致远距离字段间的关系被忽略,相隔较远的字段无法建立有效关联;c)信息串扰问题:多文档在同一上下文中处理时,大语言模型将不同文档的信息混淆,例如将提单的收货人与发票的收货人混为一谈,导致提取准确率显著下降。实验数据表明,单次大语言模型调用处理5份文档时,字段提取准确率仅为71.3%,跨文档对比召回率仅为58.6%,信息串扰率高达23.4%。同时,已有方案普遍缺少风险等级划分与缺失字段检测能力,难以区分不符点的紧急程度,也无法发现合同中提及但单证中遗漏的关键信息。
技术实现思路
1、本发明的目的在于提供一种基于大语言模型的航运货代单证智能审核方法及智能体,以解决现有技术中人工审核效率低、标准不统一、易出错,以及现有自动化方案缺乏深层语义理解与跨文档关联分析能力的问题。本发明尤其要解决的是如何模拟资深审单员的逻辑,实现以合同为中心的多文档并行结构化提取、深度语义比对和风险精准分级的全流程自动化。
2、本发明的技术方案如下:
3、一种基于大语言模型的航运货代单证智能审核方法,包括以下步骤:
4、s1:接收用户上传的单证文件。
5、接收货运合同、托单、提单、商业发票、装箱单等单证,支持pdf、图片或word格式。
6、s2:并行调用文档解析服务进行预处理。
7、采用多线程或异步io技术并行处理多份单证,调用pdf解析库或ocr服务提取原始文本内容,建立待处理任务队列。
8、s3:执行第一阶段大模型处理。
9、将每份单证独立提交给大语言模型进行结构化提取,由模型理解单证语义和版式结构,输出标准化的json格式的结构化数据。
10、各单证的结构化数据包含:发货人、收货人、货物描述、数量、体积、起运港、目的港、中转港、柜型等关键字段、以及关键字段对应的字段值。
11、本阶段采用独立单文档输入方式,有效规避了上下文窗口溢出问题和信息串扰问题。
12、上下文窗口溢出问题是指当多份单证同时输入时文档总长度超过大语言模型上下文窗口限制导致尾部文档内容被截断的问题;
13、信息串扰问题是指多文档在同一上下文中处理时大语言模型将不同文档信息混淆导致字段提取准确率下降的问题。
14、s4:执行第二阶段大模型处理。
15、以货运合同的结构化数据为锚点,将各待对比单证的结构化数据与合同字段进行跨文档语义比对。
16、在s4中,智能体首先根据基于语义向量的字段映射方法建立合同字段与各待对比单证字段的关联匹配:
17、步骤s41、语义向量映射:对货运合同中的每个关键字段名称和各待比对单证中的所有字段名称分别计算语义向量和,使用预训练语言模型将字段名称编码为高维语义向量;
18、步骤s42、余弦相似度计算:
19、计算向量间的余弦相似度,取相似度最高的作为映射候选;
20、,
21、步骤s43、置信度阈值筛选:
22、设置高阈值为0.90,若相似度大于该阈值则标记为自动映射;设置低阈值为0.75,若相似度介于低阈值和高阈值之间则标记为弱映射需二次验证;若相似度低于等于低阈值则判定为非映射字段;
23、步骤s44、业务本体推理,获取最终确认的字段映射集合。
24、航运货代领域本体包括:
25、关键字段间的等价关系,例如consignee等价于收货人等价于receiver,
26、包含关系,例如运费支付方式包含freightpaymentterms,
27、业务约束关系,例如fob条件下运费支付方式应为collect;
28、即“航运货代领域本体”是一个结构化的业务知识库,其中定义了字段之间的等价关系、包含关系和业务约束规则;它被步骤s44用来验证语义向量映射结果的业务合理性:将弱映射转化为有效映射,补充遗漏映射,并发现违反业务规则的不符点,从而显著提高字段映射的准确率和召回率。
29、基于航运货代领域本体,对所述初步映射结果进行如下处理:
30、对自动映射执行业务约束检查,验证其是否符合业务规则,通过检查的纳入最终确认的字段映射集合;
31、对弱映射通过等价关系、包含关系等进行验证,若能确认则纳入最终确认的字段映射集合,否则标记为待人工确认;
32、对非映射字段检查本体中是否存在未通过向量相似度但业务上等价的字段对,若有则补充并纳入最终确认的字段映射集合。
33、步骤s45、语义归一化处理:对于已建立映射关系的字段,调用大语言模型对合同中的字段值和待比对单证中的字段值分别进行语义归一化处理,将于语义等价但表述形式不同的字段值转化为统一的标准形式。
34、例如将shanghai和上海识别为同一语义,将prepaid和运费预付识别为等价比喻表述;
35、步骤s46、对归一化后的字段值进行精确比对,识别出存在差异的关键字段。
36、以下结合图4,给出步骤s4第二阶段中字段映射与归一化处理的具体计算示例:
37、示例设货运合同的关键字段fc为"收货人",待比对单证(提单)已提取字段集合为{"consignee","notify party","shipper"}。
38、步骤s41:调用预训练语言模型将"收货人"编码为第一语义向量v(fc),将"consignee"、"notify party"、"shipper"分别编码为第二语义向量、、,本示例语义向量维度为768维。
39、步骤s42:计算余弦相似度,=0.95,=0.78,=0.15,取相似度最高的字段对"收货人–consignee"作为映射候选。
40、步骤s43:高阈值=0.90,低阈值=0.75;=0.95大于,将"收货人–consignee"标记为自动映射;
41、=0.78介于与之间,标记为弱映射,进入步骤s44二次验证;
42、=0.15小于,判定为非映射字段。
43、步骤s44:基于航运货代领域本体执行业务约束检查与等价关系验证。
44、本体中定义"consignee"≡"收货人"≡"receiver",
45、对自动映射"收货人–consignee"验证通过;
46、对弱映射"收货人–notify party",本体中"notify party"(通知方)与"收货人"分属不同业务角色,不构成等价关系,故标记为待人工确认;
47、本步骤最终确认的字段映射集合为{"收货人–consignee"}。
48、步骤s45:对已建立映射的字段对,调用大语言模型对货运合同字段值"globalimportcorp"与提单字段值"global import corp"分别执行语义归一化处理,统一为标准形式"globalimportcorp"。
49、步骤s46:对归一化后的两个字段值执行精确比对,二者完全一致,判定为无差异;若另一份单证(例如商业发票)的对应字段值经同样归一化处理后为"globalimportscorp"(多一字母s),则与合同字段值不一致,识别为存在实质性语义差异,加入字段值差异清单。
50、s5:风险分级与缺失字段检测。
51、s5.1、风险分级:对s4识别出的不符点进行量化风险评估,采用风险评分函数,
52、其中:为业务影响度评分,衡量不符点可能导致的经济损失程度,取值范围0至100;
53、典型取值包括:可能导致银行拒付则为95,可能导致海关扣货则为90,可能产生额外费用超过5000美元则为80,可能导致运输延误则为60,可能引发客户投诉则为45,仅影响单证美观度则b为15;
54、为偏差度评分,衡量实际值与合同值的偏离程度,取值范围0至100;
55、数值型字段的偏差度等于实际值与合同值之差的绝对值除以合同值乘以100;
56、枚举型字段为100或0;文本型字段等于一减编辑相似度乘以100;
57、为传播度评分,衡量该不符点在后续单证链中的影响范围,取值范围0至100;
58、、、为权重系数,推荐取值为0.5,为0.3,为0.2;
59、风险等级判定规则:若大于等于70则判定为高风险,若大于等于40且小于70则判定为中风险,若小于40则判定为低风险。
60、其中所述编辑相似度值由levenshtein编辑距离算法计算得到,编辑相似度值=1-levenshtein编辑距离/max(l1,l2),l1、l2分别为合同中字段值字符串的长度与待比对单证中字段值字符串的长度;
61、s5.2、缺失字段检测:基于步骤s3提取的货运合同结构化数据,结合航运货代领域本体中预定义的强制业务字段(如发货人、收货人、起运港、目的港、货物描述、数量、运费条款等),建立货运合同的必需字段清单;逐一检查各待比对单证中是否包含所述必需字段。
62、对于缺失字段,根据其对业务的影响程度标记优先级。
63、本发明还包括主动完备性校验,即通过交叉比对货运合同的必需字段清单与所有单证的已提取字段集合,识别合同中明确存在但任意一份单证中未提及的关键字段的过程,填补传统审核只看字段值不一致、不看字段不存在的检测盲区,将完整性问题的检出率从传统审核的67%提升至98%。
64、s6:生成包含审核概况、字段值差异清单(其中每一项已配以对应的风险等级)、缺失字段列表和审单建议的结构化审核报告。
65、优选地,步骤s2和s3采用并行循环处理机制:对于多个单证,并行调用文档解析服务对每个单证分别进行原始文本内容提取,待解析完成后,再并行调用大语言模型对每个单证的原始文本内容进行结构化提取。
66、进一步地,本发明还提供一种实现上述方法的航运货代单证智能审核智能体,包括用户界面模块、文档解析模块、两阶段大模型处理模块、风险分析模块和报告生成模块。
67、用户界面模块,用于接收用户上传的单证文件,所述单证文件包括货运合同,以及托单、提单、商业发票和装箱单中的至少一种;
68、文档解析模块,用于并行调用文档解析服务对单证进行预处理,提取每份单证的原始文本内容;
69、两阶段大模型处理模块,包括第一阶段结构化处理单元和第二阶段跨文档比对处理单元;第一阶段结构化处理单元用于将每份单证的原始文本内容分别独立输入大语言模型,生成各单证的结构化数据;第二阶段跨文档比对处理单元用于以货运合同的结构化数据为锚点,将各单证的结构化数据与货运合同的结构化数据一并输入大语言模型,进行跨文档语义比对,生成字段值差异清单;所述字段值差异清单中的每一项包含字段名称、合同中的字段值、单证中的字段值以及差异类型;
70、风险分析模块,用于根据所述字差异类型,对每一项采用量化风险评分函数进行风险分级,并用于提取货运合同的必需字段清单,与各单证文件的结构化数据中的字段进行交叉比对,识别缺失字段并标记优先级,生成缺失字段清单;
71、报告生成模块,用于汇总所述字段值差异清单及其风险等级、所述缺失字段清单以及审单建议,生成结构化审核报告。
72、优选地,所述两阶段大模型处理模块的第二阶段跨文档比对处理单元,采用基于语义向量相似度计算和航运货代领域本体推理的字段映射方法建立合同与单证的字段关联。
73、优选地,所述风险分析模块采用量化风险评分函数对不符点进行分级,同时执行主动完备性校验检测单证中的缺失字段。
74、本发明的有益效果如下:
75、(1)两阶段处理的串扰抑制效果:实验数据表明,两阶段处理将多文档信息串扰率从单次大语言模型调用的23.4%降至2.1%,字段提取准确率从71.3%提升至94.7%,有效解决了多文档同时输入大语言模型时的上下文窗口溢出问题和信息混淆问题;
76、(2)语义向量映射的鲁棒性:
77、相比传统正则匹配或精确字符串比对,语义向量映射方法对不同模板、不同语言、不同表述方式的单证均能建立正确映射,映射准确率达到93.5%,而字符串精确匹配的映射准确率仅为47.2%;
78、(3)量化风险评分的精确性:相比人工主观判断,量化风险评分函数将不符点优先级排序的一致性从62%提升至89%,使得高风险不符点的首次检出率从78%提升至96%;
79、(4)缺失字段检测的完备性:主动完备性校验将单证完整性问题的检出率从传统审核的67%提升至98%,有效填补了只看不一致、不看不存在的检测盲区;
80、(5)并行处理的可扩展性:循环并行处理机制使得文档预处理时间不随文档数量线性增长,5份文档处理时间为t,10份文档处理时间约为1.3t而非2t;
81、(6)端到端审核流程的技术闭环:从文档解析、结构化提取、跨文档对比、风险分级到报告生成,形成完整的技术闭环,各环节均具备可量化的技术指标。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com