
混合排序方法、系统及计算机可读存储介质与流程
本发明涉及信息检索服务,特别是涉及一种混合排序方法、系统及计算机可读存储介质。
背景技术:
1、随着信息服务平台的业务复杂度提升,单一数据源往往无法满足用户的全面检索需求。典型的场景是:平台既需要访问外部的商业学术数据库(如外部数据源提供的期刊、论文、专利等学术资源检索服务),又需要访问平台自建的本地全文检索库(如基于elasticsearch的行业知识库)。
2、其中,商业学术搜索引擎(learnsearch):作为外部商业搜索引擎,通过http api提供文献检索服务,返回的每条结果携带基于自身专有算法的相关性评分(_score),结果按该评分降序排列,同样的,本地全文检索库也具有自身专有算法的相关性评分。
3、上述两者的评分体系异构导致不可比,不同搜索引擎采用的评分算法不同(如商业学术搜索引擎的专有相关性算法与本地的elasticsearch的tf-idf算法),评分值的量纲和分布范围差异巨大(例如外部数据源某结果的原始评分为15.3,本地es某结果的原始评分为8.7),直接按原始分值比较会产生严重的偏差,导致排序不公。
技术实现思路
1、有鉴于此,本发明的目的在于提供一种混合排序方法、系统及计算机可读存储介质,通过对数据源的数据进行归一化处理,从根本上解决了异构搜索引擎因评分算法不同导致的评分量纲不可比问题,排序结果具有数学上的可解释性和合理性,用户获得的相关性排序结果更加准确可信。
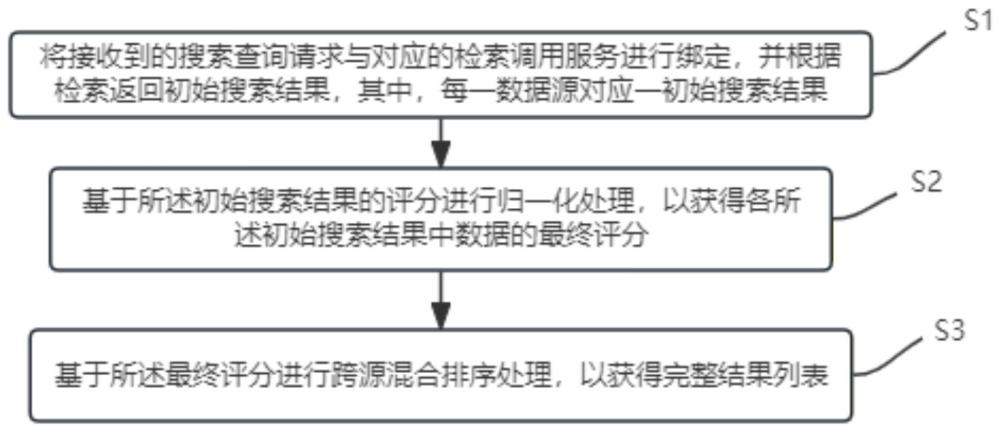
2、本发明提供一种混合排序方法,包括如下步骤:
3、将接收到的搜索查询请求与对应的检索调用服务进行绑定,并根据检索返回初始搜索结果,其中,每一数据源对应一初始搜索结果;
4、基于所述初始搜索结果的评分进行归一化处理,以获得各所述初始搜索结果中数据的最终评分;
5、基于所述最终评分进行跨源混合排序处理,以获得完整结果列表。
6、在一实施例中,所述将接收到的搜索查询请求与对应的检索调用服务进行绑定,并根据检索返回初始搜索结果,进一步包括:
7、接收到搜索查询请求后,根据所述搜索查询请求分别创建对应的异步任务,其中,每一异步任务配置有对应的超时事件阈值及窗口参数数值;
8、将所述异步任务与对应的所述检索调用服务进行绑定;
9、在所有异步任务完成后,根据所述检索调用服务返回的数据构建所述初始搜索结果。
10、在一实施例中,所述在所有异步任务完成后,根据所述检索调用服务返回的数据构建所述初始搜索结果,进一步包括:
11、在检索调用服务调用所述数据源中的某一数据出现异常时,基于所述数据源的数据对应的标识符构建异常数据列表;
12、在所述检索调用服务调用所述数据源中的数据成功时,基于所述数据源的数据对应的标识符构建有效数据列表。
13、在一实施例中,所述基于所述初始搜索结果的评分进行归一化处理,以获得各所述初始搜索结果中数据的最终评分,进一步包括:
14、遍历所述有效数据列表中的数据对应的初始评分值,并获取最高评分值;
15、基于每一数据源中的所述初始评分值和所述最高评分值,对所述有效数据列表中的数据的初始评分值进行归一化处理,以获得所述归一化评分。
16、在一实施例中,所述基于所述最终评分进行跨源混合排序处理,以获得完整结果列表,进一步包括:
17、将所有初始搜索结果中的数据合并到统一的候选列表容器中;
18、以所述最终评分为排序键,按照顺序进行排序处理,以获得完整结果列表。
19、在一实施例中,所述混合排序方法还包括;
20、遍历所述完整结果列表的数据对应的聚合结果结构;
21、将所述聚合结果结构解析为统一的聚合条目列表,其中,所述聚合条目列表包括聚合维度字段名、面向用户的显示标签和分桶统计映射表;
22、在聚合维度字段名同名的情况下,遍历同名所述聚合维度字段名对应的分桶统计映射表,将相同桶标签的文档计数值进行合并;仅在某一数据源中出现的桶标签,将该所述桶标签对应的文档计数值进行保留。
23、在一实施例中,所述混合排序方法还包括:
24、对所述完整结果列表中数据的数据源进行判断,
25、在数据源为第一数据源的情况下,根据所述查询请求中指定的资源标识符从关系数据库表中查询出所述第一数据源对应的全部映射配置记录;
26、遍历所述统一结果条目对象中的公共字段,并基于所述全部映射配置记录中的语义标签查找所述第一数据源中对应的实际字段名;
27、将所述实际字段名作为索引从所述第一数据源中提取出对应的字段值;
28、将所述字段值填充到所述统一结果条目对象中对应的所述公共字段中;
29、在所述数据源为第二数据源的情况下,直接按照固定映射规则填充到所述统一结果条目对象中对应的所述公共字段中。
30、在一实施例中,所述混合排序方法还包括:
31、对所述完整结果列表进行封装并返回给到调用方。
32、本发明还提供一种混合排序系统,用于实施上述所述的方法,包括:
33、数据源层,用于配置若干数据源;
34、控制层,用于接收搜索查询请求;
35、服务层,用于将接收到的搜索查询请求与对应的检索调用服务进行绑定,并根据检索返回初始搜索结果,其中,每一数据源对应一初始搜索结果;
36、处理层,用于基于所述初始搜索结果的评分进行归一化处理,以获得各所述初始搜索结果中数据的最终评分;
37、基于所述最终评分进行跨源混合排序处理,以获得完整结果列。
38、本发明还提供一种计算机可读存储介质,其上存储有计算机程序,所述计算机程序被处理器执行时实现上述任一项所述的方法。
39、本发明提供的混合排序方法、系统及计算机可读存储介质,通过对各数据源的数据进行归一化处理,从根本上解决了异构搜索引擎因评分算法不同导致的评分量纲不可比问题,排序结果具有数学上的可解释性和合理性,用户获得的相关性排序结果更加准确可信。
1.一种混合排序方法,其特征在于,包括如下步骤:
2.如权利要求1所述的混合排序方法,其特征在于,所述将接收到的搜索查询请求与对应的检索调用服务进行绑定,并根据检索返回初始搜索结果,进一步包括:
3.如权利要求2所述的混合排序方法,其特征在于,所述在所有异步任务完成后,根据所述检索调用服务返回的数据构建所述初始搜索结果,进一步包括:
4.如权利要求3所述的混合排序方法,其特征在于,基于所述初始搜索结果的评分进行归一化处理,以获得各所述初始搜索结果中数据的最终评分,进一步包括:
5.如权利要求1所述的混合排序方法,其特征在于,所述基于所述最终评分进行跨源混合排序处理,以获得完整结果列表,进一步包括:
6.如权利要求1所述的混合排序方法,其特征在于,所述混合排序方法还包括;
7.如权利要求1所述的混合排序方法,其特征在于,所述混合排序方法还包括:
8.如权利要求1所述的混合排序方法,其特征在于,所述混合排序方法还包括:
9.一种混合排序系统,其特征在于,用于实施权利要求1至8中任意一项所述的方法,包括:
10.一种计算机可读存储介质,其特征在于,其上存储有计算机程序,所述计算机程序被处理器执行时实现如权利要求1-8中任一项所述的方法。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com