
基于前瞻距离与强化学习的机器人轨迹跟踪控制方法
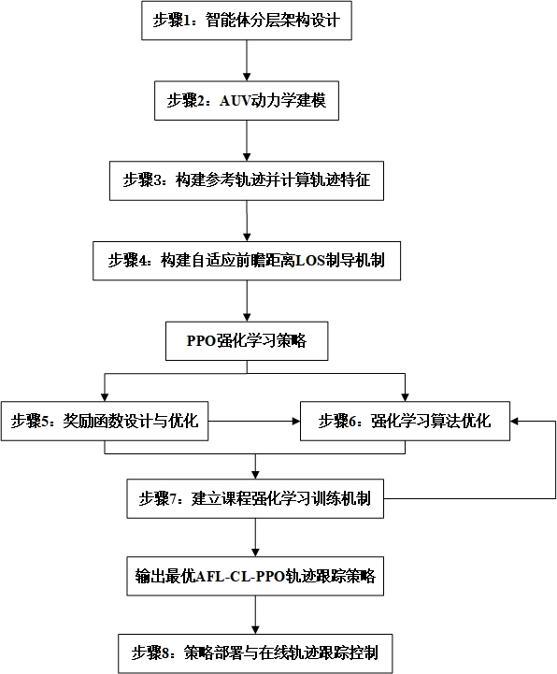
本发明公开了基于前瞻距离与强化学习的机器人轨迹跟踪控制方法,属于机器人轨迹跟踪控制。
背景技术:
1、随着自主水下机器人(auv)在海洋资源勘探、水下巡检、生态监测和军事防御等领域的广泛应用,对auv的轨迹跟踪控制精度和鲁棒性提出了更高要求。
2、国内外在auv轨迹跟踪控制领域已开展了一系列研究,包括基于los制导的传统控制方法、基于强化学习的智能控制方法等。这些方法在一定程度上提高了auv的轨迹跟踪能力,但在复杂水下环境中仍存在适应性和鲁棒性不足的问题。传统los制导大多采用固定前瞻距离,难以同时兼顾轨迹跟踪精度和航向控制平滑性;传统控制方法通常依赖精确的动力学模型,面对洋流扰动、模型参数变化和传感器噪声时控制效果容易下降;强化学习方法虽然具有较强的自学习能力,但在复杂三维轨迹和扰动环境下容易出现训练效率低、收敛速度慢和策略稳定性不足等问题。
技术实现思路
1、本发明公开了基于前瞻距离与强化学习的机器人轨迹跟踪控制方法,以解决解决现有水下机器人采用固定前瞻距离los制导难以适配曲线轨迹,且强化学习控制存在训练收敛慢、轨迹跟踪精度不足的技术问题。
2、基于前瞻距离与强化学习的机器人轨迹跟踪控制方法,包括以下步骤:
3、构建轨迹制导层、智能决策层、运动控制执行层的智能体分层架构;建立水下机器人六自由度动力学模型;计算参考轨迹与自主水下机器人当前实际运动状态之间的轨迹误差、姿态误差、速度误差及路径曲率特征;基于轨迹特征与水下机器人运动状态动态自适应调整los前瞻距离并生成制导期望姿态;构建多维度复合奖励函数;以轨迹特征、自适应los制导参数及水下机器人运动状态为输入,采用ppo强化学习算法,依托复合奖励函数优化控制策略;基于ppo强化学习搭建交互训练框架,利用奖励函数输出的即时奖励优化控制策略;采用三级课程强化学习机制分级训练策略模型;部署最优策略实现水下机器人二维、三维轨迹在线闭环跟踪。
4、进一步地,所述轨迹制导层负责接收参考轨迹及自主水下机器人实时运动状态,计算轨迹误差、航向角误差、速度误差和路径曲率,并根据路径曲率、轨迹误差及速度误差在线实时调整前瞻距离,生成动态los目标点、期望航向角以及三维轨迹下的期望俯仰角;
5、所述智能决策层采用ppo强化学习算法,根据轨迹制导层输出的轨迹误差、航向角误差、速度误差、自适应前瞻距离以及机器人运动状态构建强化学习状态空间,输出机器人控制动作,并结合课程强化学习训练机制不断优化控制策略;
6、所述运动控制执行层根据强化学习输出的控制指令完成推进器推力分配及姿态控制,实现自主水下机器人的轨迹跟踪控制。
7、进一步地,所述建立水下机器人六自由度动力学模型,包括:
8、设定坐标系下位姿向量,、、为水下机器人惯性坐标系三维位置坐标,、、分别为横滚角、俯仰角、航向角;
9、坐标系下的速度向量,、、分别为机体坐标系纵向、横向、垂向线速度,、、分别为机体坐标系横滚角速度、俯仰角速度、偏航角速度;
10、坐标系下的重心向量,机体坐标系下的浮心向量,、、分别为重心在机体坐标系下的坐标,、、分别为浮心在机体坐标系下的坐标;
11、六自由度动力学方程为:
12、;
13、式中,为水下机器人惯性矩阵,为机体坐标系下速度向量对时间的一阶导数,为科氏力和向心力矩阵,为水动力阻尼矩阵,为由重力和浮力产生的恢复力及恢复力矩,为水下机器人推进器与舵面产生的控制力、控制力矩构成的控制输入向量,为外部环境扰动项;
14、控制输入向量,分别为自主水下机器人沿机体坐标系轴方向受到的控制力,分别为水下机器人绕机体坐标系轴方向受到的控制力矩。
15、进一步地,所述计算参考轨迹的轨迹误差、姿态误差、速度误差及路径曲率特征,包括:
16、构建水下机器人轨迹跟踪任务中的参考轨迹,并根据水下机器人当前位置实时计算轨迹特征参数;
17、所述参考轨迹包括二维固定深度轨迹和三维空间轨迹;
18、所述参考轨迹点集合定义为:
19、;
20、水下机器人实时位置记为;
21、求解自主水下机器人当前位置与第个参考轨迹点之间的距离为:
22、;
23、选取距离当前位置最近的轨迹点作为当前匹配参考点,表示当前匹配参考点编号;
24、依托匹配参考点求解实时轨迹位置的轨迹误差;
25、;
26、式中,为轨迹误差,、、为匹配参考点在惯性坐标系下的三维坐标;
27、当前参考轨迹切向航向角为:
28、;
29、式中,为第时刻当前匹配参考点处的参考轨迹切向航向角;
30、自主水下机器人的航向角误差为:
31、;
32、式中,为第时刻自主水下机器人当前航向角与los期望航向角之间的误差,为自主水下机器人的当前航向角,为自适应前瞻距离los制导机制生成的期望航向角;
33、设期望速度为,自主水下机器人当前航速与期望航速之间的误差为:
34、;
35、式中,为自主水下机器人的当前航速;
36、二维连续轨迹、三维连续轨迹分别采用对应的解析曲率计算公式;离散轨迹采用三点几何算法求取离散曲率,运行过程自适应输出当前时刻路径曲率。
37、进一步地,所述基于轨迹特征与水下机器人运动状态动态自适应调整los前瞻距离并生成制导期望姿态,包括:
38、定义时刻的自适应前瞻距离满足,具体计算公式为:
39、;
40、式中,为第时刻的自适应前瞻距离,为基础前瞻距离,为水下机器人当前航行速度,为当前路径曲率,为轨迹误差,为速度误差,、、、分别为航速、路径曲率、轨迹误差和速度误差对应的调节系数,为限幅函数,限幅函数为,为最小前瞻距离,为最大前瞻距离;
41、在参考轨迹上自当前匹配参考点沿轨迹前进方向搜索弧长距离等于的位置得到los目标点,为第时刻的los目标点,为当前匹配参考点对应的轨迹弧长参数,为参考轨迹关于弧长参数的轨迹函数;
42、针对离散轨迹,当前匹配参考点向前累计轨迹弧长为:
43、;
44、式中,为自匹配参考点沿轨迹前进至轨迹点的累计轨迹弧长,为求和遍历索引,为相邻离散轨迹点的空间距离;
45、当满足时,los目标点通过插值为,、分别为los目标点所在路径段的两个端点,为插值系数且;
46、根据水下机器人当前位置和los目标点,求解los期望航向角与三维轨迹期los望俯仰角:
47、;
48、;
49、定义三维轨迹对应的俯仰角误差:
50、;
51、式中,为角度限幅归一化函数,为水下机器人当前俯仰角。
52、进一步地,所述构建多维度复合奖励函数,包括:
53、对航向角误差、俯仰角误差、速度误差分别进行归一化处理;基于归一化后的误差构建轨迹误差奖励、航向角误差奖励、俯仰角误差奖励、速度误差奖励;设置轨迹前进奖励和控制能耗奖励、动作平滑奖励;
54、配置具备多约束判定条件的任务完成型分段奖励:
55、;
56、式中,为任务完成奖励,为预设正奖励值,为轨迹误差阈值,为航向角误差阈值,为俯仰角误差阈值,为速度误差阈值,为第时刻当前匹配参考点对应的轨迹弧长位置,为参考轨迹总弧长,为终端容许弧长范围;
57、构建总奖励函数为:
58、;
59、式中,为第时刻自主水下机器人获得的总奖励,、、、、、、分别为轨迹误差奖励、航向角误差奖励、俯仰角误差奖励、速度误差奖励、轨迹前进奖励、控制能耗奖励、动作平滑奖励和任务完成奖励的权重系数,各权重系数满足;
60、ppo算法以最大化策略期望累计回报作为优化目标,所述期望累计回报:
61、;
62、式中,为策略的期望累计回报,为折扣因子的次方,为当前训练回合的最大时间步,为第时刻的即时奖励。
63、进一步地,所述以轨迹特征、自适应los制导参数及水下机器人运动状态为输入,采用ppo强化学习算法,依托复合奖励函数优化控制策略,包括:
64、定义第时刻水下机器人的状态为:
65、;
66、式中,为时刻强化学习状态,为轨迹误差,为水下机器人当前航向角与los期望航向角之间的误差,为水下机器人当前俯仰角与los期望俯仰角之间的误差,为速度误差,为当前路径曲率,为自适应前瞻距离,为los期望航向角,为los期望俯仰角,分别为水下机器人沿机体坐标系轴方向的线速度,分别为水下机器人绕机体坐标系轴方向的角速度;
67、构建强化学习动作空间,定义第时刻ppo策略网络输出的动作向量为:
68、;
69、式中,为第时刻ppo策略网络输出的控制动作,为推进器推力控制量,为水平舵角控制量,为垂直舵角控制量;
70、各动作量满足执行机构物理约束:
71、;
72、式中,、分别为推进器最小和最大推力,、分别为水平舵角最小和最大取值,、分别为垂直舵角最小和最大取值;
73、水下机器人在状态下执行动作,根据水下机器人动力学模型更新下一状态时刻:
74、;
75、式中,为第时刻的强化学习状态,为由水下机器人动力学模型、控制输入及外部扰动共同决定的状态转移函数,为第时刻外部扰动项;
76、ppo算法包含参数的策略网络、参数的价值网络;策略网络依据采样输出动作,价值网络输出状态估值;智能体交互采集样本序列,为时刻的即时奖励,由构建的多权重复合奖励函数计算得到;
77、基于即时奖励计算折扣累计回报:
78、;
79、式中,为第时刻的折扣累计回报,为折扣因子,为当前训练回合的最大时间步,为第时刻的即时奖励;
80、依次计算优势函数、策略概率比值:
81、;
82、式中,表示第时刻动作相对于当前策略的优势估计,为参数的策略网络在状态下选择动作的概率,为价值网络输出状态估值,为更新前旧策略网络在状态下选择动作的概率;
83、分别构建ppo剪切目标函数、价值网络损失、ppo联合优化目标和策略熵项:
84、;
85、式中,为剪切范围系数,为价值函数损失权重,为策略熵权重,为策略熵项,为策略分布的熵;
86、最大化总目标更新网络最优参数、,训练完成后依据最优策略输入实时状态输出最优控制动作。
87、进一步地,所述采用三级课程强化学习机制分级训练策略模型,包括:
88、构建三级课程强化学习训练机制,课程集合为:
89、;
90、式中,为课程集合,为第一阶段二维轨迹课程,为第二阶段三维轨迹课程,为第三阶段复杂扰动环境课程;
91、采用ppo算法与复合奖励函数训练,参数递进迁移规,为第阶段课程开始训练时的ppo策略网络初始参数,为第阶段课程训练完成后的最优策略网络参数;
92、第一阶段为二维轨迹训练课程,限定机器人保持固定深度,为预设固定深度,二维参考轨迹为:
93、;
94、式中,为第一阶段参考轨迹,为轨迹弧长参数,、为随弧长变化的水平面参考坐标;
95、第二阶段为三维轨迹训练课程,解除深度约束,三维参考轨迹满足:
96、;
97、式中,为第二阶段三维参考轨迹,为随弧长变化的深度坐标;
98、第三阶段为复杂扰动训练课程,水下机器人执行控制动作后的状态转移满足:
99、;
100、式中,为第时刻的强化学习状态,为由水下机器人动力学模型、控制输入及外部扰动共同决定的状态转移函数,为第时刻外部扰动项;
101、在所述复杂扰动训练课程中,状态转移函数运算过程引入扰动后的惯性矩阵和水动力阻尼矩阵,模拟存在参数失配的实际工况。
102、进一步地,所述采用三级课程强化学习机制分级训练策略模型,还包括:
103、配置多指标联合课程自动切换机制,连续统计个训练回合的平均累积奖励与平均跟踪误差;当平均累积奖励大于设定奖励阈值,且轨迹误差、航向角误差、俯仰角误差、速度误差均低于对应误差阈值时,判定当前课程训练收敛并自动切换至下一阶段;二维课程训练过程中不考核俯仰角误差指标。
104、进一步地,所述部署最优策略实现水下机器人二维、三维轨迹在线闭环跟踪,包括:
105、获得经过课程强化学习训练后得到的最优ppo策略网络;
106、采集自主水下机器人实时运动状态,结合自适应前瞻los制导信息构建在线输入状态:
107、;
108、式中,为在线轨迹跟踪阶段的策略网络输入状态,为第时刻自主水下机器人的速度向量;
109、最优策略网络根据在线状态输出最优控制动作:
110、;
111、将控制动作经映射函数转换为自主水下机器人执行机构实际控制输入:
112、;
113、自主水下机器人在实际控制输入与外部扰动作用下完成运动更新,状态迭代关系为:
114、;
115、式中,、分别为第时刻自主水下机器人的位置姿态向量和速度向量,为水下机器人动力学模型对应的状态转移函数,、分别为第时刻自主水下机器人的位置姿态向量和速度向量,为作用于自主水下机器人动力学模型的外部环境扰动项;
116、周期性循环执行状态采集、制导解算、策略推理、控制输出与状态反馈流程,构成在线闭环控制系统,实现扰动环境下二维、三维轨迹高精度跟踪控制。
117、与现有技术相比,本发明具有以下有益效果:
118、本发明的基于自适应前瞻距离与课程强化学习的水下机器人轨迹跟踪控制方法,通过自适应los制导机制与课程强化学习控制策略的结合,显著提高了auv轨迹跟踪的精确性、稳定性和自主性。该方法能够根据包括路径曲率、轨迹误差和速度误差在内的轨迹状态参数实时调整前瞻距离,使auv在复杂轨迹跟踪过程中兼顾偏差修正能力和航向控制平滑性;同时,将自适应前瞻距离和los制导信息引入强化学习状态空间,使策略网络能够根据实时轨迹状态动态输出控制动作。通过课程强化学习机制逐步增加训练难度,减少了强化学习在复杂环境中的无效探索,提高了策略收敛速度和鲁棒性,增强了auv在二维轨迹、三维轨迹及复杂扰动环境下的轨迹跟踪能力和适应性。