
一种面向机器人运动控制策略的强化学习训练方法及系统与流程
本发明属于机器人运动控制,具体为一种面向机器人运动控制策略的强化学习训练方法及系统。
背景技术:
1、机器人运动控制策略是指用于根据机器人传感器观测和速度、姿态或任务指令输出关节、轮速或轮腿复合控制量的策略网络。腿足、轮足及复合移动机器人在复杂地形中运动时,需要同时满足速度跟踪、姿态稳定、接触切换、动作平滑和真实部署可执行等要求。强化学习能够在仿真环境中通过大规模交互学习运动控制策略,但直接训练可部署策略时,策略只能利用真实机器人传感器能够提供的本体观测和历史观测,难以充分感知地形、接触状态、外部扰动等隐含因素,导致训练收敛慢、步态质量不稳定或复杂地形能力不足。
2、现有做法通常在仿真训练阶段引入特权观测,使教师策略能够利用真实部署时不可直接获得的地形参数、接触状态或扰动信息,从而学习较强的运动能力。然而,教师策略依赖特权观测,不能直接用于真实机器人端执行;若仅采用普通蒸馏方式将教师动作拟合到学生策略,学生策略容易只学习动作表面形式,难以保留教师策略隐变量中的环境感知能力和价值信息,在后续微调或实机部署中可能出现动作抖动、步态退化、地形适应能力下降等问题。当从教师策略直接继续训练部署策略时,旧优化器状态、学习率调度和特权观测分布可能对后续训练产生干扰,导致最终策略虽然在仿真指标上表现良好,但在真实部署观测条件下稳定性不足。
3、因此,有必要提出一种新的强化学习训练方法,提高机器人运动控制策略的训练稳定性和部署一致性。
技术实现思路
1、发明目的:为解决现有技术中存在的问题,本发明提出了一种面向机器人运动控制策略的强化学习训练方法及系统,通过教师引导式的三阶段强化学习,使高能力学习、信息迁移和部署一致性分别得到处理,形成可复用、可追溯、可扩展的训练流程。
2、技术方案:
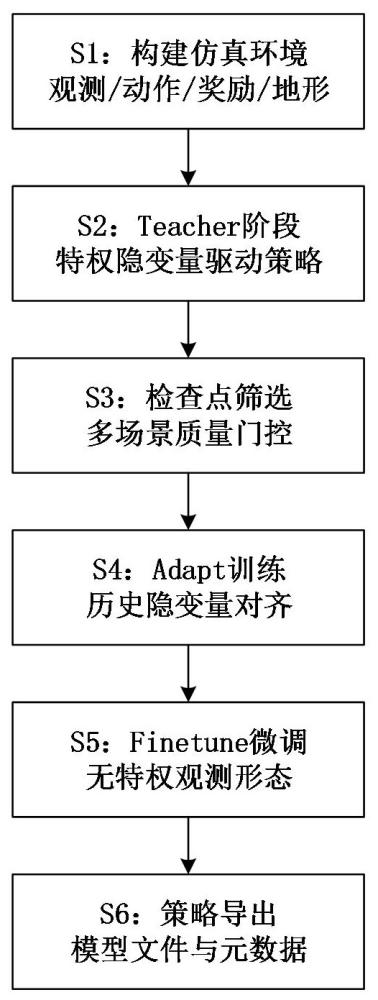
3、本发明提出了一种面向机器人运动控制策略的强化学习训练方法,包括:
4、构建包括机器人动力学模型的仿真训练环境,获取机器人在不同场景下的本体观测、历史观测和特权观测;
5、提供一个包括特权编码器、历史编码器、动作网络和评价网络的策略网络,所述特权编码器为神经网络,所述历史编码器为时序编码器;
6、采用近端策略优化算法依次对该策略网络进行教师阶段、适配阶段和微调阶段的训练,得到可部署的机器人运动控制策略模型;
7、所述教师阶段的训练包括:激活特权编码器、动作网络和评价网络,输入本体观测和特权观测,对特权编码器、动作网络和评价网络进行训练,训练过程中按预设间隔抽取教师策略检查点,直至满足预设停止条件;
8、所述适配阶段的训练包括:激活历史编码器,加载教师策略检查点作为输入,冻结教师阶段特权编码器、动作网络和评价网络的参数,仅对历史编码器进行训练,训练过程中按预设间隔抽取历史适配检查点,直至满足预设停止条件;
9、所述微调阶段的训练包括:初始化所述策略网络,激活历史编码器、动作网络和评价网络,移除特权编码器,加载历史适配检查点作为输入,对历史编码器和动作网络进行微调,直至满足部署条件,输出机器人运动控制策略模型。
10、进一步的,所述本体观测是策略真实部署时作为输入的参数,包括机器人动力学模型输出的关节位置、关节速度、机身角速度、机身姿态投影、速度指令、上一时刻控制动作、轮速状态和步态相位信息;所述历史观测为若干个连续控制周期内的本体观测序列;所述特权观测是策略真实部署时不作为输入的参数。
11、进一步的,所述教师策略检查点为教师阶段某一训练轮次保存的策略模型文件,包括特权编码器参数、动作网络参数、评论网络参数、训练轮次、观测维度、动作维度和标识;所述历史适配检查点为适配阶段某一训练轮次保存的策略模型文件,包括历史编码器参数、动作网络参数、评论网络参数、训练轮次、观测维度、动作维度和标识。
12、进一步的,所述教师阶段的训练还包括:
13、将特权观测输入特权编码器,生成特权隐变量,将本体观测和特权隐变量拼接并输入动作网络,生成教师控制动作;
14、设计目标函数,评价网络根据目标函数值执行该教师控制动作的教师价值估计,采用近端策略优化算法反馈更新特权编码器、动作网络的参数。
15、进一步的,所述适配阶段的训练还包括:
16、在仿真训练环境中执行教师策略检查点的教师控制动作,采集训练样本;从训练样本中抽取对应的历史观测,输入历史编码器,得到历史隐变量;
17、动作网络采用教师阶段中特权编码器和动作网络的参数,基于历史隐变量生成学生控制动作;
18、结合教师阶段的教师价值估计设计损失函数,计算执行该学生控制动作的损失函数值,采用近端策略优化算法反馈更新历史编码器的参数。
19、进一步的,所述加载教师策略检查点作为输入,包括:
20、在加载前对所有抽取得到的教师策略检查点进行评分,筛选满足预设评分标准的教师策略检查点作为适配阶段的输入;
21、所述评分规则包括:对于任一检查点,计算某一场景的所有评价指标,归一化所有评价指标,得到当前场景评分;对该检查点得到的所有场景评分做加权平均,得到最终评分。
22、进一步的,所述归一化所有评价指标,包括:
23、若评价指标为误差类指标,包括速度误差、偏航误差、动作变化率、动作加速度变化率、打滑率和机身晃动幅度,归一化函数为负相关函数;
24、若评价指标为收益类指标,包括台阶完成率、前轮清障高度、相位锁定分数、对角支撑比例和清障一致性,归一化函数为正相关函数。
25、进一步的,所述微调阶段的训练还包括:
26、初始化策略模型,重置适配阶段的策略模型状态,加载历史适配检查点;
27、在仿真训练环境中执行历史适配检查点的学生控制动作,采集训练样本,从训练样本中抽取对应的历史观测输入至历史编码器,得到历史隐变量;
28、将当前时刻的本体观测与历史隐变量输入动作网络,得到运动控制策略和下一时刻的微调控制动作;
29、设计奖励函数,在仿真训练环境中执行微调控制动作的奖励函数值,采用近端策略优化算法反馈更新历史编码器和动作网络的参数,直至满足部署条件。
30、进一步的,所述部署条件包括:
31、微调阶段训练轮次达到预设最大训练轮次;各场景的采样占比不低于预设下限;所述误差类指标不高于预设上限;所述收益类指标不低于预设下限;运动控制策略的观测维度、动作维度导出后与机器人接口中观测维度、动作维度匹配。
32、另一方面,本发明还提出了一种面向机器人运动控制策略的强化学习训练系统,包括:
33、仿真模块,用以构建包括机器人动力学模型的仿真训练环境,获取机器人在不同场景下的本体观测、历史观测和特权观测;
34、策略网络,包括特权编码器、历史编码器、动作网络和评价网络,所述特权编码器为神经网络,所述历史编码器为时序编码器;
35、分阶段训练模块,用以通过采用近端策略优化算法依次对该策略网络进行教师阶段、适配阶段和微调阶段的训练,得到可部署的机器人运动控制策略模型;
36、所述教师阶段的训练包括:激活特权编码器、动作网络和评价网络,输入本体观测和特权观测,对特权编码器、动作网络和评价网络进行训练,训练过程中按预设间隔抽取教师策略检查点,直至满足预设停止条件;
37、所述适配阶段的训练包括:激活历史编码器,加载教师策略检查点作为输入,冻结教师阶段特权编码器、动作网络和评价网络的参数,仅对历史编码器进行训练,训练过程中按预设间隔抽取历史适配检查点,直至满足预设停止条件;
38、所述微调阶段的训练包括:初始化所述策略网络,激活历史编码器、动作网络和评价网络,移除特权编码器,加载历史适配检查点作为输入,对历史编码器和动作网络进行微调,直至满足部署条件,输出机器人运动控制策略模型。
39、有益效果:
40、本发明构建actor-critic策略网络,收集特权观测、本体观测和历史观测进行分阶段训练,将特权训练、历史观测适配和部署形态微调解耦。
41、教师(teacher)阶段使用特权路径,使策略能够在仿真环境中充分利用地形、接触和扰动信息,先获得较强的复杂地形运动能力和步态结构。
42、适配(adapt)阶段冻结动作网络,单独训练历史编码器,将特权隐变量迁移为历史隐变量,避免直接将依赖特权观测的教师策略用于部署,降低仿真训练能力与真实部署观测之间的差距。通过隐变量对齐、动作对齐、价值信息保持和平滑性约束的组合损失,使历史编码器不仅拟合教师动作,还保留教师隐变量中的环境感知能力、价值相关信息和时间连续性,有助于降低动作抖动和微调退化。
43、微调(finetune)阶段切换为历史隐变量路径,无特权观测的部署形态,继续训练使最终策略与机器人端观测条件保持一致,提高最终策略的可部署性和可追溯性。