
一种基于PPO的多机器人路径规划与智能决策方法
本发明涉及多机器人系统,具体为一种基于ppo的多机器人路径规划与智能决策方法。
背景技术:
1、随着机器人技术与人工智能的快速发展,多机器人系统在仓储物流、环境巡检、灾害救援、工业制造等领域的应用日益广泛。这些系统需要在动态环境中执行复杂任务,例如在存在动态障碍物的场景中实现高效路径规划和协同作业。然而,现有技术在应对动态环境时存在显著局限。传统的多机器人路径规划方法多依赖静态环境模型或简单网格表示,例如基于固定网格的地图构建,难以适应障碍物位置随机变化或目标点动态调整的场景。这种静态建模方式在实际应用中,如物流仓库中的货架移动或救援场景中的突发障碍物,会导致路径规划失败或效率低下。此外,现有系统在目标识别方面通常采用预设规则或静态模型,缺乏对环境动态变化的实时响应能力,例如无法快速更新目标位置或识别新出现的障碍物,限制了机器人在非结构化环境中的表现能力。
2、进一步地,传统路径规划算法(如a*算法、dijkstra算法或遗传算法)在静态环境中表现良好,但在多机器人协同作业场景下,面对动态环境和多目标优化需求时,难以实现高效的冲突避免与资源分配。例如,在多机器人协同搬运任务中,传统算法难以平衡路径长度、避障安全性与任务时效性,导致系统整体效率低下。此外,现有技术在多机通讯方面研究不足,缺乏高效的通信机制来支持实时状态共享与协同决策,导致机器人间冲突频繁或协作效率低下。传统多机通讯多采用集中式架构或简单的广播机制,通信延迟高且扩展性差,难以适应大规模多机器人系统。例如,在动态环境中,机器人需要实时共享位置、目标和障碍物信息,以避免路径冲突或重复覆盖,但现有方法在通信拓扑设计(如星型、环型或网状网络)与信息传递效率优化方面存在不足。
3、近年来,部分研究尝试引入强化学习算法来提升路径规划的适应性,但其奖励机制设计较为简单,通常仅考虑单一目标(如到达目标点的距离),难以综合优化任务时效性、路径安全性与能耗等多个维度。此外,强化学习在多机器人场景中的应用往往忽略通信拓扑结构对协同决策的影响,例如通信带宽限制、延迟或信息丢失对策略优化的影响。
4、基于此,本发明提供一种基于ppo的多机器人路径规划与智能决策方法,通过动态gridworld环境建模、近端策略优化ppo算法、多机通讯机制以及多目标奖励函数优化,构建实时环境感知、目标识别与协同决策系统,能够有效应对动态障碍物与目标变化,提升多机器人系统的鲁棒性、协同效率与通信效率,适用于复杂非结构化场景下的路径规划与智能决策需求。
技术实现思路
1、针对现有技术的不足,本发明提供了一种基于ppo的多机器人路径规划与智能决策方法,解决了上述背景技术中提出的问题。
2、为实现以上目的,本发明通过以下技术方案予以实现:一种基于ppo的多机器人路径规划与智能决策方法,包括如下步骤:
3、s1、动态环境建模与目标识别:基于gridworld环境构建动态环境模型,所述动态环境模型包括网格、随机障碍物、机器人起点及固定目标点,基于事件触发式环境更新机制响应环境中障碍物位置或目标点的动态变化;建立环境状态反馈机制,在机器人执行动作后实时返回更新后的环境状态、奖励及终止标志,同步更新机器人状态空间,所述机器人状态空间包括机器人当前位置、目标位置及障碍物集合;
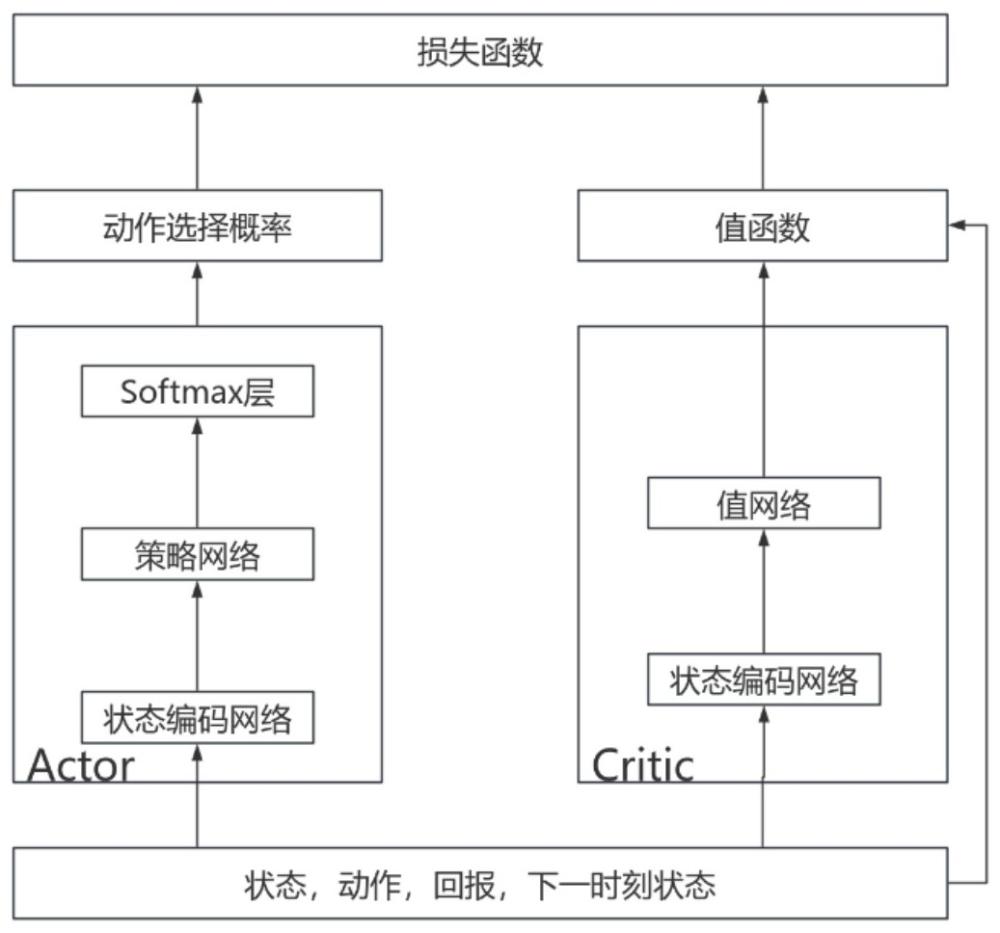
4、s2、基于ppo的强化学习决策建模与多机通讯:构建ppo强化学习决策模型,其以策略优化进行机器人动作决策,所述ppo强化学习决策模型包含actor神经网络与critic神经网络;结合多目标奖励函数平衡任务时效性、路径安全性与多机器人协同性;搭建基于网状拓扑的分布式多机通讯网络,进行机器人间状态信息共享与协同决策;
5、s3、反馈优化与动态调整:基于环境状态反馈机制更新ppo强化学习决策模型的策略网络;基于分布式多机通讯网络共享的状态信息优化冲突避免策略;根据机器人间相对距离动态调整通信拓扑;开展多机器人协同训练,通过联合策略优化最大化全局累积奖励。
6、本发明提供了一种基于ppo的多机器人路径规划与智能决策方法。具备以下有益效果:
7、(1)本发明通过动态网格环境建模与事件触发式更新机制,能够实时感知和响应复杂动态环境中的目标位置与障碍物变化,提升多机器人系统在非结构化场景下的适应能力,通过动态环境表示和实时状态反馈,能够有效应对突发障碍物的动态变化,确保路径规划的鲁棒性与高效性,此外,结合分布式多机通讯机制,能够快速更新环境状态,减少因环境变化导致的规划失败,为复杂场景下的使用提供支持。
8、(2)本发明通过多目标奖励函数,综合优化任务时效性、路径安全性与多机协同性,提升多机器人协同作业的效率,通过动态调整奖励函数与冲突惩罚机制,激励机器人快速到达目标、避免障碍物并减少路径冲突,配合分布式通信网络进一步支持实时状态共享,使各机器人能够基于全局信息优化决策路径,降低冲突概率,提高协同效率。
1.一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,包括如下步骤:
2.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述gridworld环境的网格大小设为n,目标点固定为(n-1,n-1);随机障碍物按gridworld环境网格总单元数的预设比例随机分布,且不覆盖机器人起点与目标点;
3.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述ppo强化学习决策模型的策略优化方式包括:
4.根据权利要求3所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述ppo惩罚项包括:在目标策略函数中引入kl散度惩罚项,限制新旧策略间的差异;
5.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述多目标奖励函数为:
6.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述分布式多机通讯网络采用马尔可夫博弈框架:
7.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述分布式多机通讯网络进行机器人间状态信息共享与协同决策的方式包括:
8.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述基于环境状态反馈机制更新ppo强化学习决策模型的策略网络的方式包括:
9.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述根据机器人间相对距离动态调整通信拓扑的方式为:当两机器人间的欧几里得距离超过预设距离阈值之时,断开二者间的通信连接。
10.根据权利要求1所述的一种基于ppo的多机器人路径规划与智能决策方法,其特征在于,所述开展多机器人协同训练,通过联合策略优化最大化全局累积奖励的目标函数为: