
一种基于SHEOA-SimpleTM的CFB机组SO2排放浓度的预测方法
本发明属于智能发电,尤其是涉及一种基于sheoa-simpletm的cfb机组so2排放浓度的预测方法。
背景技术:
1、循环流化床(circulating fluidized bed, cfb)是一种高效的燃烧技术,通过高速气流使固体颗粒在燃烧室内悬浮并剧烈湍动,形成类似流体的流化状态,实现燃料与空气的充分混合和燃烧。其核心在于“物料循环机制”:烟气携带未燃尽的颗粒进入分离器,分离后的颗粒经返料装置送回炉膛反复燃烧,大幅提升燃烧效率和燃料适应性。同时,通过添加石灰石实现炉内脱硫,并借助低温燃烧和分级送风显著降低氮氧化物排放。该技术兼具负荷调节灵活、运行成本低及环保优势,已广泛应用于电力、化工、冶金等领域,成为我国燃煤发电减排的关键技术。
2、循环流化床脱硫(cfb-fgd)是一种半干法烟气净化工艺,主要用于处理燃煤锅炉排放的含硫烟气。其核心在于通过文丘里管或布风板将高温烟气高速引入吸收塔底部,与喷入的精细消石灰或石灰石粉末强烈混合。高速气流使粉末颗粒形成剧烈湍动的气固悬浮层,极大扩展了气固接触面积。在喷水控温的优化条件下,二氧化硫与吸收剂发生化学反应,生成固态硫酸钙和亚硫酸钙。反应后的烟气携带颗粒进入除尘器,分离的灰渣经空气斜槽返回吸收塔循环利用百次以上,显著提升钙基吸收剂利用率,最终实现95%以上的脱硫效率,钙硫比仅需1.1–1.3。
3、循环流化床脱硫以低耗高效解决了燃煤烟气脱硫的核心需求,但so2的剧毒性、波动性及法规约束要求其必须与预测技术深度耦合。未来方向是通过物联网与人工智能,将预测数据直接嵌入脱硫控制系统,在保障超低排放的同时,最小化环境风险与经济成本。
技术实现思路
1、本发明的目的是提供一种基于sheoa-simpletm的cfb机组so2排放浓度的预测方法,通过构建sheoa-simpletm模型对so2排放浓度进行预测,以此克服so2浓度测点带来的迟延。
2、为实现上述目的,本发明提供了一种基于sheoa-simpletm的cfb机组so2排放浓度的预测方法,包括以下步骤:
3、s1、通过皮尔逊相关分析法确定影响cfb机组so2排放浓度的主要运行参数;
4、s2、对主要运行参数进行高斯平滑处理;
5、s3、建立simpletm模型;
6、s4、对simpletm模型进行训练,得到训练后的simpletm模型;
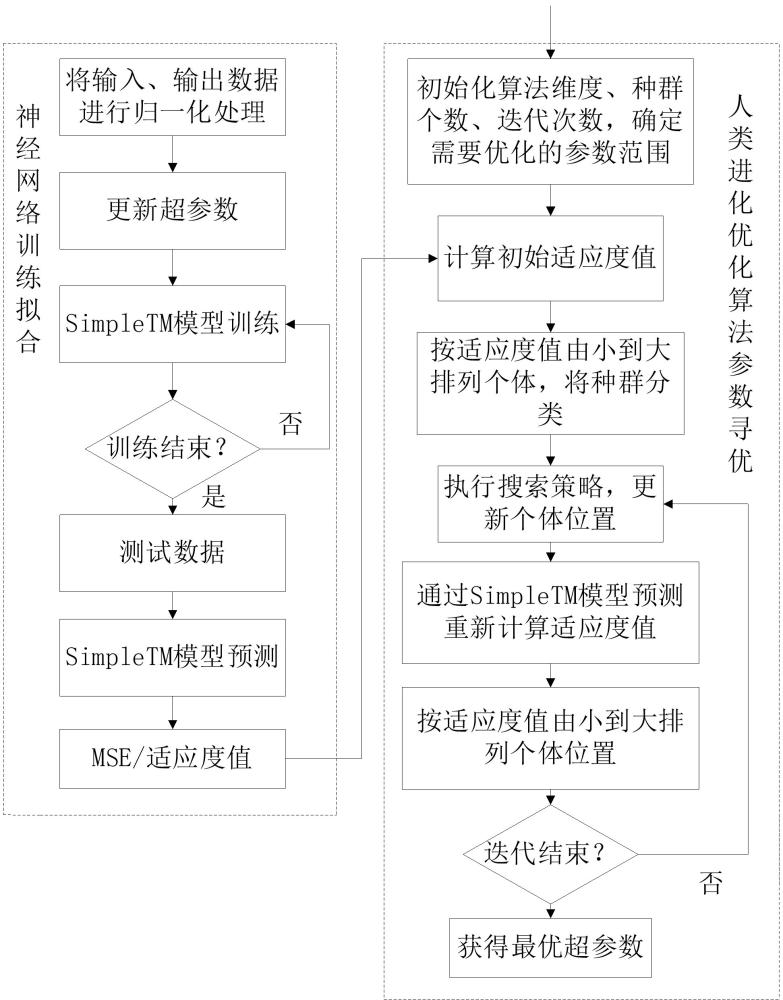
7、s5、使用训练后的simpletm模型输出初始适应度值,并通过人类进化优化算法进行参数寻优,得到最优超参数;
8、s6、通过最优超参数更新sheoa-simpletm预测模型,对so2排放浓度进行预测。
9、优选的,s1的过程如下:
10、s11、确定包括参考数列和比较数列的分析数列,其中参考数列为so2的排放浓度,比较数列为cfb机组的相关运行参数;
11、s12、对分析数列中的变量通过归一化处理进行无量纲化;
12、s13、计算关联系数;
13、s14、根据关联度对数据进行排序,选取合适的参数作为初始超参数。
14、优选的,s2中进行高斯平滑处理的目的是剔除数据中的毛刺,防止异常数据给模型学习带来不确定性。
15、优选的,s3的过程如下:
16、s31、对transformer架构通过平稳小波变换进行大模型词元化处理;
17、s32、大模型词元化处理完成之后,结合点积和楔积使用几何积重新制定注意力机制;
18、s33、重新制定注意力机制之后进行多元时间序列的重建;
19、s34、重建完成之后得到simpletm模型。
20、优选的,s4的过程如下:
21、s41、对往期的so2排放浓度的主要运行参数进行归一化,更新超参数得到训练集;
22、s42、将训练集中的超参数输入simpletm模型中进行迭代训练,训练完成之后得到最终simpletm模型;
23、s43、将s2中高斯平滑处理之后的初始超参数输入最终simpletm模型中进行预测,得到mse值。
24、优选的,s31的过程如下:
25、s311、应用一个线性投影,将每个通道嵌入到一个隐藏/潜在空间;
26、s312、使用可学习的平稳小波变换实现多尺度表示,平稳小波变换的核心是母小波和尺度函数;
27、s313、将嵌入的时间序列通过平稳小波变换进行分解,得到小波系数。
28、优选的,s5的过程如下:
29、s51、人类进化优化算法采用逻辑混沌映射初始化种群,得到初始化算法维度、种群个数和最大迭代次数,确定需要优化的参数范围;
30、s52、将mse值进行反归一化处理得到初始适应度,当种群取值为1、2、3和4时分别表示领导者、探索者、追随者和失败者;
31、s53、根据初始适应度由小到大排列个体,架构种群分类;
32、s54、进行迭代处理,最大迭代次数的前1/4执行人类探索阶段;
33、s55、人类探索阶段完成之后在剩余的迭代次数执行人类发展阶段;
34、s56、得到全局最优位置和适应度,全局最优位置即为最优超参数。
35、优选的,初始化种群的公式表示如下:
36、;
37、;
38、;
39、其中表示(0,1)之间的随机数,表示第个随机数;为第个人在搜索空间中的初始位置向量;为分支参数;和分别表示搜索空间的上界和下界。
40、优选的,s54中人类探索阶段的公式表示如下:
41、;
42、;
43、;
44、其中表示适应性函数;表示最大迭代次数;表示当前迭代次数;表示问题涉及到的变量个数,数值为4,分别为batch_size,d_model,d_ff,learning_rate;为第个人在第次迭代的位置;表示第个人在第次迭代的位置;表示目前探索到的最优位置;表示当前种群中所有人的平均位置;表示向下舍入操作;为莱维分布;表示跳跃系数;为内的随机数;
45、s54的流程如下:
46、s541、判断当前迭代次数是否超出最大迭代次数的1/4,若未超过则进行s542,否则进行s55;
47、s542、当时按统一策略更新第1个人的位置;
48、s543、若则令,按统一策略分别更新第2到j个人的位置,即探索者、追随者和失败者的位置;
49、s544、当s543完成之后,即不成立,将此时的种群位置作为超参数输入最终simpletm模型更新适应度值,按更新的适应度大小重新排列个体;
50、s545、令,返回s541。
51、优选的,s55的流程如下:
52、s551、判断迭代次数是否不大于最大迭代次数,若满足则进行s552,否则完成迭代过程;
53、s552、判断种群的值,并根据种群的值进行按顺序位置更新,过程如下:
54、若,则判断此时的种群为领导者,并更新领导者的位置;
55、若,则判断此时的种群为追随者,并更新追随者的位置;
56、若,则判断此时的种群为探索者,并更新探索者的位置;
57、若,则判断此时的种群为失败者,并淘汰失败者;
58、s553、补足种群,并将此时的种群位置作为超参数输入最终simpletm模型更新适应度值,与全局适应度比较,更小则替换之;
59、s554、令,若则返回s552,否则按更新的适应度大小重新排列个体,之后令,并返回s551。
60、因此,本发明采用上述的一种基于sheoa-simpletm的cfb机组so2排放浓度的预测方法,具有以下优点:
61、1、采用机器学习的方式进行流化床so2排放浓度建模,具有较高的精度,且过程简单。
62、2、本发明采用的sheoa-simpletm模型为transformer模型的变体,比其他transformer模型(如itransformer模型等),结构简单,训练精度高。
63、3、虽然机器算法已较为广泛地运用在火电机组建模中,但现场实际运用却十分罕见,本发明为机器算法在火电机组的运用提供了一种新思路。
64、4、能有效对so2进行预测,实现对so2的智能监测,能够在一定时间范围内对运行人员操作进行反馈,有利于安全稳定运行。
65、下面通过附图和实施例,对本发明的技术方案做进一步的详细描述。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com