
一种质谱检测细胞蛋白质乳酸化修饰组的方法
本发明属于生物检测,具体涉及一种质谱检测细胞蛋白质乳酸化修饰组的方法。
背景技术:
1、修饰组学分析是蛋白质翻译后修饰研究的核心技术手段,当前主要依托液相色谱-串联质谱(liquid chromatography-tandem mass spectrometry, lc-ms/ms)平台开展。然而,针对蛋白量少或蛋白质目标修饰丰度较低的细胞样本,现有修饰组学方法仍面临较大挑战,相关研究报道较为匮乏;尤其是针对乳酸化修饰这一新型翻译后修饰,目前尚缺乏系统性的组学分析方案及专门的实验优化策略,其主要原因如下:首先,基于质谱的翻译后修饰检测对样本的起始蛋白总量有较高要求。当研究对象为获取难度大、在生物样本中占比低且部分蛋白丰度有限的细胞类型(如cd8⁺ t细胞等特定t细胞亚群)时,往往难以满足常规修饰组学分析所需的最低蛋白上样量。若在蛋白量不足的条件下强行开展质谱检测,所得数据通常存在质量偏低、修饰鉴定深度不足及重复间一致性差等问题。
2、其次,在质谱上机阶段,目前应用最广泛,技术最成熟,也是最简单成本最低的数据采集模式是数据依赖型采集(data-dependent acquisition,dda),然而,该模式存在高丰度肽段选择偏好、低丰度修饰肽段易漏检、鉴定覆盖深度不足、重复一致性差等局限。
3、最后,未经富集的样本虽然可以达到质谱蛋白上样量的要求,但其内存在管家蛋白,细胞骨架蛋白等细胞组成性表达的蛋白,他们的蛋白丰度更高,在质谱上机时,往往会“掩盖”掉那些低丰度但是可能具有重要生物学意义的蛋白的质谱信号,导致假阴性或者检测错漏。因此目前研究者往往会采取先富集发生修饰的蛋白质,然后再进行质谱检测的策略,此种策略可以提高质谱上机样本中发生该种修饰的蛋白质的丰度,从而提高质谱检出的效率。但是同时这种富集方法也会大幅度减少蛋白总量,对于本就蛋白量很少的细胞修饰组学分析来说,又会进一步加重蛋白量不足的问题。
4、受上述技术瓶颈的限制,当前针对蛋白量少或蛋白质乳酸化修饰丰度有限的细胞样本开展乳酸化修饰研究时,其技术路线与传统翻译后修饰组学分析存在差异:多数研究倾向于避开乳酸化修饰组学鉴定这一技术难度较高的环节。现有研究多采用泛赖氨酸乳酸化(pan-kla)抗体或已知位点特异性乳酸化抗体,仅能检测细胞整体乳酸化水平变化或少数已知乳酸化修饰蛋白的修饰状态,无法实现细胞全乳酸化修饰谱的无偏鉴定。
5、综上可见,现有蛋白质乳酸化修饰组学技术难以适配蛋白量少或蛋白质乳酸化修饰丰度低的细胞样本的检测需求,普遍存在鉴定深度不足、鉴定可信度水平欠佳的技术局限,亟需建立一种针对性强、鉴定深度与鉴定特异性兼备的细胞蛋白质乳酸化修饰组学分析方法。
技术实现思路
1、本发明的目的是提供一种质谱检测细胞蛋白质乳酸化修饰组的方法,解决了现有技术中存在的问题。
2、本发明所采用的技术方案是:
3、本发明提供了一种质谱检测细胞蛋白质乳酸化修饰组的方法,步骤如下:
4、s1、获取蛋白样本;
5、s2、酶解:沉淀总蛋白,将所得蛋白沉淀溶于含尿素的tris-hcl缓冲液中,依次经还原处理、烷基化处理,并淬灭烷基化反应,稀释后加入胰蛋白酶/lys-c蛋白酶混合物进行酶解,得到肽段;
6、s3、富集:先将所述肽段与泛赖氨酸乳酸化抗体孵育,得到肽段-抗体混合物,再将所述肽段-抗体混合物加入蛋白a/g树脂中孵育;
7、s4、洗涤与洗脱;
8、s5、采用dia数据采集模式进行质谱检测;
9、s6、数据搜库:以半胱氨酸氨基甲酰甲基化为固定修饰、赖氨酸氨甲酰化、赖氨酸乳酸化以及蛋氨酸氧化为可变修饰进行搜库分析。
10、优选地,还原处理为加入二硫苏糖醇至终浓度5mm,37℃孵育1h;
11、烷基化处理为加入碘乙酰胺至终浓度15mm,室温避光孵育30min;
12、淬灭烷基化反应为加入二硫苏糖醇至终浓度10mm。
13、优选地,稀释是指加入反应体系3倍体积的50mm tris-hcl缓冲液。
14、优选地,胰蛋白酶/lys-c蛋白酶混合物与蛋白沉淀的质量比为1:60。
15、优选地,胰蛋白酶/lys-c蛋白酶混合物与蛋白沉淀酶解的条件为37℃孵育2h。
16、优选地,肽段与泛赖氨酸乳酸化抗体孵育的条件为4℃ 16h。
17、优选地,dia数据采集模式设置32个扫描窗口,isolation window为25m/z,hcdcollision energy为30%,normalized agc target为2000%,maximum it为54ms。
18、优选地,质谱检测采用正离子模式,母离子扫描范围为400m/z~1200m/z,一级质谱分辨率为120000,normalized agc target为250%,maximum it为50ms。
19、优选地,搜库分析时允许的最大漏切位点数为2个,每条肽段允许的最大可变修饰数为5个,肽段长度限制为7~52个氨基酸,前体最大电荷数限制为4。
20、优选地,获取蛋白样本的方法如下:
21、收集细胞,用裂解缓冲液冰上静置裂解30min,取上清,得到总蛋白。
22、与现有技术相比,本发明的有益效果是:
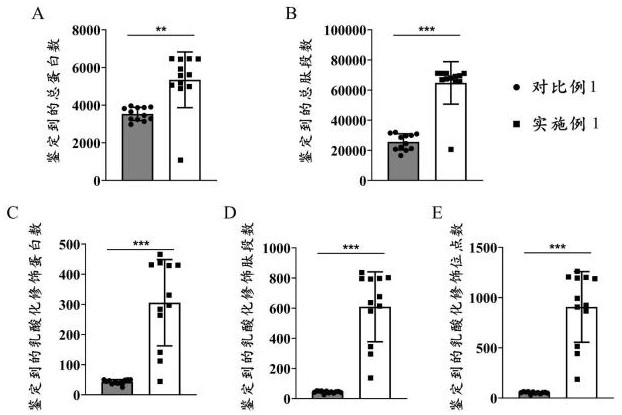
23、本发明基于液相色谱-串联质谱平台,提供了一种针对细胞样本的乳酸化修饰组学分析流程。本发明通过将沉淀后的总蛋白溶于含尿素的tris-hcl缓冲液,并在还原、烷基化后淬灭烷基化反应,再稀释并采用胰蛋白酶/lys-c蛋白酶混合物酶解,可有效切割胰蛋白酶难以作用的位点,减少漏切肽段,提高酶解效率和乳酸化肽段的真实鉴定率,同时减少烷基化试剂残留对酶解的抑制以及尿素降解等因素引起的赖氨酸氨甲酰化等副反应,更好地保留细胞样本原本的乳酸化修饰水平。其次通过先将肽段与泛赖氨酸乳酸化抗体孵育形成肽段-抗体混合物,再将该肽段-抗体混合物加入蛋白a/g树脂中孵育,即采用溶液相抗体预混合富集策略,可使抗体和乳酸化肽段在溶液中自由扩散、碰撞概率提高,并避免抗体预先固定于树脂所造成的空间位阻,从而最大程度捕获细胞中丰度极低的乳酸化修饰肽段,显著提高富集效率。采用dia数据采集模式,相比dda模式,数据采集更完整、定量更准确、重现性更好,对低丰度乳酸化修饰肽段的检测能力更强,可有效避免高峰度信号“掩盖”低丰度信号以及碎片采集随机性导致的低丰度修饰肽段丢失。搜库时以半胱氨酸氨基甲酰甲基化为固定修饰,并将赖氨酸氨甲酰化、赖氨酸乳酸化、蛋氨酸氧化设为可变修饰,可避免因尿素降解和iaa处理产生的氨甲酰化、半胱氨酸氨基甲酰甲基化肽段在母离子匹配阶段被软件丢弃,从而显著提高肽段和乳酸化修饰位点的鉴定率,并降低假阳性率。
24、因此,对于t细胞等原代获取困难、细胞数量有限、目标蛋白(修饰蛋白)丰度低的细胞样本,本发明可提升乳酸化修饰组鉴定深度、富集效率和结果可信度。
版权声明:本站专利文献数据主要来源于国家知识产权局等公开渠道,由 技术新讯 进行整理汇编。页面设计及数据汇编的著作权归本站所有。全部内容仅供个人学习、科研评估与技术交流参考,严禁用于任何商业用途(包括但不限于直接生产制造、技术转让、倒卖数据等)。
免责条款:专利技术具有时效性,本站不对资料的绝对准确性、完整性和可实施性提供任何明示或暗示的担保。因参考本站内容造成的直接或间接损失,本站不承担相关法律责任。若您认为本站内容有侵权问题,请及时提供权属证明与我们联系,本站将在核实后依法处理。反馈意见:yyfuon@163.com